S3-подобное хранилище
В этой главе мы спроектируем object storage service, похожий на Amazon Simple Storage Service (S3). S3 — это сервис Amazon Web Services (AWS), предоставляющий object storage через интерфейс на базе RESTful API. Вот несколько фактов об AWS S3:
-
Запущен в июне 2006 года.
-
В 2010 году в S3 появились
versioning,bucket policyиmultipart upload. -
В 2011 году были добавлены
server-side encryption,multi-object deleteиobject expiration. -
В 2013 году Amazon сообщила о 2 триллионах objects, хранящихся в S3.
-
В 2014 и 2015 годах появились
life cycle policy,event notificationиcross-region replication. -
В 2021 году Amazon сообщила уже более чем о 100 триллионах objects в S3.
Прежде чем углубляться в object storage, сначала коротко разберем storage systems в целом и зафиксируем базовую терминологию.
Storage System 101
На high-level storage systems обычно делятся на три большие категории:
-
Block storage
-
File storage
-
Object storage
Block storage
Block storage появилась первой, еще в 1960-х. Обычные storage devices вроде HDD и SSD, физически подключенные к servers, относятся именно к block storage.
Block storage предоставляет server-у сырые blocks в виде volume. Это самый гибкий и универсальный вид storage. Server может форматировать raw blocks и использовать их как file system, а может отдать управление blocks приложению. Некоторые applications, например database engine или virtual machine engine, управляют этими blocks напрямую, чтобы выжать максимум performance.
Block storage не ограничивается физически подключенным storage. Она может быть доступна по high-speed network или через стандартные connectivity protocols вроде Fibre Channel (FC) [1] и iSCSI [2]. Концептуально network-attached block storage все равно отдает raw blocks. Для servers она работает почти так же, как физически подключенный storage.
File storage
File storage строится поверх block storage. Она дает более высокоуровневую abstraction, чтобы удобнее работать с files и directories. Data хранится как files в иерархической directory structure. Это самый распространенный general-purpose storage solution. File storage может раздаваться большому числу servers через common file-level network protocols вроде SMB/CIFS [3] и NFS [4]. Servers, работающим с file storage, не нужно заниматься block management, volume formatting и прочими низкоуровневыми деталями. Благодаря этой простоте file storage отлично подходит для совместного доступа к большому числу files и folders внутри организации.
Object storage
Object storage появилась позже. Она сознательно жертвует performance ради высокой durability, огромного scale и низкой стоимости. Она ориентирована на сравнительно “cold” data и в основном используется для archival и backup. Object storage хранит все data как objects в flat structure. Иерархической directory structure нет. Доступ обычно предоставляется через RESTful API. По сравнению с другими типами storage она относительно медленная. Практически у всех крупных cloud providers есть свои object storage offerings: AWS S3, Google Cloud Storage, Azure Blob Storage и т. д.
Сравнение
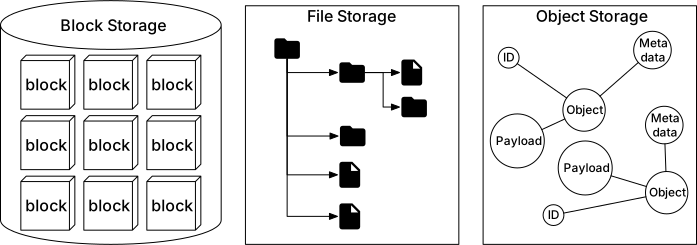
Рисунок 1 Три разных storage options
Таблица 1 сравнивает block storage, file storage и object storage.
| Block storage | File storage | Object storage | |
|---|---|---|---|
| Mutable content | Да | Да | Нет (object versioning есть, но in-place update нет) |
| Cost | Высокая | Средняя или высокая | Низкая |
| Performance | Средняя или высокая, иногда очень высокая | Средняя или высокая | Низкая или средняя |
| Consistency | Strong consistency | Strong consistency | Strong consistency [5] |
| Data access | SAS [6] / iSCSI / FC | Standard file access, CIFS/SMB, NFS | RESTful API |
| Scalability | Средняя | Высокая | Очень высокая |
| Good for | VM, high-performance workloads вроде database | General-purpose file system access | Binary data, unstructured data |
Таблица 1 Storage options
Терминология
Чтобы спроектировать S3-подобное object storage, сначала нужно понимать базовые object storage concepts. В этом разделе зафиксируем основные термины.
Bucket. Логический container для objects. Имя bucket глобально уникально. Чтобы загрузить данные в S3, сначала нужно создать bucket.
Object. Отдельная единица данных, которую мы храним в bucket. Содержит object data (payload)
и metadata. Object data — это любая последовательность bytes, которую мы хотим сохранить.
Metadata — набор name-value pairs, описывающих object.
Versioning. Feature, позволяющая держать несколько versions одного object в одном bucket. Она включается на уровне bucket. Благодаря ей можно восстановить objects, случайно удаленные или перезаписанные.
Uniform Resource Identifier (URI). Object storage предоставляет RESTful APIs к своим resources — buckets и objects. Каждый resource однозначно идентифицируется своим URI.
Service-level agreement (SLA). Контракт между service provider и client. Например, storage class Amazon S3 Standard-Infrequent Access дает такой SLA [7]:
-
Designed for durability of 99.999999999% of objects across multiple Availability Zones.
-
Data is resilient even if one entire Availability Zone is destroyed.
-
Designed for 99.9% availability.
Шаг 1 — Понять задачу и определить рамки дизайна
Следующие вопросы помогают уточнить requirements и сузить scope.
Кандидат: Какие features должны войти в design?
Интервьюер: Нам нужна S3-like object storage system со следующими возможностями:
-
Создание bucket
-
Upload и download objects
-
Versioning objects
-
Listing objects in a bucket. Это похоже на команду
aws s3 ls[8]
Кандидат: Какой типичный размер данных?
Интервьюер: Нужно эффективно хранить и massive objects размером в несколько GB и больше, и
очень много small objects размером в десятки KB.
Кандидат: Сколько data нужно хранить за год?
Интервьюер: 100 petabytes (PB).
Кандидат: Можно считать, что durability data — 6 nines (99.9999%), а service availability —
4 nines (99.99%)?
Интервьюер: Да, звучит разумно.
Нефункциональные требования
-
100 PB data
-
Data durability — 6 nines
-
Service availability — 4 nines
-
Storage efficiency. Нужно снижать storage costs, сохраняя высокую reliability и приемлемую performance.
Back-of-the-envelope estimation
У object storage bottlenecks обычно лежат либо в disk capacity, либо в disk IOPS. Посмотрим приближенно.
-
Disk capacity. Предположим, objects распределены так:
-
20% — small objects (меньше 1MB)
-
60% — medium-sized objects (1MB ~ 64MB)
-
20% — large objects (больше 64MB)
-
-
IOPS. Предположим, один hard disk (SATA, 7200 rpm) умеет делать 100~150 random seeks per second (100-150 IOPS).
С этими assumptions можно оценить общее число objects, которое система сможет хранить. Для простоты возьмем median size каждого типа: 0.5MB для small, 32MB для medium и 200MB для large. При 40% storage usage ratio получаем:
-
100 PB = 100 * 1000 * 1000 * 1000 MB = 10^11 MB -
10^11 * 0.4 / (0.2 * 0.5MB + 0.6 * 32MB + 0.2 * 200MB) = 0.68 billion objects -
Если metadata одного object занимает около 1KB, то для всей metadata потребуется 0.68 TB
Даже если эти числа потом не будут использоваться напрямую, они помогают почувствовать масштаб и ограничения системы.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
Прежде чем углубляться в design, полезно проговорить несколько важных свойств object storage, потому что они сильно влияют на архитектуру.
Object immutability. Одно из ключевых отличий object storage от block и file storage в том, что objects внутри object storage immutable. Мы можем удалить object или целиком заменить его новой version, но не можем делать incremental updates.
Key-value store. Мы можем использовать object URI для retrieval object data, как в листинге 1. URI выступает как key, а object data — как value.
Request:
GET /bucket1/object1.txt HTTP/1.1

Response:
HTTP/1.1 200 OK
Content-Length: 4567

[4567 bytes of object data]
Листинг 1 Использование object URI для получения object data
Write once, read many times. Access pattern для object data — запись один раз и последующие многократные чтения. По данным LinkedIn, 95% requests — это read operations [9].
Поддержка и small, и large objects. Размер object может сильно варьироваться, и система должна работать хорошо в обоих случаях.
Философия object storage очень похожа на UNIX file system. В UNIX, когда мы сохраняем file в local
file system, имя файла и его data не хранятся вместе. Filename лежит в data structure под
названием inode [10], а file data — в разных местах disk. Inode содержит list of file block
pointers, указывающих на физические blocks file data. Когда мы читаем local file, сначала
получаем metadata из inode, а затем по file block pointers идем к actual disk locations.
Object storage работает похожим образом. Inode превращается в metadata store, который хранит object metadata. Hard disk превращается в data store, где лежит object data. В UNIX file system inode использует file block pointers, чтобы помнить местоположение data на disk. В object storage metadata store использует object ID, чтобы найти соответствующую object data в data store через network request. Это показано на рисунке 2.
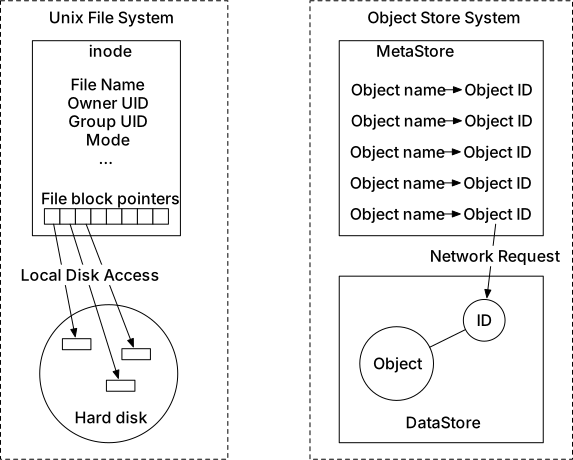
Рисунок 2 UNIX file system и object store
Разделение metadata и object data сильно упрощает design. Data store содержит immutable data, а metadata store — mutable data. Благодаря этому эти две части можно реализовывать и оптимизировать независимо. На рисунке 3 показано, как выглядят bucket и object.
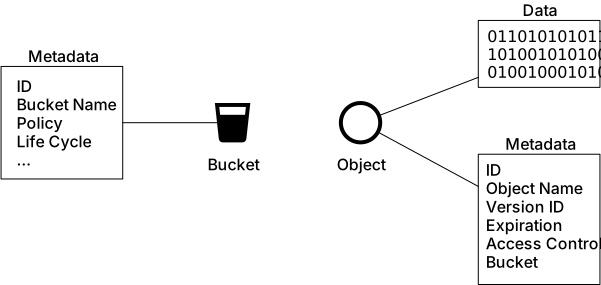
Рисунок 3 Bucket и object
High-level design
На рисунке 4 показан high-level design.
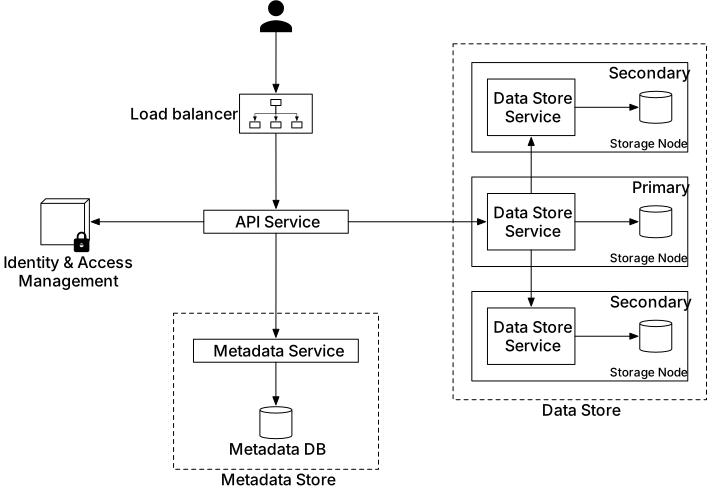
Рисунок 4 High-level design
Пройдемся по components по очереди.
Load balancer. Распределяет RESTful API requests между набором API servers.
API service. Оркестрирует remote procedure calls к identity and access management service, metadata service и storage stores. Это stateless service, поэтому ее легко scale horizontally.
Identity and access management (IAM). Центральное место для authentication, authorization и access control. Authentication проверяет, кто вы, а authorization — какие operations вам доступны.
Data store. Хранит и отдает actual object data. Все data-related operations опираются на object ID (UUID).
Metadata store. Хранит metadata объектов.
Заметим, что metadata store и data store — это логические components, а физически их можно реализовать по-разному. Например, в Ceph Rados Gateway [11] нет standalone metadata store: bucket и object data сохраняются как один или несколько Rados objects.
Теперь, когда high-level design понятен, разберем главные workflows:
-
Uploading an object
-
Downloading an object
-
Object versioning и listing objects in a bucket — обсудим в deep dive
Uploading an object
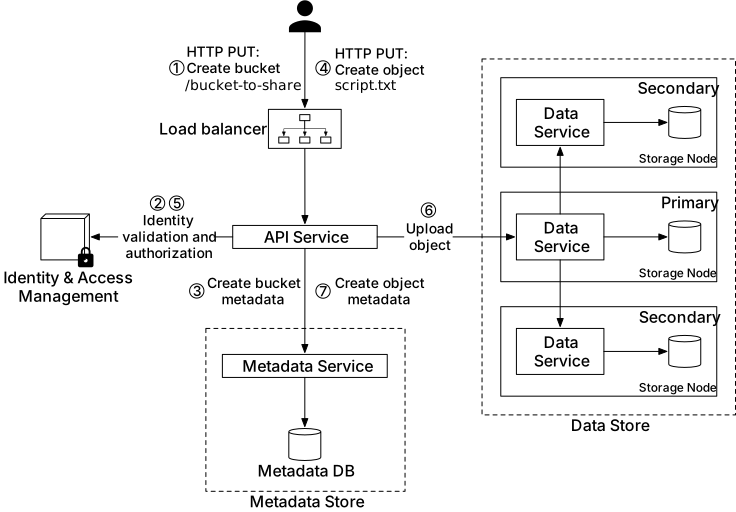
Рисунок 5 Uploading an object
Object должен находиться внутри bucket. В примере сначала создадим bucket с именем
bucket-to-share, а потом загрузим в него file script.txt. Рисунок 5 объясняет flow из 7
шагов.
-
Client отправляет HTTP PUT request на создание bucket
bucket-to-share. Request идет в API service. -
API service вызывает IAM, чтобы убедиться, что user авторизован и имеет WRITE permission.
-
API service вызывает metadata store, чтобы создать entry с bucket info в metadata database. После успешного создания client получает success response.
-
После создания bucket client отправляет HTTP PUT request на создание object
script.txt. -
API service проверяет identity пользователя и наличие WRITE permission на этот bucket.
-
После успешной validation API service отправляет object data из HTTP PUT payload в data store. Data store сохраняет payload как object и возвращает UUID object-а.
-
API service вызывает metadata store, чтобы создать новый entry в metadata database. Там хранятся важные metadata:
object_id(UUID),bucket_id(к какому bucket принадлежит object),object_nameи т. д. Пример такой записи показан в таблице 2.
| object_name | object_id | bucket_id |
|---|---|---|
| script.txt | 239D5866-0052-00F6-014E-C914E61ED42B | 82AA1B2E-F599-4590-B5E4-1F51AAE5F7E4 |
Таблица 2 Пример metadata entry
API для upload object может выглядеть так:
PUT /bucket-to-share/script.txt HTTP/1.1
Host: foo.s3example.org
Date: Sun, 12 Sept 2021 17:51:00 GMT
Authorization: authorization string
Content-Type: text/plain
Content-Length: 4567
x-amz-meta-author: Alex

[4567 bytes of object data]
Листинг 2 Uploading an object
Downloading an object
У bucket нет directory hierarchy. Но логическую hierarchy можно симулировать, если включать bucket
name в object name. Например, вместо script.txt назвать object
bucket-to-share/script.txt. Тогда для получения object в GET request указывается object name.
API для download object выглядит так:
GET /bucket-to-share/script.txt HTTP/1.1
Host: foo.s3example.org
Date: Sun, 12 Sept 2021 18:30:01 GMT
Authorization: authorization string
Листинг 3 Downloading an object
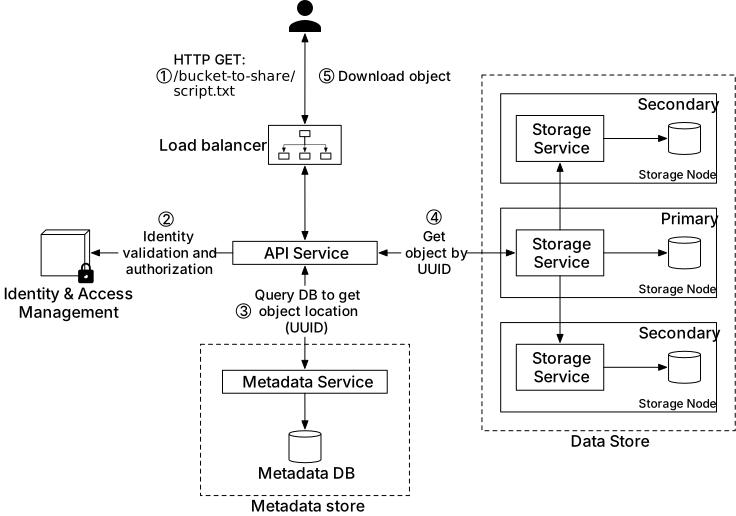
Рисунок 6 Downloading an object
Как уже говорилось, data store не хранит object name и поддерживает operations только через
object_id (UUID). Значит, чтобы скачать object, сначала нужно отобразить object name в UUID.
Workflow download object такой:
-
Client отправляет HTTP GET request на load balancer:
GET /bucket-to-share/script.txt -
API service обращается к IAM и проверяет, что user имеет READ access к bucket.
-
После validation API service получает UUID соответствующего object из metadata store.
-
Дальше API service запрашивает object data из data store по UUID.
-
API service возвращает object data client-у в HTTP GET response.
Шаг 3 — Погружение в детали дизайна
В этом разделе углубимся в несколько важных областей:
-
Data store
-
Metadata data model
-
Listing objects in a bucket
-
Object versioning
-
Optimizing uploads of large files
-
Garbage collection
Data store
Посмотрим ближе на design data store. Как уже говорилось, API service принимает внешние requests от users и вызывает внутренние services. Чтобы сохранить или получить object, API service вызывает data store. На рисунке 7 показаны interactions между API service и data store для upload/download object.
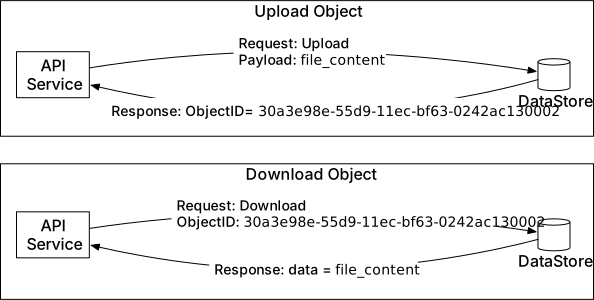
Рисунок 7 Upload и download an object
High-level design data store
У data store есть три главных components, показанные на рисунке 8.
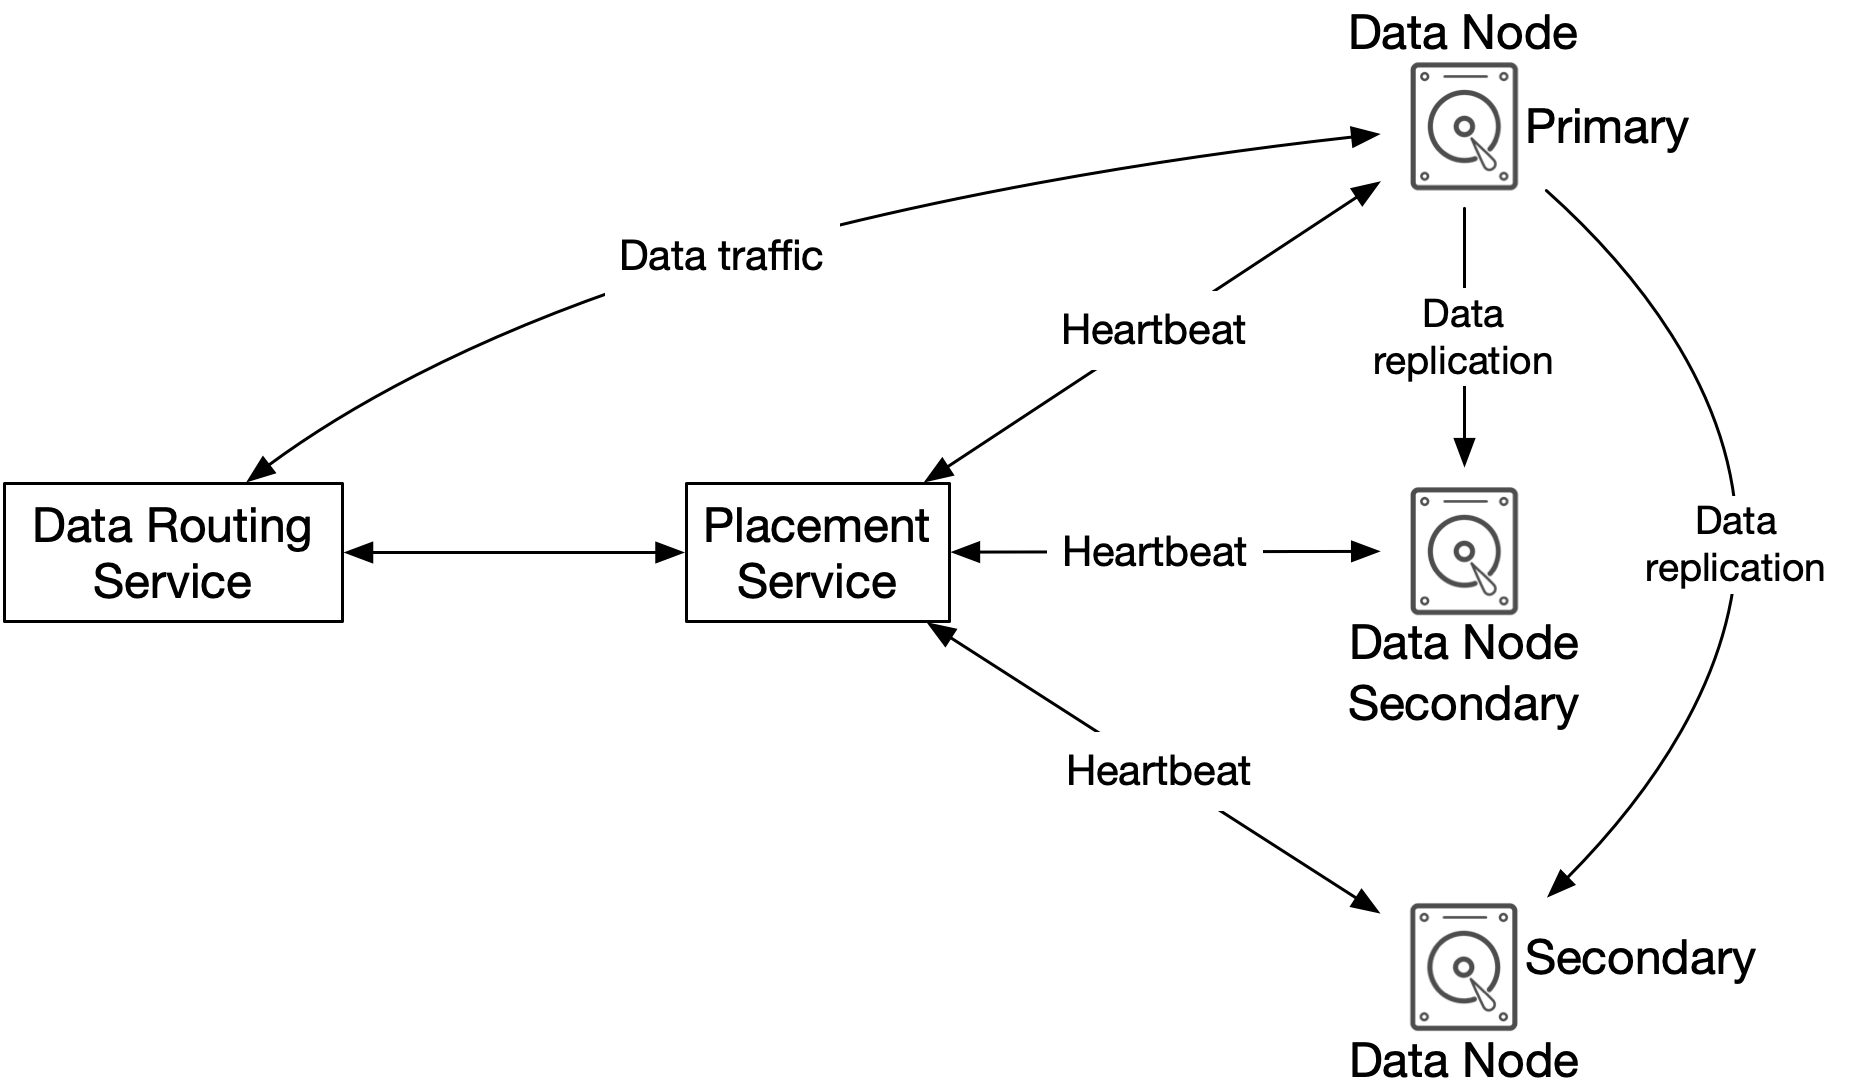
Рисунок 8 Components data store
Data routing service
Data routing service предоставляет RESTful или gRPC [12] APIs для доступа к cluster data nodes. Это stateless service, поэтому она масштабируется простым добавлением servers. У нее такие responsibilities:
-
Query placement service, чтобы выбрать best data node для хранения data
-
Read data из data nodes и возвращать ее API service
-
Write data в data nodes
Placement service
Placement service определяет, какие data nodes (primary и replicas) должны хранить object. Она
поддерживает virtual cluster map, описывающую physical topology cluster. В virtual cluster map
есть location info для каждого data node, и placement service использует ее, чтобы физически
разносить replicas. Это критично для высокой durability. Подробнее — в разделе Durability ниже.
Пример такой virtual cluster map показан на рисунке 9.
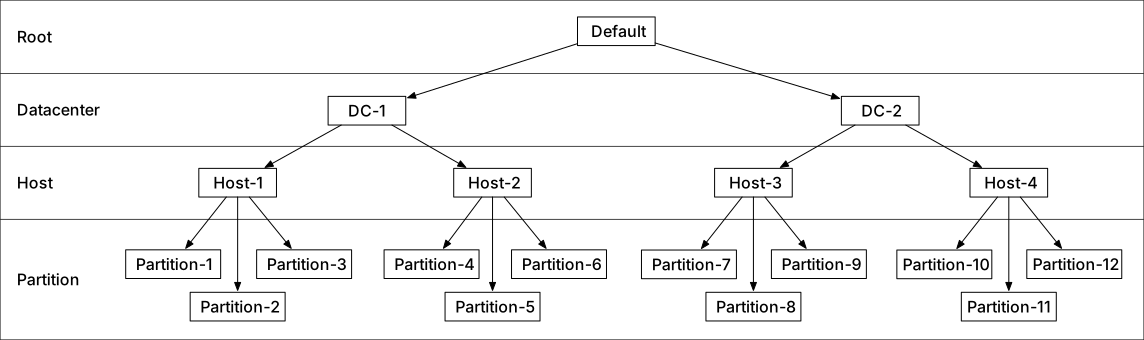
Рисунок 9 Virtual cluster map
Placement service постоянно мониторит все data nodes через heartbeats. Если data node не присылает
heartbeat в течение настраиваемого grace period, например 15 секунд, placement service помечает
node как down в virtual cluster map.
Это критически важный service, поэтому разумно строить cluster из 5 или 7 placement service nodes с Paxos [13] или Raft [14]. Consensus protocol гарантирует, что пока больше половины nodes здоровы, service продолжает работать. Например, cluster из 7 nodes выдержит отказ 3 nodes.
Data node
Data node хранит actual object data. Надежность и durability обеспечиваются replication на несколько data nodes, то есть на replication group.
На каждом data node работает data service daemon. Она непрерывно шлет heartbeats в placement service. В heartbeat message входит такая essential info:
-
Сколько disk drives (HDD или SSD) управляется этим data node
-
Сколько data хранится на каждом drive
Когда placement service впервые получает heartbeat от node, она:
-
назначает уникальный ID data node
-
добавляет node в virtual cluster map
-
возвращает:
-
уникальный ID data node
-
virtual cluster map
-
информацию о том, куда replicate data
-
Data persistence flow
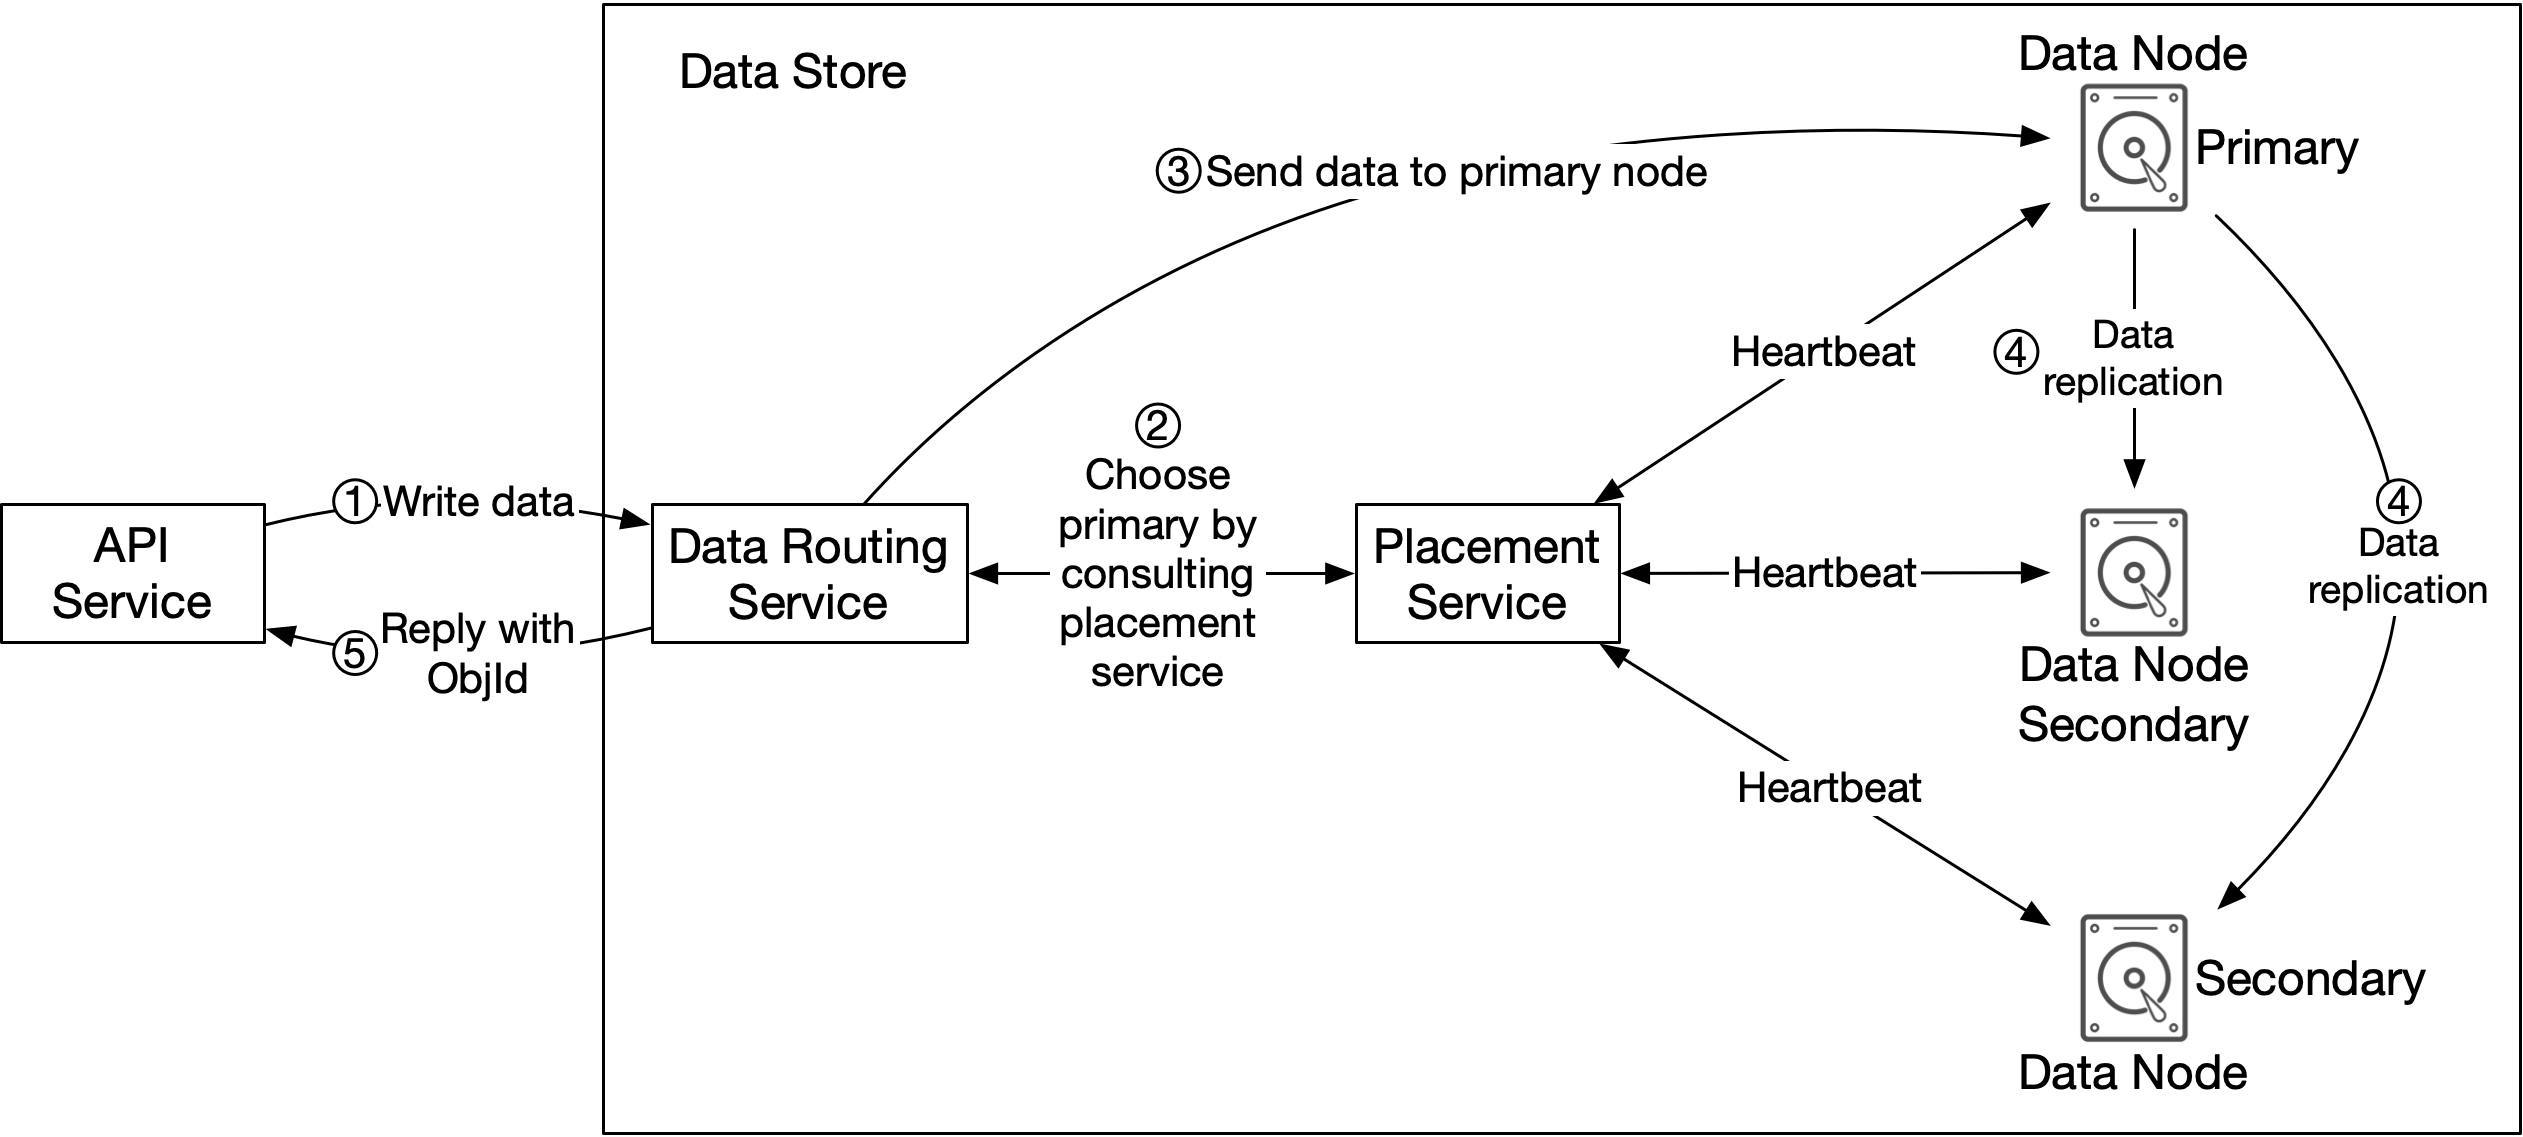
Рисунок 10 Data persistence flow
Теперь посмотрим, как data сохраняется в data node.
-
API service передает object data в data store.
-
Data routing service генерирует UUID для object и спрашивает у placement service, на какой data node его сохранить. Placement service смотрит в virtual cluster map и возвращает primary data node.
-
Data routing service отправляет data напрямую на primary data node вместе с UUID.
-
Primary data node сохраняет data локально и replicates ее на два secondary data nodes. Ответ в data routing service возвращается только после того, как репликация на все secondaries завершена.
-
UUID object (
ObjId) возвращается в API service.
На шаге 2 placement service по UUID object должна deterministically вернуть replication group, и это должно переживать добавление/удаление replication groups. Обычный способ — consistent hashing [15].
На шаге 4 primary node replicates data на все secondary nodes до возврата response. Это дает strong consistency между data nodes, но увеличивает latency, потому что приходится ждать самую медленную replica. На рисунке 11 показан trade-off between consistency and latency.
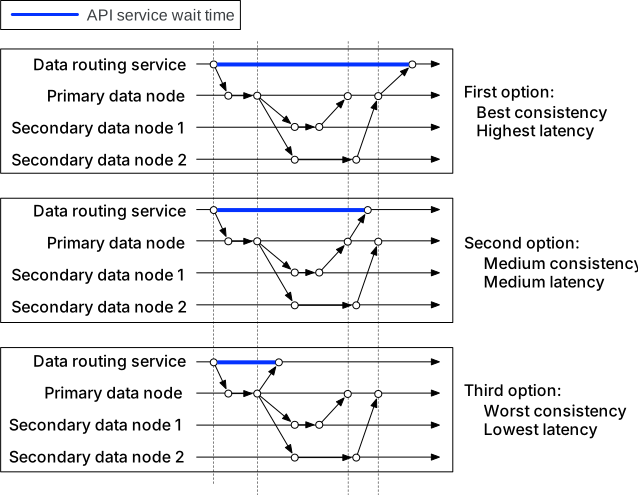
Рисунок 11 Trade-off between consistency and latency
-
Data считается сохраненной только после записи на все три nodes. Это лучший consistency, но самая высокая latency.
-
Data считается сохраненной после записи на primary и одну secondary. Это средние consistency и latency.
-
Data считается сохраненной после persistence только на primary. Это худшая consistency, но минимальная latency.
Подходы 2 и 3 — это eventual consistency.
How data is organized
Теперь посмотрим, как data организуется внутри каждого data node. Самое простое решение — хранить каждый object как отдельный file. Это работает, но сильно теряет в performance, если objects мелкие. Возникают две проблемы.
Во-первых, тратится много disk blocks впустую. File system хранит files в дискретных disk blocks. Размер blocks одинаковый и фиксируется при инициализации volume. Типичный block size около 4KB. Даже file меньше 4KB все равно займет целый block. Если file system хранит много small files, получается большой waste blocks.
Во-вторых, можно уткнуться в inode capacity. File system хранит местоположение и другие details
про file в special block под названием inode. Для большинства file systems число inodes
фиксируется при инициализации disk. Миллионы small files могут выбить все inodes. Кроме того,
operating system плохо справляется с очень большим числом inodes, даже при aggressive metadata
caching. Поэтому хранить small objects как individual files на практике плохо.
Чтобы решить проблему, можно merge-ить many small objects в один large file. Концептуально это похоже на write-ahead log (WAL). Когда мы сохраняем object, он append-ится в существующий read-write file. Когда read-write file достигает threshold, обычно в несколько GB, он помечается как read-only, а для новых objects создается новый read-write file. Read-only file обслуживает только read requests. Это показано на рисунке 12.

Рисунок 12 Хранение многих small objects в одном big file
Важно, что write access к read-write file должен быть serialized. Как видно на рисунке 12, objects лежат в файле по порядку, один за другим. Чтобы сохранить такой on-disk layout, multiple cores, обрабатывающие incoming writes in parallel, должны писать по очереди. На современном server это сильно ограничивает write throughput. Чтобы ослабить bottleneck, можно выделять dedicated read-write files по одному на каждое core.
Object lookup
Если внутри data file лежит много small objects, как data node найдет object по UUID? Ей нужны:
-
Data file, содержащий object
-
Start offset object внутри file
-
Object size
Schema для такого lookup показана в таблице 3.
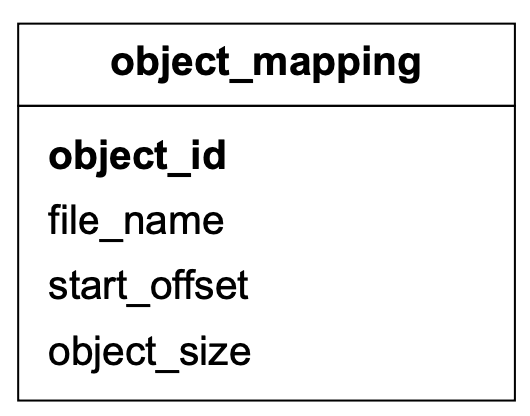
Таблица 3 Object_mapping table
| Field | Описание |
|---|---|
| object_id | UUID object |
| file_name | Имя file, содержащего object |
| start_offset | Начальный адрес object внутри file |
| object_size | Размер object в bytes |
Таблица 4 Поля object_mapping
Мы рассматривали два варианта хранения mapping:
-
File-based key-value store вроде RocksDB [16]
-
Relational database
RocksDB основана на SSTable [17], быстро пишет, но медленнее читает. Relational database обычно использует B+ tree [18] storage engine, поэтому быстрее читает, но медленнее пишет. Ранее мы уже отмечали, что access pattern здесь — write once, read many times. Поэтому relational database лучше подходит, чем RocksDB.
Как deploy-ить эту relational database? На нашем масштабе объем mapping data большой. Можно было бы держать единый крупный cluster на все data nodes, но этим сложно управлять. Заметим, что mapping data изолирована внутри каждого data node и не требует sharing между nodes. Поэтому можно просто держать локальную relational database на каждом data node. Хороший кандидат — SQLite [19], это file-based relational database с очень хорошей репутацией.
Updated data persistence flow
Раз мы внесли заметные изменения в design data node, пересоберем persistence flow еще раз (рисунок 13).
-
API service отправляет request на сохранение нового object
object 4. -
Data node service append-ит
object 4в конец read-write file/data/c. -
Новый record для
object 4вставляется в tableobject_mapping. -
Data node service возвращает UUID обратно API service.
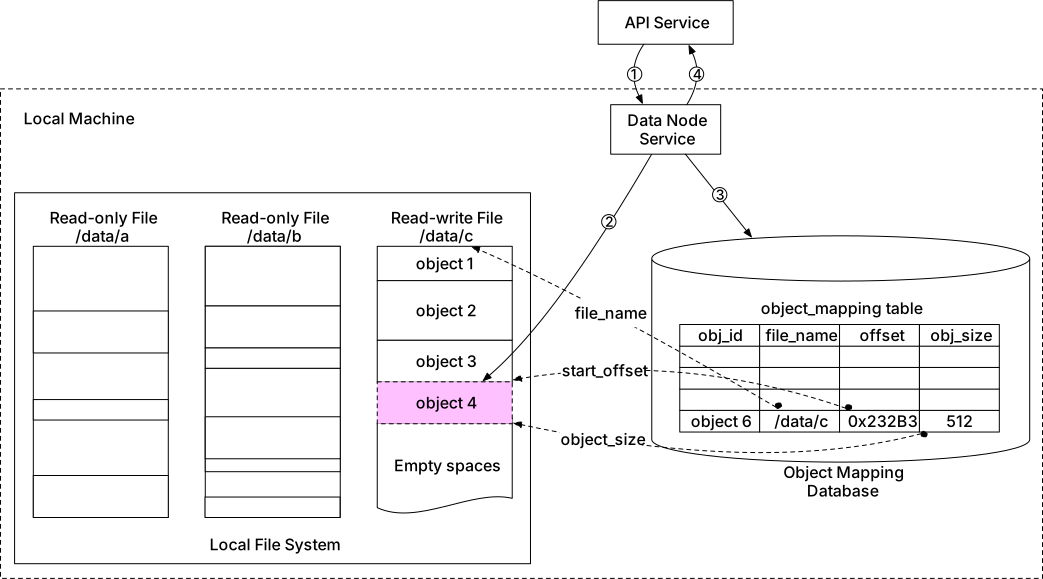
Рисунок 13 Updated data persistence flow
Durability
Data reliability чрезвычайно важна для storage systems. Как построить storage system с six nines durability? Нужно аккуратно учитывать каждый failure case и правильно replicate data.
Hardware failure и failure domain
Failures hard drives неизбежны независимо от media type. Какие-то носители надежнее других, но на single hard drive рассчитывать нельзя. Проверенный способ повысить durability — replicate data на несколько hard drives, чтобы failure одного disk не влиял на availability data в целом. В нашем design data replicates three times.
Предположим, spinning hard drive имеет annual failure rate 0.81% [20]. Это сильно зависит от
модели и производителя. Если хранить 3 copies data, получаем
1 - (0.0081)^3 = ~0.999999 reliability. Это грубая оценка; для более точных расчетов стоит
смотреть [20].
Для полного анализа durability надо учитывать и разные failure domains. Failure domain — это physical или logical часть окружения, которая затрагивается, если critical service испытывает problem. В современном data center server обычно стоит в rack [21], racks собираются в rows, floors, rooms. Так как rack делит network switches и power, все servers в rack принадлежат одному rack-level failure domain. Внутри самого server общими являются motherboard, CPU, power supply, HDD drives и т. д. Это node-level failure domain.
Хороший пример изоляции failure domains на масштабе — Availability Zones (AZs). Обычно data centers делят infrastructure, не разделяющую critical dependencies, на разные AZs. Мы replicates data в разные AZs, чтобы уменьшить impact failures (рисунок 14). Выбор failure domain level сам по себе не увеличивает математическую durability data напрямую, но сильно повышает reliability в extreme cases: large-scale outages, cooling failures, natural disasters и т. д.
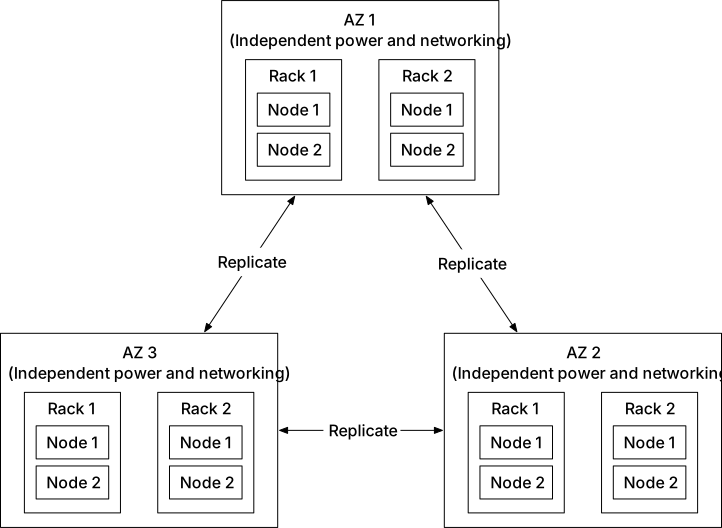
Рисунок 14 Multi-datacenter replication
Erasure coding
Три полные copies data дают нам примерно 6 nines durability. Можно ли увеличить durability еще
сильнее? Да, один из вариантов — erasure coding [22]. Она подходит к durability иначе:
разбивает data на chunks, распределяет их по разным servers и добавляет parities для redundancy.
При failures исходную data можно reconstruct-ить из chunks и parities. Рассмотрим пример
(4 + 2) erasure coding на рисунке 15.
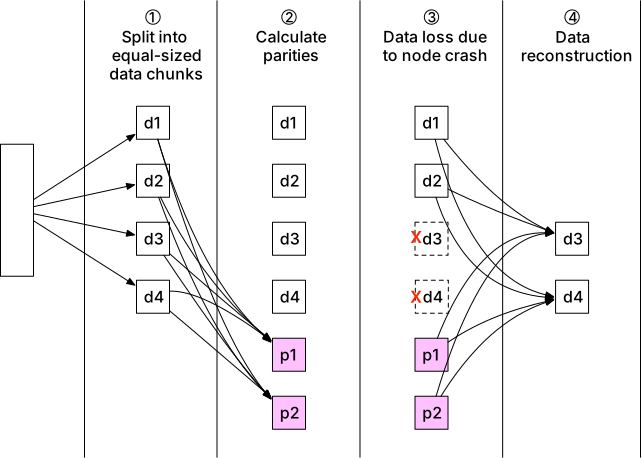
Рисунок 15 Erasure coding
-
Data разбивается на четыре равных chunks:
d1,d2,d3,d4. -
По математической формуле [23] вычисляются parities
p1иp2. В сильно упрощенном виде:p1 = d1 + 2*d2 - d3 + 4*d4, аp2 = -d1 + 5*d2 + d3 - 3*d4[24]. -
Data
d3иd4теряется из-за node crashes. -
Исходные
d3иd4reconstruct-ятся из известныхd1,d2,p1иp2.
Еще один пример — рисунок 16, чтобы лучше увидеть связь erasure coding с failure domains.
(8+4) erasure coding разбивает исходную data на 8 chunks и вычисляет 4 parities. Все 12 pieces
имеют одинаковый размер и распределены по 12 разным failure domains. Математика гарантирует, что
исходную data можно восстановить, если down не более 4 nodes.
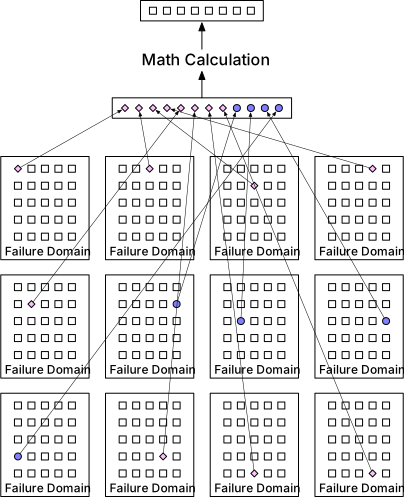
Рисунок 16 (8+4) erasure coding
В отличие от replication, где data router читает object data с одного healthy node, при erasure coding data router должен читать данные хотя бы с 8 healthy nodes. Это архитектурный trade-off: более сложное решение и более медленный access в обмен на higher durability и lower storage cost. Для object storage, где основной cost — storage, такой trade-off может быть оправдан.
Сколько extra space требует erasure coding? На каждые две chunks data нужна одна parity block, то есть storage overhead равен 50% (рисунок 17). Для 3-copy replication storage overhead равен 200%.
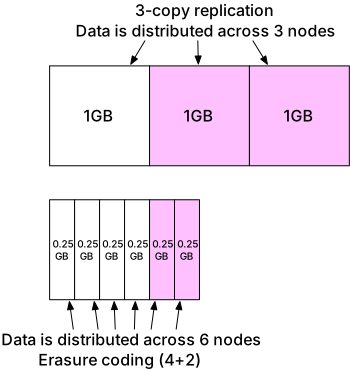
Рисунок 17 Extra space for replication and erasure coding
Увеличивает ли erasure coding durability? Если считать annual failure rate node равным 0.81%, по оценкам Backblaze [20] erasure coding может дать 11 nines durability. Расчет там довольно сложный, поэтому в детали не идем.
Таблица 5 сравнивает replication и erasure coding.
| Replication | Erasure coding | |
|---|---|---|
| Durability | 6 nines durability (3 copies data) | 11 nines durability для (8+4). Erasure coding выигрывает |
| Storage efficiency | 200% storage overhead | 50% storage overhead. Erasure coding выигрывает |
| Compute resource | Вычисления не нужны. Replication выигрывает | Требуется вычислять parities |
| Write performance | Просто replication на nodes, без computation. Replication выигрывает | Более высокая write latency из-за расчета parities |
| Read performance | В норме чтение идет с одной replica; при failure режим чтения почти не страдает | Даже в норме чтение идет с нескольких nodes; при failure reconstruction медленнее |
Таблица 5 Replication vs erasure coding
Итог такой: replication широко используется в latency-sensitive applications, а erasure coding — там, где нужно минимизировать storage cost. Она очень привлекательна по cost efficiency и durability, но заметно усложняет design data node. Поэтому в этой главе основное внимание мы уделяем replication.
Correctness verification
Erasure coding повышает durability при разумном storage overhead. Но есть еще одна сложная проблема: data corruption.
Если disk полностью fail-ится, и этот отказ можно детектировать, его можно рассматривать как data node failure. В таком случае data можно reconstruct-ить через erasure coding. Но in-memory data corruption — обычное явление в large-scale systems.
Решение — проверка checksums [25] между process boundaries. Checksum — это маленький блок data, используемый для обнаружения ошибок. На рисунке 18 показано, как checksum вычисляется.
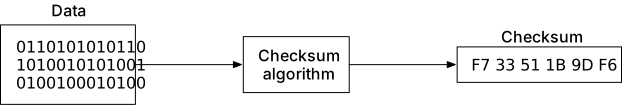
Рисунок 18 Generate checksum
Если checksum исходной data известна, можно вычислить checksum после transmission:
-
Если они разные — data corrupted
-
Если одинаковые — с очень высокой вероятностью data не испорчена
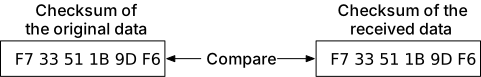
Рисунок 19 Compare checksums
Checksum algorithms много: MD5 [26], SHA1 [27], HMAC [28] и т. д. Хороший algorithm сильно меняет output даже при малом изменении input. В этой главе возьмем простой вариант вроде MD5.
В нашем design checksum append-ится в конец каждого object. Перед тем как file будет помечен read-only, мы добавляем checksum всего file в его конец. Это показано на рисунке 20.
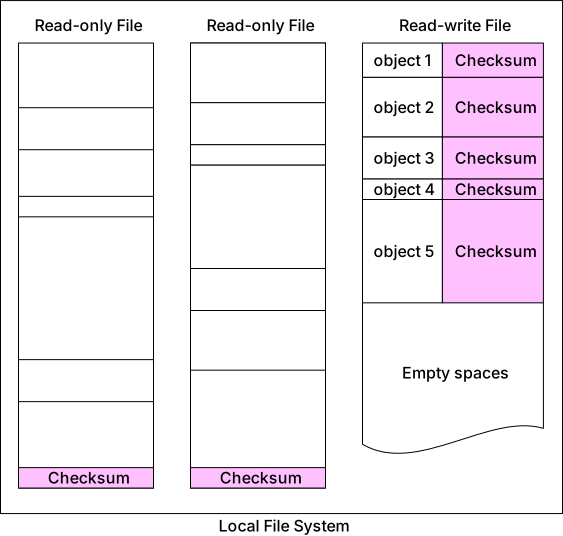
Рисунок 20 Add checksum to data node
С (8+4) erasure coding и checksum verification чтение data выглядит так:
-
Получаем object data и checksum.
-
Считаем checksum по полученной data.
(a). Если checksums совпали, data корректна.
(b). Если не совпали, data corrupted. Тогда пытаемся восстановиться, читая data из других failure domains.
-
Повторяем шаги 1 и 2, пока не получим все 8 pieces data. После этого reconstruct-им исходную data и возвращаем ее client.
Metadata data model
В этом разделе сначала обсудим database schema, а потом то, как масштабировать metadata DB.
Schema
Schema должна поддерживать три основных queries:
Query 1: Найти object ID по object name.
Query 2: Вставить и удалить object по object name.
Query 3: List objects in a bucket, sharing the same prefix.
На рисунке 21 показан schema design. Нам нужны две database tables: bucket и object.
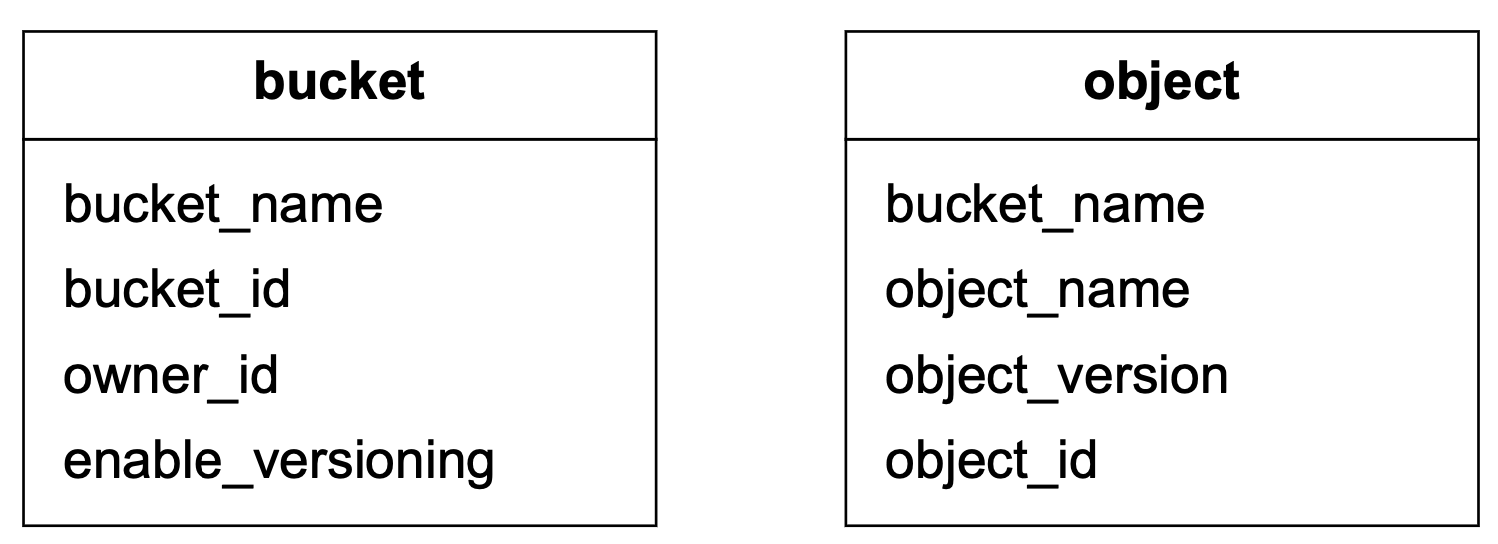
Рисунок 21 Database tables
Scale the bucket table
Обычно на число buckets, которое может создать один user, есть limit, поэтому размер bucket table
небольшой. Предположим, у нас 1 миллион customers, каждый владеет 10 buckets, а каждая запись
занимает 1KB. Тогда понадобится всего 10GB (1 million * 10 * 1KB) storage. Такая table легко
поместится на современном database server. Но single database server может не иметь достаточно CPU
или network bandwidth для всех read requests. Тогда можно разнести read load по нескольким
database replicas.
Scale the object table
Object table хранит object metadata. На нашем масштабе dataset, скорее всего, уже не поместится в один database instance. Значит, ее нужно sharding.
Один вариант — shard by bucket_id, чтобы все objects в bucket лежали на одном shard. Это плохо, потому что bucket может содержать миллиарды objects и станет hotspot shard.
Другой вариант — shard by object_id. Это красиво балансирует load, но queries 1 и 2 становятся неэффективными, потому что обе основаны на URI.
Мы выбираем sharding по комбинации bucket_name и object_name. Большинство metadata operations
основаны именно на object URI: поиск object ID по URI, upload по URI и т. д. Чтобы распределить
data равномерно, можно использовать hash от (_bucket_name_, _object_name_) как sharding key.
При такой sharding scheme первые два queries поддерживаются просто, а вот listing уже сложнее.
Listing objects in a bucket
Object store хранит files в flat structure, а не как file system hierarchy. Object доступен по path
формата s3://bucket-name/object-name. Например, s3://mybucket/abc/d/e/f/file.txt содержит:
-
Bucket name:
mybucket -
Object name:
abc/d/e/f/file.txt
Чтобы users могли логически организовывать objects внутри bucket, S3 вводит concept prefixes.
Prefix — это string в начале object name. S3 использует prefixes как аналог directories, хотя
технически directories здесь нет. Listing by prefix просто ограничивает results объектами, чьи
имена начинаются с этого prefix.
В примере s3://mybucket/abc/d/e/f/file.txt prefix равен abc/d/e/f/.
У AWS S3 listing command есть три типичных use cases:
- List all buckets owned by a user:
aws s3 list-buckets
- List all objects in a bucket that are at the same level as the specified prefix:
aws s3 ls s3://mybucket/abc/
В этом режиме objects, у которых после prefix есть дополнительные /, сворачиваются в common
prefix. Например, если в bucket лежат:
CA/cities/losangeles.txt
CA/cities/sanfrancisco.txt
NY/cities/ny.txt
federal.txt
Тогда listing bucket с prefix / вернет:
CA/ NY/ federal.txt
- Recursively list all objects in a bucket that share the same prefix:
aws s3 ls s3://mybucket/abc/ --recursive
В том же примере listing bucket с prefix CA/ вернет:
CA/cities/losangeles.txt
CA/cities/sanfrancisco.txt
Single database
Сначала посмотрим, как listing поддерживается на single database.
Чтобы list all buckets owned by a user:
SELECT * FROM bucket WHERE owner_id={id}
Чтобы list all objects in a bucket sharing the same prefix:
SELECT * FROM object WHERE bucket_id = "123" AND object_name LIKE `abc/%`
Здесь мы получаем все objects с bucket_id = "123", у которых prefix равен abc/. Если после
prefix в именах есть дополнительные /, они сворачиваются в application code, как и говорилось
во втором use case.
Этот же query поддерживает recursive mode из третьего use case — просто application code не делает rollups, а возвращает все objects with the same prefix.
Distributed databases
Когда metadata table sharded, listing становится сложнее, потому что заранее неясно, какие shards содержат нужные data. Самое очевидное решение — выполнять search query по всем shards и потом агрегировать результаты. Для этого можно:
- Metadata service запускает на каждом shard такой query:
SELECT * FROM object WHERE bucket_id = "123" AND object_name LIKE `a/b/%`
- Metadata service агрегирует объекты со всех shards и возвращает caller-у.
Это работает, но pagination становится неприятно сложной. Сначала вспомним, как pagination делает single database. Чтобы вернуть pages по 10 objects на страницу, SELECT query будет начинаться так:
SELECT * FROM object WHERE
bucket_id = "123" AND object_name LIKE `a/b/%`
ORDER BY object_name OFFSET 0 LIMIT 10
OFFSET и LIMIT ограничивают results первыми 10 objects. В следующем request client присылает
hint серверу, чтобы тот построил query уже с OFFSET 10. Обычно это оформляется через cursor,
который server возвращает с каждой page. В cursor зашит offset. Client передает cursor в next
request, server его декодирует и строит следующий query. Для второй page это будет:
SELECT * FROM metadata
WHERE bucket_id = "123" AND object_name LIKE `a/b/%`
ORDER BY object_name OFFSET 10 LIMIT 10
Такой request loop продолжается, пока server не вернет special cursor, означающий end of listing.
Теперь видно, почему это сложно на sharded databases. Objects размазаны по shards, и каждый shard вернет разное число results: кто-то полную page, кто-то частичную, кто-то ничего. Application code должен получить results со всех shards, aggregate и sort, а потом вернуть только page из 10 objects. Объекты, не вошедшие в текущую page, придется снова учитывать в следующем round. А значит, у каждого shard будет свой собственный offset. Server обязан отслеживать offsets для всех shards и зашивать их в cursor. При сотнях shards offsets тоже будут сотни.
У нас есть решение, которое это упрощает, но с trade-offs. Поскольку object storage оптимизируется
под huge scale и high durability, object listing редко является top priority. Более того,
коммерческие object storages обычно поддерживают listing с sub-optimal performance. Можно
воспользоваться этим и денормализовать listing data в отдельную table, sharded by bucket_id.
Эта table используется только для listing. Тогда даже buckets с миллиардами objects смогут давать
приемлемую performance, а listing будет изолирован внутри single database, что сильно упрощает
implementation.
Object versioning
Versioning — это feature, которая хранит multiple versions одного object в bucket. Она позволяет восстанавливать objects, случайно удаленные или перезаписанные. Например, мы можем изменить document и сохранить его под тем же именем в том же bucket. Без versioning старая metadata будет заменена новой, а old version document будет помечена deleted, чтобы garbage collector потом освободил ее storage. С versioning object storage сохраняет все previous versions в metadata store, а old versions в object store не помечаются deleted.
На рисунке 22 показано, как upload-ится versioned object. Для этого сначала нужно enable versioning на bucket.
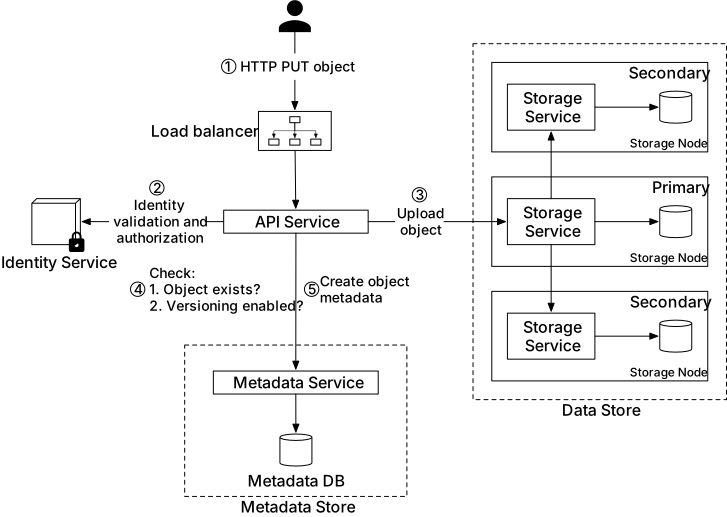
Рисунок 22 Object versioning
-
Client отправляет HTTP PUT request на upload object
script.txt. -
API service проверяет identity user и WRITE permission на bucket.
-
После validation API service загружает data в data store. Data store сохраняет ее как new object и возвращает new UUID.
-
API service вызывает metadata store, чтобы сохранить metadata info object.
-
Для versioning object table в metadata store имеет колонку
object_version, которая используется только если versioning enabled. Вместо overwrite existing record вставляется новый record с тем жеbucket_idиobject_name, но с новымobject_idи новымobject_version.object_id— это UUID, полученный на шаге 3, аobject_version— TIMEUUID [29], созданный в момент insert. Независимо от выбора database, lookup current version должен быть эффективным. Current version — та, у которой largest TIMEUUID среди всех entries с одинаковымobject_name.
Это иллюстрирует рисунок 23.
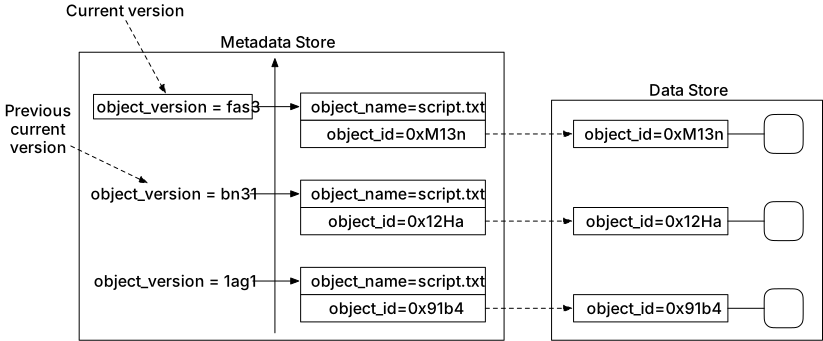
Рисунок 23 Versioned metadata
Versioned object можно не только upload-ить, но и delete-ить.
При delete object все его versions остаются в bucket, а мы просто insert-им delete marker, как на рисунке 24.
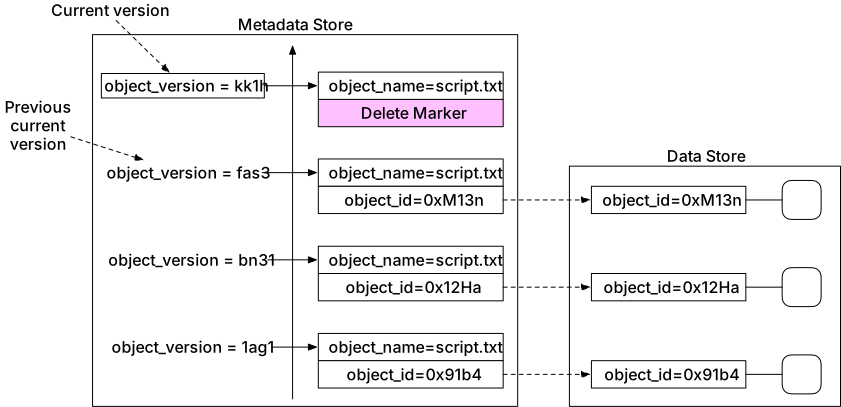
Рисунок 24 Delete object by inserting a delete marker
Delete marker — это новая version object, и после insert она становится current version. Если
сделать GET request в момент, когда current version является delete marker, storage вернет
404 Object Not Found.
Optimizing uploads of large files
В back-of-the-envelope estimation мы предполагали, что 20% objects — large. Некоторые из них могут быть больше нескольких GB. Теоретически такой large file можно upload-ить напрямую, но это долго. Если сеть оборвется посередине upload, все придется начинать сначала. Гораздо лучше нарезать large object на smaller parts и upload-ить их независимо. Когда все parts загружены, object store собирает final object из частей. Этот процесс называется multipart upload.
На рисунке 25 показано, как multipart upload работает.
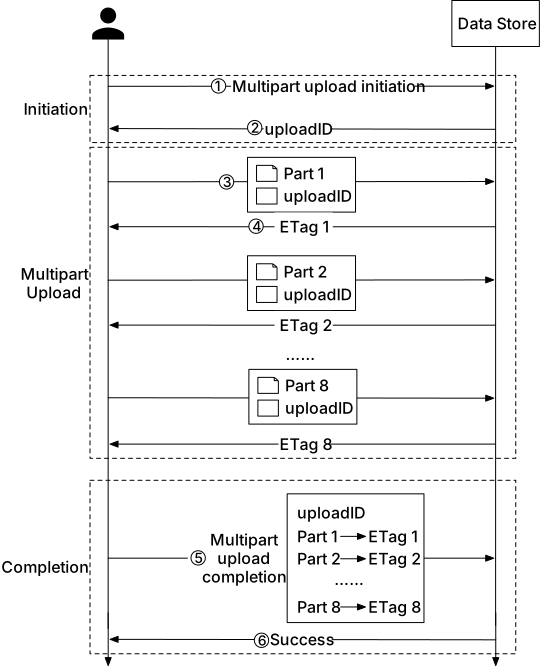
Рисунок 25 Multipart upload
-
Client вызывает object storage, чтобы инициировать multipart upload.
-
Data store возвращает
uploadID, который uniquely identifies upload. -
Client режет large file на smaller objects и начинает upload. Допустим, размер file 1.6GB, и client делит его на 8 parts по 200MB. Затем загружает first part вместе с
uploadID. -
Когда очередной part успешно uploaded, data store возвращает
ETag, который по сути является md5 checksum этого part. Он нужен для verify multipart uploads. -
После загрузки всех parts client шлет complete multipart upload request, включающий
uploadID, part numbers иETags. -
Data store reassembles object из parts согласно их part numbers. Так как object очень большой, это может занять несколько минут. После завершения client получает success response.
Потенциальная проблема такого подхода в том, что после reassembly old parts больше не нужны. Чтобы не захламлять storage, можно ввести garbage collection service, которая будет освобождать space от parts, больше не нужных системе.
Garbage collection
Garbage collection — это процесс автоматического reclaim storage space, которая больше не используется. Data может стать garbage несколькими способами:
-
Lazy object deletion. Object помечен как deleted, но физически еще не удален.
-
Orphan data. Например, half-uploaded data или abandoned multipart uploads.
-
Corrupted data. Data, не прошедшая checksum verification.
Garbage collector не удаляет objects из data store сразу. Deleted objects чистятся периодически через compaction.
Garbage collector также отвечает за reclaim unused space в replicas. Для replication object
удаляется и с primary, и со всех backup nodes. Для erasure coding в (8+4) setup — со всех
12 nodes.
На рисунке 26 показан пример compaction.
-
Garbage collector копирует objects из
/data/bв новый file/data/d. Обратите внимание:Object 2иObject 5пропускаются, потому что их delete flag =true. -
После копирования всех objects garbage collector обновляет
object_mappingtable. Например, уObject 3поляobj_idиobject_sizeостаются прежними, аfile_nameиstart_offsetменяются на новые значения. Чтобы обеспечить consistency, обновлениеfile_nameиstart_offsetстоит оборачивать в database transaction.
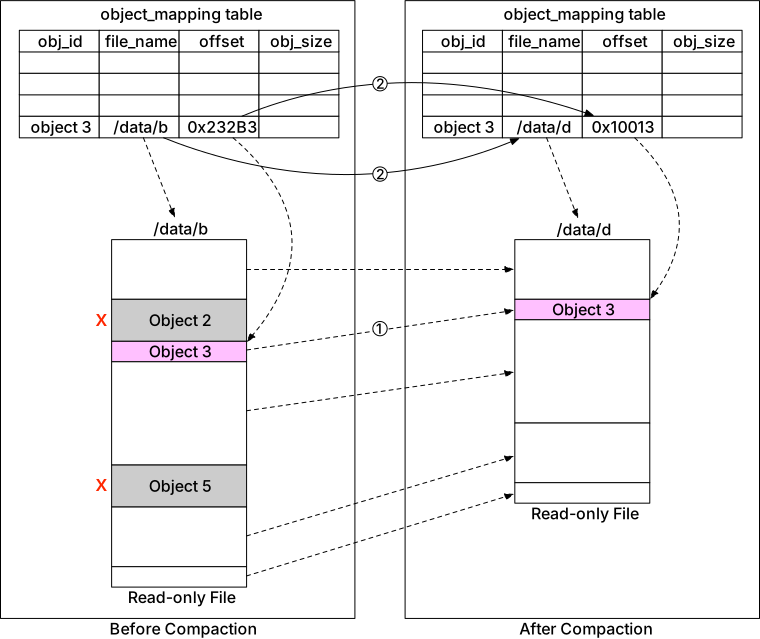
Рисунок 26 Compaction
Как видно на рисунке 26, новый file после compaction меньше старого. Чтобы не плодить много small files, garbage collector обычно ждет, пока накопится достаточно read-only files, и затем compaction append-ит objects из многих old files в несколько new large files.
Шаг 4 — Итоги
В этой главе мы описали high-level design для S3-подобного object storage. Сначала сравнили block storage, file storage и object storage.
Основной фокус задачи — именно object storage, поэтому отдельно разобрали, как обычно устроены uploading, downloading, listing objects in a bucket и object versioning.
Затем мы углубились в design. Object storage состоит из data store и metadata store. Мы объяснили, как data persists в data store, и обсудили два способа повышения reliability и durability: replication и erasure coding. Для metadata store объяснили, как работает multipart upload и как спроектировать database schema под основные use cases. Наконец, показали, как shard metadata store для еще большего data volume.
Поздравляю, вы дошли до конца. Можно похлопать себе по плечу — хорошая работа.
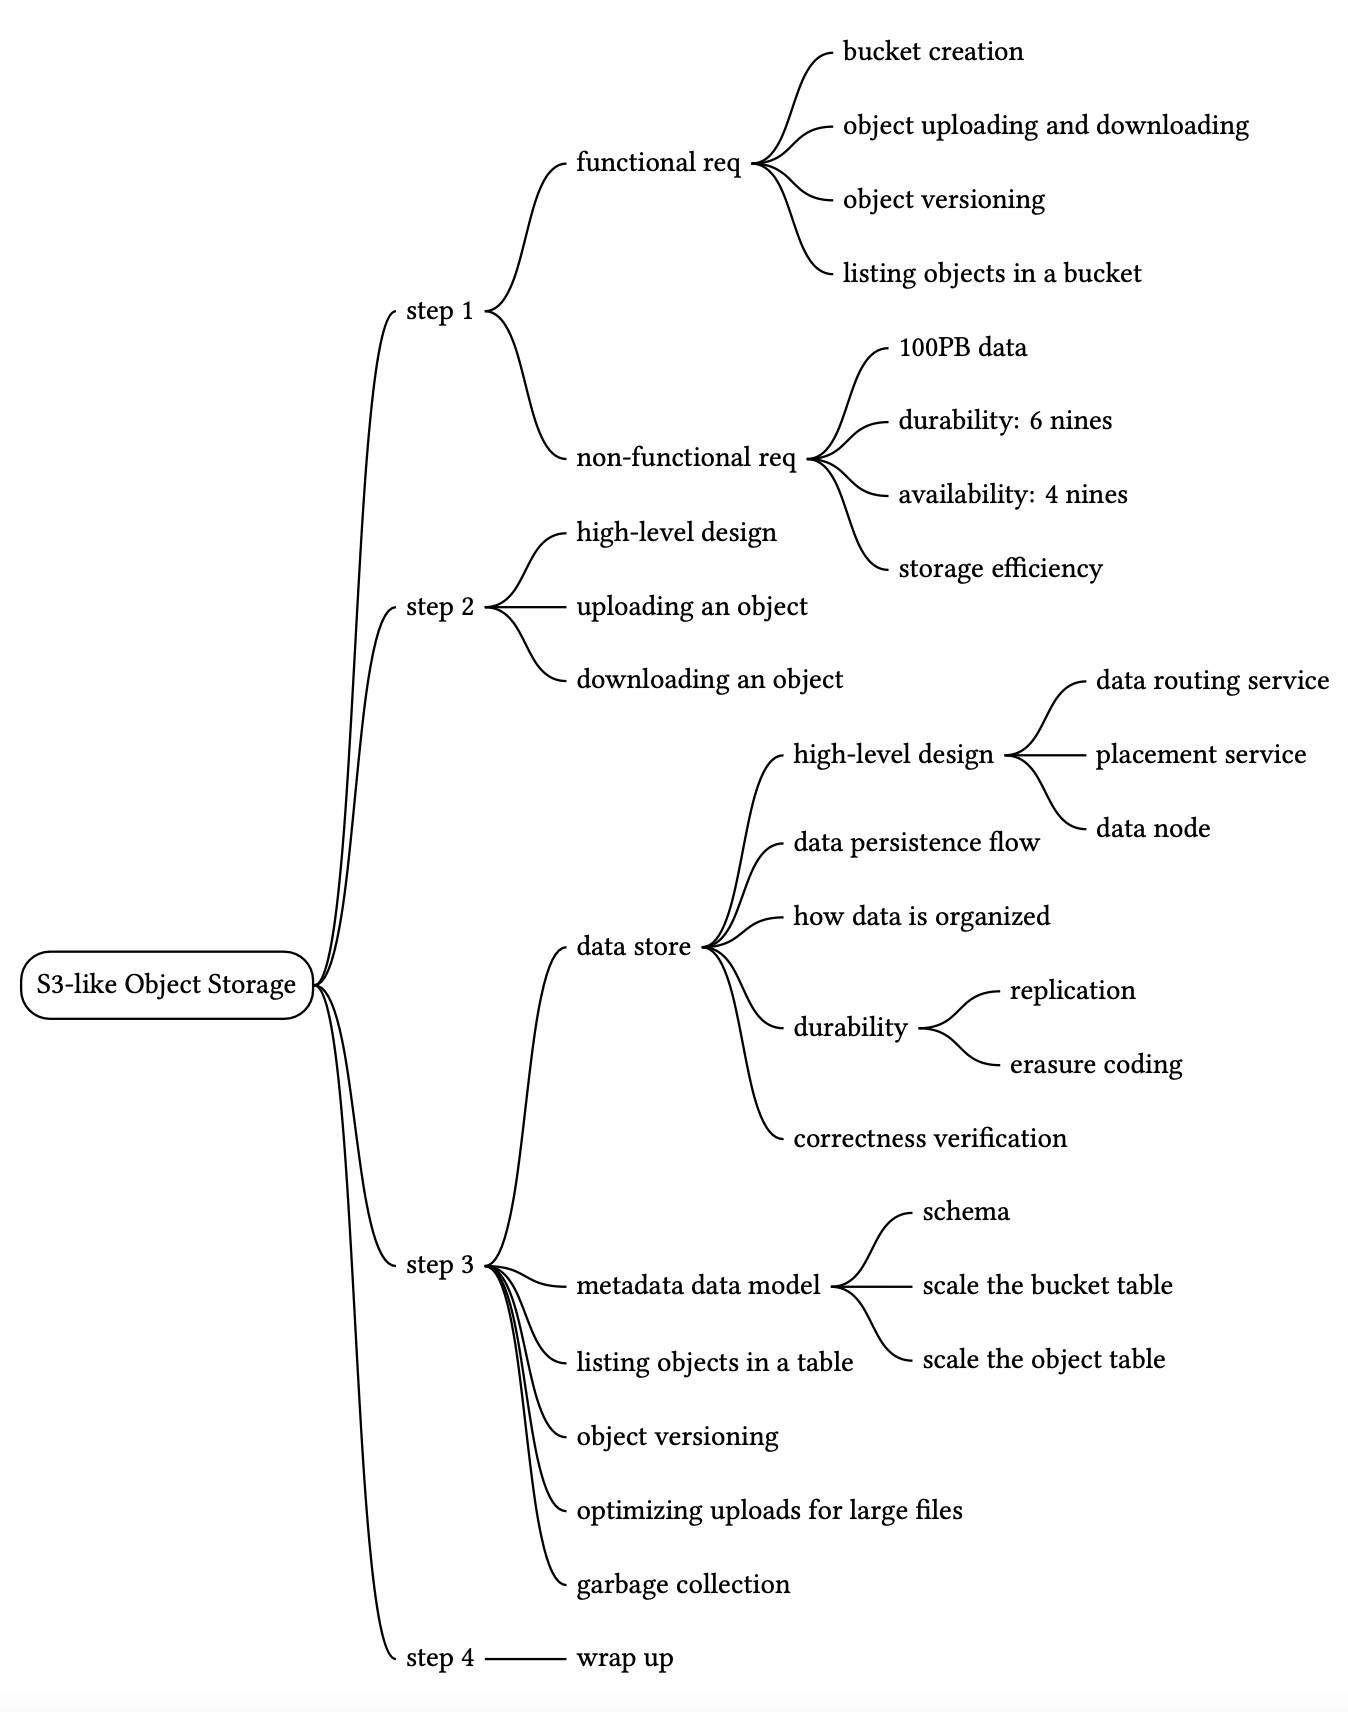
Краткое содержание главы
Reference Material
[1] Fibre channel: https://en.wikipedia.org/wiki/Fibre_Channel
[2] iSCSI: https://en.wikipedia.org/wiki/ISCSI
[3] Server Message Block: https://en.wikipedia.org/wiki/Server_Message_Block
[4] Network File System: https://en.wikipedia.org/wiki/Network_File_System
[5] Amazon S3 Strong Consistency: https://aws.amazon.com/s3/consistency/
[6] Serial Attached SCSI: https://en.wikipedia.org/wiki/Serial_Attached_SCSI
[7] AWS CLI ls command: https://docs.aws.amazon.com/cli/latest/reference/s3/ls.html
[8] Amazon S3 Service Level Agreement: https://aws.amazon.com/s3/sla/
[9] Ambry: LinkedIn’s Scalable Geo-Distributed Object Store:
https://assured-cloud-computing.illinois.edu/files/2014/03/Ambry-LinkedIns-Scalable-GeoDistributed-Object-Store.pdf
[10] inode: https://en.wikipedia.org/wiki/Inode
[11] Ceph’s Rados Gateway: https://docs.ceph.com/en/pacific/radosgw/index.html
[12] gRPC: https://grpc.io/
[13] Paxos: https://en.wikipedia.org/wiki/Paxos_(computer_science)
[14] Raft: https://raft.github.io/
[15] Consistent hashing: https://www.toptal.com/big-data/consistent-hashing
[16] RocksDB: https://github.com/facebook/rocksdb
[17] SSTable: https://www.igvita.com/2012/02/06/sstable-and-log-structured-storage-leveldb/
[18] B+ tree: https://en.wikipedia.org/wiki/B%2B_tree
[19] SQLite: https://www.sqlite.org/index.html
[20] Data Durability Calculation: https://www.backblaze.com/blog/cloud-storage-durability/
[21] Rack: https://en.wikipedia.org/wiki/19-inch_rack
[22] Erasure Coding: https://en.wikipedia.org/wiki/Erasure_code
[23] Reed–Solomon error correction: https://en.wikipedia.org/wiki/Reed%E2%80%93Solomon_error_correction
[24] Erasure Coding Demystified: https://www.youtube.com/watch?v=Q5kVuM7zEUI
[25] Checksum: https://en.wikipedia.org/wiki/Checksum
[26] MD5: https://en.wikipedia.org/wiki/MD5
[27] SHA1: https://en.wikipedia.org/wiki/SHA-1
[28] HMAC: https://en.wikipedia.org/wiki/HMAC
[29] TIMEUUID: https://docs.datastax.com/en/cql-oss/3.3/cql/cql_reference/timeuuid_functions_r.html