Электронный кошелек
Payment platforms обычно предоставляют clients digital wallet service, чтобы они могли хранить деньги в wallet и тратить их позже. Например, можно пополнить digital wallet с bank card, а затем при покупке товаров online выбрать оплату средствами из wallet. На рисунке 1 показан этот процесс.

Рисунок 1 Digital wallet
Трата денег — не единственная возможность, которую дает digital wallet. На payment platform вроде PayPal можно напрямую перевести деньги в wallet другого человека внутри той же platform. По сравнению с bank-to-bank transfer прямой transfer между digital wallets быстрее и, что особенно важно, обычно не требует дополнительной комиссии. На рисунке 2 показана операция transfer balance между wallets.

Рисунок 2 Cross-wallet balance transfer
Предположим, нас просят спроектировать backend digital wallet application, поддерживающей операцию transfer balance между wallets. В начале interview мы зададим уточняющие вопросы, чтобы точно определить requirements.
Шаг 1 — Понять задачу и определить рамки дизайна
Кандидат: Стоит ли нам сосредоточиться только на operations по transfer balance между двумя
digital wallets? Нужно ли учитывать другие features?
Интервьюер: Давайте сосредоточимся только на balance transfer operations.
Кандидат: Сколько transactions per second (TPS) должна поддерживать system?
Интервьюер: Предположим, 1,000,000 TPS.
Кандидат: У digital wallet очень строгие требования к correctness. Можем ли мы считать, что
transactional guarantees [1] нам достаточно?
Интервьюер: Звучит хорошо.
Кандидат: Нужно ли нам уметь доказывать correctness?
Интервьюер: Хороший вопрос. Correctness обычно можно проверить только после завершения
transaction. Один из способов — сравнить наши internal records с выписками banks. Ограничение
reconciliation в том, что она показывает только discrepancy, но не объясняет, как именно возникла
разница. Поэтому нам хотелось бы спроектировать system с reproducibility, то есть такую, где мы
всегда можем восстановить historical balance, проиграв данные с самого начала.
Кандидат: Можем ли мы считать, что требование по availability — 99.99%?
Интервьюер: Да, подходит.
Кандидат: Нужно ли учитывать foreign exchange?
Интервьюер: Нет, это вне scope.
Итак, нашей digital wallet нужно поддерживать следующее:
-
Поддерживать balance transfer operation между двумя digital wallets.
-
Поддерживать 1,000,000 TPS.
-
Reliability не ниже 99.99%.
-
Поддерживать transactions.
-
Поддерживать reproducibility.
Back-of-the-envelope estimation
Когда мы говорим о TPS, подразумевается, что будет использоваться transactional database. Сегодня relational database, работающая на типичном data center node, способна поддерживать несколько тысяч transactions per second. Например, в источнике [2] приведены performance benchmarks некоторых популярных transactional database servers. Предположим, один database node способен поддерживать 1,000 TPS. Чтобы выйти на 1 million TPS, нам потребуется 1,000 database nodes.
Однако эта оценка слегка неточна. Каждая transfer command требует двух operations: списать деньги с одного account и зачислить их на другой. Чтобы поддерживать 1 million transfers per second, system фактически должна выдерживать до 2 million TPS, а значит нам нужно уже 2,000 nodes.
Таблица 1 показывает, сколько nodes понадобится при разных значениях “per-node TPS” (TPS, которую способен выдержать один node). Если hardware остается одинаковой, то чем больше transactions в секунду выдерживает один node, тем меньше общее число nodes, а значит ниже hardware cost. Поэтому одна из целей дизайна — увеличить число transactions, которое один node может обрабатывать за секунду.
| Per-node TPS | Node Number |
|---|---|
| 100 | 20,000 |
| 1,000 | 2,000 |
| 10,000 | 200 |
Таблица 1 Соответствие между per-node TPS и количеством nodes
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
В этом разделе мы обсудим следующее:
-
API design
-
Три high-level designs
-
Simple in-memory solution
-
Database-based distributed transaction solution
-
Event sourcing solution с reproducibility
API Design
Будем использовать RESTful API convention. Для этого interview нам нужен только один API:
| API | Detail |
|---|---|
| POST /v1/wallet/balance_transfer | Перевести balance из одного wallet в другой |
Request parameters:
| Field | Description | Type |
|---|---|---|
| from_account | Debit account | string |
| to_account | Credit account | string |
| amount | Сумма денег | string |
| currency | Тип currency | string (ISO 4217 [3]) |
| transaction_id | ID для deduplication | uuid |
Пример response body:
{
  "Status": "success",
  "Transaction_id": "01589980-2664-11ec-9621-0242ac130002"
}
Стоит отдельно отметить, что data type поля amount — string, а не double. Почему именно
так, мы уже разбирали в главе про Payment System.
На практике многие все равно выбирают float или double, потому что они поддерживаются почти
каждым programming language и database. Это допустимый выбор, если мы понимаем потенциальный риск
потери precision.
In-memory sharding solution
Wallet application хранит account balance для каждого user account. Хорошая data structure для
представления отношения <user, balance> — это map, также называемая hash table (map) или
key-value store.
Для in-memory stores популярный выбор — Redis. Одного Redis node недостаточно, чтобы выдержать 1 million TPS. Нам нужно поднять cluster из Redis nodes и равномерно распределить user accounts между ними. Этот процесс называется partitioning или sharding.
Чтобы распределить key-value data по N partitions, можно вычислить hash value key и поделить его на N. Остаток будет указывать destination partition. Ниже показан pseudocode процесса sharding:
String accountID = "A";
Int partitionNumber = 7;
Int myPartition = accountID.hashCode() % partitionNumber;
Количество partitions и addresses всех Redis nodes можно хранить централизованно. Например, можно использовать Zookeeper [4] как highly-available configuration storage solution.
Финальный component этого решения — service, обрабатывающий transfer commands. Назовем ее wallet service. У нее несколько ключевых responsibilities:
-
Принимать transfer command
-
Валидировать transfer command
-
Если command валидна, обновлять account balances двух users, участвующих в transfer
Wallet service stateless. Ее легко масштабировать горизонтально. На рисунке 3 показано in-memory solution.
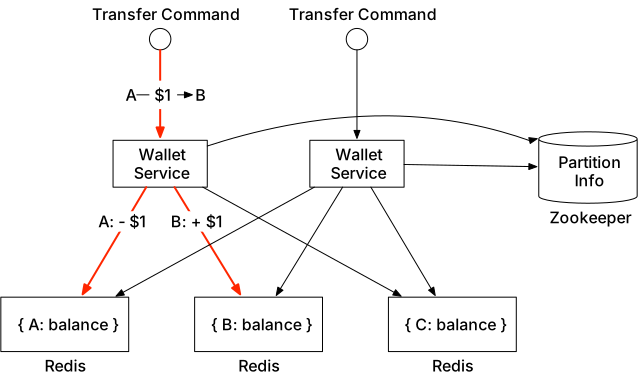
Рисунок 3 In-memory solution
В этом примере у нас есть 3 Redis nodes. Есть три clients: A, B и C. Их account balances равномерно распределены между этими тремя Redis nodes. Также есть два wallet service nodes, обрабатывающих balance transfer requests. Когда один из wallet service nodes получает transfer command на перемещение $1 от client A к client B, он отправляет две commands в два Redis nodes. Для Redis node, где хранится account client A, wallet service вычитает $1 из account. Для client B wallet service добавляет $1 к account.
Кандидат: В этом design account balances распределены по нескольким Redis nodes. Zookeeper используется для хранения sharding information. Stateless wallet service использует эту информацию, чтобы находить Redis nodes для clients и обновлять account balances соответствующим образом.
Интервьюер: Этот design работает, но не удовлетворяет нашему требованию correctness. Wallet service обновляет два Redis nodes для каждого transfer. Нет гарантии, что оба updates завершатся успешно. Если, например, wallet service node упадет после того, как первый update уже прошел, но до того, как выполнен второй update, мы получим incomplete transfer. Оба updates должны входить в одну atomic transaction.
Distributed transactions
Database sharding
Как сделать updates двух разных storage nodes atomic? Первый шаг — заменить каждый Redis node на transactional relational database node. На рисунке 4 показана архитектура. На этот раз clients A, B и C partitioned в 3 relational databases, а не в 3 Redis nodes.
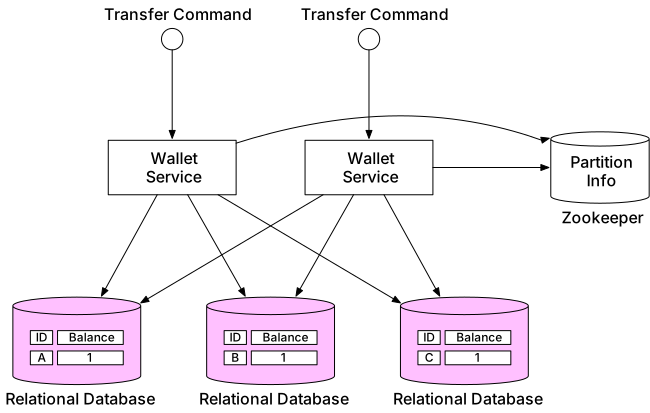
Рисунок 4 Relational database
Использование transactional databases решает только часть проблемы. Как уже говорилось в прошлом разделе, очень вероятно, что одна transfer command должна обновить два accounts в двух разных databases. Нет гарантии, что две update operations будут выполнены ровно в один и тот же момент. Если wallet service restart-ится сразу после обновления первого account balance, как убедиться, что второй account тоже будет обновлен?
Distributed transaction: two-phase commit
В distributed system одна transaction может затрагивать несколько processes на нескольких nodes. Чтобы сделать transaction atomic, может подойти distributed transaction. Существует два способа реализовать distributed transaction: low-level solution и high-level solution. Разберем оба.
Low-level solution опирается на саму database. Самый распространенный algorithm называется two-phase commit (2PC). Как следует из названия, у него две phases, как показано на рисунке 5.
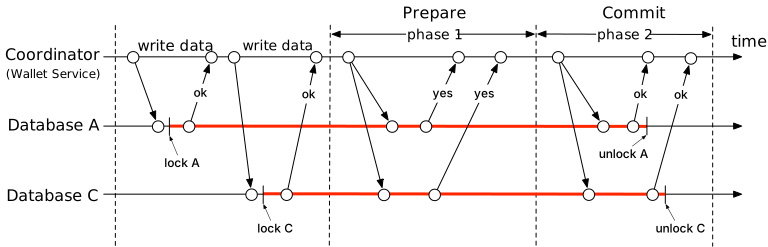
Рисунок 5 Two-phase commit (source [5])
-
Coordinator, которым в нашем случае выступает wallet service, выполняет read и write operations в нескольких databases как обычно. Как показано на рисунке 5, databases A и C locked.
-
Когда application собирается commit-ить transaction, coordinator просит все databases подготовить transaction.
-
Во второй phase coordinator собирает replies от всех databases и делает следующее:
-
Если все databases отвечают “yes”, coordinator просит все databases commit-ить transaction, которую они получили.
-
Если хотя бы одна database отвечает “no”, coordinator просит все databases abort-ить transaction.
-
Это low-level solution, потому что prepare step требует специальной модификации database transaction. Например, существует стандарт X/Open XA [6], координирующий heterogeneous databases, чтобы реализовать 2PC. Главная проблема 2PC в том, что он не слишком performant: locks могут удерживаться очень долго, пока идет ожидание messages от других nodes. Еще одна проблема 2PC — coordinator может стать single point of failure, как показано на рисунке 6.
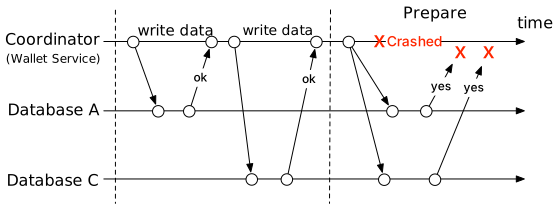
Рисунок 6 Coordinator crashes
Distributed transaction: Try-Confirm/Cancel (TC/C)
TC/C — это тип compensating transaction [7], состоящий из двух steps:
-
В первой phase coordinator просит все databases зарезервировать resources для transaction.
-
Во второй phase coordinator собирает replies от всех databases:
-
Если все databases отвечают “yes”, coordinator просит все databases confirm operation — это Try-Confirm process.
-
Если хотя бы одна database отвечает “no”, coordinator просит все databases cancel operation — это Try-Cancel process.
-
Важно отметить, что в 2PC обе phases обернуты в одну и ту же transaction, а в TC/C каждая phase — отдельная transaction.
Пример TC/C
Объяснить, как работает TC/C, проще на реальном примере. Допустим, мы хотим перевести $1 с account A на account C. Таблица 2 кратко показывает, как TC/C выполняется в каждой phase.
| Phase | Operation | A | C |
|---|---|---|---|
| 1 | Try | Balance change: -$1 | Do nothing |
| 2 | Confirm | Do nothing | Balance change: +$1 |
| Cancel | Balance change: +$1 | Do nothing |
Таблица 2 Пример TC/C
Предположим, wallet service — это coordinator TC/C. В начале distributed transaction у account A на balance $1, а у account C — $0.
Первая phase: Try
В Try phase wallet service, выступающая coordinator-ом, отправляет две transaction commands в две databases:
-
Для database, содержащей account A, coordinator запускает local transaction, уменьшающую balance A на $1.
-
Для database, содержащей account C, coordinator отправляет NOP (no operation). Чтобы пример оставался переносимым на другие scenarios, предположим, что coordinator всегда отправляет этой database NOP command. Database ничего не делает для NOP commands и всегда отвечает coordinator-у success message.
Try phase показана на рисунке 7. Толстая линия означает, что transaction удерживает lock.
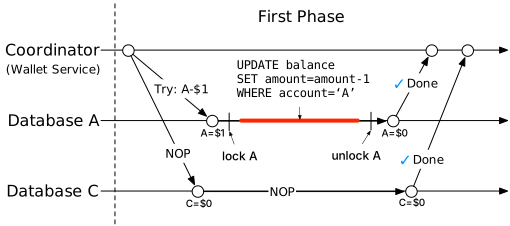
Рисунок 7 Try phase
Вторая phase: Confirm
Если обе databases отвечают “yes”, wallet service запускает следующую Confirm phase.
Balance account A уже была обновлена в первой phase. Wallet service не нужно снова изменять ее balance. Однако account C еще не получил свой $1 от account A в первой phase. В Confirm phase wallet service должна добавить $1 к balance account C.
Confirm process показан на рисунке 8.
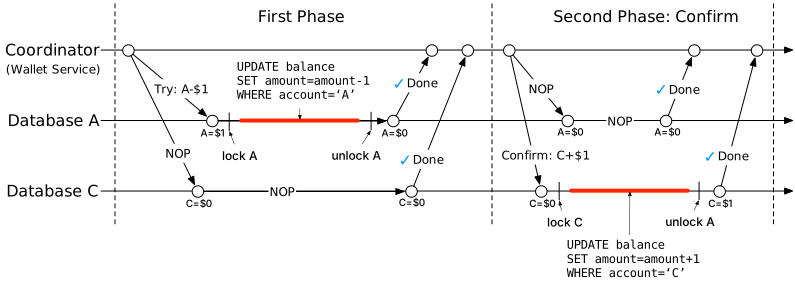
Рисунок 8 Confirm phase
Вторая phase: Cancel
Что если первая Try phase завершилась неудачей? В примере выше мы предполагали, что NOP operation для account C всегда успешна, хотя на практике она тоже может упасть. Например, account C может быть illegal account, и regulator потребовал, чтобы в нее нельзя было переводить деньги ни входящим, ни исходящим потоком. В этом случае distributed transaction должна быть отменена, и нам нужно выполнить cleanup.
Так как balance account A уже была обновлена transaction-ом в Try phase, wallet service не может отменить уже завершенную transaction. Но она может запустить другую transaction, которая откатит эффект transaction из Try phase, то есть добавит $1 обратно на account A.
Так как account C не обновлялся в Try phase, wallet service достаточно отправить в database account C NOP operation.
Cancel process показан на рисунке 9.
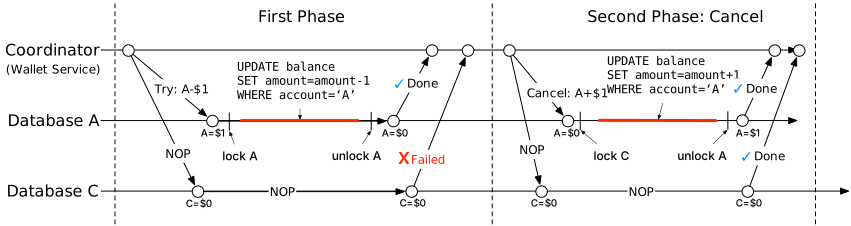
Рисунок 9 Cancel phase
Сравнение 2PC и TC/C
Таблица 3 показывает, что у 2PC и TC/C много общего, но есть и различия. В 2PC все local transactions еще не завершены (все еще locked), когда начинается вторая phase, а в TC/C все local transactions уже завершены (unlocked) к началу второй phase. Иными словами, вторая phase 2PC — это завершение незаконченной transaction, например abort или commit, а в TC/C вторая phase — использование reverse operation для компенсации результата предыдущей transaction при ошибке.
| First Phase | Second Phase: success | Second Phase: fail | |
|---|---|---|---|
| 2PC | Local transactions еще не завершены | Commit всех local transactions | Cancel всех local transactions |
| TC/C | Все local transactions завершены, либо committed, либо canceled | Выполнить новые local transactions при необходимости | Reverse side effect уже committed transaction, то есть “undo” |
Таблица 3 2PC vs TC/C
TC/C также называют distributed transaction by compensation. Это high-level solution, потому что compensation, или “undo”, реализуется в business logic. Преимущество такого подхода — он database-agnostic. Пока database поддерживает transactions, TC/C будет работать. Недостаток — нам самим приходится управлять всеми деталями и сложностью distributed transactions в business logic на application layer.
Phase status table
Мы все еще не ответили на вопрос, который задавали ранее: что если wallet service restart-ится в середине TC/C? После restart-а вся previous operation history может быть потеряна, и system не поймет, как восстановиться.
Решение простое. Мы можем хранить progress TC/C как phase status в transactional database. Phase status включает как минимум следующую information:
-
ID и content distributed transaction
-
Status Try phase для каждой database. Status может быть “not sent yet”, “has been sent” и “response received”
-
Название второй phase. Это может быть “Confirm” или “Cancel”. Его можно вычислить по результату Try phase
-
Status второй phase
-
Out-of-order flag (скоро разберем его в разделе “Out-of-Order Execution”)
Куда класть phase status tables? Обычно phase status хранится в database, содержащей wallet account, с которого списываются деньги. Обновленная architecture diagram показана на рисунке 10.
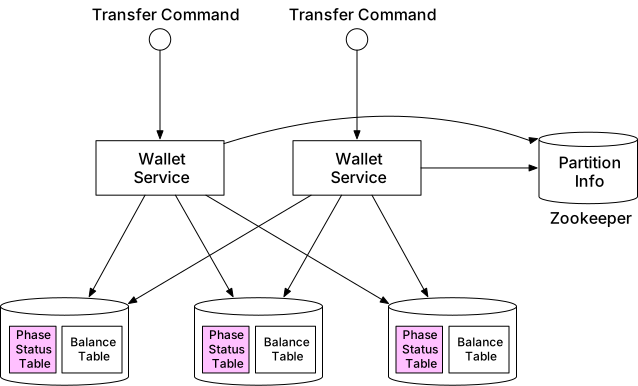
Рисунок 10 Phase status table
Unbalanced state
Замечаете, что к концу Try phase $1 “исчезает” (рисунок 11)?
Если все идет хорошо, к концу Try phase $1 списан с account A, а account C остается неизменным. Сумма balances у A и C станет равной $0, что меньше, чем в начале TC/C. Это нарушает фундаментальное accounting rule: после transaction суммарный баланс должен оставаться тем же.
Хорошая новость в том, что transactional guarantee все равно поддерживается TC/C. TC/C состоит из нескольких независимых local transactions. Так как TC/C driven application-ом, само application может видеть intermediate result между этими local transactions. В отличие от этого, database transaction или distributed transaction в версии 2PC поддерживалась databases и была невидима high-level applications.
Во время исполнения distributed transactions discrepancies в data возникают всегда. Иногда они прозрачны для нас, потому что lower-level systems вроде databases уже сами исправили discrepancy. Если нет, мы должны разбираться с этим самостоятельно, как в TC/C.
Unbalanced state показано на рисунке 11.
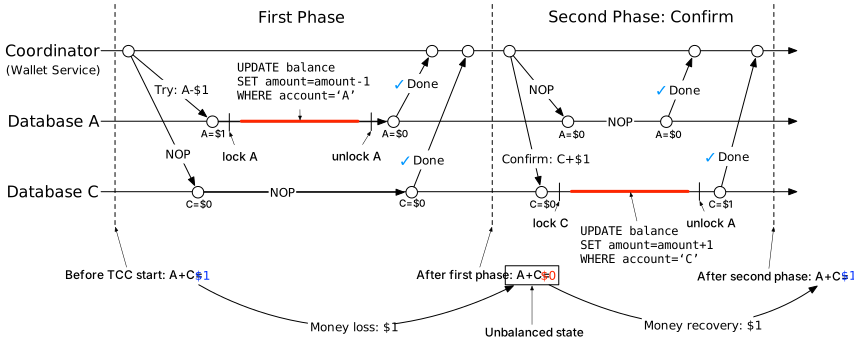
Рисунок 11 Unbalanced state
Valid operation orders
Для Try phase есть три варианта:
| Try phase choices | Account A | Account C |
|---|---|---|
| Choice 1 | -$1 | NOP |
| Choice 2 | NOP | +$1 |
| Choice 3 | -$1 | +$1 |
Таблица 4 Варианты Try phase
Все три варианта выглядят правдоподобно, но не все valid.
Для choice 2: если Try phase для account C успешна, но для account A (NOP) завершилась неудачей, wallet service должна перейти в Cancel phase. Есть шанс, что кто-то еще вмешается и уведет этот $1 с account C. Позже, когда wallet service попытается списать $1 с account C, окажется, что денег уже нет, а это нарушает transactional guarantee distributed transaction.
Для choice 3: если $1 списывается с account A и одновременно начисляется на account C, это создает массу сложностей. Например, $1 уже добавлен в account C, но списание с account A завалилось. Что тогда делать?
Поэтому choice 2 и choice 3 flawed, а valid остается только choice 1.
Out-of-order execution
Один из side effects TC/C — out-of-order execution. Проще всего объяснить это на примере.
Возьмем тот же пример с переводом $1 с account A на account C. Как показано на рисунке 12, в Try phase operation для account A проваливается и возвращает failure в wallet service. После этого wallet service переходит в Cancel phase и отправляет cancel operation и для account A, и для account C.
Предположим, у database, обрабатывающей account C, network issues, и она получает Cancel instruction раньше Try instruction. В таком случае отменять пока нечего.
Out-of-order execution показано на рисунке 12.
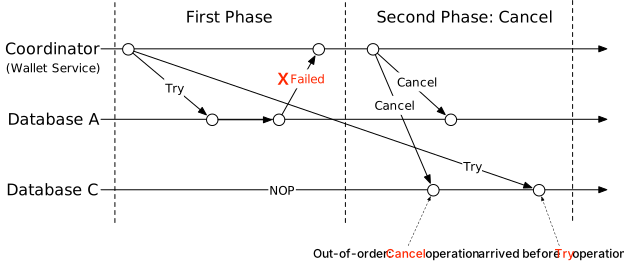
Рисунок 12 Out-of-order execution
Чтобы обрабатывать out-of-order operations, каждому node разрешается выполнить Cancel TC/C, даже если Try instruction еще не приходила. Для этого existing logic усиливается так:
-
Out-of-order Cancel operation оставляет в database flag, показывающий, что node уже видел Cancel operation, но еще не видел Try operation
-
Try operation дополняется проверкой этого out-of-order flag. Если flag есть, Try возвращает failure
Именно поэтому в разделе “Phase Status Table” мы добавили в phase status table out-of-order flag.
Distributed transaction: Saga
Linear order execution
Еще одно популярное решение для distributed transactions называется Saga [8]. Saga — это де-факто standard в microservice architecture. Идея Saga проста:
-
Все operations упорядочены в sequence. Каждая operation — независимая transaction в своей database
-
Operations исполняются от первой к последней. Когда одна operation завершена, запускается следующая
-
Если какая-то operation упала, весь process начинает rollback от текущей operation к первой в обратном порядке, используя compensating transactions. Поэтому если distributed transaction состоит из n operations, нужно подготовить 2n operations: n для normal case и еще n compensating transactions для rollback
Понять это проще на примере. На рисунке 13 показан Saga workflow для перевода $1 с account A на account C. Верхняя горизонтальная line показывает normal order execution. Две вертикальные lines показывают, что должна сделать system при ошибке. Если system сталкивается с error, transfer operations rollback-ятся и client получает error message. Как мы уже обсуждали в разделе “Valid operation orders”, deduction operation должна идти перед addition operation.

Рисунок 13 Saga workflow
Как координировать operations? Есть два способа:
-
Choreography. В microservice architecture все services, участвующие в Saga distributed transaction, делают свою часть работы, подписываясь на events других services. То есть coordination полностью decentralized
-
Orchestration. Один coordinator командует всем services, что и в каком порядке делать
Выбор coordination model определяется business needs и goals. Проблема choreography solution в том, что services взаимодействуют полностью asynchronously, и каждому service приходится держать внутренний state machine, чтобы понимать, что делать, когда другие services публикуют event. При большом количестве services этим становится трудно управлять. Orchestration solution лучше справляется со сложностью, поэтому в digital wallet system обычно предпочитают именно ее.
Сравнение TC/C и Saga
TC/C и Saga — оба application-level distributed transactions. Таблица 5 суммирует их сходства и различия.
| TC/C | Saga | |
|---|---|---|
| Compensating action | В Cancel phase | В rollback phase |
| Central coordination | Yes | Yes (в orchestration mode) |
| Operation execution order | Any | Linear |
| Возможность parallel execution | Yes | No (linear execution) |
| Видимость partial inconsistent status | Yes | Yes |
| Application или database logic | Application | Application |
Таблица 5 TC/C vs Saga
Что использовать на практике? Ответ зависит от latency requirement. Как видно из таблицы 5, operations в Saga должны исполняться в linear order, тогда как в TC/C возможно parallel execution. Поэтому решение зависит от нескольких факторов:
-
Если latency requirement отсутствует или services очень мало, например как в нашем money transfer example, можно выбрать любое из решений. Если хочется следовать тренду microservice architecture, выбирайте Saga
-
Если system latency-sensitive и содержит много services/operations, TC/C может быть лучшим вариантом
Кандидат: Чтобы сделать balance transfer transactional, мы заменяем Redis на relational database и используем TC/C или Saga для реализации distributed transactions.
Интервьюер: Отличная работа. Решение с distributed transactions работает, но бывают случаи, когда его недостаточно. Например, users могут ошибиться и отправить неверные operations на уровне application. Тогда указанная сумма денег тоже может оказаться неверной. Нам нужен способ проследить root cause проблемы и audit-ить все account operations. Как это сделать?
Event sourcing
Background
В реальной жизни provider digital wallet может проходить audit. External auditors могут задавать сложные вопросы, например:
-
Знаем ли мы account balance в любой момент времени?
-
Как мы понимаем, что historical и current account balances корректны?
-
Как доказать, что logic system корректна после code change?
Одна из design philosophies, системно отвечающая на эти вопросы, — event sourcing, техника из Domain-Driven Design (DDD) [9].
Definition
В event sourcing есть четыре важных термина:
-
Command
-
Event
-
State
-
State machine
Command
Command — это намеренное действие, пришедшее из внешнего мира. Например, если мы хотим перевести $1 от client A к client C, такой запрос на transfer money и есть command.
В event sourcing очень важно, чтобы у всего был order. Поэтому commands обычно кладутся в FIFO (first in, first out) queue.
Event
Command — это намерение, а не факт, потому что некоторые commands могут быть invalid и не могут быть выполнены. Например, transfer operation провалится, если после transfer account balance станет negative.
Прежде чем что-либо делать, command нужно провалидировать. Если command проходит validation, она valid и должна быть выполнена. Результат выполнения называется event.
Между command и event есть два больших отличия.
-
Events должны быть исполнены, потому что они представляют собой validated fact. На практике для event обычно используется past tense. Если command — “transfer $1 from A to C”, то соответствующий event будет “transferred $1 from A to C”
-
Commands могут содержать randomness или I/O, а events обязаны быть deterministic. Events представляют historical facts
У процесса генерации events есть два важных свойства.
-
Одна command может породить любое число events. Может не породить ни одного event или породить несколько
-
Event generation может содержать randomness, поэтому не гарантируется, что одна и та же command всегда порождает один и тот же набор event(s). Event generation может включать external I/O или random numbers. В конце главы мы еще вернемся к этому свойству
Order events должен следовать order commands. Поэтому events тоже сохраняются в FIFO queue.
State
State — это то, что меняется при применении event. В wallet system state — это balances всех client accounts, которые можно представить data structure типа map. Key — это account name или ID, а value — account balance. Для хранения такой map data structure обычно используют key-value stores. Relational database тоже можно рассматривать как key-value store, где keys — primary keys, а values — table rows.
State machine
State machine управляет process event sourcing. У нее две основные functions:
-
Валидировать commands и генерировать events
-
Применять event для обновления state
Event sourcing требует, чтобы поведение state machine было deterministic. Поэтому state machine сама не должна содержать randomness. Например, она не должна читать случайные данные извне через I/O или использовать random numbers. При применении event к state результат всегда должен быть одинаковым.
На рисунке 14 показан static view event sourcing architecture. State machine отвечает и за преобразование command в event, и за применение event. Так как у state machine две основные functions, обычно рисуют две state machines: одну для validation commands, другую — для application events.
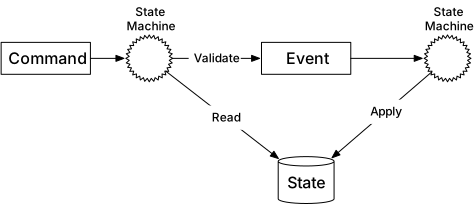
Рисунок 14 Static view of event sourcing
Если добавить временное измерение, на рисунке 15 показан dynamic view event sourcing. System постоянно получает commands и обрабатывает их одну за другой.

Рисунок 15 Dynamic view of event sourcing
Пример wallet service
Для wallet service commands — это balance transfer requests. Эти commands кладутся в FIFO queue. Один из популярных вариантов для command queue — Kafka [10]. Command queue показана на рисунке 16.

Рисунок 16 Command queue
Предположим, что state (account balance) хранится в relational database. State machine рассматривает каждую command по очереди в FIFO order. Для каждой command она проверяет, хватает ли account balance. Если да, state machine генерирует event для каждого account. Например, если command — “A->$1->C”, state machine порождает два events: “A:-$1” и “C:+$1”.
На рисунке 17 показано, как state machine работает в 5 steps.
-
Прочитать commands из command queue
-
Прочитать balance state из database
-
Провалидировать command. Если она valid, сгенерировать по event для каждого account
-
Прочитать следующий Event
-
Применить Event, обновив balance в database
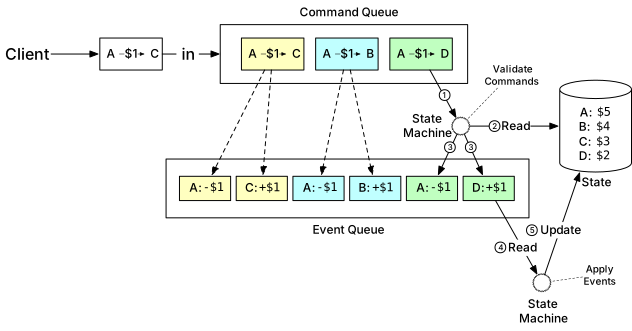
Рисунок 17 How state machine works
Reproducibility
Самое важное преимущество event sourcing перед другими architectures — reproducibility.
В distributed transaction solutions, обсуждавшихся раньше, wallet service сохраняет в database обновленный account balance (state). Но сложно понять, почему именно account balance изменилась. Кроме того, historical balance information теряется при update operation. В design event sourcing все изменения сначала сохраняются как immutable history. Database используется лишь как updated view того, как выглядит balance в любой момент времени.
Мы всегда можем восстановить historical balance states, replay-нув events с самого начала. Так как event list immutable, а logic state machine deterministic, гарантируется, что historical states, полученные при каждом replay, будут одинаковыми.
На рисунке 18 показано, как воспроизвести states wallet service, replay-нув events.
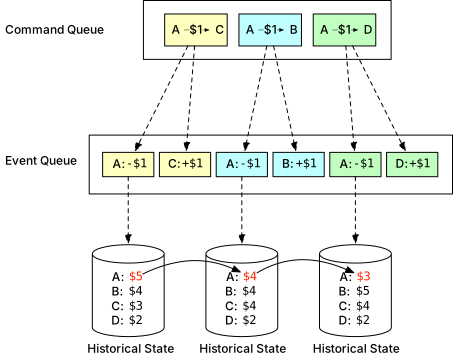
Рисунок 18 Reproduce states
Reproducibility помогает ответить на трудные вопросы auditors, заданные в начале раздела. Еще раз повторим их:
-
Знаем ли мы account balance в любой момент времени?
-
Как понимаем, что historical и current account balances корректны?
-
Как доказать корректность logic system после code change?
На первый вопрос можно ответить, replay-нув events с начала до нужного нам момента времени.
На второй вопрос можно ответить, пересчитав account balance по event list и сверив результат.
На третий вопрос можно ответить, прогнав разные versions code по одному и тому же набору events и убедившись, что результаты идентичны.
Именно из-за audit capability event sourcing часто становится de facto solution для wallet service.
Command-query responsibility segregation (CQRS)
До сих пор wallet service проектировалась так, чтобы эффективно перемещать деньги между accounts. Но client все еще не знает, каков текущий account balance. Значит, нужен способ публиковать state (balance information), чтобы client, находящийся вне event sourcing framework, тоже могла получить state.
Интуитивно можно было бы сделать read-only copy database (historical state) и поделиться ею с внешним миром. Event sourcing отвечает на этот вопрос немного иначе.
Вместо публикации state (balance information) event sourcing публикует все events. Внешний мир может сам перестраивать любое нужное ему customized state. Эта design philosophy называется CQRS [11].
В CQRS есть одна state machine, отвечающая за write part of the state, но может быть много read-only state machines, отвечающих за построение views of the state. Эти views могут использоваться для queries.
Такие read-only state machines могут выводить разные state representations из event queue. Например, clients хотят знать свои balances, и одна read-only state machine может сохранять state в database, чтобы обслуживать balance query. Другая state machine может строить state для конкретного time period, помогая расследовать issues вроде возможного double charge. Такая state information образует audit trail, который помогает reconcile financial records.
Эти read-only state machines немного lag behind, но всегда eventually catch up. То есть architecture eventually consistent.
На рисунке 19 показана классическая CQRS architecture.
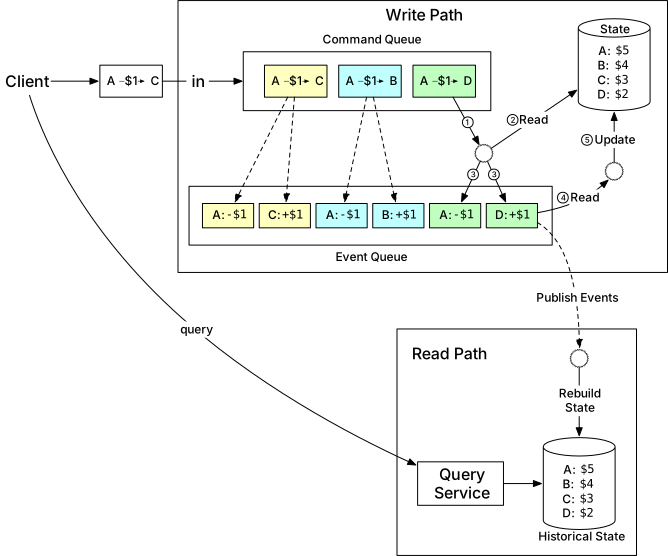
Рисунок 19 CQRS architecture
Кандидат: В этом design мы используем event sourcing architecture, чтобы сделать всю system reproducible. Все valid business records сохраняются в immutable Event queue, которую можно использовать для correctness verification.
Интервьюер: Отлично. Но предложенная тобой event sourcing architecture обрабатывает только по одному event за раз и должна общаться с несколькими external systems. Можем ли мы сделать ее быстрее?
Шаг 3 — Детальное проектирование
В этом разделе мы подробно разберем techniques для достижения high performance, reliability и scalability.
High-performance event sourcing
В примере выше мы использовали Kafka как command и event store, а database — как state store. Теперь посмотрим, какие optimizations здесь возможны.
File-based command and event list
Первая optimization — сохранять commands и events на local disk, а не в remote store вроде Kafka. Это позволяет избежать transit time по сети. Event list использует append-only data structure. Append — это sequential write operation, а она обычно очень быстрая. Такой подход хорошо работает даже для magnetic hard drives, потому что operating system очень хорошо оптимизирована под sequential reads и writes. Согласно статье ACM Queue [12], в некоторых случаях sequential disk access может быть быстрее random memory access.
Вторая optimization — cache recent commands и events в memory. Как мы уже объясняли, мы обрабатываем commands и events сразу после их persistence. Поэтому есть смысл кешировать их в memory, чтобы не тратить время на повторную загрузку с local disk.
Теперь посмотрим на implementation details. Для этих optimizations отлично подходит техника
mmap [13]. mmap может одновременно писать на local disk и кешировать recent content in
memory. Она отображает disk file в memory как array. Operating system кеширует некоторые sections
file в memory, ускоряя read и write operations. Для append-only file operations почти гарантировано,
что все данные будут в memory, а это очень быстро.
На рисунке 20 показано file-based storage для commands и events.
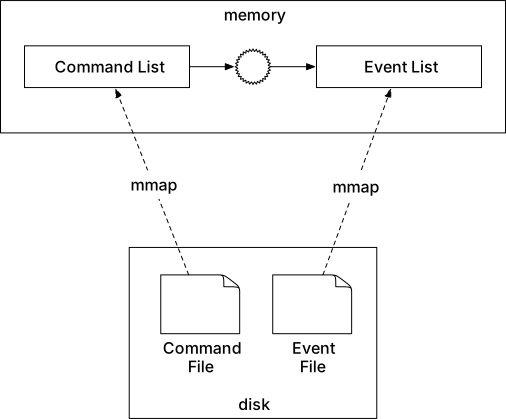
Рисунок 20 File-based command and event storage
File-based state
В предыдущем design state (balance information) хранится в relational database. В production environment database обычно работает на отдельном server и доступна только по сети. Аналогично optimizations для command и event, state information тоже можно сохранять на local disk.
Более конкретно, можно использовать SQLite [14], то есть file-based local relational database, или RocksDB [15], local file-based key-value store.
Здесь выбираем RocksDB, потому что она использует log-structured merge-tree (LSM), оптимизированную под write operations. Чтобы улучшить read performance, самые recent data кешируются.
На рисунке 21 показано file-based solution для command, event и state.
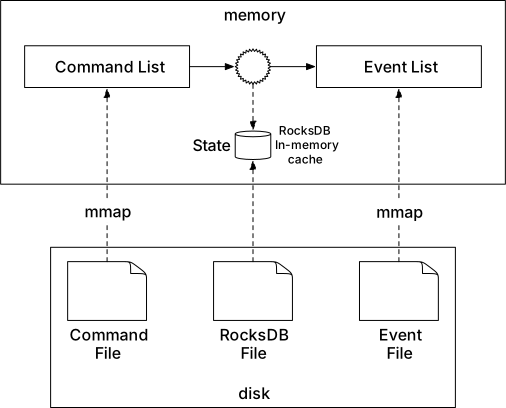
Рисунок 21 File-based solution for command, event, and state
Snapshot
Раз уж все стало file-based, давайте подумаем, как ускорить reproducibility. Когда мы впервые вводили reproducibility, state machine каждый раз должна была обрабатывать events с самого начала. Что можно улучшить? Периодически останавливать state machine и сохранять current state в file. Это и называется snapshot.
Snapshot — это immutable view historical state. После сохранения snapshot state machine больше не обязательно стартовать с самого начала. Она может прочитать data из snapshot, понять, где остановилась, и продолжить processing оттуда.
Для financial applications вроде wallet service finance team часто требует делать snapshot в 00:00, чтобы можно было проверить все transactions, произошедшие за день. Когда мы впервые обсуждали CQRS в event sourcing, решение было таким: поднять read-only state machine, которая читает события с самого начала до нужного момента времени. С snapshots read-only state machine достаточно загрузить один snapshot, содержащий нужные data.
Snapshot — это giant binary file, и стандартное решение — сохранять ее в object storage solution, например HDFS [16].
На рисунке 22 показана file-based event sourcing architecture. Когда все file-based, system может полностью использовать maximum I/O throughput computer hardware.
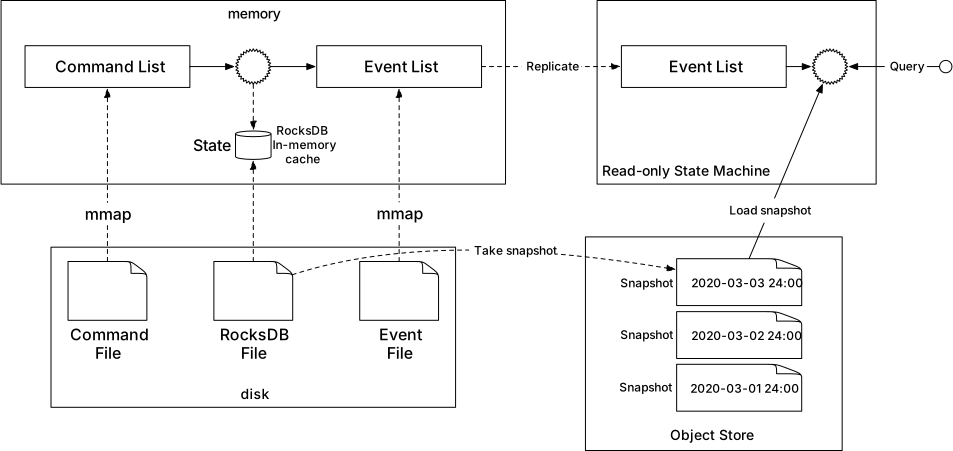
Рисунок 22 Snapshot
Кандидат: Мы можем переработать design event sourcing так, чтобы command list, event list, state и snapshot сохранялись в files. Event sourcing architecture обрабатывает event list линейно, что очень хорошо соответствует design hard disks и operating system cache.
Интервьюер: Performance local file-based solution лучше, чем у system, где нужно ходить за данными в remote Kafka и databases. Но тут появляется другая проблема: раз данные лежат на local disk, server становится stateful и превращается в single point of failure. Как нам повысить reliability system?
Reliable high-performance event sourcing
Прежде чем объяснять solution, давайте посмотрим, какие части system требуют reliability guarantee.
Reliability analysis
Концептуально все, что делает node, можно свести к двум понятиям: data и computation. Пока data durable, computational result легко восстановить, просто запустив тот же code на другом node. Это значит, что нас должна по-настоящему беспокоить только reliability data. Если data потеряны, они потеряны навсегда. Следовательно, reliability system в основном — это reliability data.
В нашей system есть четыре типа data:
-
File-based command
-
File-based event
-
File-based state
-
State snapshot
Посмотрим, как обеспечить reliability каждого из этих типов data.
State и snapshot всегда можно сгенерировать заново, replay-нув event list. Чтобы повысить reliability state и snapshot, нужно лишь обеспечить strong reliability для event list.
Теперь посмотрим на command. На первый взгляд кажется, что раз event генерируется из command, то достаточно strong reliability guarantee для command. Это выглядит правдоподобно, но тут есть важный нюанс. Event generation не гарантированно deterministic и может включать random factors: random numbers, external I/O и т. д. Значит, command сама по себе не гарантирует reproducibility events.
Теперь время внимательно посмотреть на event. Event представляет historical fact, который вносит изменение в state (account balance). Event immutable и может быть использован для rebuilding state.
Из этого анализа следует, что event data — единственный тип data, которому действительно нужна high-reliability guarantee. В следующем разделе разберем, как этого добиться.
Consensus
Чтобы обеспечить high reliability, нужно replicat-ить event list на несколько nodes. Во время replication process нужно гарантировать следующие свойства:
-
No data loss
-
Relative order data внутри log file остается одинаковым на всех nodes
Для обеспечения этих гарантий хорошо подходит consensus-based replication. Consensus algorithm гарантирует, что несколько nodes приходят к консенсусу о том, какой именно event list у них должен быть. В качестве примера возьмем consensus algorithm Raft [17].
Algorithm Raft гарантирует, что пока online больше половины nodes, append-only lists на них содержат одинаковые data. Например, если у нас 5 nodes и для синхронизации их data используется Raft, то пока как минимум 3 nodes (то есть больше половины) remain up, как показано на рисунке 23, вся system может корректно работать:

Рисунок 23 Raft
Node может играть три разных roles в algorithm Raft:
-
Leader
-
Candidate
-
Follower
Implementation details Raft можно найти в самой статье про Raft. Здесь мы рассмотрим только high-level concepts. В Raft максимум один node cluster является leader-ом, остальные — followers. Leader отвечает за прием external commands и за надежную replication data между nodes cluster.
С Raft system остается reliable, пока большинство nodes operational. Например, если в cluster 3 nodes, она может пережить failure 1 node, а если 5 nodes — failure 2 nodes.
Reliable solution
Благодаря replication в нашей file-based event sourcing architecture больше не будет single point of failure. Посмотрим на implementation details. На рисунке 24 показана event sourcing architecture с reliability guarantee.
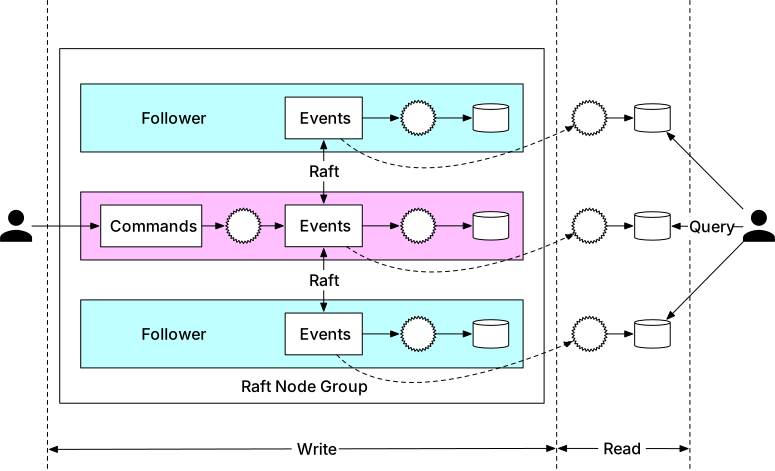
Рисунок 24 Raft node group
На рисунке 24 мы поднимаем 3 event sourcing nodes. Эти nodes используют algorithm Raft, чтобы надежно синхронизировать event list.
Leader принимает incoming command requests от external users, преобразует их в events и append-ит events в local event list. Algorithm Raft replicat-ит newly added events на followers.
Все nodes, включая followers, обрабатывают event list и обновляют state. Algorithm Raft гарантирует, что у leader и followers одинаковые event lists, а event sourcing гарантирует, что и все states будут одинаковыми, пока одинаковы event lists.
Reliable system должна gracefully handle failures, поэтому давайте разберем, как обрабатываются node crashes.
Если leader crashes, algorithm Raft автоматически выбирает нового leader-а из remaining healthy nodes. Новый elected leader берет на себя ответственность за прием commands от external users. Гарантируется, что cluster в целом продолжит работать даже после падения node.
Когда leader crashes, возможно, что crash произошел до того, как command list была преобразована в events. В этом случае client заметит проблему либо по timeout, либо по error response. Client должен повторно отправить ту же command новому elected leader-у.
С follower crashes ситуация проще. Если follower падает, requests к ней будут fail-иться. Raft обрабатывает это, retry-ая репликацию бесконечно, пока crashed node не будет restart-нут или заменен новым.
Кандидат: В этом design мы используем consensus algorithm Raft, чтобы replicat-ить event list между несколькими nodes. Leader получает commands и replicat-ит events на другие nodes.
Интервьюер: Да, system стала надежнее и более fault-tolerant. Но чтобы обработать 1 million TPS, одного server недостаточно. Как сделать system более scalable?
Distributed event sourcing
В предыдущем разделе мы разобрали reliable high-performance event sourcing architecture. Она решает reliability issue, но у нее есть два ограничения:
-
Когда digital wallet обновляется, нам хочется получить updated result немедленно. Но в CQRS design request/response flow может быть медленным, потому что client не знает точно, когда digital wallet обновлена, и может быть вынуждена использовать periodic polling
-
Capacity одного Raft group ограничена. При определенном scale придется shard-ить data и реализовывать distributed transactions
Посмотрим, как решить обе эти проблемы.
Pull vs push
В pull model внешний user периодически poll-ит execution status у read-only state machine. Такая model не real-time и может overload-ить wallet service, если polling frequency слишком высокая. На рисунке 25 показана pulling model.
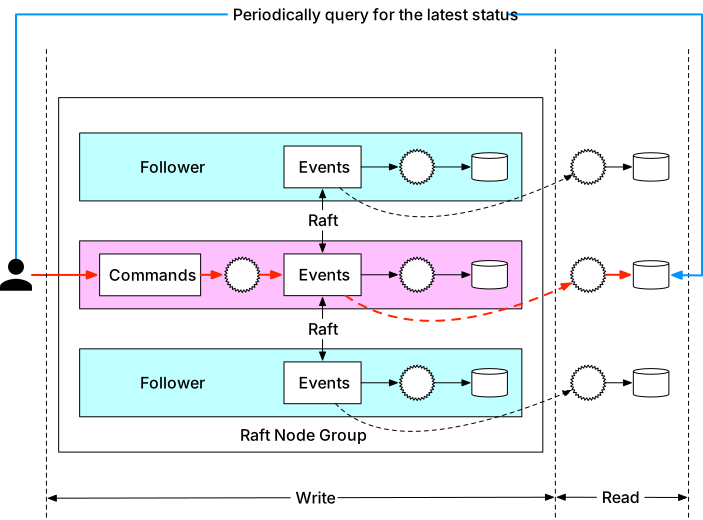
Рисунок 25 Periodical pulling
Naive pull model можно улучшить, добавив reverse proxy [18] между external user и event sourcing node. В этом design external user отправляет command reverse proxy, которая форвардит command в event sourcing nodes и периодически poll-ит execution status. Такой design упрощает client logic, но communication все равно не становится real-time.
На рисунке 26 показана pull model с добавленным reverse proxy.
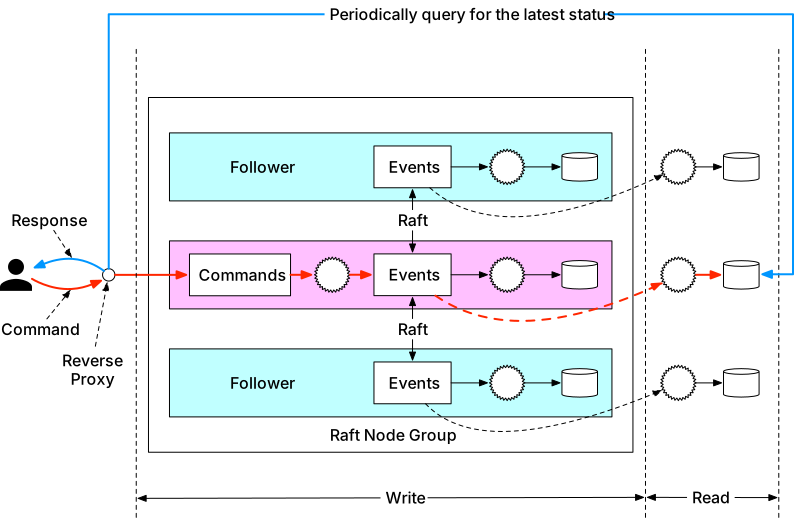
Рисунок 26 Pull model with reverse proxy
Раз уж у нас появился reverse proxy, можно сделать response быстрее, изменив поведение read-only state machine. Как уже говорилось, read-only state machine может иметь собственное behavior. Например, она может push-ить execution status обратно в reverse proxy сразу после получения event. Тогда user будет воспринимать response как real-time.
На рисунке 27 показана push-based model.
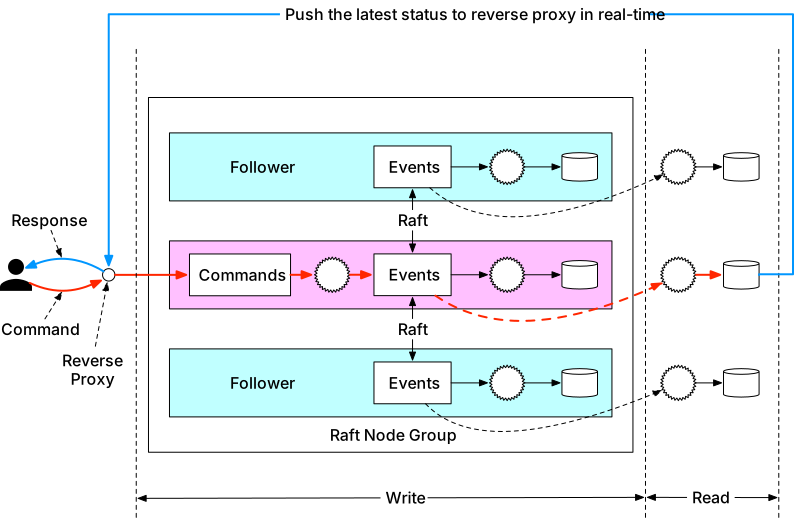
Рисунок 27 Push model
Distributed transaction
После того как для каждого event sourcing node group принято synchronous execution, можно заново использовать solution для distributed transactions: TC/C или Saga. Предположим, что data partitioned по правилу “hash value key / 2”.
На рисунке 28 показан обновленный design.
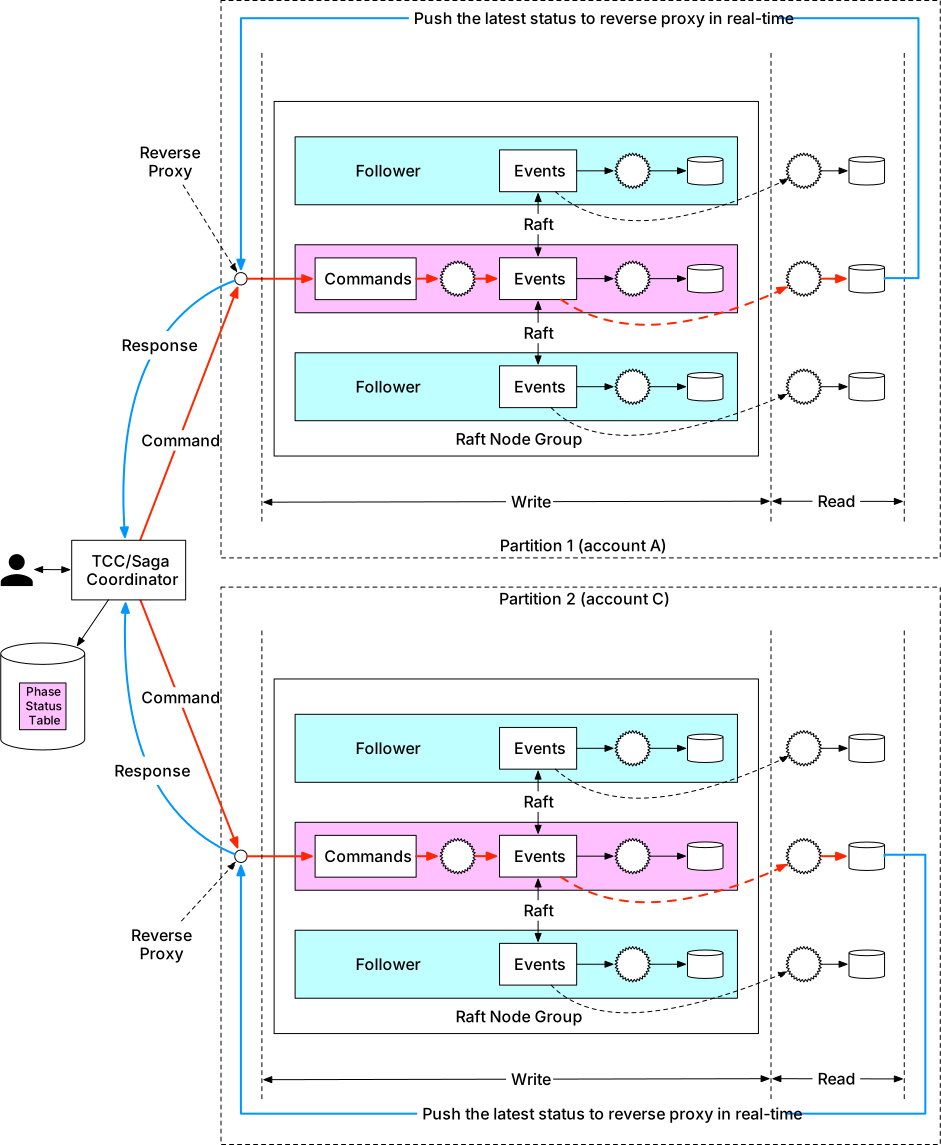
Рисунок 28 Final design
Посмотрим, как money transfer работает в final distributed event sourcing architecture. Чтобы объяснение было проще, используем distributed transaction model Saga и разберем только happy path без rollback.
Money transfer operation состоит из 2 distributed operations: A-$1 и C+$1. Saga coordinator
координирует выполнение так, как показано на рисунке 29:
-
User A отправляет distributed transaction Saga coordinator-у. В ней две operations:
A-$1иC+$1 -
Saga coordinator создает record в phase status table, чтобы отслеживать status transaction
-
Saga coordinator анализирует order operations и определяет, что сначала нужно обработать
A-$1. Coordinator отправляетA-$1как command в Partition 1, где хранится информация о account A -
Raft leader в Partition 1 получает command
A-$1и сохраняет ее в command list. Затем валидирует command. Если она valid, преобразует ее в event. Consensus algorithm Raft используется для синхронизации data между nodes. Event (списание $1 с balance A) исполняется после завершения synchronization -
После synchronization event event sourcing framework Partition 1 синхронизирует data в read path с помощью CQRS. Read path reconstruct-ит state и execution status
-
Read path Partition 1 push-ит status обратно caller-у event sourcing framework, то есть Saga coordinator-у
-
Saga coordinator получает success status от Partition 1
-
Saga coordinator создает record в phase status table, отмечающий, что operation в Partition 1 успешна
-
Так как первая operation успешна, Saga coordinator исполняет вторую operation
C+$1. Coordinator отправляетC+$1как command в Partition 2, где хранится информация об account C -
Raft leader в Partition 2 получает command
C+$1и сохраняет ее в command list. Если command valid, она преобразуется в event. Consensus algorithm Raft используется для синхронизации data между nodes. Event (добавление $1 к account C) исполняется после завершения synchronization -
После synchronization event event sourcing framework Partition 2 синхронизирует data в read path с помощью CQRS. Read path reconstruct-ит state и execution status
-
Read path Partition 2 push-ит status обратно caller-у event sourcing framework, то есть Saga coordinator-у
-
Saga coordinator получает success status от Partition 2
-
Saga coordinator создает record в phase status table, отмечающий, что operation в Partition 2 успешна
-
В этот момент все operations успешны и distributed transaction завершена. Saga coordinator отвечает своему caller-у результатом
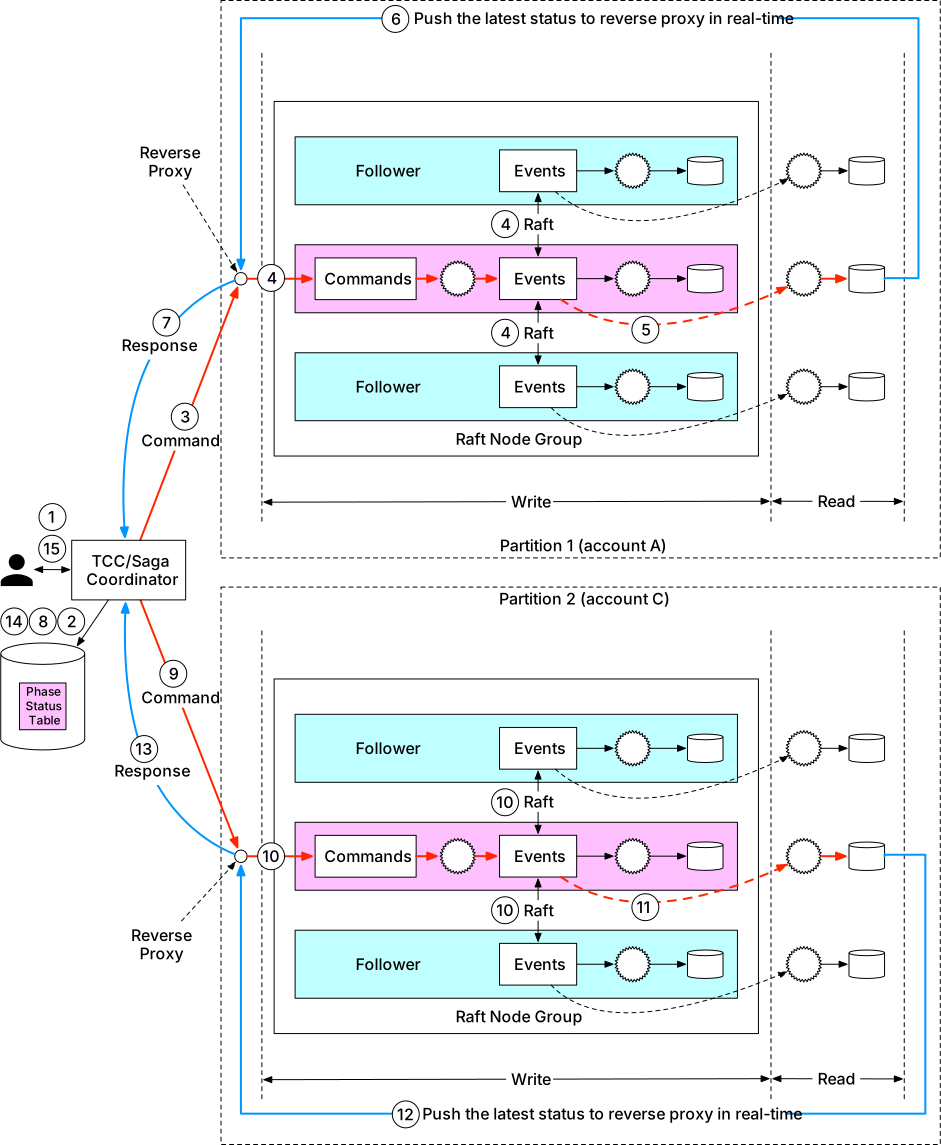
Рисунок 29 Final design in a numbered sequence
Шаг 4 — Итоги
В этой главе мы спроектировали wallet service, способную обрабатывать более 1 million payment commands per second. После back-of-the-envelope estimation мы пришли к выводу, что для такой нагрузки потребуется несколько тысяч nodes.
В первом design было предложено решение на in-memory key-value stores вроде Redis. Проблема этого design в том, что data недолговечны.
Во втором design in-memory cache заменяется transactional databases. Чтобы поддерживать несколько nodes, предлагаются разные transactional protocols: 2PC, TC/C и Saga. Главная проблема решений на основе transactions — сложность проведения data audit.
Затем вводится event sourcing. Сначала мы реализовали event sourcing через external database и queue, но это оказалось недостаточно performant. Мы улучшили performance, перенеся command, event и state на local node.
Single node означает single point of failure. Чтобы повысить reliability system, мы используем consensus algorithm Raft, replicating event list на несколько nodes.
Последнее улучшение — использование feature CQRS из event sourcing. Мы добавили reverse proxy, чтобы превратить asynchronous event sourcing framework в synchronous для external users. Protocol TC/C или Saga используется для coordination Command executions между несколькими node groups.
Поздравляю, если дочитали до этого места. Можно похлопать себе по плечу. Отличная работа!
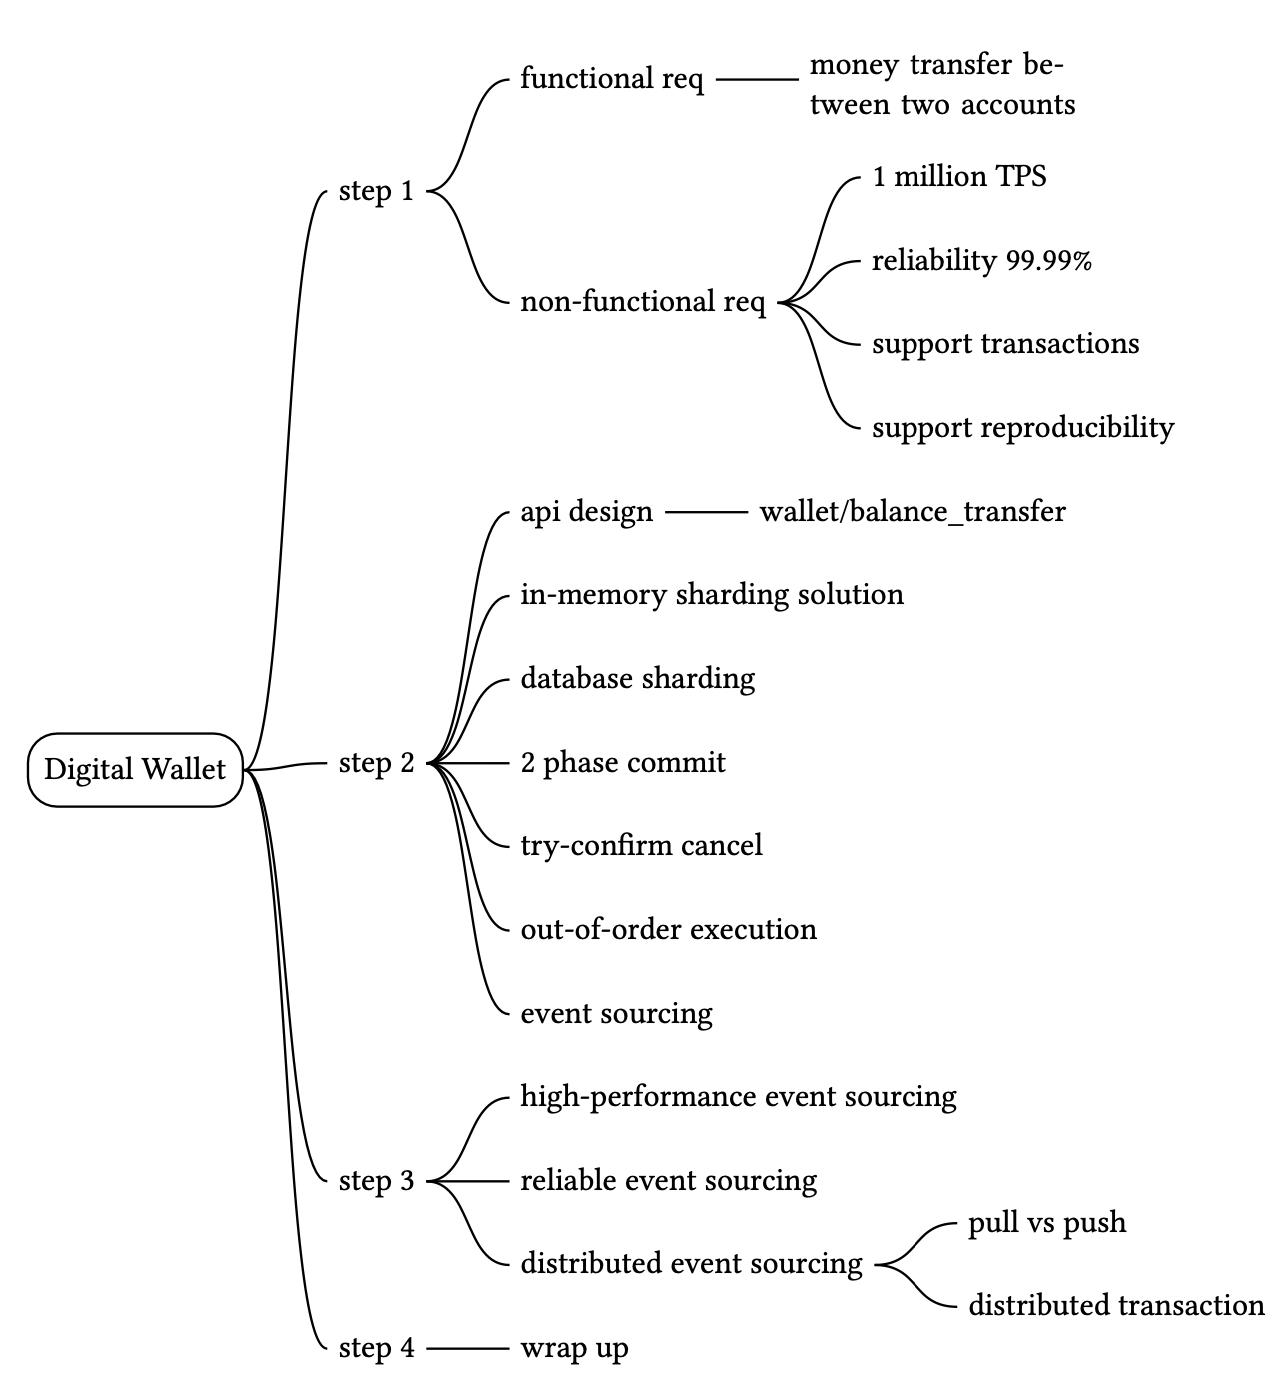
Chapter Summary
Reference materials
[1] Transactional guarantees:
https://docs.oracle.com/cd/E17275_01/html/programmer_reference/rep_trans.html
[2] TPC-E Top Price/Performance Results:
http://tpc.org/tpce/results/tpce_price_perf_results5.asp?resulttype=all
[3] ISO 4217 CURRENCY CODES: https://en.wikipedia.org/wiki/ISO_4217
[4] Apache Zookeeper: https://zookeeper.apache.org/
[5] Martin Kleppmann (2017). Designing Data-Intensive Applications. O'Reilly Media.
[6] X/Open XA: https://en.wikipedia.org/wiki/X/Open_XA
[7] Compensating transaction: https://en.wikipedia.org/wiki/Compensating_transaction
[8] SAGAS, HectorGarcia-Molina: https://www.cs.cornell.edu/andru/cs711/2002fa/reading/sagas.pdf
[9] Evans, E. (2003). Domain-Driven Design: Tackling Complexity in the Heart of Software. Addison-Wesley Professional.
[10] Apache Kafka. https://kafka.apache.org/
[11] CQRS: https://martinfowler.com/bliki/CQRS.html
[12] Comparing Random and Sequential Access in Disk and Memory:
https://deliveryimages.acm.org/10.1145/1570000/1563874/jacobs3.jpg
[13] mmap: https://man7.org/linux/man-pages/man2/mmap.2.html
[14] SQLite: https://www.sqlite.org/index.html
[15] RocksDB. https://rocksdb.org/
[16] Apache Hadoop: https://hadoop.apache.org/
[17] Raft: https://raft.github.io/
[18] Reverse proxy: https://en.wikipedia.org/wiki/Reverse_proxy