Счетчик рекламных кликов
С ростом Facebook, YouTube, TikTok и экономики онлайн-медиа digital advertising занимает все большую долю рекламных бюджетов. Поэтому отслеживание ad click events чрезвычайно важно. В этой главе мы разберем, как спроектировать систему агрегации ad click events масштаба Facebook или Google.
Прежде чем переходить к техническому дизайну, полезно понять базовые concepts онлайн-рекламы. Одно из ключевых преимуществ digital advertising — измеримость, то есть возможность опираться на данные в near real-time.
У digital advertising есть базовый процесс под названием Real-Time Bidding (RTB), в рамках которого покупается и продается рекламный inventory. На рисунке 1 показано, как работает процесс онлайн-рекламы.

Рисунок 1 Процесс RTB
Скорость RTB-процесса важна, потому что обычно он укладывается менее чем в секунду.
Точность данных тоже крайне важна. Агрегация ad click events играет критическую роль в измерении эффективности онлайн-рекламы, а это напрямую влияет на то, сколько денег платят рекламодатели. Опираясь на результаты click aggregation, campaign managers могут контролировать бюджет или менять bidding strategies, например корректировать целевые audience groups, keywords и т. д. Ключевые метрики онлайн-рекламы, включая click-through rate (CTR) [1] и conversion rate (CVR) [2], зависят от агрегированных ad click data.
Шаг 1 — Понять задачу и определить рамки дизайна
Следующий набор вопросов помогает уточнить требования и сузить scope.
Кандидат: Какой формат у входных данных?
Интервьюер: Это log file, расположенный на разных серверах, и новые click events
дописываются в конец файла. У события есть следующие attributes: ad_id, click_timestamp,
user_id, ip и country.
Кандидат: Какой объем данных?
Интервьюер: 1 миллиард ad clicks в день и 2 миллиона ads всего. Число ad click events растет
на 30% год к году.
Кандидат: Какие запросы самые важные?
Интервьюер: Система должна поддерживать следующие 3 запроса:
-
Вернуть количество click events для конкретного ad за последние M минут.
-
Вернуть top 100 самых кликаемых ads за последнюю 1 минуту. Оба параметра должны быть конфигурируемыми. Агрегация выполняется каждую минуту.
-
Поддерживать фильтрацию данных по ip, user_id или country для двух запросов выше.
Кандидат: Нужно ли учитывать edge cases? Я вижу, например, такие:
- Некоторые events могут приходить позже ожидаемого.
- Некоторые events могут дублироваться.
- Любая часть системы может упасть в любой момент, значит надо продумать recovery.
Интервьюер: Хороший список. Да, это нужно учитывать.
Кандидат: Какое требование по latency?
Интервьюер: Несколько минут end-to-end latency. Обрати внимание, что требования по latency
для RTB и для ad click aggregation сильно различаются. Для RTB latency обычно меньше секунды из-за
требований по responsiveness, а вот для ad click event aggregation допустимы несколько минут,
потому что она в основном используется для ad billing и reporting.
Из информации выше у нас есть и functional, и non-functional requirements.
Functional requirements
-
Агрегировать количество кликов для ad_id за последние M минут.
-
Каждую минуту возвращать top 100 самых кликаемых ad_id.
-
Поддерживать фильтрацию агрегации по разным attributes.
-
Объем dataset — масштаб Facebook или Google (подробнее о размерах системы в разделе back-of-the-envelope estimation ниже).
Нефункциональные требования
-
Корректность aggregation result важна, потому что данные используются для RTB и billing.
-
Корректно обрабатывать delayed и duplicated events.
-
Robustness. Система должна быть устойчивой к частичным отказам.
-
Требование по latency. End-to-end latency должно составлять несколько минут, максимум.
Back-of-the-envelope estimation
Сделаем грубую оценку, чтобы понять масштаб системы и потенциальные сложности.
-
1 миллиард DAU.
-
Предположим, в среднем каждый пользователь кликает по 1 объявлению в день. Это 1 миллиард ad click events в день.
-
Ad click QPS = 10^9 events / 10^5 секунд в день = 10,000
-
Предположим, peak ad click QPS в 5 раз выше среднего. Peak QPS = 50,000 QPS.
-
Предположим, один ad click event занимает 0.1 KB. Тогда дневное требование по storage: 0.1 KB * 1 миллиард = 100 GB. Месячное требование по storage — около 3 TB.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
В этом разделе обсудим query API design, data model и high-level design.
Query API design
Цель API design — зафиксировать контракт между client и server. В consumer app клиентом обычно является конечный пользователь продукта. В нашем случае клиент — это пользователь dashboard (data scientist, product manager, advertiser и т. д.), который запускает запросы к aggregation service.
Еще раз посмотрим на functional requirements, чтобы лучше спроектировать API:
-
Агрегировать количество кликов для ad_id за последние M минут.
-
Возвращать top N самых кликаемых ad_id за последнюю M минуту.
-
Поддерживать фильтрацию агрегации по разным attributes.
Нам нужны всего два API для этих трех use cases, потому что filtering можно поддержать, добавив query parameters к запросам.
API 1: агрегировать количество кликов для ad_id за последние M минут.
| API | Описание |
|---|---|
GET /v1/ads/{:ad\_id}/aggregated\_count | Вернуть агрегированный count событий для данного ad_id |
Таблица 1 API для агрегации количества кликов
Параметры запроса:
| Поле | Описание | Тип |
|---|---|---|
| from | Начальная минута (по умолчанию: текущий момент минус 1 минута) | long |
| to | Конечная минута (по умолчанию: текущий момент) | long |
| filter | Идентификатор стратегии фильтрации. Например, filter = 001 исключает не-US clicks | long |
Таблица 2 Параметры запроса для GET /v1/ads/{:ad\_id}/aggregated\_count
Ответ:
| Поле | Описание | Тип |
|---|---|---|
| ad_id | Идентификатор объявления | string |
| count | Агрегированное количество между начальной и конечной минутами | long |
Таблица 3 Ответ для GET /v1/ads/{:ad\_id}/aggregated\_count
API 2: вернуть top N самых кликаемых ad_id за последние M минут
| API | Описание |
|---|---|
| GET /v1/ads/popular_ads | Вернуть top N самых кликаемых ads за последние M минут |
Таблица 4 API для /v1/ads/popular\_ads
Параметры запроса:
| Поле | Описание | Тип |
|---|---|---|
| count | Top N самых кликаемых ads | integer |
| window | Размер aggregation window (M) в минутах | integer |
| filter | Идентификатор стратегии фильтрации | long |
Таблица 5 Параметры запроса для /v1/ads/popular\_ads
Ответ:
| Поле | Описание | Тип |
|---|---|---|
| ad_ids | Список самых кликаемых ads | array |
Таблица 6 Ответ для /v1/ads/popular\_ads
Data model
В системе есть два типа данных: raw data и aggregated data.
Raw data
Ниже показано, как raw data выглядит в log files:
[AdClickEvent] ad001, 2021-01-01 00:00:01, user 1, 207.148.22.22, USA
Таблица 7 показывает структуру этих данных. Данные разбросаны по разным application servers.
| ad_id | click_timestamp | user | ip | country |
|---|---|---|---|---|
| ad001 | 2021-01-01 00:00:01 | user1 | 207.148.22.22 | USA |
| ad001 | 2021-01-01 00:00:02 | user1 | 207.148.22.22 | USA |
| ad002 | 2021-01-01 00:00:02 | user2 | 209.153.56.11 | USA |
Таблица 7 Raw data
Aggregated data
Предположим, ad click events агрегируются каждую минуту. Таблица 8 показывает aggregated result.
| ad_id | click_minute | count |
|---|---|---|
| ad001 | 202101010000 | 5 |
| ad001 | 202101010001 | 7 |
Таблица 8 Aggregated data
Чтобы поддержать ad filtering, добавим в таблицу дополнительное поле filter_id. Записи с одинаковыми ad_id и click_minute группируются по filter_id, как в таблице 9, а сами filters определяются в таблице 10.
| ad_id | click_minute | filter_id | count |
|---|---|---|---|
| ad001 | 202101010000 | 0012 | 2 |
| ad001 | 202101010000 | 0023 | 3 |
| ad001 | 202101010001 | 0012 | 1 |
| ad001 | 202101010001 | 0023 | 6 |
Таблица 9 Aggregated data с filters
| filter_id | region | IP | user_id |
|---|---|---|---|
| 0012 | US | * | * |
| 0013 | * | 123.1.2.3 | * |
Таблица 10 Таблица filters
Чтобы поддержать запрос top N самых кликаемых ads за последние M минут, используется следующая структура.
| Поле | Тип | Описание |
|---|---|---|
| window_size | integer | Размер aggregation window (M) в минутах |
| update_time_minute | timestamp | Время последнего обновления (с точностью до минуты) |
| most_clicked_ads | array | Список ad IDs в формате JSON |
Таблица 11 Поддержка top N самых кликаемых ads за последние M минут
Сравнение
Сравнение хранения raw data и aggregated data приведено ниже:
| Только raw data | Только aggregated data | |
|---|---|---|
| Плюсы | Полный dataset; поддержка filtering и recalculation | Меньший объем данных; быстрые queries |
| Минусы | Огромный объем хранения; медленные queries | Потеря данных. Это derived data. Например, 10 записей могут стать 1 |
Таблица 12 Raw data vs aggregated data
Стоит ли хранить raw data или aggregated data? Наша рекомендация — хранить оба типа. Посмотрим почему.
-
Имеет смысл сохранять raw data. Если что-то пойдет не так, их можно использовать для debugging. Если aggregated data окажется повреждена из-за серьезного бага, после исправления бага мы сможем пересчитать aggregated data из raw data.
-
Aggregated data тоже нужно хранить. Объем raw data огромен, и из-за этого напрямую выполнять queries по raw data очень неэффективно. Поэтому read queries мы запускаем по aggregated data.
-
Raw data служит backup data. Обычно мы не запрашиваем raw data, если не нужен recalculation. Старые raw data можно переносить в cold storage, чтобы снизить costs.
-
Aggregated data служит active data. Она оптимизирована под query performance.
Выбрать правильную database
При выборе подходящей database нужно оценить следующее:
-
Как выглядят данные? Они relational? Это document или blob?
-
Workflow read-heavy, write-heavy или и то и другое?
-
Нужна ли поддержка transactions?
-
Зависят ли queries от большого числа online analytical processing (OLAP) functions [3], таких как
SUM,COUNT?
Сначала посмотрим на raw data. Хотя при обычной работе мы не делаем queries по raw data, они полезны для data scientists или machine learning engineers, которые изучают user response prediction, behavioral targeting, relevance feedback и т. д. [4].
Как показала оценка выше, средний write QPS равен 10,000, а peak QPS может достигать 50,000, поэтому система write-heavy. На read side raw data используется как backup и источник для recalculation, так что теоретически read volume невелик.
Relational databases справятся, но масштабировать writes может быть сложно. NoSQL databases, такие как Cassandra и InfluxDB, подходят лучше, потому что они оптимизированы под writes и time-range queries.
Еще один вариант — хранить данные в Amazon S3, используя один из columnar data formats вроде ORC [5], Parquet [6] или AVRO [7]. Можно ограничивать размер каждого файла, например 10GB, а stream processor, отвечающий за запись raw data, будет делать file rotation при достижении этого лимита. Поскольку для многих такой setup может быть менее знаком, в этом дизайне мы используем Cassandra как пример.
Для aggregated data данные по природе являются time-series, а workflow одновременно и read-heavy, и write-heavy. Это связано с тем, что для каждого ad нам нужно каждую минуту запрашивать database, чтобы показывать пользователям актуальный aggregation count. Это полезно для auto-refresh dashboard или своевременного срабатывания alerts. Поскольку всего ads два миллиона, workflow read-heavy. Параллельно aggregation service каждую минуту агрегирует данные и пишет их, так что система и write-heavy тоже. Мы можем использовать один и тот же тип database для raw data и aggregated data.
Теперь, когда мы обсудили query API design и data model, соберем high-level design.
High-level design
В real-time big data [8] processing данные обычно входят в processing system и выходят из нее в виде unbounded data streams. Aggregation service работает так же: input — это raw data (unbounded data streams), output — aggregated results (см. рисунок 2).

Рисунок 2 Aggregation workflow
Asynchronous processing
Текущий дизайн синхронный. Это плохо, потому что capacity producers и consumers не всегда совпадает. Например, если внезапно вырастет traffic и число produced events сильно превысит то, что consumers способны обработать, consumers могут получить out-of-memory errors или неожиданно завершиться. Если один компонент синхронной цепочки падает, перестает работать вся система.
Обычное решение — использовать message queue, например Kafka, чтобы decouple producers и consumers. Тогда весь процесс становится asynchronous, а producers и consumers можно масштабировать независимо.
Собрав все вместе, получаем high-level design, показанный на рисунке 3. Log watcher, aggregation service и database развязаны двумя message queues. Database writer читает данные из message queue, преобразует их в database format и записывает в database.
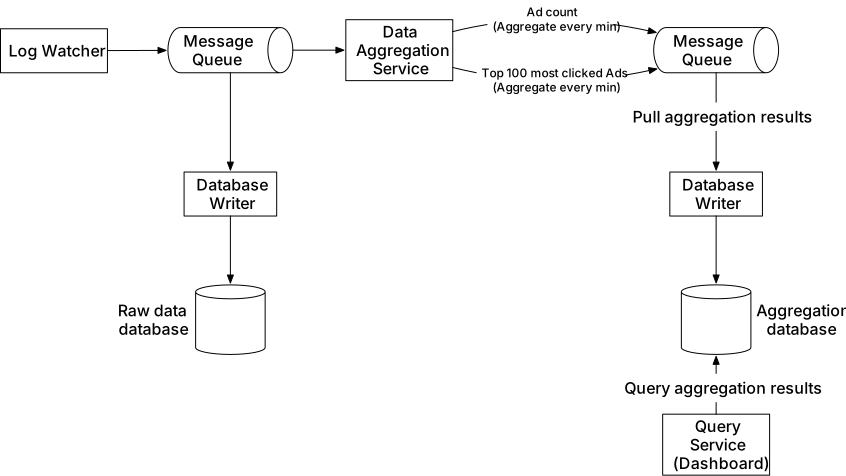
Рисунок 3 High-level design
Что хранится в первой message queue? Она содержит ad click event data, как в таблице 13.
| ad_id | click_timestamp | user_id | ip | country |
|---|
Таблица 13 Данные в первой message queue
Что хранится во второй message queue? Вторая queue содержит два типа данных:
- Ad click counts, агрегированные с точностью до минуты.
| ad_id | click_minute | count |
|---|
Таблица 14 Данные во второй message queue
- Top N самых кликаемых ads, агрегированные с точностью до минуты.
| update_time_minute | most_clicked_ads |
|---|
Таблица 15 Данные во второй message queue
Можно спросить, почему мы не пишем aggregated results напрямую в database. Короткий ответ: нам нужна вторая message queue, такая как Kafka, чтобы обеспечить end-to-end exactly-once semantics (atomic commit).
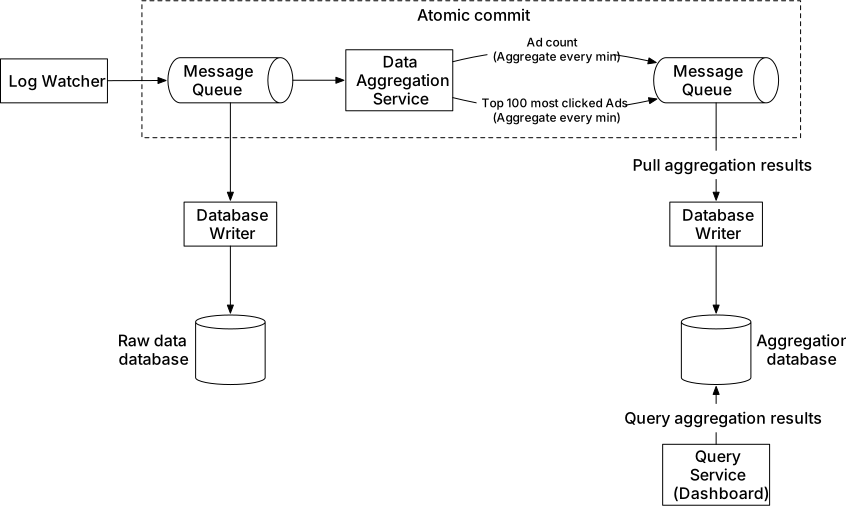
Рисунок 4 End-to-end exactly once
Теперь разберем подробнее aggregation service.
Aggregation service
MapReduce framework — хороший вариант для агрегации ad click events. Directed acyclic graph (DAG) — подходящая модель для этого [9]. Суть DAG-модели в том, чтобы разбить систему на небольшие computing units, например Map/Aggregate/Reduce nodes, как показано на рисунке 5.
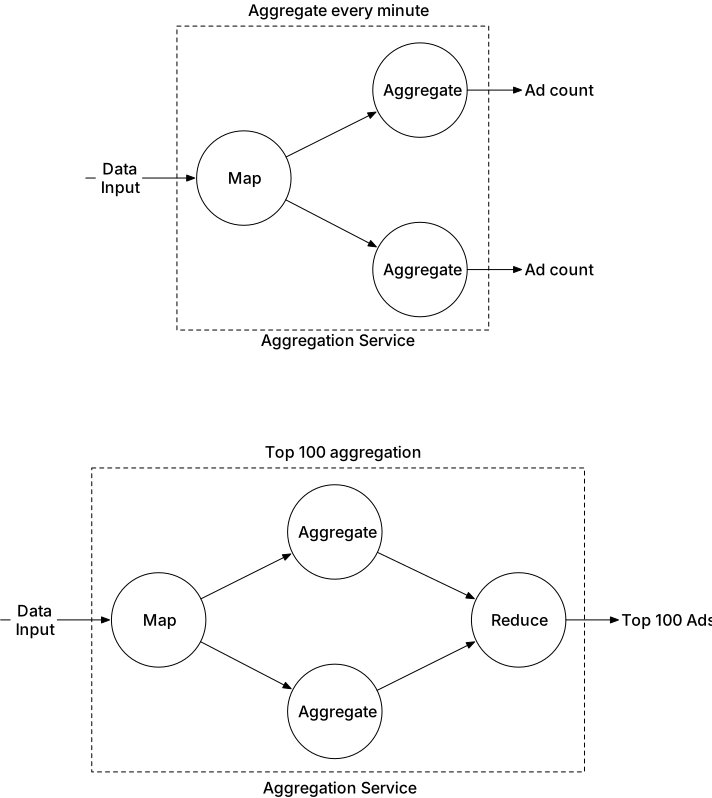
Рисунок 5 Aggregation service
Каждый node отвечает за одну конкретную задачу и отправляет результат обработки downstream nodes.
Map node
Map node читает данные из data source, а затем фильтрует и трансформирует их. Например, Map node отправляет ads с ad_id % 2 = 0 в node 1, а остальные ads — в node 2, как показано на рисунке 6.

Рисунок 6 Map operation
Можно спросить, зачем вообще нужен Map node. Альтернатива — настроить Kafka partitions или tags и дать aggregate nodes подписываться на Kafka напрямую. Это работает, но input data может требовать очистки или нормализации, и эти операции удобно выполнять в Map node. Еще одна причина — мы не всегда контролируем, как данные производятся, поэтому events с одинаковым ad_id могут попасть в разные Kafka partitions.
Aggregate node
Aggregate node каждую минуту считает ad click events по ad_id в памяти. В парадигме MapReduce Aggregate node является частью Reduce. Поэтому процесс map-aggregate-reduce по сути означает map-reduce-reduce.
Reduce node
Reduce node объединяет aggregated results со всех Aggregate nodes в финальный result. Например, как показано на рисунке 7, есть три aggregation nodes, и каждая хранит top 3 самых кликаемых ads внутри себя. Reduce node сводит общее множество самых кликаемых ads к финальному top 3.
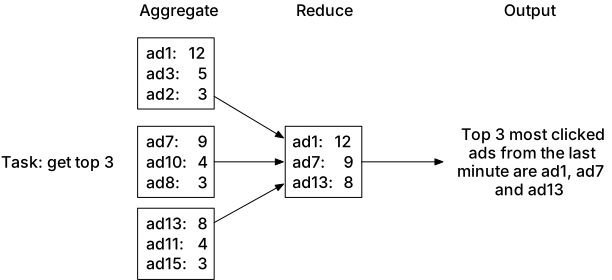
Рисунок 7 Reduce node
DAG model представляет известную парадигму MapReduce. Она рассчитана на то, чтобы взять big data и с помощью parallel distributed computing превратить их в маленькие или обычные по размеру данные.
В DAG model intermediate data можно хранить в memory, а разные nodes могут взаимодействовать либо через TCP (если они работают в разных processes), либо через shared memory (если они работают в разных threads).
Main use cases
Теперь, когда мы понимаем, как MapReduce работает на high level, посмотрим, как его использовать для основных use cases:
-
Агрегировать количество кликов для
ad_idза последние M минут. -
Возвращать top N самых кликаемых
ad_idза последние M минут. -
Data filtering.
Use case 1: агрегировать количество кликов
Как показано на рисунке 8, входные events partitioned по ad_id (ad_id % 3) в Map nodes, а
затем агрегируются в Aggregation nodes.
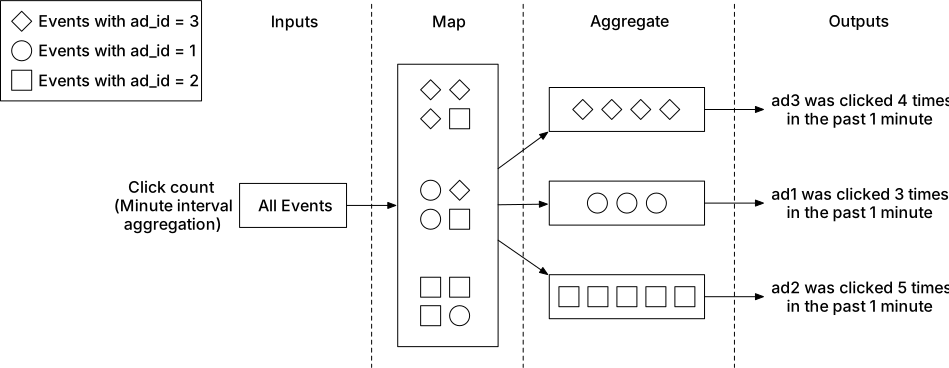
Рисунок 8 Агрегация количества кликов
Use case 2: вернуть top N самых кликаемых ads
На рисунке 9 показан упрощенный дизайн получения top 3 самых кликаемых ads, который легко
расширяется до top N. Входные events мапятся по ad_id, и каждый Aggregate node поддерживает
heap data structure, чтобы эффективно получать top 3 ads внутри node. На последнем шаге Reduce
node сводит 9 ads (top 3 с каждого aggregate node) к итоговому top 3 самых кликаемых ads каждую
минуту.
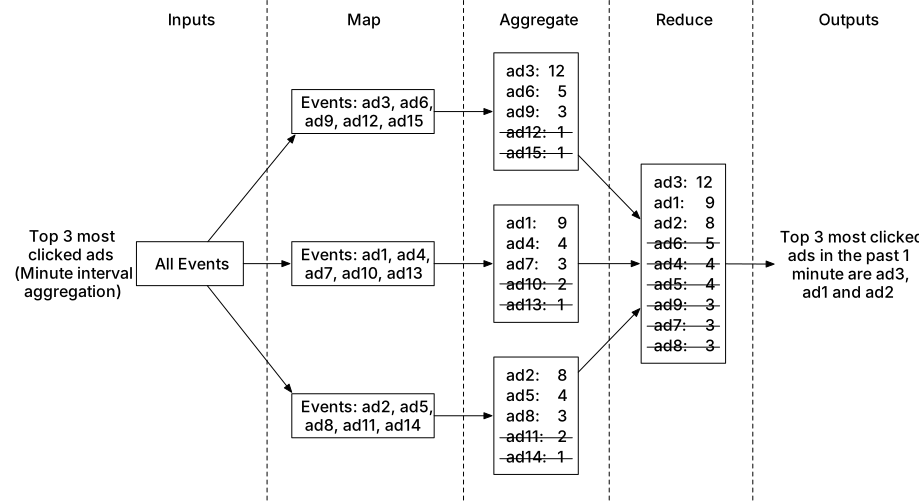
Рисунок 9 Возврат top N самых кликаемых ads
Use case 3: data filtering
Чтобы поддержать filtering вроде «покажи aggregated click count для ad001 только в USA», можно
заранее определить filtering criteria и агрегировать данные на их основе. Например, aggregation
results для ad001 и ad002 могут выглядеть так:
| ad_id | click_minute | country | count |
|---|---|---|---|
| ad001 | 202101010001 | USA | 100 |
| ad001 | 202101010001 | GPB | 200 |
| ad001 | 202101010001 | others | 3000 |
| ad002 | 202101010001 | USA | 10 |
| ad002 | 202101010001 | GPB | 25 |
| ad002 | 202101010001 | others | 12 |
Таблица 16 Aggregation results (filter by country)
Эта техника называется star schema [11] и широко используется в data warehouses. Поля, по которым идет фильтрация, называются dimensions. У этого подхода есть следующие преимущества:
-
Его легко понять и построить.
-
Текущий aggregation service можно переиспользовать для создания дополнительных dimensions в star schema. Никаких новых components не требуется.
-
Доступ к данным по filtering criteria быстрый, потому что result рассчитывается заранее.
Ограничение этого подхода в том, что он создает гораздо больше buckets и records, особенно если критериев фильтрации много.
Шаг 3 — Погружение в детали дизайна
В этом разделе мы подробнее рассмотрим следующее:
-
Streaming vs batching
-
Time и aggregation window
-
Delivery guarantees
-
Масштабирование системы
-
Data monitoring и correctness
-
Финальную design diagram
-
Fault tolerance
Streaming vs batching
High-level architecture, предложенная на рисунке 3, — это разновидность stream processing system. Таблица 17 сравнивает три типа систем [12]:
| Services (online system) | Batch system (offline system) | Streaming system (near real-time system) | |
|---|---|---|---|
| Responsiveness | Быстро отвечает клиенту | Ответ клиенту не нужен | Ответ клиенту не нужен |
| Input | User requests | Bounded input конечного размера, большой объем данных | Input не имеет границ (infinite streams) |
| Output | Responses to clients | Materialized views, aggregated metrics и т. д. | Materialized views, aggregated metrics и т. д. |
| Метрика performance | Availability, latency | Throughput | Throughput, latency |
| Пример | Online shopping | MapReduce | Flink [13] |
Таблица 17 Сравнение трех типов систем
В нашем дизайне используются и stream processing, и batch processing. Stream processing нужен, чтобы обрабатывать данные по мере поступления и формировать aggregated results в near real-time. Batch processing нужен для backup исторических данных.
Если у системы одновременно есть два processing paths — batch и streaming, — такая архитектура называется lambda [14]. Недостаток lambda architecture в том, что у вас два processing paths, значит, приходится поддерживать два codebases. Kappa architecture [15], которая объединяет batch и streaming в один processing path, решает эту проблему. Ключевая идея — обрабатывать и real-time data, и постоянный reprocessing исторических данных через единый stream processing engine. На рисунке 10 показано сравнение lambda и kappa architecture.
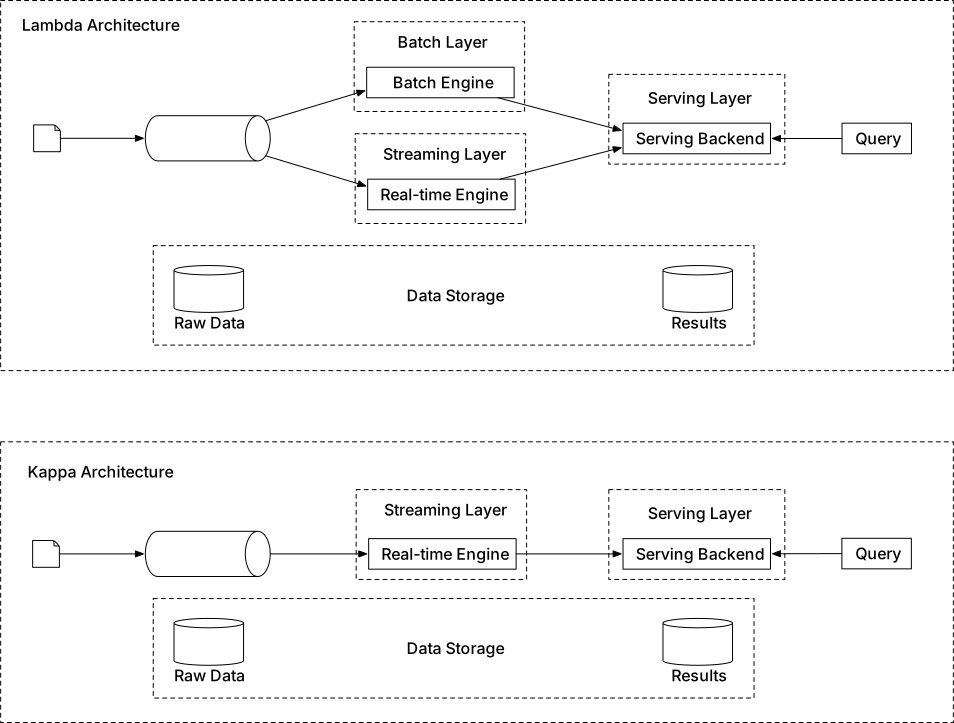
Рисунок 10 Lambda и Kappa architectures
Наш high-level design использует Kappa architecture, где reprocessing исторических данных тоже проходит через real-time aggregation service. Подробности см. в разделе «Data recalculation» ниже.
Data recalculation
Иногда приходится пересчитывать aggregated data, что также называют historical data replay. Например, если мы обнаружили серьезный bug в aggregation service, нам нужно пересчитать aggregated data из raw data, начиная с точки, где bug был внесен. На рисунке 11 показан flow пересчета:
-
Recalculation service получает данные из raw data storage. Это batched job.
-
Полученные данные отправляются в dedicated aggregation service, чтобы historical data replay не влиял на real-time processing.
-
Aggregated results отправляются во вторую message queue, а затем обновляются в aggregation database.
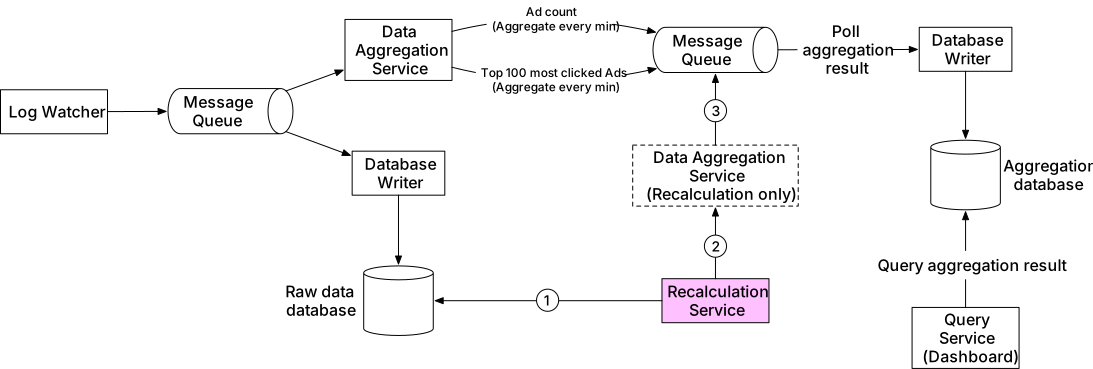
Рисунок 11 Recalculation service
Процесс recalculation переиспользует data aggregation service, но использует другой data source — raw data.
Time
Для агрегации нам нужен timestamp. Он может быть сгенерирован в двух разных местах:
-
Event time: момент, когда произошел ad click.
-
Processing time: системное время aggregation server, который обрабатывает click event.
Из-за network delays и asynchronous environment (данные проходят через message queue) разрыв между event time и processing time может быть большим. Как показано на рисунке 12, событие 1 приходит в aggregation service очень поздно — через 5 часов.

Рисунок 12 Late events
Если для агрегации использовать event time, придется обрабатывать delayed events. Если использовать processing time, aggregation result может оказаться неточным. Идеального решения нет, поэтому нужно понимать trade-offs.
| Плюсы | Минусы | |
|---|---|---|
| Event time | Aggregation results точнее, потому что клиент точно знает, когда был совершен ad click | Зависит от timestamp, сгенерированного на client-side. У клиентов может быть неверное время, либо timestamp может прийти от malicious users |
| Processing time | Server timestamp надежнее | Timestamp неточен, если event попадает в систему заметно позже фактического события |
Таблица 18 Event time vs processing time
Поскольку точность данных очень важна, мы рекомендуем использовать event time для агрегации. Как в
таком случае корректно обрабатывать delayed events? Для slightly delayed events часто используют
технику под названием watermark.
На рисунке 13 ad click events агрегируются в one-minute tumbling window (подробнее см. раздел «Aggregation window»). Если использовать event time для определения принадлежности event окну, то window 1 пропускает event 2, а window 3 пропускает event 5, потому что они приходят немного позже конца своих aggregation windows.
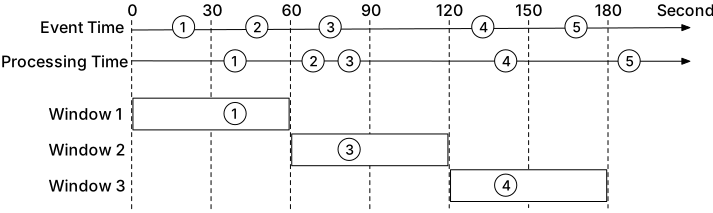
Рисунок 13 Пропуск событий в aggregation window
Один из способов смягчить проблему — использовать watermark (расширенные прямоугольники на
рисунке 14), который можно рассматривать как расширение aggregation window. Это повышает точность
aggregation result. Если продлить окно еще на 15 секунд (значение настраивается), то window 1
сможет включить event 2, а window 3 — event 5.
Значение watermark зависит от business requirements. Длинный watermark может поймать события,
которые пришли очень поздно, но увеличит latency системы. Короткий watermark делает данные менее
точными, зато добавляет меньше latency.
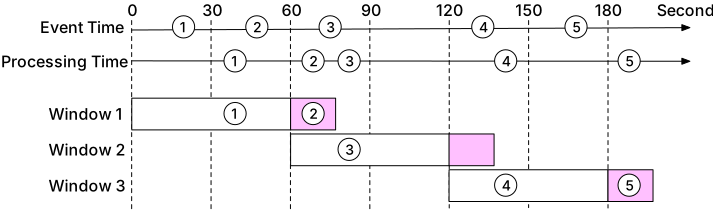
Рисунок 14 Watermark
Заметьте, что watermark не решает проблему events с очень большой задержкой. Можно утверждать, что усложнять дизайн ради low probability events невыгодно с точки зрения ROI. Небольшую неточность всегда можно исправить при end-of-day reconciliation (см. раздел Reconciliation). Важный trade-off: watermark повышает точность данных, но увеличивает общую latency из-за дополнительного времени ожидания.
Aggregation window
Согласно книге Мартина Клеппмана “Designing Data-Intensive Applications” [16], есть четыре типа window functions: tumbling window (он же fixed window), hopping window, sliding window и session window. Мы обсудим tumbling window и sliding window, потому что они наиболее релевантны нашей системе.
В tumbling window (подсвечен на рисунке 15) время делится на равные, неперекрывающиеся chunks. Tumbling window хорошо подходит для агрегации ad click events каждую минуту (use case 1).

Рисунок 15 Tumbling window
В sliding window (подсвечен на рисунке 16) события группируются в окне, которое сдвигается по data stream с заданным интервалом. Sliding window может быть overlapping. Это хороший способ удовлетворить наш второй use case — получать top N самых кликаемых ads за последние M минут.

Рисунок 16 Sliding window
Delivery guarantees
Поскольку aggregation result используется для billing, точность и полнота данных чрезвычайно важны. Система должна уметь отвечать на такие вопросы:
-
Как избежать обработки duplicate events?
-
Как гарантировать, что все events обработаны?
Message queues, такие как Kafka, обычно предоставляют три delivery semantics: at-most-once, at-least-once и exactly-once.
Какой способ доставки выбрать?
В большинстве случаев at-least-once processing достаточно хорош, если допустим небольшой процент дубликатов.
Но не в нашей системе. Расхождения даже в несколько процентов могут привести к несоответствиям на миллионы долларов. Поэтому мы рекомендуем exactly-once delivery. Если интересно посмотреть на реальную ad aggregation system, изучите, как это реализовано в Yelp [17].
Data deduplication
Одна из самых распространенных проблем data quality — duplicated data. Дубликаты могут появляться по самым разным причинам, и в этом разделе мы разберем два типичных источника.
-
Client-side. Например, клиент может отправить одно и то же событие несколько раз. Duplicated events, отправленные со злым умыслом, лучше обрабатывать отдельными ad fraud/risk control components. Если тема интересна, см. reference material [18].
-
Server outage. Если node aggregation service падает посреди aggregation и upstream service еще не получил acknowledgment, те же самые events могут быть отправлены и агрегированы повторно. Посмотрим подробнее.
На рисунке 17 показано, как outage у aggregation service node (Aggregator) создает duplicate data. Aggregator отслеживает статус consumption, сохраняя offset в upstream Kafka.

Рисунок 17 Duplicate data
Если step 6 не удается, например из-за outage Aggregator, events с 100 по 110 уже отправлены downstream, но новый offset 110 не сохранен в upstream Kafka. В этом случае новый Aggregator снова начнет consumption с offset 100, даже если эти events уже были обработаны, и это создаст дубли.
Самое прямолинейное решение (рисунок 18) — использовать внешнее file storage, например HDFS или S3, чтобы записывать offset. Но и у этого решения есть проблемы.

Рисунок 18 Сохранение offset
На step 3 aggregator обработает events с offset 100 по 110 только если последний offset, сохраненный во внешнем storage, равен 100. Если в storage уже лежит offset 110, aggregator игнорирует events до offset 110.
Но у этого дизайна есть серьезная проблема: offset сохраняется в HDFS / S3 (step 3.2) до того, как aggregation result отправлен downstream. Если step 4 падает из-за outage Aggregator, events с 100 по 110 уже никогда не будут обработаны новым aggregator node, потому что во внешнем storage уже сохранен offset 110.
Чтобы избежать data loss, нужно сохранять offset только после того, как мы получили acknowledgment от downstream. Обновленный дизайн показан на рисунке 19.

Рисунок 19 Сохранение offset после получения ack
В этом дизайне, если Aggregator падает до выполнения step 5.1, events с 100 по 110 будут снова
отправлены downstream. Чтобы добиться exactly-once processing, нужно поместить операции между
step 4 и step 6 в одну distributed transaction. Distributed transaction — это transaction,
работающая сразу на нескольких nodes. Если любая операция внутри нее падает, откатывается вся
transaction.

Рисунок 20 Distributed transaction
Как видите, dedupe data в large-scale systems — не самая простая задача. Как добиться
exactly-once processing — это уже продвинутая тема. Если хотите углубиться, см. reference
material [19].
Масштабирование системы
Из rough estimation видно, что бизнес растет на 30% в год, а значит traffic удваивается примерно каждые 3 года. Как справиться с этим ростом? Посмотрим.
Наша система состоит из трех независимых components: message queue, aggregation service и database. Поскольку эти components decoupled, каждый из них можно масштабировать отдельно.
Масштабирование message queue
Мы уже подробно обсуждали масштабирование message queue в главе “Distributed Message Queue”, так что здесь ограничимся несколькими тезисами.
Producers. Мы не ограничиваем число producer instances, поэтому scalability producers достигается легко.
Consumers. Внутри consumer group механизм rebalancing помогает масштабировать consumers путем добавления или удаления nodes. Как показано на рисунке 21, если добавить еще двух consumers, каждый consumer будет обрабатывать events только из одной partition.
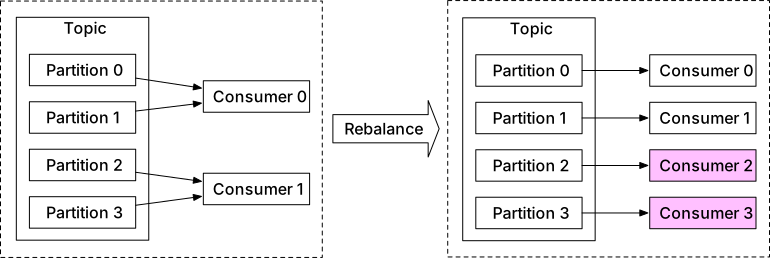
Рисунок 21 Добавление consumers
Когда в системе сотни Kafka consumers, rebalance может идти довольно медленно и занимать несколько минут или даже больше. Поэтому, если нужно добавить consumers, лучше делать это в off-peak hours, чтобы минимизировать impact.
Brokers
-
Hashing key
Используем ad_id как hashing key для Kafka partition, чтобы events одного и того же ad_id хранились в одной Kafka partition. Тогда aggregation service может читать все events одного ad_id из одной partition.
-
Число partitions
Если число partitions меняется, events одного и того же ad_id могут начать отображаться в другую partition. Поэтому рекомендуется заранее pre-allocate достаточное количество partitions, чтобы не увеличивать их число динамически в production.
-
Topic physical sharding
Одного topic обычно недостаточно. Мы можем разбить данные по geography (
topic_north_america,topic_europe,topic_asiaи т. д.) или по business type (topic_web_ads,topic_mobile_adsи т. д.).Плюсы: разбиение данных на разные topics помогает увеличить throughput системы. А если у одного topic меньше consumers, то и rebalance consumer groups проходит быстрее.
Минусы: появляется дополнительная сложность и растут maintenance costs.
Масштабирование aggregation service
В high-level design мы говорили, что aggregation service — это map/reduce operation. На рисунке 22 показано, как все это соединено.
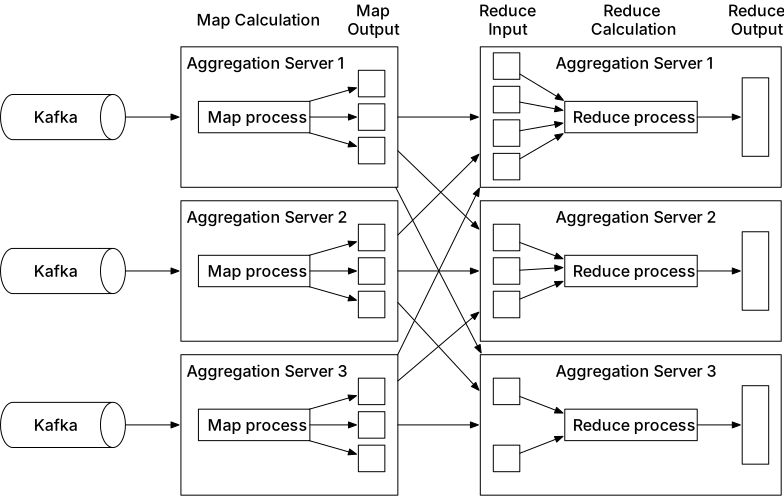
Рисунок 22 Aggregation service
Если вам интересны детали, см. reference material [20]. Aggregation service горизонтально масштабируется путем добавления или удаления nodes. Здесь возникает интересный вопрос: как увеличить throughput aggregation service? Есть два варианта.
Вариант 1: распределять events с разными ad_id по разным threads, как показано на рисунке 23.
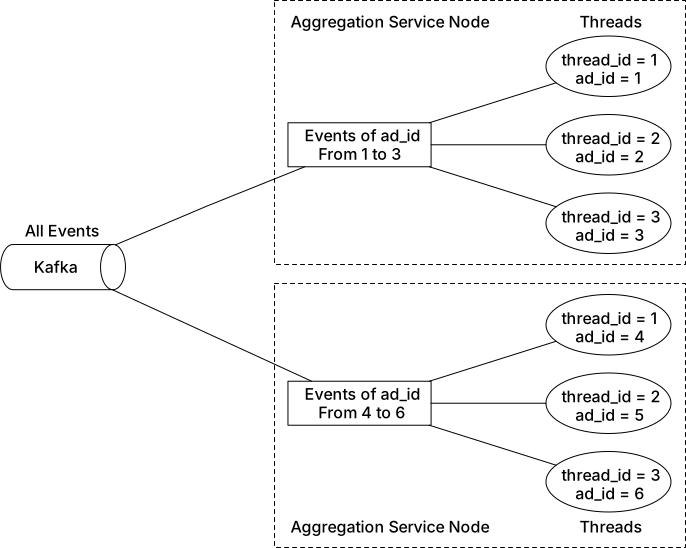
Рисунок 23 Multi-threading
Вариант 2: разворачивать aggregation service nodes на resource providers, таких как Apache Hadoop YARN [21]. Этот подход можно рассматривать как использование multi-processing.
Вариант 1 проще в реализации и не зависит от resource providers. Но на практике вариант 2 используется чаще, потому что позволяет масштабировать систему простым добавлением computing resources.
Масштабирование database
Cassandra из коробки поддерживает horizontal scaling, во многом похожий на consistent hashing.
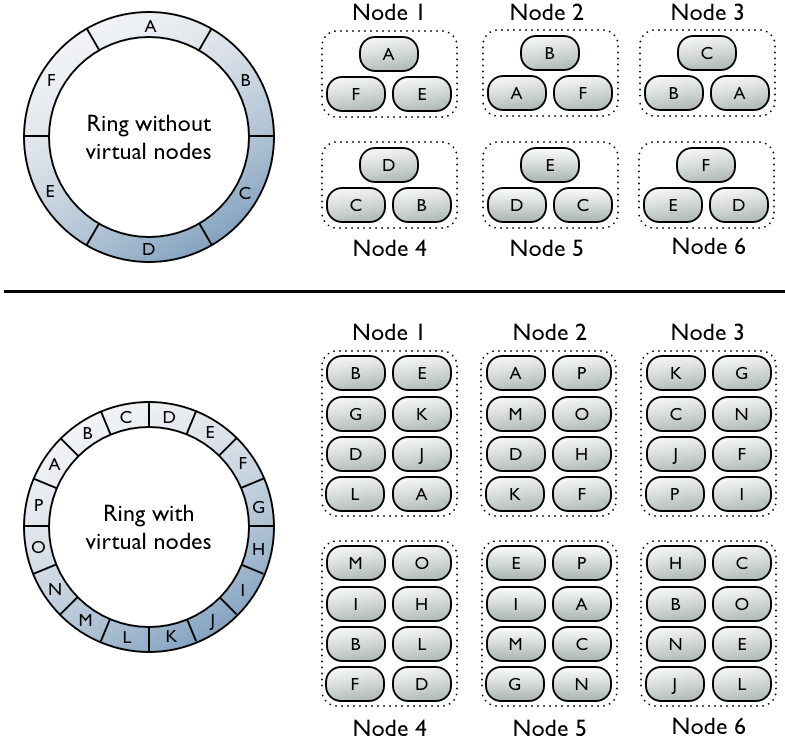
Рисунок 24 Virtual nodes [22]
Данные равномерно распределяются по каждому node при корректно выбранном replication factor. Каждый node хранит свою часть ring на основе hashed value, а также копии данных с других virtual nodes.
Если в cluster добавить новый node, Cassandra автоматически rebalance-ит virtual nodes между всеми nodes. Ручной resharding не требуется. Подробности можно посмотреть в official Cassandra docs [22].
Проблема hotspot
Shard или service, который получает намного больше данных, чем остальные, называется hotspot. Такое происходит, потому что крупные компании могут тратить на рекламу миллионы долларов, а их ads получают значительно больше кликов. Так как events partitioned по ad_id, некоторые aggregation service nodes могут получать существенно больше ad click events, чем другие, что может привести к перегрузке сервера.
Эту проблему можно смягчить, если выделять больше aggregation nodes на обработку популярных ads. Рассмотрим пример на рисунке 25. Предположим, каждый aggregation node способен обработать только 100 events.
-
Так как в aggregation node поступило 300 events (это больше, чем node может обработать), он запрашивает дополнительные resources через resource manager.
-
Resource manager выделяет дополнительные resources, например еще два aggregation nodes, чтобы исходный node не оказался перегружен.
-
Исходный aggregation node делит events на 3 группы, и каждый aggregation node обрабатывает по 100 events.
-
Result записывается обратно в исходный aggregate node.
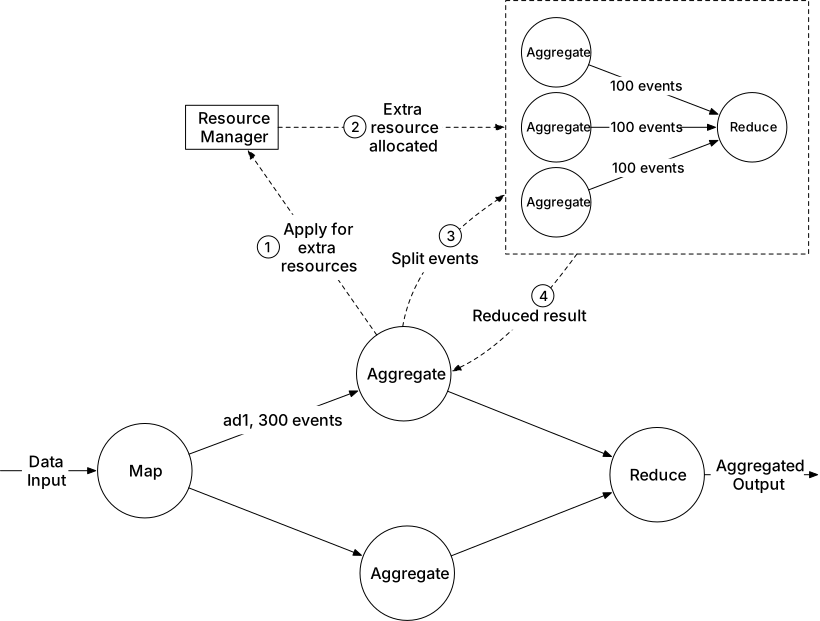
Рисунок 25 Выделение дополнительных aggregation nodes
Есть и более продвинутые способы решить эту проблему, например Global-Local Aggregation или Split Distinct Aggregation. Подробнее см. [23].
Fault tolerance
Поговорим о fault tolerance aggregation service. Поскольку aggregation происходит в memory, при падении aggregation node теряется и aggregated result. Восстановить count можно, replay-нув events из upstream Kafka brokers.
Replay данных с самого начала Kafka медленный. Хорошая практика — сохранять “system status”, например upstream offset, в snapshot и восстанавливаться из последнего сохраненного состояния. В нашем дизайне “system status” — это не только upstream offset, потому что нам нужно хранить и данные вроде top N самых кликаемых ads за последние M минут.
На рисунке 26 показан простой пример того, как могут выглядеть данные в snapshot.
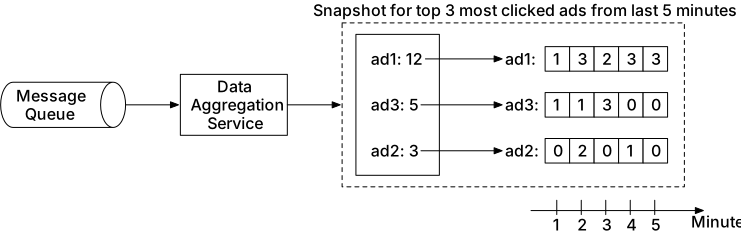
Рисунок 26 Данные в snapshot
При наличии snapshot failover для aggregation service довольно прост. Если один aggregation service node падает, мы поднимаем новый node и восстанавливаем данные из последнего snapshot (рисунок 27). Если после сохранения snapshot пришли новые events, новый aggregation node заберет их из Kafka broker и replay-нет.

Рисунок 27 Failover aggregation node
Data monitoring и correctness
Как уже говорилось, aggregation results могут использоваться для RTB и billing. Поэтому критично и мониторить здоровье системы, и обеспечивать correctness.
Continuous monitoring
Вот несколько metrics, которые стоит мониторить:
-
Latency. Так как latency может появляться на каждом этапе, очень полезно отслеживать timestamps по мере прохождения events через разные части системы. Разницы между этими timestamps можно публиковать как latency metrics.
-
Размер message queue. Если queue size резко вырос, возможно, нужно добавить больше aggregation nodes. Заметьте, Kafka — это message queue, реализованная как distributed commit log, поэтому на практике нужно мониторить metrics типа records-lag.
-
System resources на aggregation nodes: CPU, disk, JVM и т. д.
Reconciliation
Reconciliation означает сравнение разных наборов данных, чтобы убедиться в data integrity. В отличие от reconciliation в banking, где можно сравнить собственные записи с банковскими, у результатов ad click aggregation нет третьей стороны, с которой можно свериться.
Что мы можем сделать: в конце дня сортировать ad click events по event time в каждой partition batch job-ом и сверять это с real-time aggregation result. Если нужна более высокая точность, можно использовать меньший aggregation window, например 1 час. Обратите внимание: независимо от выбранного aggregation window batch result может не совпасть с real-time aggregation result идеально, потому что некоторые events могут прийти поздно (см. раздел Time).
На рисунке 28 показана финальная design diagram с поддержкой reconciliation.
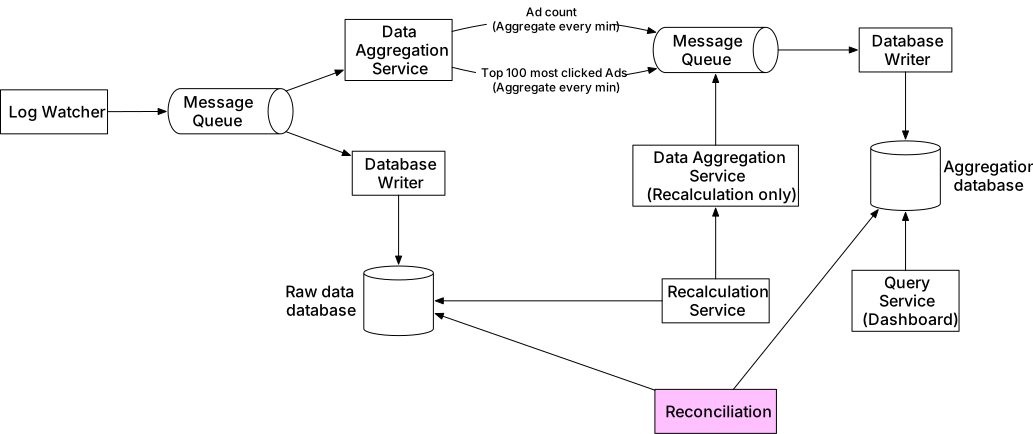
Рисунок 28 Финальный дизайн
Alternative design
В generalist system design interview от вас не ожидают глубокого знания внутренностей разного специализированного software, используемого в big data pipeline. Гораздо важнее уметь объяснять свой thought process и обсуждать trade-offs, поэтому мы и предлагаем generic solution. Еще один вариант — хранить ad click data в Hive, а поверх построить ElasticSearch layer для быстрых queries. Aggregation обычно выполняется в OLAP databases, таких как ClickHouse [24] или Druid [25]. На рисунке 29 показана такая architecture.

Рисунок 29 Alternative design
Если хотите больше деталей, см. reference material [26].
Шаг 4 — Итоги
В этой главе мы прошли весь путь проектирования ad click event aggregation system масштаба Facebook или Google. Мы рассмотрели:
-
Data model и API design.
-
Использование парадигмы MapReduce для агрегации ad click events.
-
Масштабирование message queue, aggregation service и database.
-
Смягчение hotspot issue.
-
Непрерывный monitoring системы.
-
Использование reconciliation для обеспечения correctness.
-
Fault tolerance.
Ad click event aggregation system — это типичная big data processing system. Понимать и проектировать ее будет проще, если у вас уже есть знания или опыт работы с industry-standard solutions, такими как Apache Kafka, Apache Flink или Apache Spark.
Поздравляю, вы добрались так далеко. Можно похлопать себе по плечу — хорошая работа.
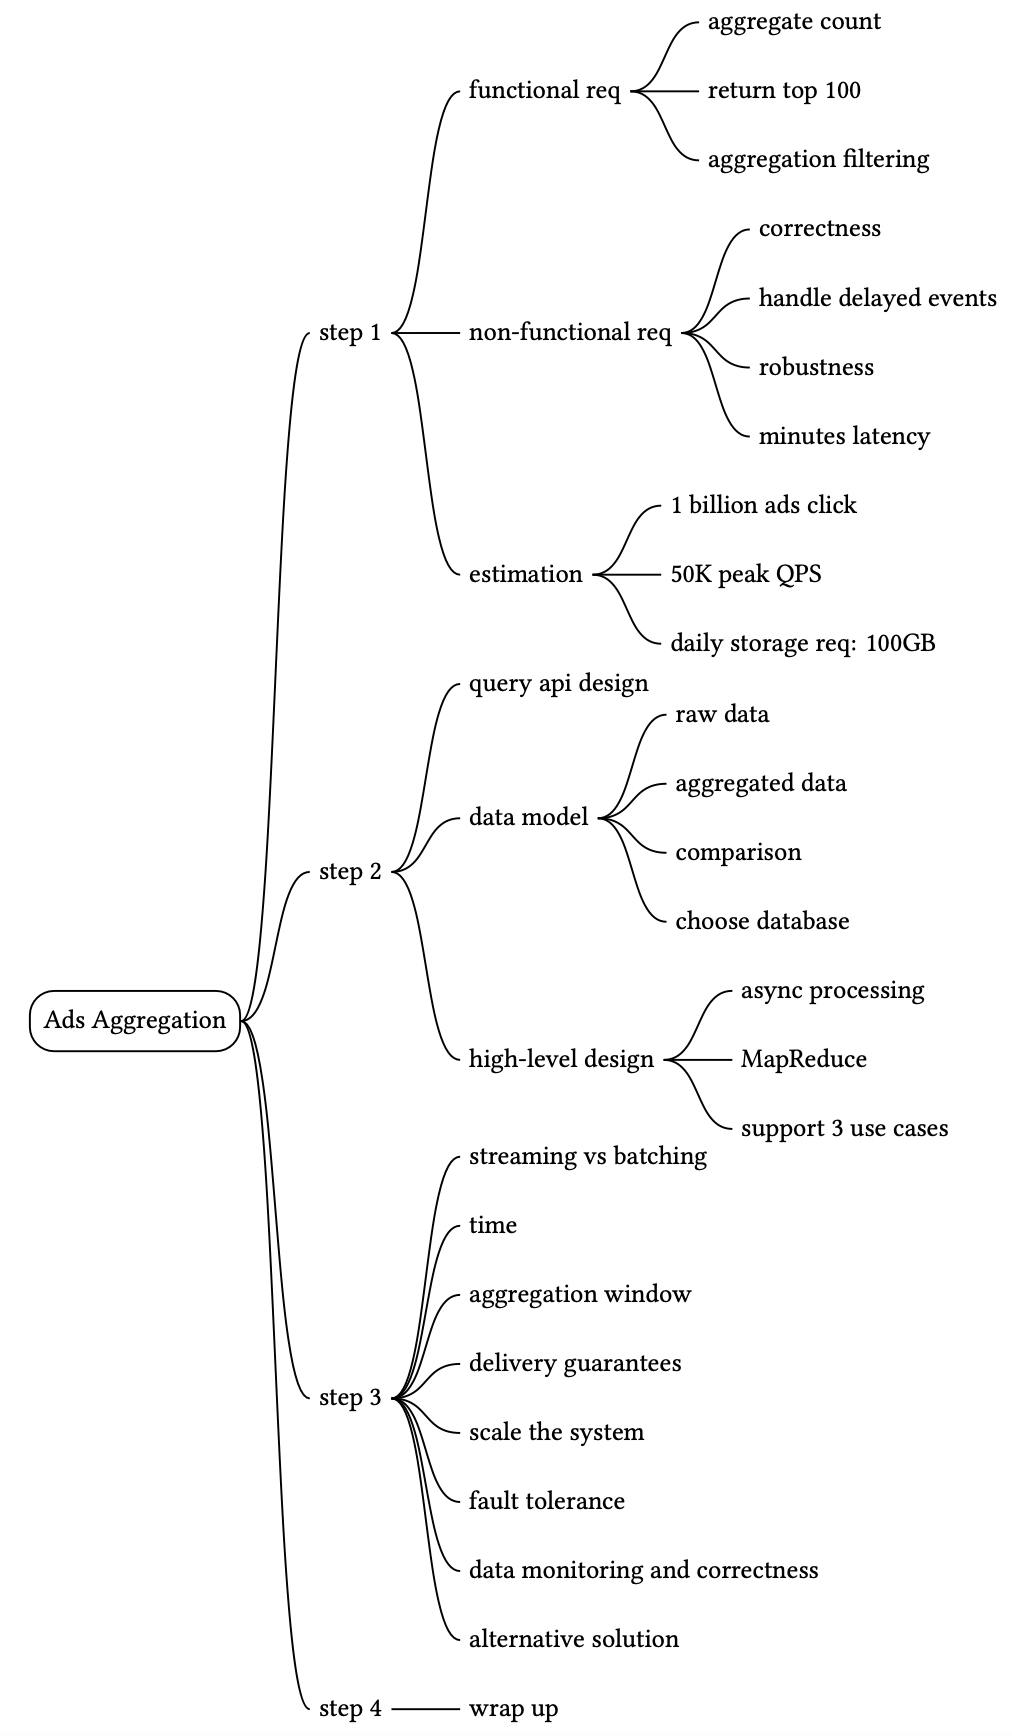
Краткое содержание главы
Reference Materials
[1] Clickthrough rate (CTR):
Definition: https://support.google.com/google-ads/answer/2615875?hl=en
[2] Conversion rate:
Definition: https://support.google.com/google-ads/answer/2684489?hl=en
[3] OLAP functions:
https://docs.oracle.com/database/121/OLAXS/olap_functions.htm#OLAXS169
[4] Display Advertising with Real-Time Bidding (RTB) and Behavioural Targeting:
https://arxiv.org/pdf/1610.03013.pdf
[5] LanguageManual ORC:
https://cwiki.apache.org/confluence/display/hive/languagemanual+orc
[6] Parquet:
https://databricks.com/glossary/what-is-parquet
[7] What is avro:
https://www.ibm.com/topics/avro
[8] Big Data:
https://www.datakwery.com/techniques/big-data/
[9] DAG model:
https://en.wikipedia.org/wiki/Directed_acyclic_graph
[10] Java stream:
https://docs.oracle.com/javase/8/docs/api/java/util/stream/Stream.html
[11] Understand star schema and the importance for Power BI:
https://docs.microsoft.com/en-us/power-bi/guidance/star-schema
[12] Martin Kleppmann, “Designing Data-Intensive Applications”, 2017
[13] Apache Flink: https://flink.apache.org/
[14] Lambda architecture:
https://databricks.com/glossary/lambda-architecture
[15] Kappa architecture:
https://hazelcast.com/glossary/kappa-architecture/
[16] Martin Kleppmann, “Stream Processing, Designing Data-Intensive Applications”, 2017
[17] End-to-end Exactly-once Aggregation Over Ad Streams:
https://www.youtube.com/watch?v=hzxytnPcAUM
[18] Ad traffic quality:
https://www.google.com/ads/adtrafficquality
[19] An Overview of End-to-End Exactly-Once Processing in Apache Flink:
https://flink.apache.org/features/2018/03/01/end-to-end-exactly-once-apache-flink.html
[20] Understanding MapReduce in Hadoop:
https://www.section.io/engineering-education/understanding-map-reduce-in-hadoop/
[21] Flink on Apache Yarn:
https://ci.apache.org/projects/flink/flink-docs-release-1.13/docs/deployment/resource-providers/yarn/
[22] How data is distributed across a cluster (using virtual nodes):
https://docs.datastax.com/en/cassandra-oss/3.0/cassandra/architecture/archDataDistributeDistribute.html
[23] Flink performance tuning:
https://nightlies.apache.org/flink/flink-docs-master/docs/dev/table/tuning/
[24] ClickHouse: https://clickhouse.com/
[25] Druid: https://druid.apache.org/
[26] Real-Time Exactly-Once Ad Event Processing with Apache Flink, Kafka, and Pinot:
https://eng.uber.com/real-time-exactly-once-ad-event-processing/