Распределенная очередь сообщений
В этой главе мы разбираем популярный вопрос с system design interviews: спроектировать distributed message queue. В современной архитектуре системы разбиваются на небольшие независимые building blocks с хорошо определенными интерфейсами между ними. Message queues обеспечивают коммуникацию и координацию между этими блоками. Какие преимущества они дают?
-
Decoupling. Message queues убирают жесткую связность между компонентами, поэтому их можно обновлять независимо.
-
Лучшая scalability. Мы можем масштабировать producers и consumers независимо в зависимости от нагрузки. Например, в peak hours можно добавить больше consumers.
-
Повышенная availability. Если одна часть системы временно offline, остальные компоненты все равно могут продолжать работать через queue.
-
Более высокая производительность. Message queues упрощают asynchronous communication. Producers могут складывать сообщения в queue, не дожидаясь ответа, а consumers — читать их, когда готовы.
На рисунке 1 показаны самые популярные distributed message queues на рынке.
Рисунок 1 Популярные distributed message queues
Message queues vs event streaming platforms
Строго говоря, Apache Kafka и Pulsar — это не message queues, а event streaming platforms. Но граница между message queues (RocketMQ, ActiveMQ, RabbitMQ, ZeroMQ и т. д.) и event streaming platforms (Kafka, Pulsar) постепенно размывается. Например, RabbitMQ, являясь типичной message queue, добавил optional streaming feature, позволяющую повторное потребление сообщений и длинное retention, а внутренняя реализация использует append-only log, как в event streaming platforms. Apache Pulsar в первую очередь конкурирует с Kafka, но также достаточно гибок и производителен, чтобы использоваться как обычная distributed message queue.
В этой главе мы спроектируем distributed message queue с дополнительными возможностями, такими как long data retention, repeated consumption of messages и т. д., которые обычно встречаются именно в event streaming platforms. Эти дополнительные features делают дизайн сложнее. По ходу главы мы будем отмечать места, где дизайн можно было бы упростить, если интервью сфокусировано на более традиционных distributed message queues.
Шаг 1 — Понять задачу и определить рамки дизайна
В самом базовом виде message queue проста: producers отправляют сообщения в queue, consumers их читают. Но помимо этой базовой функции есть и другие аспекты: performance, semantics доставки, retention данных и т. д. Следующие вопросы помогут уточнить требования и сузить scope.
Кандидат: Какой формат и средний размер сообщений? Только текст? Можно ли multimedia?
Интервьюер: Только текст. Обычно размер сообщений измеряется в килобайтах (KBs).
Кандидат: Могут ли сообщения читаться повторно?
Интервьюер: Да, сообщения могут читаться повторно разными consumers. Заметьте, это
дополнительная feature. Традиционная distributed message queue не хранит сообщение после
успешной доставки consumer-у, поэтому повторное чтение невозможно.
Кандидат: Должны ли сообщения читаться в том же порядке, в каком были произведены?
Интервьюер: Да, сообщения должны читаться в том же порядке, в каком были произведены. Это
тоже дополнительная feature. Традиционная distributed message queue обычно не гарантирует строгий
order доставки.
Кандидат: Нужно ли персистентно хранить данные и каков retention?
Интервьюер: Да, предположим retention — две недели. Это тоже дополнительная feature.
Традиционная distributed message queue обычно не хранит сообщения долго.
Кандидат: Сколько producers и consumers нам нужно поддержать?
Интервьюер: Чем больше, тем лучше.
Кандидат: Какие delivery semantics нужно поддерживать? Например, at-most-once, at-least-once
и exactly-once.
Интервьюер: Минимум at-least-once. В идеале хорошо бы поддержать все и дать пользователю
возможность выбирать.
Кандидат: Какой целевой throughput и end-to-end latency?
Интервьюер: Должен быть высокий throughput для use cases вроде log aggregation. И при этом
должна поддерживаться low-latency delivery для более традиционных message queue сценариев.
Из этого разговора примем следующие функциональные требования:
-
Producers отправляют сообщения в message queue.
-
Consumers читают сообщения из message queue.
-
Сообщения могут читаться один раз или повторно.
-
Historical data можно truncate-ить.
-
Размер сообщений — килобайты.
-
Система умеет доставлять сообщения consumer-ам в порядке добавления.
-
Delivery semantics (at-least-once, at-most-once, exactly-once) конфигурируемы.
Нефункциональные требования
-
Высокий throughput или низкая latency — в зависимости от use case.
-
Scalability. Система должна быть distributed по своей природе и выдерживать внезапный рост message volume.
-
Persistence и durability. Данные должны сохраняться на диск и реплицироваться между несколькими nodes.
Поправки для traditional message queues
Traditional message queues вроде RabbitMQ не предъявляют таких же жестких требований к retention, как event streaming platforms. Они держат сообщения в памяти ровно столько, сколько нужно, чтобы их забрал consumer. Для overflow на диск у них есть ограниченная on-disk capacity [1], на порядки меньшая, чем требуется event streaming platform. Traditional message queues обычно не обещают строгий order доставки. Все это заметно упрощает дизайн, и мы по ходу главы будем указывать такие места.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
Сначала обсудим базовые building blocks message queue.
На рисунке 2 показаны ключевые компоненты message queue и упрощенные взаимодействия между ними.

Рисунок 2 Ключевые компоненты message queue
-
Producer отправляет сообщения в message queue.
-
Consumer подписывается на queue и читает сообщения.
-
Message queue — это сервис посередине, который decouple-ит producers и consumers, позволяя им независимо работать и масштабироваться.
-
И producer, и consumer — это clients в client/server-модели, а message queue — server. Коммуникация идет по сети.
Messaging models
Самые популярные messaging models — point-to-point и publish-subscribe.
Point-to-point
Эта модель типична для traditional message queues. В point-to-point модели сообщение отправляется в queue и потребляется ровно одним consumer-ом. Consumers может быть несколько, но каждое сообщение получает только один из них. На рисунке 3 message A получает только consumer 1.

Рисунок 3 Point-to-point model
Как только consumer подтверждает, что сообщение прочитано, оно удаляется из queue. Здесь нет data retention. В нашем дизайне, напротив, есть persistence layer, которая хранит сообщения две недели и позволяет повторное чтение.
Хотя наш дизайн может имитировать point-to-point model, по своей природе он ближе к publish-subscribe.
Publish-subscribe
Сначала введем новый concept: topic. Topics — это категории, по которым организуются сообщения.
У каждого topic есть имя, уникальное в рамках всего message queue service. Сообщения пишутся и
читаются из конкретного topic.
В publish-subscribe модели сообщение отправляется в topic и получают его все consumers, подписанные на topic. На рисунке 4 message A получает и consumer 1, и consumer 2.

Рисунок 4 Publish-subscribe model
Наша distributed message queue поддерживает обе модели. Publish-subscribe реализуется через topics, а point-to-point можно смоделировать через consumer group, которую мы введем чуть позже.
Topics, partitions и brokers
Как мы уже сказали, сообщения хранятся в topics. Что делать, если данных внутри topic слишком много для одного сервера?
Решение — partition (sharding). Как показано на рисунке 5, мы делим topic на partitions и равномерно распределяем сообщения между ними. Partition — это маленькое подмножество сообщений topic-а. Partitions равномерно распределяются по серверам message queue cluster. Эти серверы называются brokers. Именно распределение partitions между brokers дает системе scalability. При необходимости capacity topic-а масштабируется за счет увеличения числа partitions.

Рисунок 5 Partitions
Каждая topic partition работает как очередь FIFO (first in, first out). Это позволяет сохранять order сообщений внутри partition. Позиция сообщения внутри partition называется offset.
Когда producer отправляет сообщение, на самом деле оно отправляется в одну из partitions topic-а. У сообщения есть optional message key (например, user ID), и все сообщения с одинаковым key отправляются в одну и ту же partition. Если key отсутствует, сообщение случайным образом отправляется в одну из partitions.
Когда consumer подписывается на topic, он читает данные из одной или нескольких partitions. Если на один topic подписано много consumers, каждый consumer отвечает только за subset partitions. Такой набор consumers называется consumer group.
Message queue cluster с brokers и partitions показан на рисунке 6.
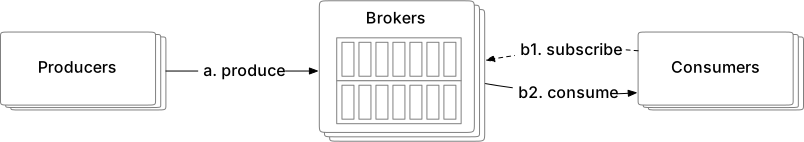
Рисунок 6 Message queue cluster
Consumer group
Как уже говорилось, нам нужно поддерживать и point-to-point, и publish-subscribe. Consumer group — это набор consumers, которые работают вместе и читают сообщения из topics.
Consumers можно организовывать по группам. Каждая consumer group может подписываться на несколько topics и вести собственные consuming offsets. Например, одна group может отвечать за billing, другая — за accounting.
Instances внутри одной group могут читать трафик параллельно, как на рисунке 7.
-
Consumer group 1 подписана на topic A.
-
Consumer group 2 подписана на topics A и B.
-
Topic A подписан обеими consumer groups, поэтому одно и то же сообщение читается несколькими consumers. Это и есть publish-subscribe pattern.
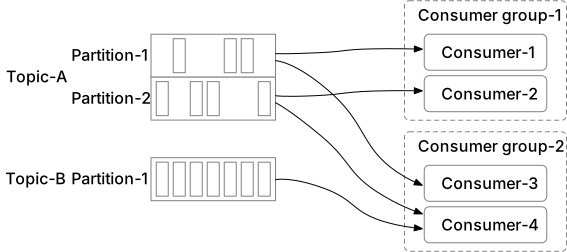
Рисунок 7 Consumer groups
Но здесь есть проблема. Параллельное чтение повышает throughput, однако order consumption для сообщений внутри одной partition уже нельзя гарантировать. Например, если consumer 1 и consumer 2 оба читают из partition 1, порядок чтения внутри partition 1 теряется.
Хорошая новость в том, что это легко исправить: одна partition может читаться только одним consumer-ом внутри одной group. Если consumers в group больше, чем partitions у topic-а, часть consumers останется без данных по этому topic. Например, на рисунке 7 consumer 3 в group 2 не может читать topic B, потому что его уже читает consumer 4 из той же group.
С этим ограничением, если все consumers находятся в одной consumer group, то сообщения каждой partition читаются только одним consumer-ом, что эквивалентно point-to-point model. Поскольку partition — это минимальная единица хранения, можно заранее создать достаточно partitions, чтобы не приходилось часто увеличивать их число динамически. Для high scale потом достаточно просто добавлять consumers.
High-level architecture
На рисунке 8 показан обновленный high-level design.
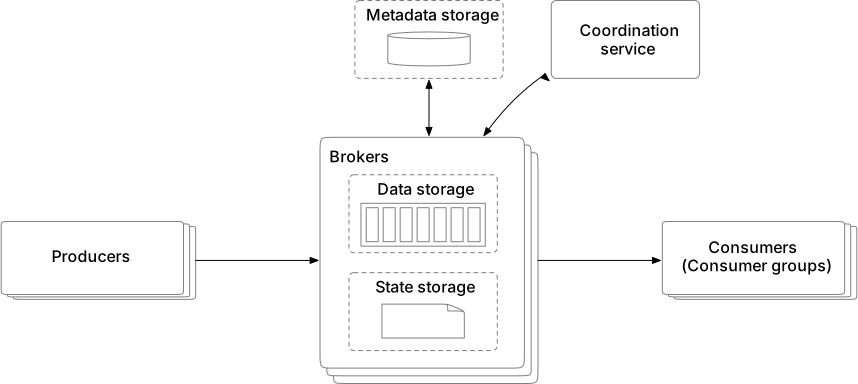
Рисунок 8 High-level design
Clients:
-
Producer: отправляет сообщения в определенные topics.
-
Consumer group: подписывается на topics и читает сообщения.
Core service и storage:
-
Broker: хранит несколько partitions. Каждая partition содержит часть сообщений topic-а.
-
Storage:
-
Data storage: сообщения persist-ятся в partitions.
-
State storage: состояния consumers хранятся отдельно.
-
Metadata storage: конфигурация и свойства topics хранятся отдельно.
-
-
Coordination service:
-
Service discovery: какие brokers живы.
-
Leader election: один broker выбирается активным controller-ом. В cluster-е всегда только один active controller. Именно он отвечает за assignment partitions.
-
Для election часто используют Apache ZooKeeper [2] или etcd [3].
-
Шаг 3 — Deep Dive дизайна
Чтобы получить высокий throughput и одновременно удовлетворить требование по долгому retention, мы сделали три важных design choices:
-
Выбрали on-disk data structure, использующую преимущества последовательного доступа к дискам и агрессивного disk caching в современных ОС.
-
Спроектировали message data structure так, чтобы сообщение могло пройти путь от producer к queue и затем к consumer без модификаций. Это минимизирует costly data copying.
-
Спроектировали систему так, чтобы она любила batching. Мелкие I/O — враг throughput, поэтому producers отправляют сообщения batch-ами, queue записывает их еще большими batch-ами, а consumers по возможности тоже читают batch-ами.
Data storage
Теперь подробнее разберем варианты persistence сообщений. Чтобы выбрать лучший, посмотрим на traffic pattern message queue:
-
Write-heavy и read-heavy.
-
Нет update и delete операций. Заметим, что traditional message queue не хранит сообщения постоянно, если только queue не отстает. Тогда удаление сообщений возможно, когда queue догоняет. Но здесь мы обсуждаем persistence data streaming platform.
-
Доступ почти всегда sequential read/write.
Вариант 1: Database
Первый вариант — использовать database.
-
Relational database: создать topic table и писать сообщения как rows.
-
NoSQL database: создать collection на topic и писать сообщения как documents.
Databases могут справиться с хранением, но они неидеальны: сложно получить database, одинаково хорошо поддерживающую и write-heavy, и read-heavy access patterns при большом масштабе. Такое решение плохо соответствует нашему конкретному usage pattern.
Значит, database — не лучший choice и может стать bottleneck.
Вариант 2: Write-ahead log (WAL)
Второй вариант — write-ahead log (WAL). WAL — это обычный файл, в который новые entries добавляются в append-only log. WAL используется во многих системах, например redo log в MySQL и WAL в ZooKeeper.
Мы рекомендуем хранить сообщения как WAL log files на диске. У WAL чистый sequential read/write pattern. Диск отлично работает на последовательном доступе [4]. Кроме того, rotational disks имеют большую емкость и довольно дешевы.
Как показано на рисунке 9, каждое новое сообщение append-ится в tail partition с монотонно растущим offset. Самый простой вариант — использовать номер строки в log file как offset. Но файл не может расти бесконечно, поэтому разумно делить его на segments.
При сегментации новые сообщения append-ятся только в active segment file. Когда active segment достигает определенного размера, создается новый active segment, а старый становится inactive, как и остальные неактивные segments. Inactive segments обслуживают только read requests. Старые inactive segment files можно truncate-ить, если они выходят за retention или capacity limit.
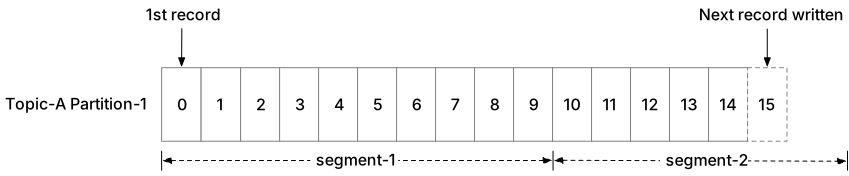
Рисунок 9 Append new messages
Segment files одной partition организуются в папке Partition-{:partition_id}. Структура показана
на рисунке 10.
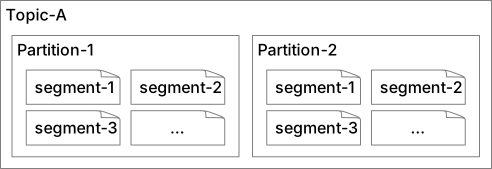
Рисунок 10 Распределение segment files по topic partitions
Замечание о disk performance
Чтобы удовлетворить требование долгого retention, наш дизайн сильно опирается на диски. Есть распространенное заблуждение, что rotational disks медленные, но это относится в основном к random access. Для нашей нагрузки, если on-disk data structure спроектирована под sequential access, современные диски в RAID-конфигурации могут спокойно выдавать сотни MB/sec чтения и записи. Для наших задач этого более чем достаточно, а cost structure получается выгодным.
Кроме того, современные ОС очень агрессивно кэшируют disk data в main memory, вплоть до того, что охотно занимают под cache всю свободную память. WAL выигрывает и от этого тяжелого OS disk caching.
Message data structure
Структура message критична для throughput. Она определяет contract между producers, queue и consumers. Наш дизайн достигает высокой производительности за счет исключения лишнего data copying во время передачи сообщения от producer к queue и далее к consumer. Если части системы не согласны по этому contract, сообщение придется мутировать, а это дорого и может серьезно ударить по performance.
Ниже пример schema для message:
| Field Name | Data Type |
|---|---|
| key | byte[] |
| value | byte[] |
| topic | string |
| partition | integer |
| offset | long |
| timestamp | long |
| size | integer |
| crc [5] | integer |
Таблица 1. Data schema message
Message key
Key сообщения используется для определения partition. Если key не задан, partition выбирается
случайно. Иначе partition считается как hash(key) % numPartitions. Если нужна дополнительная
гибкость, producer может сам определять mapping algorithm. Заметьте: key не равен partition
number.
Key может быть строкой или числом. Обычно он несет business information. А partition number — это внутренний concept message queue, который не стоит явно выставлять наружу клиентам.
При хорошем mapping algorithm, даже если число partitions меняется, сообщения все равно можно равномерно отправлять по partitions.
Message value
Value сообщения — это payload. Это может быть plain text или compressed binary block.
| Напоминание |
|---|
| Key и value сообщения — не то же самое, что key-value в KV-store. В KV-store keys уникальны, и по key можно найти value. В message keys не обязаны быть уникальны, иногда их вообще нет, и искать value по key нам не нужно. |
Другие поля сообщения
-
Topic: имя topic-а, которому принадлежит сообщение.
-
Partition: ID partition, которой принадлежит сообщение.
-
Offset: позиция сообщения внутри partition. Найти сообщение можно по комбинации трех полей:
topic,partition,offset. -
Timestamp: время, когда сообщение сохранено.
-
Size: размер сообщения.
-
CRC: cyclic redundancy check для проверки целостности raw data.
Чтобы поддержать дополнительные features, можно по необходимости добавлять optional fields. Например, для message filtering можно добавить tags.
Batching
Batching пронизывает весь дизайн. Мы batch-им сообщения в producer, в consumer и внутри самой message queue. Это критично для performance. В этом разделе главным образом сосредоточимся на batching внутри queue. Про batching в producer и consumer поговорим чуть позже.
Почему batching так важен:
-
ОС может объединять сообщения в один network request и амортизировать дорогие network round trips.
-
Broker записывает сообщения в append logs большими кусками. Это дает более длинные последовательные записи на диск и более крупные contiguous blocks в disk cache ОС. Оба эффекта сильно повышают sequential disk throughput.
Здесь есть trade-off между throughput и latency. Если система настроена как traditional message queue, где latency важнее, можно уменьшить batch size. Disk performance немного ухудшится. Если система нацелена на throughput, возможно, понадобится больше partitions на topic, чтобы компенсировать более медленный sequential disk write throughput.
Теперь, когда мы разобрали disk storage subsystem, перейдем к producer и consumer flows, а затем вернемся и завершим deep dive остальных частей queue.
Producer flow
Если producer хочет отправить сообщения в partition, к какому broker он должен подключиться?
Первый вариант — ввести routing layer. Все сообщения сначала отправляются туда, а уже он
перенаправляет их в правильный broker. Если brokers реплицируются, правильный broker — это
leader replica. Репликацию мы разберем позже.
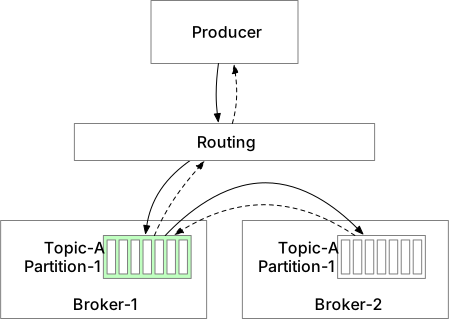
Рисунок 11 Routing layer
Как показано на рисунке 11, producer пытается отправить сообщения в partition 1 topic A.
-
Producer отправляет сообщения в routing layer.
-
Routing layer читает replica distribution plan из metadata storage и кэширует его локально. Когда приходит сообщение, он маршрутизирует его в leader replica partition 1, которая лежит в broker 1.
Распределение replicas для каждой partition называется
replica distribution plan
-
Leader replica принимает сообщение, а follower replicas тянут данные с leader.
-
Когда
достаточноечисло replicas синхронизировало сообщение, leader commit-ит данные (то есть они persist-ятся на диск) и отвечает producer-у.
Зачем нужны leader и follower replicas? Ради fault tolerance. Подробно разберем это в разделе про in-sync replicas.
Подход рабочий, но у него есть несколько недостатков:
-
Дополнительный routing layer означает лишнюю network latency и лишний hop.
-
Одним из главных факторов эффективности является request batching, а эта схема его не учитывает.
На рисунке 12 показан улучшенный дизайн.
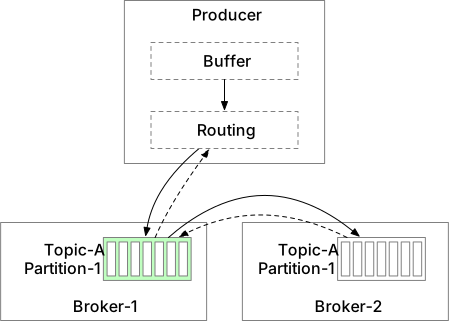
Рисунок 12 Producer с buffer и routing
Routing layer встраивается внутрь producer, а к producer добавляется buffer component. Обе части можно поставить прямо в producer client library. Это дает несколько преимуществ:
-
Меньше network hops — ниже latency.
-
Producers могут сами решать, в какую partition отправлять сообщения.
-
Batching буферизует сообщения в памяти и отправляет более крупные batches одним request-ом, повышая throughput.
Выбор batch size — классический trade-off между throughput и latency (рисунок 13). Большой batch size увеличивает throughput, но повышает latency, потому что нужно дольше ждать накопления batch. Маленький batch size снижает latency, но throughput страдает. Producers могут настраивать размер batch-а под свой use case.

Рисунок 13 Выбор batch size
Consumer flow
Consumer указывает свой offset в partition и получает chunk events, начиная с этой позиции. Пример показан на рисунке 14.
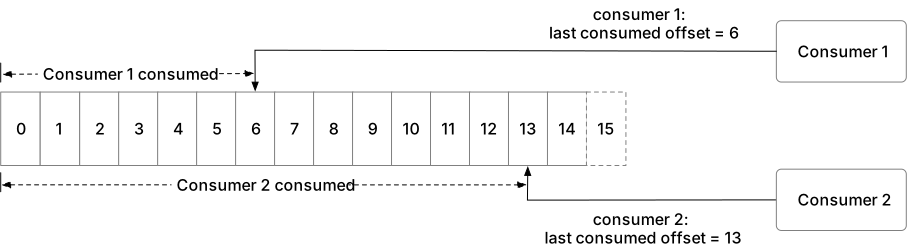
Рисунок 14 Consumer flow
Push vs pull
Важный вопрос: должен ли broker push-ить данные consumer-ам, или consumers сами должны pull-ить их у brokers?
Push model
Плюсы:
- Низкая latency. Broker может отправить сообщение consumer-у сразу после его получения.
Минусы:
-
Если скорость consumption ниже, чем production, consumers могут быть перегружены.
-
Трудно работать с consumers разной мощности, потому что именно broker управляет скоростью передачи данных.
Pull model
Плюсы:
-
Consumers сами управляют скоростью consumption. Один набор consumers может работать в real-time, другой — в batch mode.
-
Если consumption отстает от production, можно scale out consumers или просто позже догнать поток.
-
Pull model лучше подходит для batch processing. В push model broker не знает, сможет ли consumer обработать сообщения сразу. Если broker отправляет по одному сообщению, а consumer уже отстает, сообщения просто зависнут в buffer-е. В pull model consumer забирает все доступные сообщения после своей текущей позиции в log (или до настраиваемого max size), что отлично подходит для агрессивного batching.
Минусы:
- Когда в broker нет сообщений, consumer все равно может продолжать pull-ить данные и зря тратить ресурсы. Чтобы обойти это, многие message queues поддерживают long polling, позволяющий pull ждать какое-то время появления новых сообщений [6].
Учитывая эти аргументы, большинство message queues выбирают pull model.
На рисунке 15 показан workflow consumer pull model.

Рисунок 15 Pull model
-
Новый consumer хочет присоединиться к group 1 и подписаться на topic A. Он находит соответствующий broker node хешированием group name. Благодаря этому все consumers одной group подключаются к одному и тому же broker, который называется coordinator consumer group. Заметим, что consumer group coordinator — не то же самое, что coordination service из рисунка 8.
-
Coordinator подтверждает, что consumer вошел в group, и назначает ему partition 2. Есть разные strategies назначения partitions: round-robin, range и т. д. [7]
-
Consumer fetch-ит сообщения с last consumed offset, который хранится в state storage.
-
Consumer обрабатывает сообщения и commit-ит offset broker-у. Порядок обработки данных и commit offset влияет на delivery semantics, к которым мы вернемся позже.
Consumer rebalancing
Consumer rebalancing определяет, какой consumer отвечает за какой subset partitions. Rebalance может происходить, когда consumer присоединяется, уходит, падает или меняется число partitions.
При rebalance coordinator играет ключевую роль. Coordinator — это один из brokers, отвечающий за коммуникацию с consumers и orchestration rebalance. Он получает heartbeat от consumers и управляет их offsets.
Посмотрим на пример, чтобы понять, как coordinator и consumers работают вместе.

Рисунок 16 Coordinator consumer groups
-
Как видно на рисунке 16, каждый consumer принадлежит группе. Он находит своего coordinator-а через hash(group name). Все consumers из одной group подключаются к одному coordinator-у.
-
Coordinator поддерживает joined consumer list. Когда список меняется, coordinator выбирает нового leader-а группы.
-
Новый leader group формирует partition dispatch plan и отправляет его coordinator-у. Coordinator рассылает план остальным consumers группы.
В distributed system consumers могут сталкиваться с network problems, crashes, restarts и т. д. С точки зрения coordinator-а это выглядит как пропавшие heartbeats. Когда такое случается, coordinator запускает rebalance и перераспределяет partitions, как показано на рисунке 17.
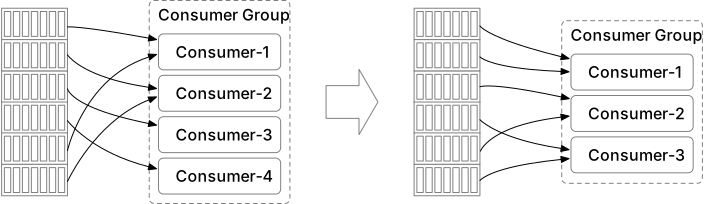
Рисунок 17 Consumer rebalance
Разберем несколько сценариев. Предположим, в group 2 consumers и 4 partitions в subscribed topic. На рисунке 18 показан сценарий, когда в group приходит новый consumer B.
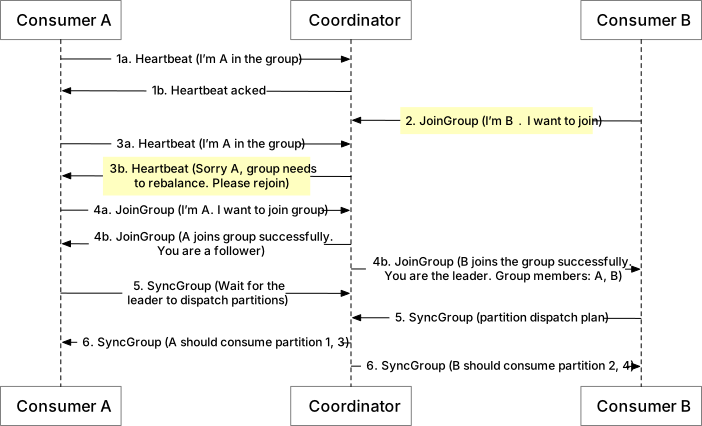
Рисунок 18 Новый consumer joins
-
Изначально в group только consumer A. Он читает все partitions и регулярно шлет heartbeat coordinator-у.
-
Consumer B отправляет request на join group.
-
Coordinator понимает, что пора делать rebalance, и пассивно уведомляет consumers группы. Когда heartbeat A доходит до coordinator-а, тот просит A заново join-иться в group.
-
Когда все consumers снова вошли в group, coordinator выбирает одного leader-ом и сообщает всем результат election.
-
Leader consumer формирует partition dispatch plan и отправляет его coordinator-у. Follower consumers запрашивают этот план у coordinator-а.
-
Consumers начинают читать сообщения из newly assigned partitions.
На рисунке 19 показан сценарий, когда существующий consumer A покидает group.
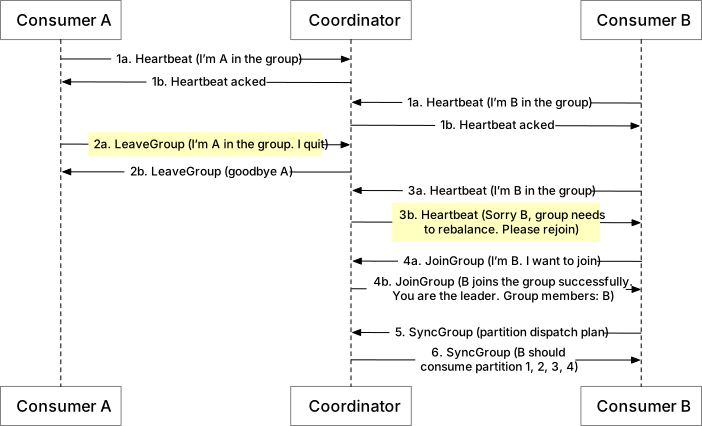
Рисунок 19 Existing consumer leaves
-
Consumers A и B находятся в одной consumer group.
-
Consumer A собирается остановиться и запрашивает leave group.
-
Coordinator понимает, что пора rebalance-иться. Когда heartbeat B доходит до него, он просит B заново join-иться.
-
Остальные шаги такие же, как в сценарии рисунка 18.
На рисунке 20 показан сценарий, когда существующий consumer A падает.
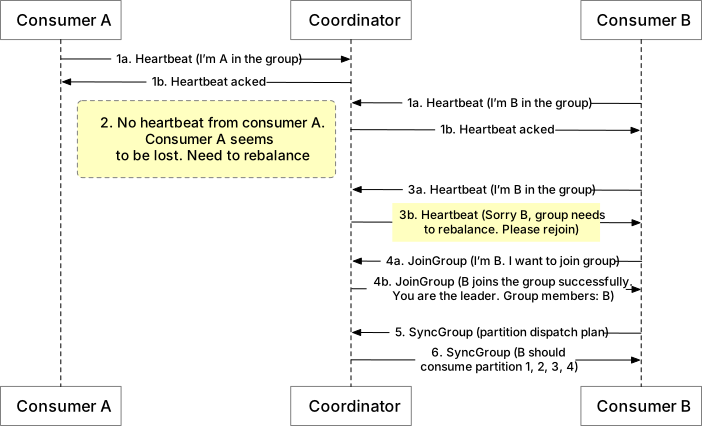
Рисунок 20 Existing consumer crashes
-
Consumers A и B поддерживают heartbeats с coordinator-ом.
-
Consumer A падает, heartbeat больше не приходит. Если coordinator не получает heartbeat в течение заданного времени, consumer считается dead.
-
Coordinator запускает rebalance.
-
Дальше шаги совпадают с предыдущим сценарием.
Теперь, когда producer и consumer flows разобраны, вернемся к остальной части broker.
State storage
State storage внутри message queue broker хранит:
-
Mapping между partitions и consumers.
-
Last consumed offsets consumer groups для каждой partition. Например, на рисунке 21 last consumed offset для consumer group 1 равен 6, а для consumer group 2 — 13.
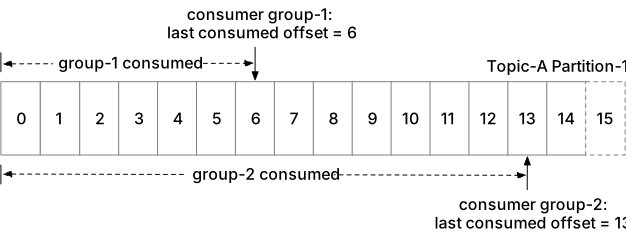
Рисунок 21 Last consumed offset consumer groups
Например, как на рисунке 21, consumer из group 1 читает сообщения по порядку и commit-ит offset 6. Это означает, что все сообщения до offset 6 включительно уже прочитаны. Если consumer падает, новый consumer той же group сможет продолжить consumption, прочитав last consumed offset из state storage.
Паттерны доступа к consumer state:
-
Частые read и write операции, но объем данных невелик.
-
Данные часто обновляются и редко удаляются.
-
Random read/write access.
-
Consistency важна.
Для хранения consumer state можно использовать разные storage solutions. С учетом требований к consistency и fast read/write, отличный choice — KV store вроде ZooKeeper. Kafka позже перенес offset storage из ZooKeeper в самих Kafka brokers. Подробнее можно почитать в [8].
Metadata storage
Metadata storage хранит конфигурацию и свойства topics: число partitions, retention period, distribution replicas и т. д.
Metadata меняются редко и объем у них мал, но consistency требуется высокая. ZooKeeper хорошо подходит и для этой задачи.
ZooKeeper
По предыдущим разделам уже видно, что ZooKeeper очень помогает при проектировании distributed message queue. Если вы с ним не сталкивались: ZooKeeper — важный сервис для distributed systems, предоставляющий hierarchical key-value store. Его часто используют как distributed configuration service, synchronization service и naming registry [2].
ZooKeeper упрощает наш дизайн, как показано на рисунке 22.
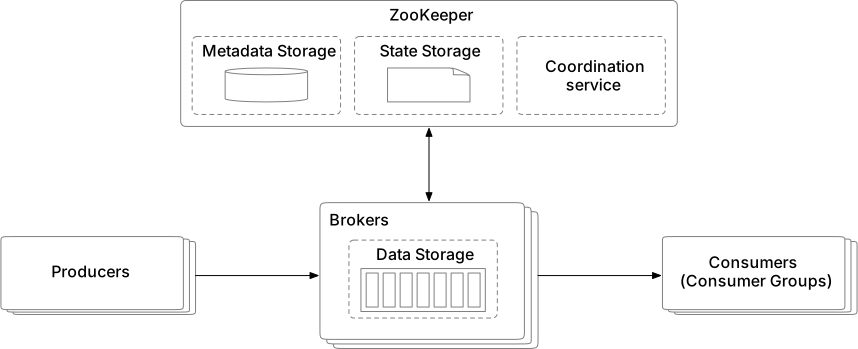
Рисунок 22 ZooKeeper
Коротко о том, что меняется:
-
Metadata и state storage переносятся в ZooKeeper.
-
Broker теперь должен поддерживать только data storage для сообщений.
-
ZooKeeper помогает с leader election broker cluster.
Replication
В distributed systems hardware failures неизбежны и их нельзя игнорировать. Данные теряются, если диск поврежден или окончательно вышел из строя. Классическое решение для высокой availability — replication.
Как показано на рисунке 23, у каждой partition по 3 replicas, распределенных по разным broker nodes.
Для каждой partition выделенная replica — это leader, остальные — followers. Producers отправляют
сообщения только в leader replica. Followers постоянно pull-ят новые сообщения у leader-а. Когда
сообщение синхронизировано в достаточное число replicas, leader отправляет acknowledgment
producer-у. Что значит достаточное, подробно разберем в разделе про in-sync replicas.
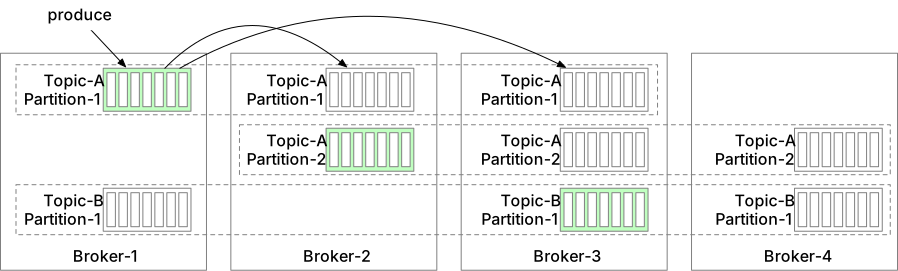
Рисунок 23 Replication
Распределение replicas для каждой partition называется replica distribution plan. Например, на
рисунке 23 план можно описать так:
-
Partition 1 topic A: 3 replicas, leader в broker 1, followers в broker 2 и 3.
-
Partition 2 topic A: 3 replicas, leader в broker 2, followers в broker 3 и 4.
-
Partition 1 topic B: 3 replicas, leader в broker 3, followers в broker 4 и 1.
Кто создает replica distribution plan? С помощью coordination service один из broker nodes избирается leader-ом. Он генерирует plan и persist-ит его в metadata storage. Затем все brokers работают по этому plan.
Если хотите глубже разобраться в replication, полезно посмотреть Chapter 5. Replication из
Designing Data-Intensive Applications [9].
In-sync replicas
Мы уже обсудили, что сообщения пишутся в leader, а follower replicas синхронизируются с ним. Но
нужно понять, как определить, кто из replicas считается синхронизированным.
In-sync replicas (ISR) — это replicas, которые считаются достаточно близкими к leader-у. Точное
определение in-sync зависит от topic configuration. Например, если replica.lag.max.messages = 4,
то follower не будет исключен из ISR, пока отстает от leader не более чем на 3 сообщения [10].
Сам leader всегда считается ISR.
На рисунке 24 показано, как работает ISR:
-
Committed offset в leader replica равен 13. Два новых сообщения уже записаны в leader, но еще не committed. Committed offset означает, что все сообщения до этого offset включительно уже синхронизированы на все replicas из ISR.
-
Replica-2 и replica-3 полностью догнали leader, поэтому входят в ISR и могут получать новые сообщения.
-
Replica-4 не успела догнать leader в пределах допустимого lag time, поэтому не входит в ISR. Когда догонит — снова может быть добавлена.
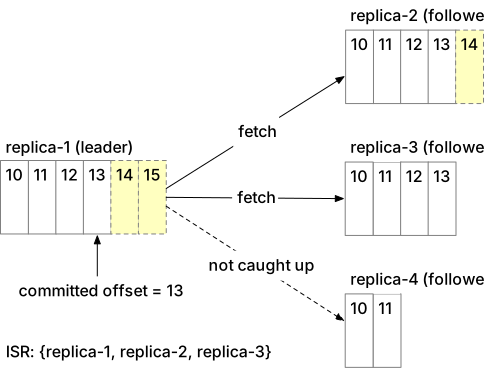
Рисунок 24 Как работает ISR
Зачем нужен ISR? Потому что он отражает trade-off между performance и durability. Если producer совсем не хочет потерять сообщения, safest вариант — ждать, пока все replicas будут synchronized, прежде чем отправлять ack. Но одна медленная replica тогда замедлит или даже сделает partition недоступной.
Теперь посмотрим на acknowledgment settings. Producers могут выбирать, ждать ли ack, пока
сообщение не получат K ISR-реплик, где K настраивается.
ACK=all
На рисунке 25 показан случай ACK=all. Producer получает ACK только тогда, когда сообщение
получили все ISR. Сообщение отправляется медленнее, потому что нужно ждать самую медленную ISR,
зато durability максимальная.
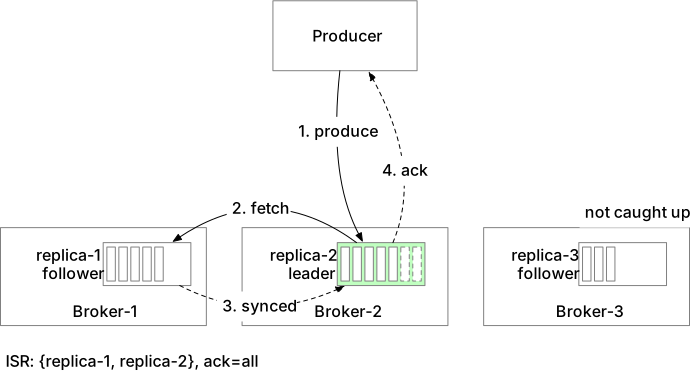
Рисунок 25 ack=all
ACK=1
При ACK=1 producer получает ACK, как только leader persist-ит сообщение. Latency улучшается,
потому что мы не ждем replication. Но если leader упадет сразу после ACK и до того, как follower
успеют реплицировать сообщение, сообщение потеряется. Эта настройка подходит для low-latency
систем, где редкая потеря данных допустима.
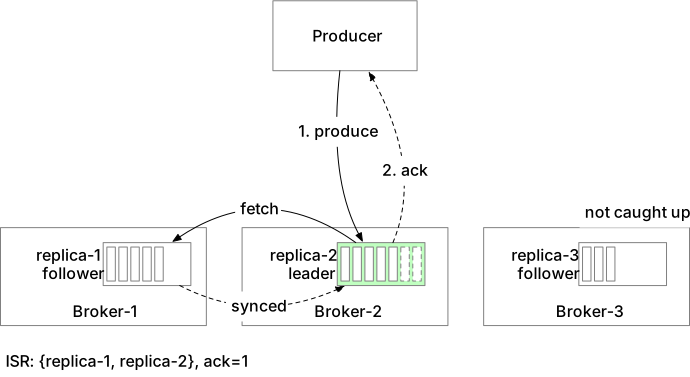
Рисунок 26 ack=1
ACK=0
Producer непрерывно шлет сообщения leader-у, не ожидая подтверждения и никогда не retry-ит. Это дает минимальную latency ценой возможной потери сообщений. Подходит, например, для metrics или logging, где данных много, а редкая потеря приемлема.
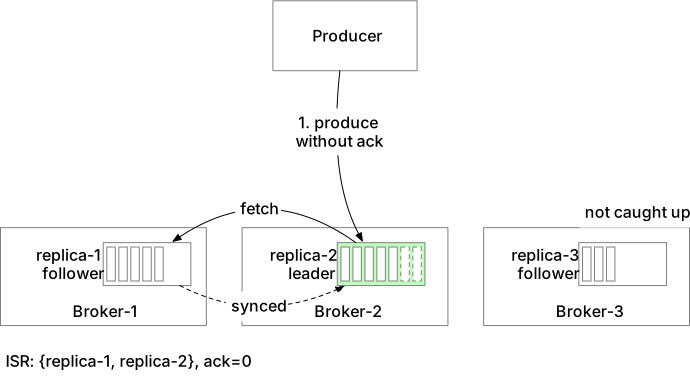
Рисунок 27 ack=0
Configurable ACK позволяет торговать durability ради performance.
Теперь посмотрим на consumer side. Самый простой вариант — давать consumers читать сообщения у leader replica.
Может возникнуть вопрос: не будет ли leader перегружен и почему consumers не читают из ISR? Причины такие:
-
Простота дизайна и эксплуатации.
-
Сообщения одной partition внутри consumer group назначаются только одному consumer-у, а значит, число connections к leader replica ограничено.
-
Обычно число connections к leader replicas невелико, если topic не супер hot.
-
Если topic горячий, можно масштабироваться увеличением partitions и consumers.
В некоторых сценариях чтение только с leader неидеально. Например, если consumer находится в другом data center, latency может пострадать. Тогда может быть полезно разрешить чтение из наиболее близких ISR [11].
ISR очень важен. Как определяется, находится ли replica в ISR? Обычно leader каждой partition сам вычисляет lag каждой replica относительно себя и на основе этого ведет ISR list. За деталями алгоритма можно пойти в reference materials [12] [13].
Scalability
К этому моменту у нас уже есть хороший дизайн distributed message queue. Теперь оценим scalability разных компонентов:
-
Producers
-
Consumers
-
Brokers
-
Partitions
Producer
Producer концептуально гораздо проще consumer-а, потому что ему не нужна group coordination. Scalability producers достигается просто добавлением или удалением producer instances.
Consumer
Consumer groups изолированы друг от друга, так что добавлять и удалять entire consumer groups легко. Внутри одной group механика rebalancing покрывает добавление, удаление и crash consumers. Благодаря consumer groups и rebalance mechanism у consumers есть и scalability, и fault tolerance.
Broker
Прежде чем обсуждать broker scalability, сначала посмотрим на broker failure recovery.
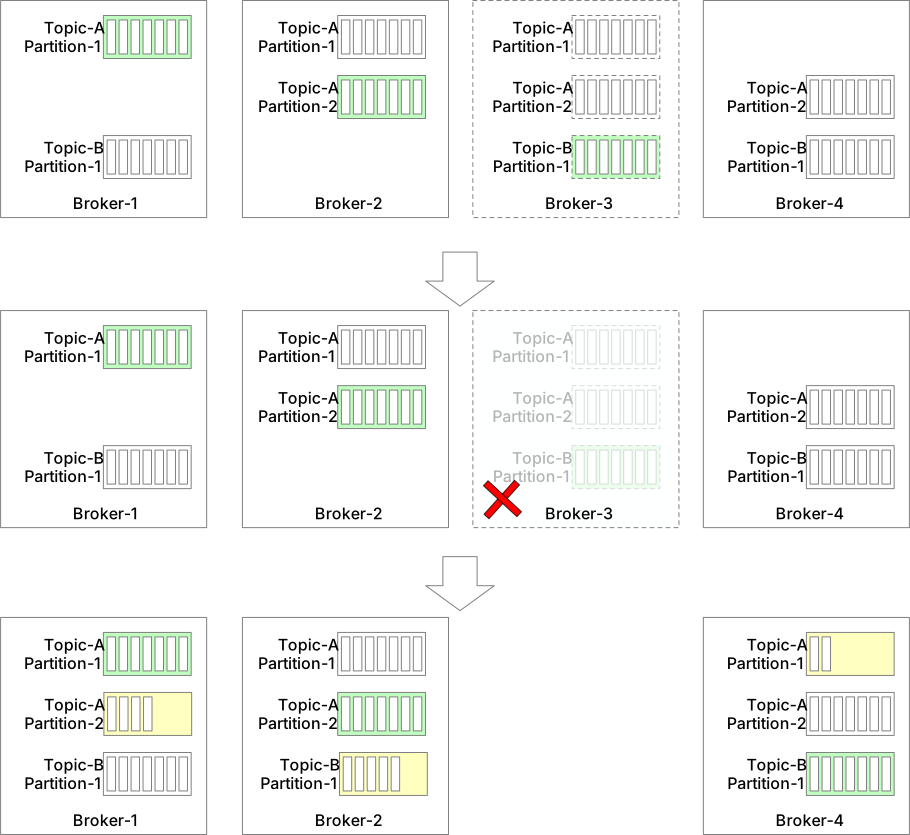
Рисунок 28 Broker node crashes
Разберем на примере из рисунка 28.
-
Пусть у нас 4 brokers, а partition distribution plan такой:
-
Partition 1 topic A: replicas в broker 1 (leader), 2 и 3.
-
Partition 2 topic A: replicas в broker 2 (leader), 3 и 4.
-
Partition 1 topic B: replicas в broker 3 (leader), 4 и 1.
-
-
Broker 3 падает, а значит, все partitions на нем потеряны. План временно меняется на:
-
Partition 1 topic A: replicas в broker 1 (leader) и 2.
-
Partition 2 topic A: replicas в broker 2 (leader) и 4.
-
Partition 1 topic B: replicas в broker 4 и 1.
-
-
Broker controller замечает, что broker 3 down, и генерирует новый plan для оставшихся nodes:
-
Partition 1 topic A: replicas в broker 1 (leader), 2 и 4 (new).
-
Partition 2 topic A: replicas в broker 2 (leader), 4 и 1 (new).
-
Partition 1 topic B: replicas в broker 4 (leader), 1 и 2 (new).
-
-
Новые replicas начинают как followers и догоняют leader.
Чтобы brokers были fault-tolerant, нужно учитывать еще несколько моментов:
-
Минимальное число ISR определяет, сколько replicas producer должен дождаться, прежде чем сообщение считается committed. Чем число выше, тем безопаснее, но тем выше latency.
-
Если все replicas partition находятся на одном broker node, отказ этого node убьет сразу все replicas partition. Это и небезопасно, и неэффективно. Поэтому replicas не должны жить на одном node.
-
Если упадут вообще все replicas partition, данные этой partition потеряны навсегда. При выборе числа replicas и их размещения всегда есть trade-off между безопасностью, стоимостью и latency. Реплики безопаснее разносить по data centers, но тогда возрастут cost и latency synchronization. Возможный workaround — data mirroring, но это уже вне scope [14].
Теперь вернемся к broker scalability. Самый простой вариант — перераспределять replicas, когда brokers добавляются или убираются.
Но есть и лучший подход. Broker controller может временно разрешать иметь в системе больше replicas, чем указано в config. Когда newly added broker догонит, лишние replicas можно удалить. Разберем это на рисунке 29.
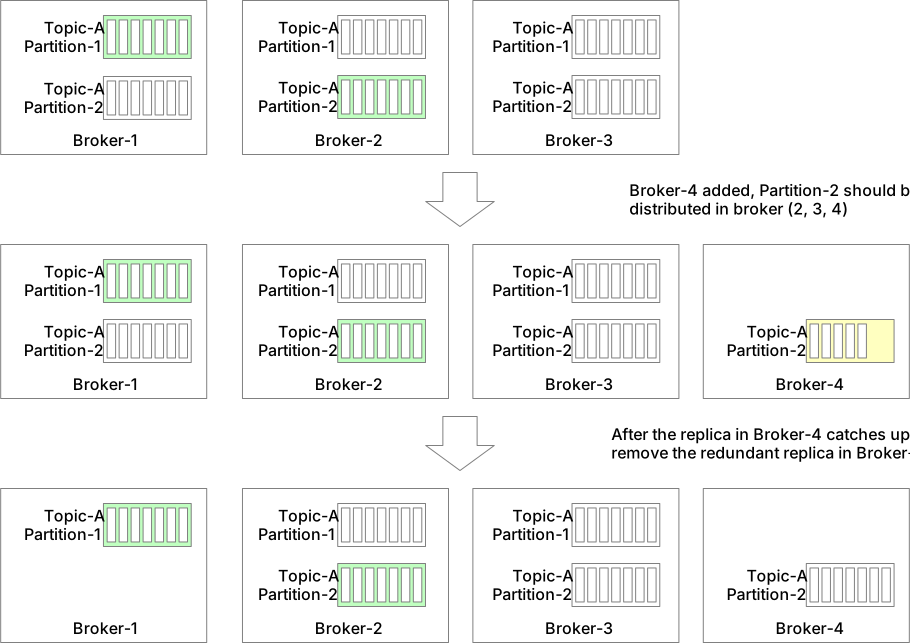
Рисунок 29 Добавление нового broker node
-
Начальное состояние: 3 brokers, 2 partitions и по 3 replicas на partition.
-
Добавляется новый broker 4. Допустим, broker controller меняет replica distribution partition 2 на brokers
(2, 3, 4). Новая replica в broker 4 начинает копировать данные у leader broker 2. Теперь число replicas partition 2 временно больше 3. -
Когда replica в broker 4 догоняет, избыточная partition в broker 1 аккуратно удаляется.
Такой процесс позволяет избежать потери данных при добавлении brokers. Аналогично можно безопасно и удалять brokers.
Partition
По operational причинам — например, ради scaling topic, tuning throughput, балансировки availability/throughput и т. д. — мы можем менять число partitions. Когда partitions меняются, producer узнает об этом после общения с любым broker-ом, а consumer запускает rebalance. Поэтому для producer и consumer такой change безопасен.
Теперь посмотрим на data storage layer при изменении числа partitions. На рисунке 30 мы добавили новую partition к topic.
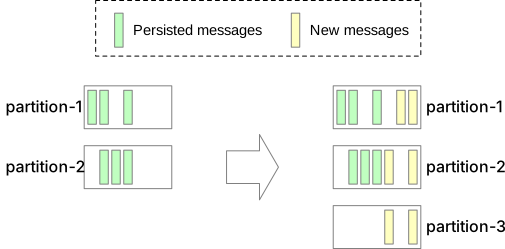
Рисунок 30 Увеличение числа partitions
-
Persisted messages остаются в старых partitions, поэтому миграции данных нет.
-
После добавления новой partition (
partition-3) новые сообщения начинают persist-иться уже во всех трех partitions.
Значит, scale topic через увеличение partitions довольно просто.
Уменьшение числа partitions
Уменьшать partitions сложнее, как показано на рисунке 31.
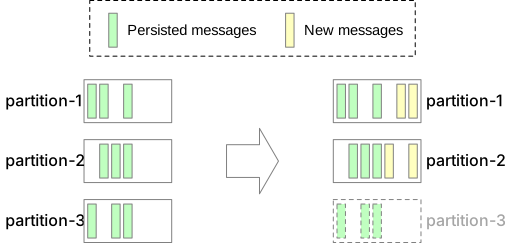
Рисунок 31 Уменьшение числа partitions
-
partition-3decommission-ится, поэтому новые сообщения принимают только оставшиеся partitions (partition-1иpartition-2). -
Decommissioned partition нельзя удалить сразу, потому что consumers могут еще читать оттуда данные. Только после истечения retention period можно truncate-ить данные и освободить место. Уменьшение partitions — это не быстрый способ освободить storage.
-
В переходный период producers уже отправляют сообщения только в оставшиеся 2 partitions, но consumers все еще могут читать из всех 3. После истечения retention у decommissioned partition понадобится rebalance consumer groups.
Data delivery semantics
Теперь, когда мы понимаем разные компоненты distributed message queue, обсудим delivery semantics: at-most-once, at-least-once и exactly-once.
At-most once
Как видно из названия, at-most-once означает, что сообщение будет доставлено не более одного раза. Сообщения могут теряться, но повторно не доставляются. На high level это выглядит так:
-
Producer отправляет сообщение асинхронно в topic, не дожидаясь acknowledgment (
ack=0). Если доставка не удалась, retry нет. -
Consumer fetch-ит сообщение и commit-ит offset до обработки данных. Если consumer падает сразу после commit offset, сообщение уже не будет прочитано повторно.

Рисунок 32 At-most once
Такой режим подходит, например, для monitoring metrics, где небольшая потеря данных приемлема.
At-least once
Здесь допустимо, что сообщение будет доставлено более одного раза, но оно не должно потеряться. На high level это работает так:
-
Producer отправляет сообщение синхронно или асинхронно с callback-ом, используя
ack=1илиack=all, чтобы убедиться, что broker получил сообщение. Если доставка упала или timeout-нулась, producer retry-ит. -
Consumer fetch-ит сообщение и commit-ит offset только после успешной обработки. Если consumer не смог обработать сообщение, он перечитает его, поэтому data loss не будет. Но если consumer обработал сообщение, а затем не успел commit-ить offset, после рестарта он прочитает его еще раз и получится duplicate.
-
Одно и то же сообщение может быть доставлено brokers и consumers более одного раза.

Рисунок 33 At-least once
Use cases: здесь сообщения не теряются, но один и тот же message может прийти несколько раз. Для пользователя это неидеально, но для многих use cases at-least-once достаточно, если duplication не страшна или можно сделать deduplication на consumer side. Например, если у сообщения есть unique key, duplicate можно отбрасывать при записи в database.
Exactly once
Exactly-once — самая сложная semantic delivery. Для users это удобно, но system cost и complexity самые высокие.

Рисунок 34 Exactly once
Use cases: финансы, платежи, trading, accounting и другие сценарии, где duplication недопустима и downstream service или third-party system не поддерживает idempotency.
Advanced features
В этом разделе коротко поговорим о нескольких advanced features: message filtering, delayed messages и scheduled messages.
Message filtering
Topic — это логическая abstraction, содержащая сообщения одного типа. Но некоторые consumer groups могут хотеть читать только отдельные subtypes. Например, ordering system отправляет все события по заказу в один topic, а payment system интересуют только checkout и refund.
Один вариант — строить отдельный topic для payment system и отдельный для ordering system. Это просто, но вызывает несколько проблем:
-
Что если другие системы попросят другие subtypes? Неужели создавать отдельный topic для каждого запроса?
-
Хранить одни и те же сообщения в разных topics — пустая трата ресурсов.
-
Producer придется менять каждый раз при появлении нового consumer requirement, и producer с consumer окажутся tightly coupled.
Значит, нужно решать эту задачу иначе. Здесь нас выручает message filtering.
Наивный вариант — consumer fetch-ит полный набор сообщений и фильтрует ненужные уже на своей стороне. Это гибко, но создает лишний трафик и бьет по performance.
Лучший вариант — фильтровать сообщения на broker side, чтобы consumers получали только то, что им нужно. Но тут важно быть аккуратными. Если filtering требует decryption или deserialization, performance brokers серьезно просядет. Кроме того, если сообщение содержит sensitive data, message queue вообще не должна уметь его читать целиком.
Поэтому filtering logic в broker не должна лезть в payload. Лучше вынести данные для filtering в metadata message. Например, можно прикрепить к каждому сообщению tag. Тогда broker сможет фильтровать сообщения по этому измерению. Если tags несколько, filtering можно делать по нескольким измерениям. Список tags покрывает большую часть реальных требований. А вот чтобы поддерживать более сложную логику, например формулы, broker-у понадобятся grammar parser или script executor, а это уже слишком тяжело для message queue.
С tags consumer может подписываться только на интересующие сообщения, как показано на рисунке 35.
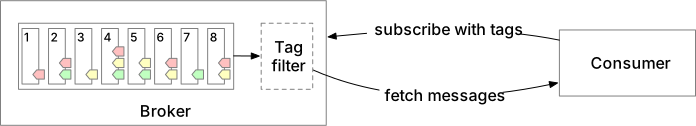
Рисунок 35 Message filtering по tags
Delayed messages и scheduled messages
Иногда нужно отложить доставку сообщения consumer-у на заданный период времени. Например, order должен автоматически закрыться, если не оплачен в течение 30 минут после создания. Тогда delayed verification message (проверка, завершена ли оплата) отправляется сразу, но consumer получит его только через 30 минут. Когда consumer его получит, он проверит payment status. Если оплаты нет — закроет order. Иначе сообщение будет проигнорировано.
В отличие от instant messages, delayed messages можно сначала отправлять во temporary storage на broker side, а в topic переносить только тогда, когда пришло время доставки. High-level design показан на рисунке 36.

Рисунок 36 Delayed messages
Ключевые компоненты:
-
Temporary storage — это один или несколько специальных message topics.
-
Timing function — вне scope, но есть два популярных решения:
-
Dedicated delay queues с predefined delay levels [16]. Например, RocketMQ не поддерживает произвольную точность delay, но поддерживает фиксированные уровни:
1s, 5s, 10s, 30s, 1m, 2m, 3m, 4m, 6m, 8m, 9m, 10m, 20m, 30m, 1h, 2h. -
Hierarchical time wheel [17].
-
Scheduled message означает, что сообщение должно быть доставлено consumer-у в точно заданное время. Общий дизайн очень похож на delayed messages.
Шаг 4 — Wrap-up
В этой главе мы представили дизайн distributed message queue с рядом advanced features, которые обычно встречаются в data streaming platforms. Если в конце интервью останется время, вот еще несколько полезных talking points:
-
Protocol: он определяет правила, syntax и APIs для обмена информацией и передачи данных между разными nodes. В distributed message queue protocol должен:
-
Покрывать все активности: production, consumption, heartbeat и т. д.
-
Эффективно переносить большие объемы данных.
-
Проверять integrity и correctness данных.
Популярные примеры — Advanced Message Queuing Protocol (AMQP) [18] и Kafka protocol [19].
-
-
Retry consumption. Если какие-то сообщения не удалось обработать, нужно retry-ить операцию. Как сделать это через определенный промежуток времени и не блокировать входящие сообщения? Один из вариантов — отправлять failed messages в отдельный retry topic, чтобы они читались позже.
-
Historical data archive. Предположим, есть time-based или capacity-based log retention. Если consumer хочет replay-нуть historical messages, которые уже были truncated, как это сделать? Один из вариантов — хранить historical data в systems с большой емкостью, например HDFS или object storage.
Поздравляю, вы дошли до конца этой главы. Можно похлопать себе по плечу — отличная работа!
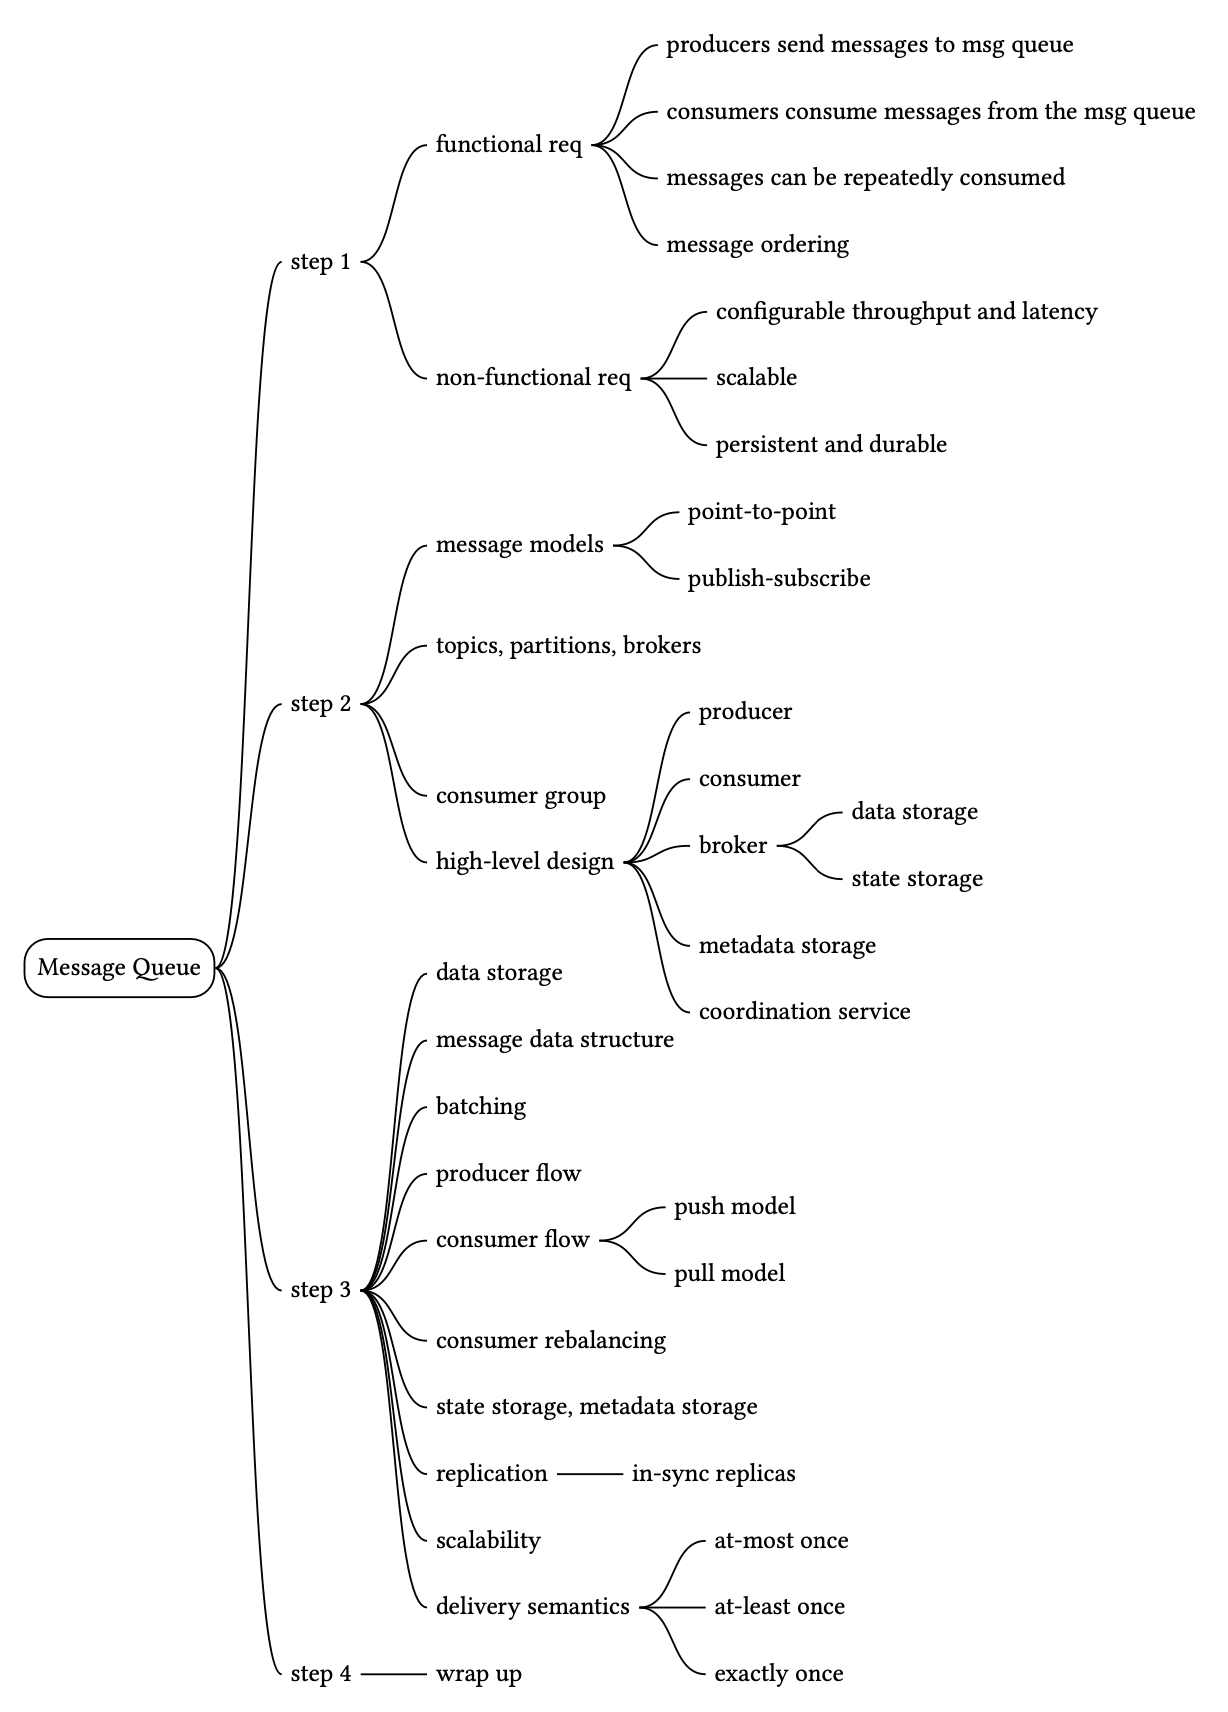
Краткое содержание главы
Справочные материалы
[1] Queue Length Limit: https://www.rabbitmq.com/docs/maxlength
[2] Apache ZooKeeper - Wikipedia:
https://en.wikipedia.org/wiki/Apache_ZooKeeper
[3] etcd: https://etcd.io/
[4] Comparison of disk and memory performance:
https://deliveryimages.acm.org/10.1145/1570000/1563874/jacobs3.jpg
[5] Cyclic redundancy check: https://en.wikipedia.org/wiki/Cyclic_redundancy_check
[6] Push vs. pull: https://kafka.apache.org/documentation/#design_pull
[7] Kafka 2.0 Documentation:
https://kafka.apache.org/20/documentation.html#consumerconfigs
[8] Kafka No Longer Requires ZooKeeper:
https://towardsdatascience.com/kafka-no-longer-requires-zookeeper-ebfbf3862104
[9] Martin Kleppmann. (2017). Replication in Designing Data-Intensive Applications. O'Reilly
Media. pp. 151-197
[10] ISR in Apache Kafka:
https://www.cloudkarafka.com/docs/dictionary.html
[11] Apache Kafka allow consumers fetch from closest replica:
https://cwiki.apache.org/confluence/display/KAFKA/KIP-392%3A+Allow+consumers+to+fetch+from+closest+replica
[12] Hands-free Kafka Replication:
https://www.confluent.io/blog/hands-free-kafka-replication-a-lesson-in-operational-simplicity/
[13] Kafka high watermark: https://rongxinblog.wordpress.com/2016/07/29/kafka-high-watermark/
[14] Kafka mirroring: https://cwiki.apache.org/confluence/pages/viewpage.action?pageId=27846330
[15] Message filtering in RocketMQ: https://partners-intl.aliyun.com/help/doc-detail/29543.htm
[16] Scheduled messages and delayed messages in Apache RocketMQ:
https://partners-intl.aliyun.com/help/doc-detail/43349.htm
[17] Hashed and hierarchical timing wheels:
http://www.cs.columbia.edu/~nahum/w6998/papers/sosp87-timing-wheels.pdf
[18] Advanced Message Queuing Protocol: https://en.wikipedia.org/wiki/Advanced_Message_Queuing_Protocol
[19] Kafka protocol guide: https://kafka.apache.org/protocol