Система бронирования отелей
В этой главе мы спроектируем hotel reservation system для сети отелей вроде Marriott International. Подход и техники из этой главы применимы и к другим популярным booking-related interview topics:
-
Проектирование Airbnb
-
Проектирование flight reservation system
-
Проектирование movie ticket booking system
Шаг 1 — Понять задачу и определить рамки дизайна
Hotel reservation system довольно сложна, а ее components зависят от конкретных business use cases. Прежде чем углубляться в дизайн, стоит задать интервьюеру уточняющие вопросы, чтобы сузить scope.
Кандидат: Какой масштаб системы?
Интервьюер: Предположим, мы строим website для hotel chain, у которой 5,000 hotels и 1 миллион
rooms всего.
Кандидат: Клиенты платят при бронировании или уже по прибытии в отель?
Интервьюер: Для простоты считаем, что они платят полностью в момент бронирования.
Кандидат: Клиенты бронируют номера только через website отеля? Нужно ли поддерживать и другие
варианты, например phone calls?
Интервьюер: Предположим, люди могут бронировать номер через hotel website или app.
Кандидат: Могут ли клиенты отменять reservations?
Интервьюер: Да.
Кандидат: Есть ли что-то еще, что нужно учесть?
Интервьюер: Да, мы разрешаем 10% overbooking. Если термин незнаком: overbooking означает, что
отель продает больше номеров, чем у него есть фактически. Отели делают так в расчете на то, что
часть клиентов отменит reservations.
Кандидат: Поскольку времени немного, предположу, что hotel room search вне scope. Сфокусируемся на следующих features.
-
Показать hotel-related page.
-
Показать detail page для hotel room.
-
Забронировать room.
-
Admin panel для добавления, удаления и обновления hotel или room info.
-
Поддержать overbooking.
Интервьюер: Звучит хорошо.
Интервьюер: И еще один момент: hotel prices меняются динамически. Цена hotel room зависит от
того, насколько заполненным ожидается отель в конкретный день. Для этого интервью можно считать,
что цена может отличаться от дня к дню.
Кандидат: Буду держать это в голове.
Далее имеет смысл обсудить самые важные non-functional requirements.
Нефункциональные требования
-
Поддержка высокой concurrency. В peak season или во время крупных событий некоторые популярные hotels могут получать много клиентов, которые одновременно пытаются забронировать один и тот же room type.
-
Умеренная latency. Желательно иметь быстрый response time, когда пользователь делает reservation, но допустимо, если обработка reservation request занимает несколько секунд.
Back-of-the-envelope estimation
-
5000 hotels и 1 миллион rooms всего.
-
Предположим, что занято 70% rooms, а средняя длительность проживания — 3 дня.
-
Оценка daily reservations:
(1 миллион * 0.7) / 3 = 233,333(округляя, примерно240,000) -
Reservations per second =
240,000 / 10^5секунд в день = примерно3. Как видно, средний reservation TPS не очень высокий.
Теперь грубо оценим QPS всех страниц в системе. В типичном customer flow есть три шага:
-
Просмотр hotel/room detail page. Пользователь изучает страницу.
-
Просмотр booking page. Пользователь подтверждает booking details: даты, число гостей, payment info и т. д. перед бронированием.
-
Бронирование room. Пользователь нажимает
book, и room резервируется.
Предположим, что примерно 10% пользователей доходят до следующего шага, а 90% отваливаются до финального шага. Также предположим, что prefetching не реализован. На рисунке 1 показана грубая оценка QPS для разных шагов. Мы знаем, что финальный reservation TPS равен 3, значит можем двигаться назад по funnel. QPS для order confirmation page будет 30, а QPS для detail page — 300.

Рисунок 1 Распределение QPS
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
В этом разделе обсудим:
-
API design
-
Data models
-
High-level design
API design
Разберем API design для hotel reservation system. Ниже перечислены самые важные APIs в RESTful стиле.
Заметим, что эта глава фокусируется именно на design hotel reservation system. Для полноценного hotel website пришлось бы добавить удобные features поиска rooms по большому набору criteria. Эти APIs важны, но технически не слишком сложны, поэтому в scope этой главы не входят.
Hotel-related APIs
| API | Описание |
|---|---|
| GET /v1/hotels/ID | Получить подробную информацию об отеле. |
| POST /v1/hotels | Добавить новый отель. Этот API доступен только hotel staff. |
| PUT /v1/hotels/ID | Обновить информацию об отеле. Этот API доступен только hotel staff. |
| DELETE /v1/hotels/ID | Удалить отель. Этот API доступен только hotel staff. |
Таблица 1 Hotel-related APIs
Room-related APIs
| API | Описание |
|---|---|
| GET /v1/hotels/ID/rooms/ID | Получить подробную информацию о room. |
| POST /v1/hotels/ID/rooms | Добавить room. Этот API доступен только hotel staff. |
| PUT /v1/hotels/ID/rooms/ID | Обновить информацию о room. Этот API доступен только hotel staff. |
| DELETE /v1/hotels/ID/rooms/ID | Удалить room. Этот API доступен только hotel staff. |
Таблица 2 Room-related APIs
Reservation-related APIs
| API | Описание |
|---|---|
| GET /v1/reservations | Получить reservation history текущего logged-in user. |
| GET /v1/reservations/ID | Получить подробную информацию о reservation. |
| POST /v1/reservations | Создать новую reservation. |
| DELETE /v1/reservations/ID | Отменить reservation. |
Таблица 3 Reservation-related APIs
Создание новой reservation — одна из самых важных features. Request parameters для
POST /v1/reservations могут выглядеть так:
{
  "startDate":"2021-04-28",
  "endDate":"2021-04-30",
  "hotelID":"245",
  "roomID":"U12354673389",
  "reservationID":"13422445"
}
Обратите внимание: reservationID используется как idempotency key, чтобы предотвратить double booking. Double booking означает, что для одного и того же room на один и тот же день создается несколько reservations. Подробности разберем в разделе “Concurrency issues” ниже.
Data model
Прежде чем выбирать database, полезно внимательно посмотреть на data access patterns. Для hotel reservation system нам нужно поддержать следующие queries:
Query 1: Просмотр подробной информации об отеле.
Query 2: Поиск доступных room types для заданного date range.
Query 3: Запись reservation.
Query 4: Просмотр reservation или reservation history.
Из back-of-the-envelope estimation видно, что система не очень большая, но к traffic spikes во время крупных событий надо быть готовыми. С этими требованиями логично выбрать relational database, потому что:
-
Relational database хорошо подходит для read-heavy workload, где writes случаются реже. Число пользователей, которые заходят на hotel website/apps, на несколько порядков выше числа тех, кто реально делает reservation. NoSQL databases обычно лучше оптимизированы под writes, а relational database здесь вполне достаточно.
-
Relational database дает ACID guarantees: atomicity, consistency, isolation, durability. Для reservation system это критично. Без этих свойств трудно предотвращать отрицательные балансы, double charge, double reservation и т. д. ACID сильно упрощает application code и делает всю систему более предсказуемой.
-
Relational database легко моделирует данные. Структура business data понятна, а отношения между entities вроде hotel, room, room_type и т. д. стабильны. Такой data model естественно ложится в relational database.
Теперь, когда мы выбрали relational database, посмотрим на schema design. На рисунке 2 показана прямая и интуитивная схема, которую многие кандидаты сначала и предложат.
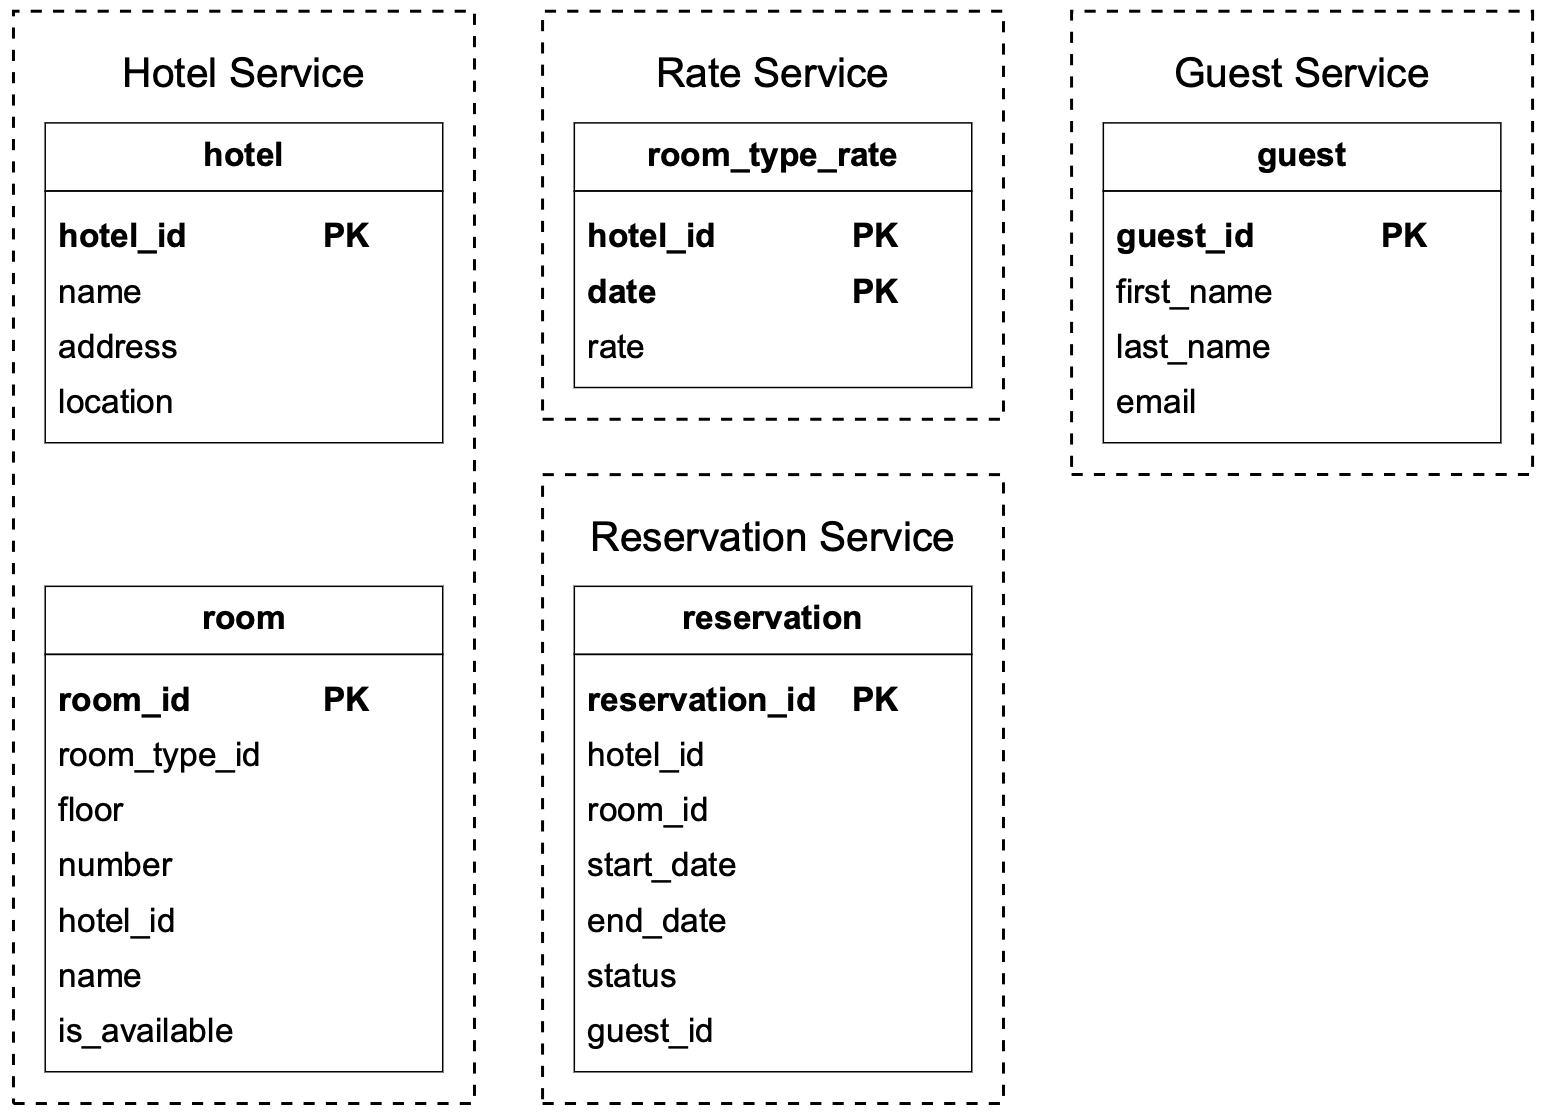
Рисунок 2 Database schema
Большинство attributes здесь понятны сами по себе, поэтому отдельно поясним только поле status в
reservation table. Поле status может находиться в одном из состояний: pending, paid,
refunded, canceled, rejected. State machine показана на рисунке 3.

Рисунок 3 Reservation status
У этой schema design есть серьезная проблема. Такая модель подошла бы компаниям вроде Airbnb, где room_id (или listing_id) известен в момент reservation. Но для hotel это не так. Пользователь резервирует тип номера, а не конкретный номер. Например, room type может быть standard room, king-size room, queen room с двумя queen beds и т. д. Конкретный room number назначается уже при check-in, а не во время reservation. Поэтому data model нужно обновить. Подробнее см. раздел “Improved data model”.
High-level design
Для hotel reservation system мы выберем microservice architecture. За последние годы она стала очень популярной. Ее используют Amazon, Netflix, Uber, Airbnb, Twitter и многие другие. Если хочется глубже понять преимущества microservice architecture, можно посмотреть reference materials [1] [2].
Наш дизайн построен на microservice architecture, а high-level design показан на рисунке 4.
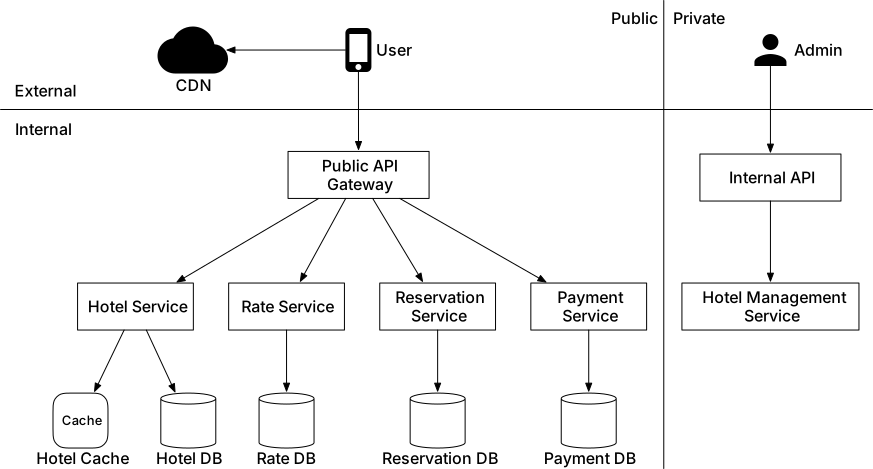
Рисунок 4 High-level design
Коротко пройдемся по components сверху вниз.
-
User: пользователь бронирует hotel room со смартфона или компьютера.
-
Admin (hotel staff): авторизованный сотрудник отеля выполняет administrative operations: refund customer, cancel reservation, update room information и т. д.
-
CDN: для более быстрой загрузки кэширует static assets — JavaScript bundles, images, videos, HTML и т. д.
-
Public API Gateway: fully managed service, поддерживающий rate limiting, authentication и т. д. Он маршрутизирует requests в нужные services по endpoints. Например, запросы на hotel homepage идут в Hotel Service, а booking requests — в Reservation Service.
-
Internal APIs: доступны только authorized hotel staff через internal software или websites. Как правило, дополнительно защищены VPN.
-
Hotel Service: предоставляет подробную информацию об отелях и комнатах. Hotel и room data в основном статичны, поэтому легко кэшируются.
-
Rate Service: предоставляет room rates для будущих дат. В hotel industry цена room зависит от того, насколько заполненным ожидается hotel в конкретный день.
-
Reservation Service: принимает reservation requests и резервирует hotel rooms. Он же отслеживает room inventory при reservation и cancellation.
-
Payment Service: списывает payment с customer и обновляет reservation status до
paid, если transaction прошла успешно, либо доrejected, если payment failed. -
Hotel Management Service: доступен только authorized hotel staff. Сотрудники могут смотреть upcoming reservations, бронировать room для клиента, cancel reservation и т. д.
Для ясности рисунок 4 не показывает много inter-service arrows. Например, как показано на рисунке 5, должна быть связь между Reservation Service и Rate Service: Reservation Service запрашивает room rates, чтобы вычислить total room charge. Еще пример: Hotel Management Service должен взаимодействовать почти со всеми остальными services, потому что admin changes нужно передавать в сервис, который владеет соответствующими данными.

Рисунок 5 Связи между services
В production systems inter-service communication часто строится на современном высокопроизводительном RPC framework вроде gRPC. У этого есть много преимуществ. Подробнее про gRPC можно почитать в [3].
Шаг 3 — Погружение в детали дизайна
Теперь, когда high-level design понятен, углубимся в следующее:
-
Improved data model
-
Concurrency issues
-
Scaling the system
-
Resolving data inconsistency в microservice architecture
Improved data model
Как уже упоминалось, при hotel reservation мы резервируем именно room type, а не конкретный room. Что нужно поменять в API и schema, чтобы это учесть?
В reservation API параметр roomID нужно заменить на roomTypeID. Тогда API для reservation
выглядит так:
POST /v1/reservations
Request parameters:
{
  "startDate":"2021-04-28",
  "endDate":"2021-04-30",
  "hotelID":"245",
  "roomTypeID":"12354673389",
  "roomCount":"3",
  "reservationID":"13422445"
}
Обновленная schema показана на рисунке 6.
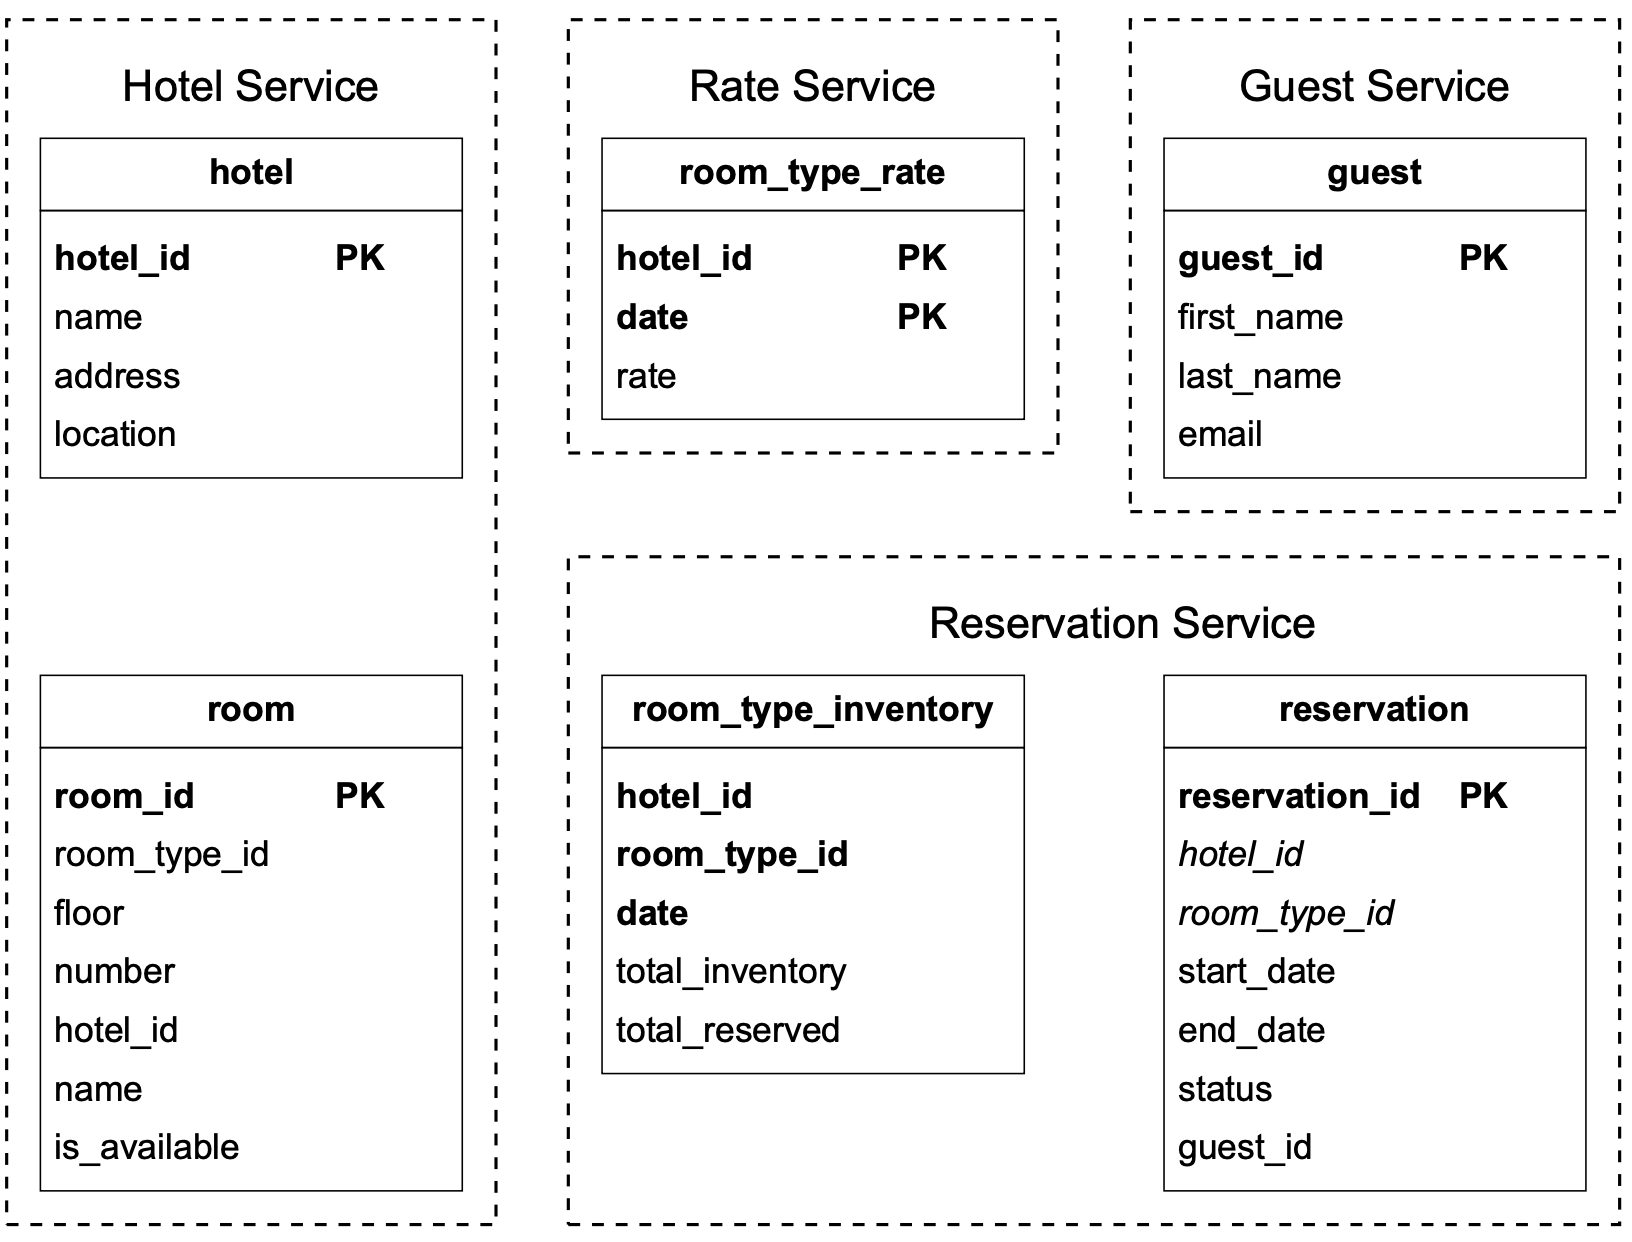
Рисунок 6 Updated schema
Коротко пройдемся по важнейшим tables.
room: содержит информацию о конкретной комнате.
room_type_rate: хранит price data для конкретного room type на будущие даты.
reservation: хранит reservation data гостя.
room_type_inventory: хранит inventory data по hotel rooms. Эта table особенно важна, поэтому посмотрим на колонки подробнее.
-
hotel_id: ID отеля
-
room_type_id: ID room type
-
date: отдельная дата
-
total_inventory: общее число комнат за вычетом тех, которые временно выведены из inventory. Например, часть rooms может быть недоступна из-за maintenance.
-
total_reserved: общее число rooms, уже забронированных для заданных hotel_id, room_type_id и date.
Есть и другие способы спроектировать room_type_inventory, но строка на каждую дату делает
управление reservations по date range и queries очень удобным. Как видно на рисунке 6,
(hotel_id, room_type_id, date) — составной primary key. Таблица заранее pre-populated на основе
inventory data для всех будущих дат на 2 года вперед. Дополнительно есть daily scheduled job,
который продолжает заполнять inventory по мере сдвига дат.
Теперь, когда schema design финализирован, оценим storage volume. Как мы уже считали выше, у нас 5,000 hotels. Предположим, в каждом отеле 20 room types. Тогда получаем:
5000 hotels * 20 room types * 2 years * 365 days = 73 million rows
73 миллиона rows — это не очень много, и одной database достаточно. Но single server — это single point of failure. Чтобы получить high availability, можно настроить database replication между несколькими regions или availability zones.
Таблица 4 показывает sample data для room_type_inventory.
| hotel_id | room_type_id | date | total_inventory | total_reserved |
|---|---|---|---|---|
| 211 | 1001 | 2021-06-01 | 100 | 80 |
| 211 | 1001 | 2021-06-02 | 100 | 82 |
| 211 | 1001 | 2021-06-03 | 100 | 86 |
| 211 | 1001 | ... | ... | |
| 211 | 1001 | 2023-05-31 | 100 | 0 |
| 211 | 1002 | 2021-06-01 | 200 | 16 |
| 2210 | 101 | 2021-06-01 | 30 | 23 |
| 2210 | 101 | 2021-06-02 | 30 | 25 |
Таблица 4 Sample data для room_type_inventory
Таблица room_type_inventory используется, чтобы проверить, может ли клиент забронировать конкретный room type. Вход и выход такой проверки могут выглядеть так:
-
Input:
startDate (2021-07-01), endDate (2021-07-03), roomTypeId, hotelId, numberOfRoomsToReserve -
Output:
true, если для заданного room type есть inventory и booking возможен. Иначеfalse.
С точки зрения SQL это две операции:
- Выбрать строки в указанном date range:
SELECT date, total_inventory, total_reserved
FROM room_type_inventory
WHERE room_type_id = ${roomTypeId} AND hotel_id = ${hotelId}
AND date between ${startDate} and ${endDate}
Запрос вернет что-то вроде:
| date | total_inventory | total_reserved |
|---|---|---|
| 2021-07-01 | 100 | 97 |
| 2021-07-02 | 100 | 96 |
| 2021-07-03 | 100 | 95 |
Таблица 5 Hotel inventory
- Для каждой записи application проверяет условие:
if (total_reserved + ${numberOfRoomsToReserve}) <= total_inventory
Если условие истинно для всех строк, значит rooms хватает на каждую дату в заданном диапазоне.
Одно из требований — поддержка 10% overbooking. С новой schema это легко реализовать:
if (total_reserved + ${numberOfRoomsToReserve}) <= 110% * total_inventory
На этом этапе интервьюер может спросить: “А что, если reservation data станет слишком большой для одной database?” Есть несколько стратегий:
-
Хранить только current и future reservation data. Reservation history используется редко, поэтому ее можно архивировать, а часть вообще отправить в cold storage.
-
Database sharding. Наиболее частые queries — сделать reservation или найти reservation по имени. В обоих случаях сначала выбирается hotel, значит hotel_id — хороший sharding key. Данные можно шардировать по
hash(hotel_id) % number_of_servers.
Concurrency issues
Еще одна важная проблема — double booking. Нам нужно решить два сценария:
-
Один и тот же user нажимает
bookнесколько раз. -
Несколько users пытаются забронировать один и тот же room type одновременно.
Сначала разберем первый сценарий. Как показано на рисунке 7, создаются две reservations.

Рисунок 7 Создаются две reservations
Есть два распространенных способа решить эту проблему:
-
Client-side implementation. Клиент может сделать
submitbutton серой, скрыть или disable-ить его после отправки request. Обычно это предотвращает double-clicking, но решение ненадежное. Например, пользователь может отключить JavaScript и обойти эту проверку. -
Idempotent APIs. Добавить idempotency key в reservation API request. API call называется idempotent, если независимо от числа повторов он дает один и тот же result. На рисунке 8 показано, как idempotency key (reservation_id) помогает избежать double reservation.
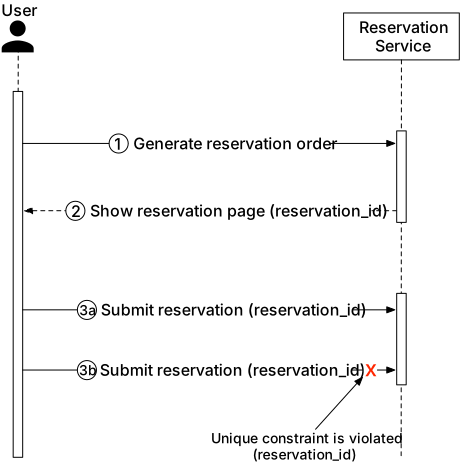
Рисунок 8 Unique constraint
-
Генерируется reservation order. После того как customer вводит details reservation (
room type,check-in date,check-out dateи т. д.) и нажимаетcontinue, Reservation Service создает reservation order. -
Система показывает reservation order клиенту на review. Уникальный reservation_id генерируется globally unique ID generator-ом и возвращается как часть API response. UI на этом шаге может выглядеть как на рисунке 9.
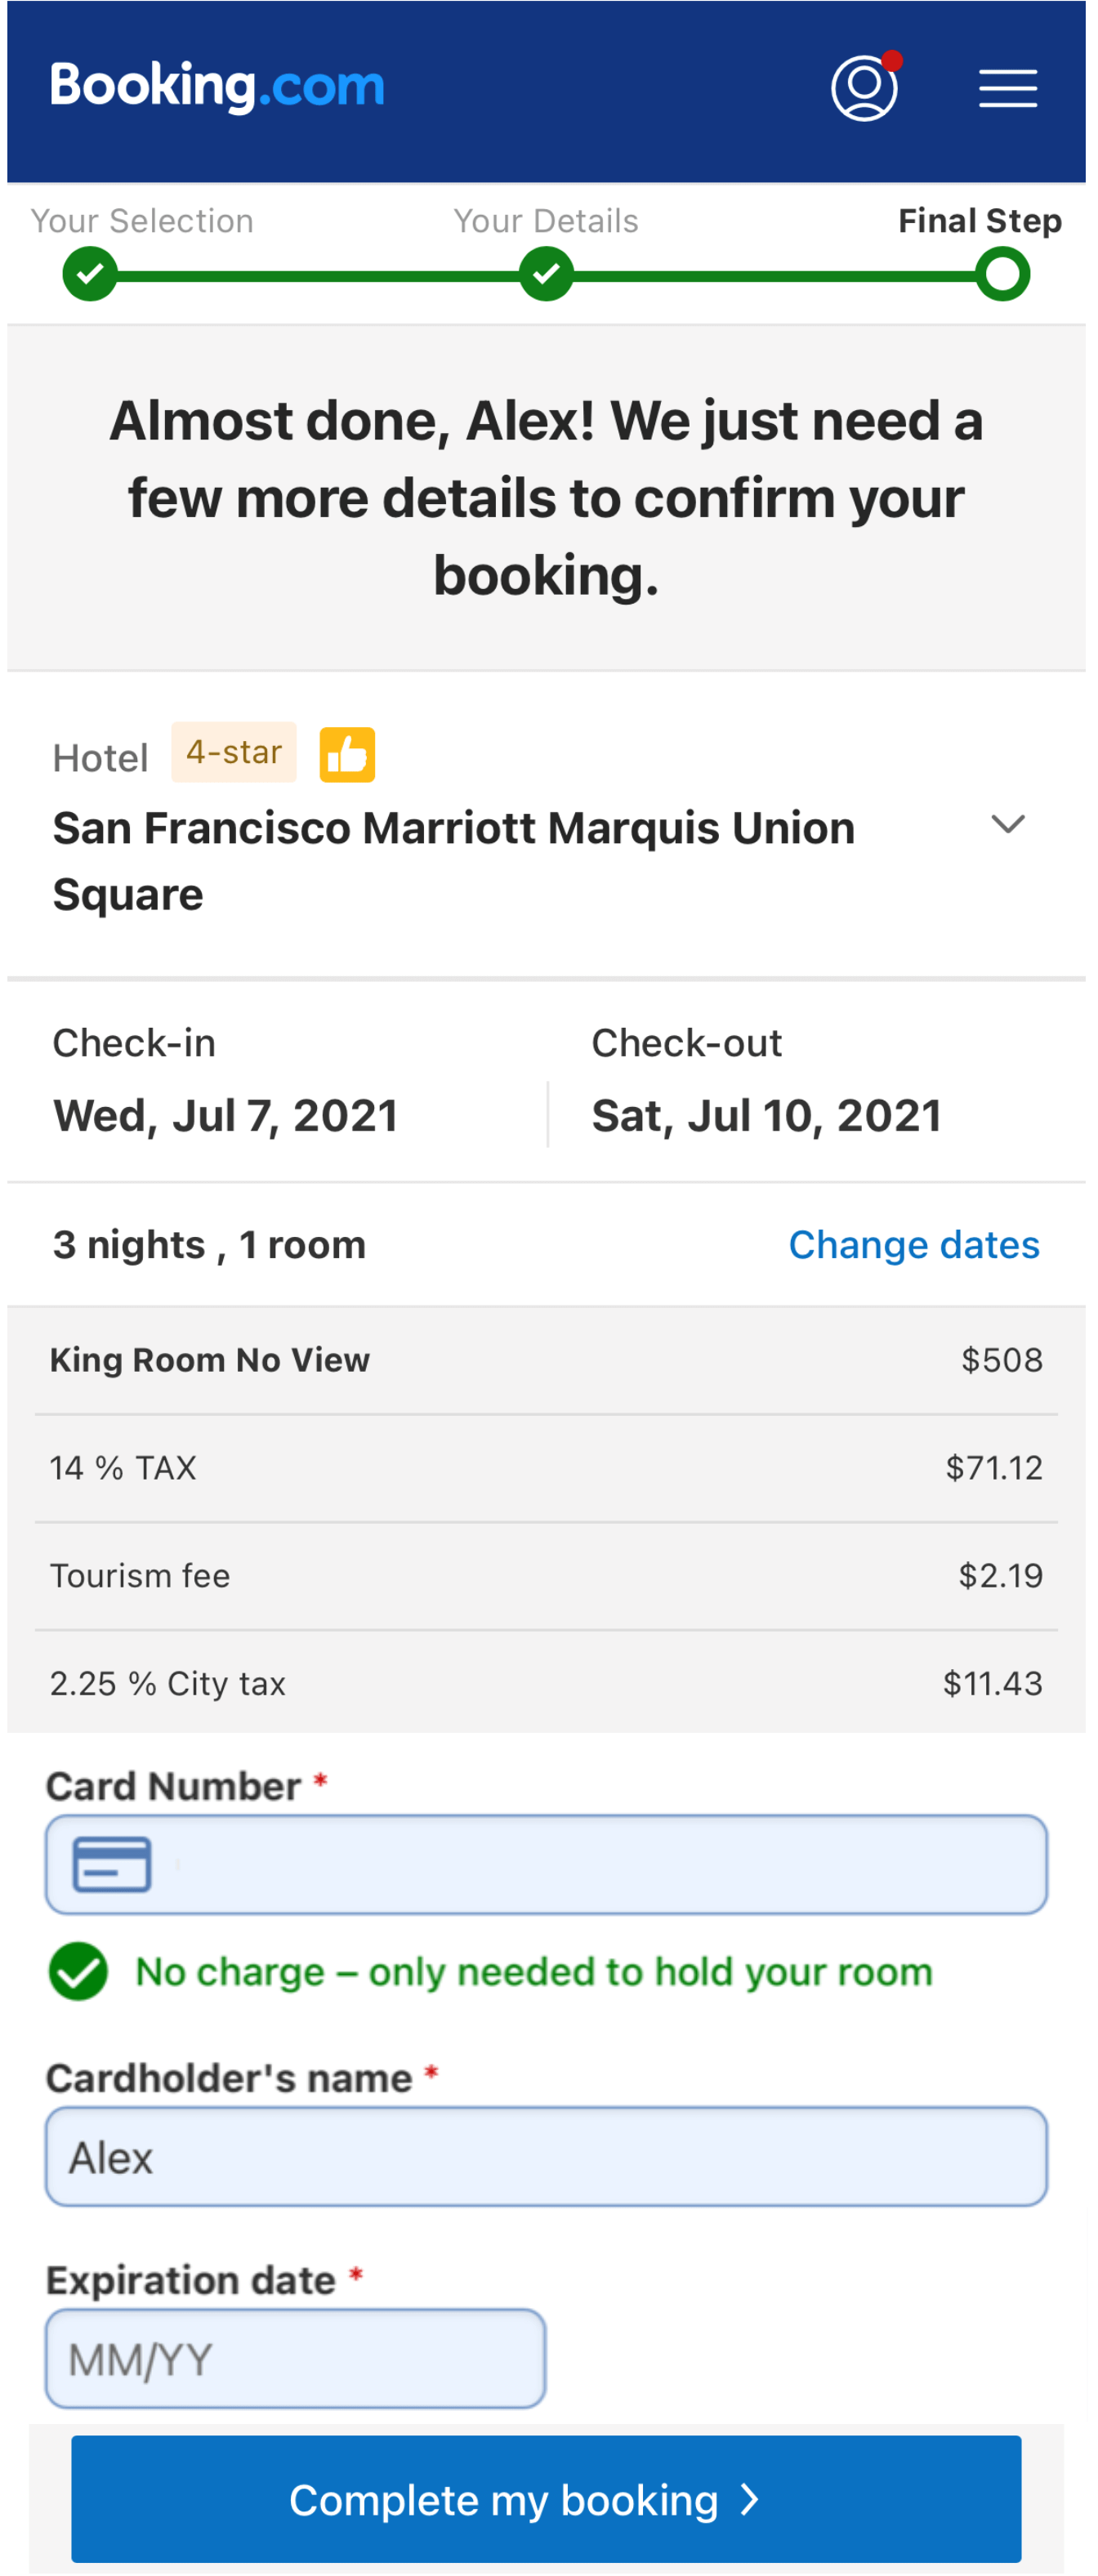
Рисунок 9 Confirmation page (источник: [4])
3a. Submit reservation 1. reservation_id включается в request. Это primary key таблицы reservation. Обратите внимание: idempotency key не обязан быть именно reservation_id. Мы выбрали его, потому что он уже есть и хорошо подходит для нашего design.
3b. Если user нажимает Complete my booking второй раз, отправляется reservation 2. Поскольку
reservation_id — primary key reservation table, unique constraint гарантирует отсутствие
double reservation.
Почему это работает, показано на рисунке 10.
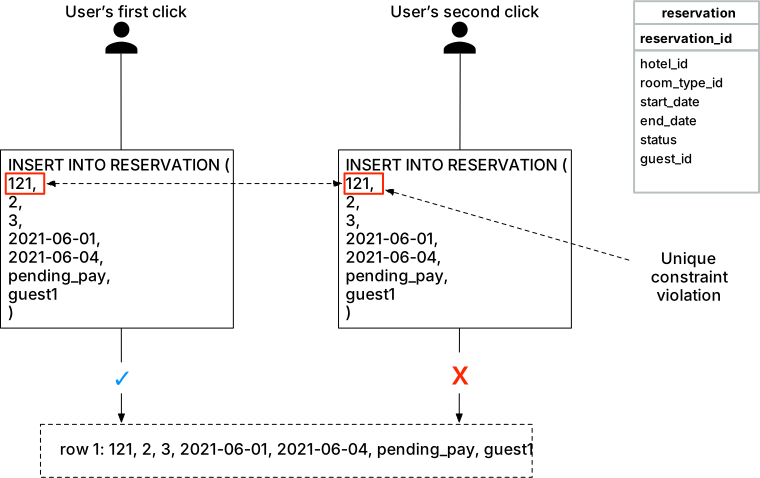
Рисунок 10 Unique constraint violation
Сценарий 2: что будет, если несколько users одновременно бронируют один и тот же room type, а осталась только одна room? Рассмотрим ситуацию на рисунке 11.
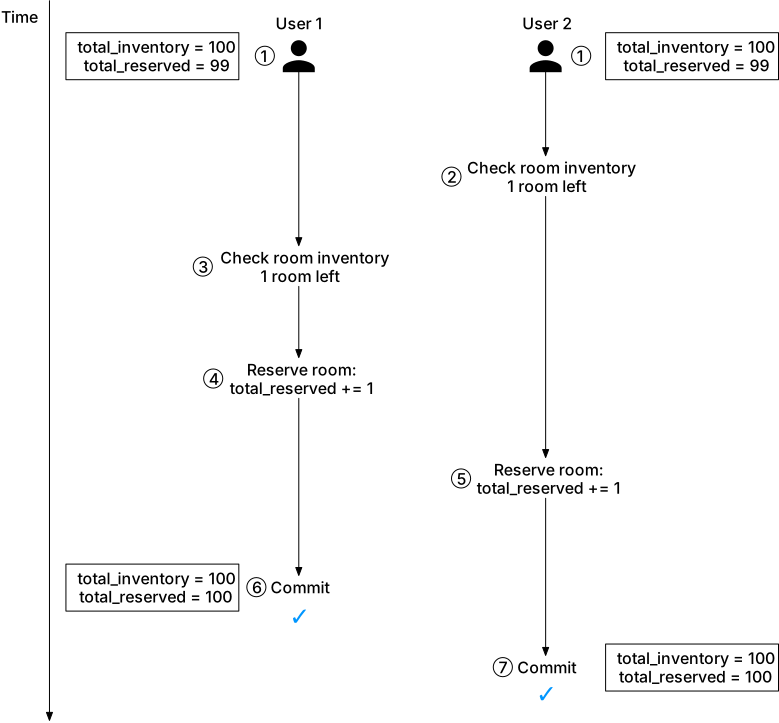
Рисунок 11 Race condition
-
Предположим, database isolation level не serializable [5]. User 1 и User 2 одновременно пытаются забронировать один и тот же room type, а осталась только одна комната. Назовем выполнение первого
transaction 1, второго —transaction 2. В этот момент в hotel 100 rooms, из них 99 уже reserved. -
Transaction 2 проверяет, хватает ли rooms, вычисляя условие
(total_reserved + rooms_to_book) <= total_inventory. Поскольку одна room еще есть, ответtrue. -
Transaction 1 делает ту же проверку и тоже получает
true. -
Transaction 1 резервирует room и обновляет inventory: reserved_room становится 100.
-
Затем transaction 2 тоже резервирует room. Свойство isolation в ACID означает, что transactions должны выполняться независимо друг от друга. Поэтому изменения transaction 1 не видны transaction 2 до commit. Transaction 2 все еще видит total_reserved = 99 и тоже обновляет inventory до 100. В итоге система позволяет двум users забронировать room, хотя свободна была только одна.
-
Transaction 1 успешно commit-ится.
-
Transaction 2 тоже успешно commit-ится.
Чтобы решить проблему, обычно нужен какой-то locking mechanism. Рассмотрим три техники:
-
Pessimistic locking
-
Optimistic locking
-
Database constraints
Прежде чем исправлять проблему, посмотрим на SQL pseudo-code, используемый для reservation room. SQL состоит из двух частей:
-
Проверка inventory
-
Reservation room
# step 1: check room inventory
SELECT date, total_inventory, total_reserved
FROM room_type_inventory
WHERE room_type_id = ${roomTypeId} AND hotel_id = ${hotelId}
AND date between ${startDate} and ${endDate}

# For every entry returned from step 1
if((total_reserved + ${numberOfRoomsToReserve}) > 110% * total_inventory) {
  Rollback
}

# step 2: reserve rooms
UPDATE room_type_inventory
SET total_reserved = total_reserved + ${numberOfRoomsToReserve}
WHERE room_type_id = ${roomTypeId}
AND date between ${startDate} and ${endDate}

Commit
Вариант 1: Pessimistic locking
Pessimistic locking [6], также называемый pessimistic concurrency control, предотвращает одновременные updates, ставя lock на record, как только один user начинает ее менять. Другие users, которые пытаются обновить ту же запись, должны ждать, пока первый user не отпустит lock (не commit-нет изменения).
В MySQL запрос SELECT ... FOR UPDATE блокирует строки, возвращенные selection query. Пусть
transaction 1 уже стартовала. Тогда все остальные transactions ждут, пока она завершится.
Подробности показаны на рисунке 12.
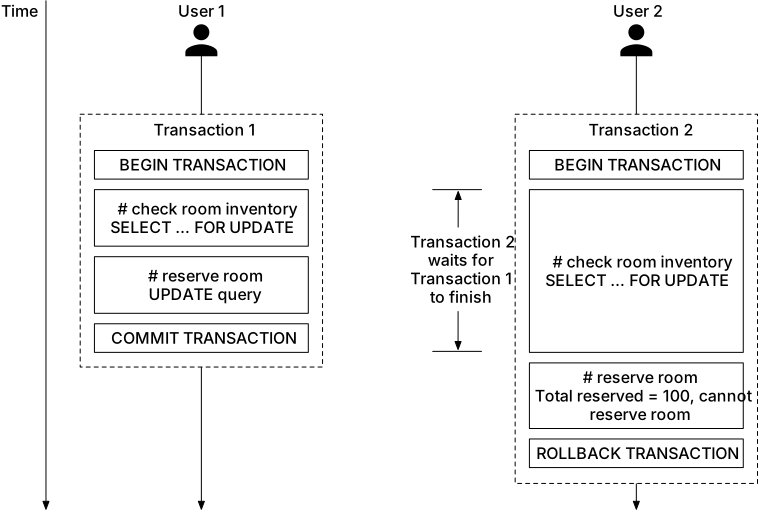
Рисунок 12 Pessimistic locking
На рисунке 12 SELECT ... FOR UPDATE во второй transaction ждет завершения первой, потому что
первая transaction держит lock на rows. Когда transaction 1 заканчивается, total_reserved
становится 100, а значит места для User 2 больше нет.
Плюсы:
-
Предотвращает update data, которая уже меняется или была изменена.
-
Легко реализуется и избегает conflicts через сериализацию updates. Pessimistic locking полезен, когда contention высокий.
Минусы:
-
Возможны deadlocks, если блокируются несколько resources. Написать deadlock-free application code может быть непросто.
-
Подход плохо масштабируется. Если transaction держит lock слишком долго, остальные transactions не могут получить доступ к resource. Это заметно бьет по database performance, особенно если transactions долгоживущие или затрагивают много entities.
Из-за этих ограничений для reservation system мы pessimistic locking не рекомендуем.
Вариант 2: Optimistic locking
Optimistic locking [7], также называемый optimistic concurrency control, позволяет нескольким concurrent users пытаться обновлять один и тот же resource одновременно.
Есть два распространенных способа реализовать optimistic locking: version number и timestamp. Обычно version number считается лучшим вариантом, потому что server clock со временем может быть неточен. Ниже объясним optimistic locking через version number.
На рисунке 13 показан успешный кейс и failure case.
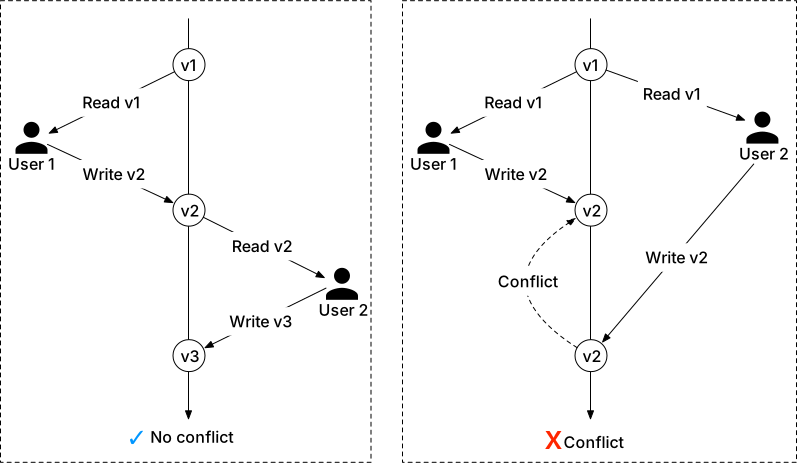
Рисунок 13 Optimistic locking
-
В database table добавляется новая колонка
version. -
Перед тем как user меняет database row, application читает version number этой row.
-
Когда user обновляет row, application увеличивает version number на 1 и записывает его назад в database.
-
Добавляется database validation check: следующая version должна быть больше текущей ровно на 1. Если validation не проходит, transaction abort-ится, и user начинает с шага 2 заново.
Optimistic locking обычно быстрее pessimistic locking, потому что database не блокируется. Но при высокой concurrency performance optimistic locking резко падает.
Почему? Представим, что много clients одновременно пытаются забронировать hotel room. Поскольку на число clients, которые могут прочитать available room count, ограничений нет, все они получают одинаковый available room count и одну и ту же текущую version number. Когда clients пытаются записать результат reservation назад в database, succeed-ит только один, а остальные получают version check failure. Им приходится retry. В следующем раунде retries снова проходит только один client, а остальные снова retry. Итог математически корректный, но user experience получается неприятным.
Плюсы:
-
Предотвращает редактирование stale data.
-
Не требует database locks. С точки зрения database тут вообще нет locking; вся логика лежит на application.
-
Обычно хорошо работает при низком contention. Когда conflicts редки, transactions завершаются без издержек на управление locks.
Минусы:
- Performance плохой, когда contention высокий.
Optimistic locking — хороший вариант для hotel reservation system, потому что reservation QPS обычно невысок.
Вариант 3: Database constraints
Этот подход очень похож на optimistic locking. Посмотрим, как он работает. В room_type_inventory table можно добавить такой constraint:
CONSTRAINT `check_room_count` CHECK((`total_inventory - total_reserved` >= 0))
В примере с рисунка 14, когда User 2 пытается зарезервировать room, total_reserved становится
101, а это нарушает constraint
total_inventory (100) - total_reserved (101) >= 0. Поэтому transaction откатывается.
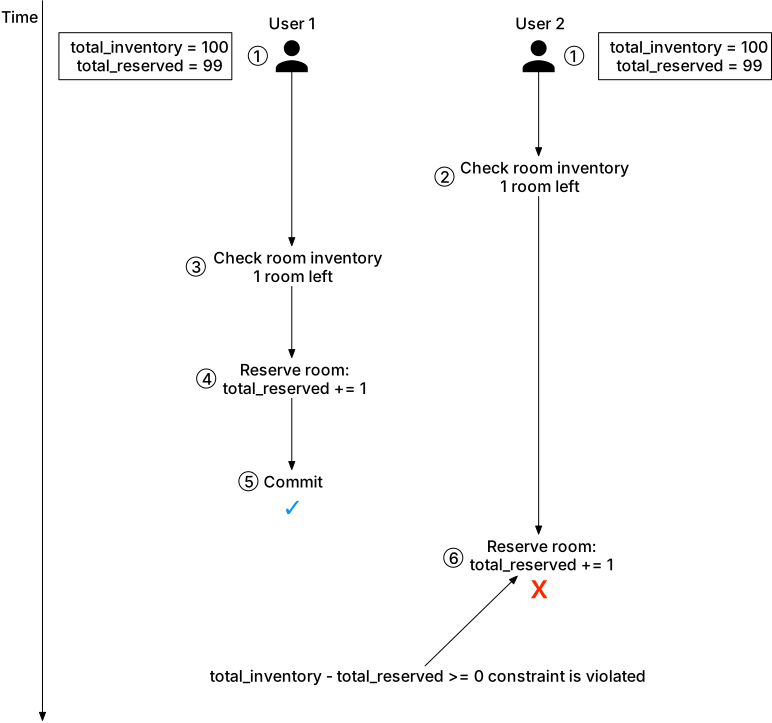
Рисунок 14 Database constraint
Плюсы
-
Легко реализовать.
-
Хорошо работает, когда contention минимален.
Минусы
-
Как и optimistic locking, при высоком contention может приводить к большому числу failures. Users могут видеть, что room доступны, но при попытке booking получать ответ “no rooms available”. Это раздражает.
-
Database constraints сложнее version-control-ить, чем application code.
-
Не все databases поддерживают constraints. Это может создавать проблемы при миграции между database solutions.
Так как подход прост в реализации, а contention в hotel reservation обычно невысокий, это тоже хороший вариант для нашей системы.
Scalability
Обычно нагрузка на hotel reservation system не очень высокая. Но интервьюер может спросить: “А что, если система используется не только hotel chain, а популярным travel site вроде booking.com или expedia.com?” Тогда QPS может быть выше в 1,000 раз.
Когда нагрузка высока, надо понять, где возникнет bottleneck. Все наши services stateless, значит их можно масштабировать простым добавлением servers. Но database хранит state и не масштабируется так же легко. Посмотрим, как масштабировать database.
Database sharding
Один из способов масштабировать database — database sharding. Идея в том, чтобы разделить данные между несколькими databases, и каждая из них будет хранить только часть dataset.
При sharding нужно решить, как именно распределять данные. Как видно из data model, большинство
queries фильтрует по hotel_id. Поэтому естественный вывод — шардировать именно по hotel_id.
На рисунке 15 нагрузка распределена между 16 shards. Если общий QPS равен 30,000, то после
sharding каждая shard будет обрабатывать 30,000 / 16 = 1875 QPS, что укладывается в capacity
одного MySQL server.
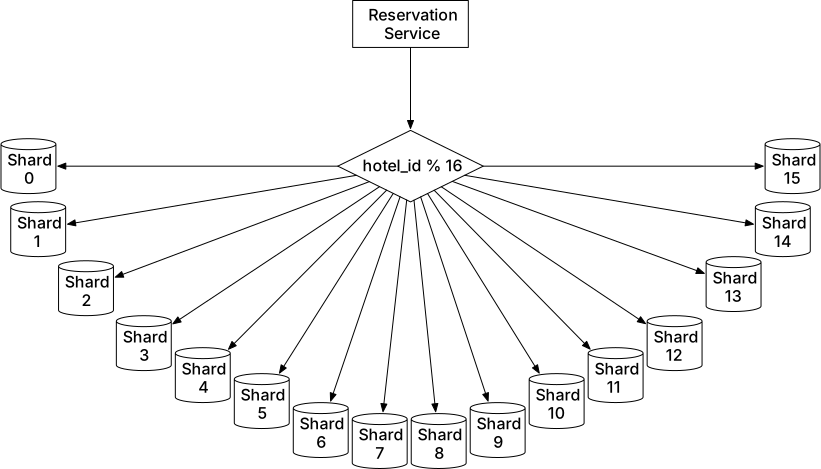
Рисунок 15 Database sharding
Caching
У hotel inventory data есть интересное свойство: meaningful only current and future inventory data, потому что users могут бронировать rooms только в обозримом будущем.
Поэтому для storage хорошо бы иметь TTL mechanism, чтобы old data истекали автоматически. Historical data можно хранить в другой database. Redis здесь хорошо подходит, потому что TTL и LRU cache eviction policy помогают эффективно использовать memory.
Если loading speed и database scalability становятся проблемой, например при масштабе booking.com или expedia.com, можно добавить cache layer поверх database и перенести check inventory и reserve room logic в cache layer, как показано на рисунке 16. В таком design лишь маленький процент requests доходит до inventory database, потому that большинство неподходящих requests отсеиваются inventory cache. Но даже если Redis показывает, что inventory достаточно, все равно нужно повторно проверить inventory на стороне database. Database остается source of truth.
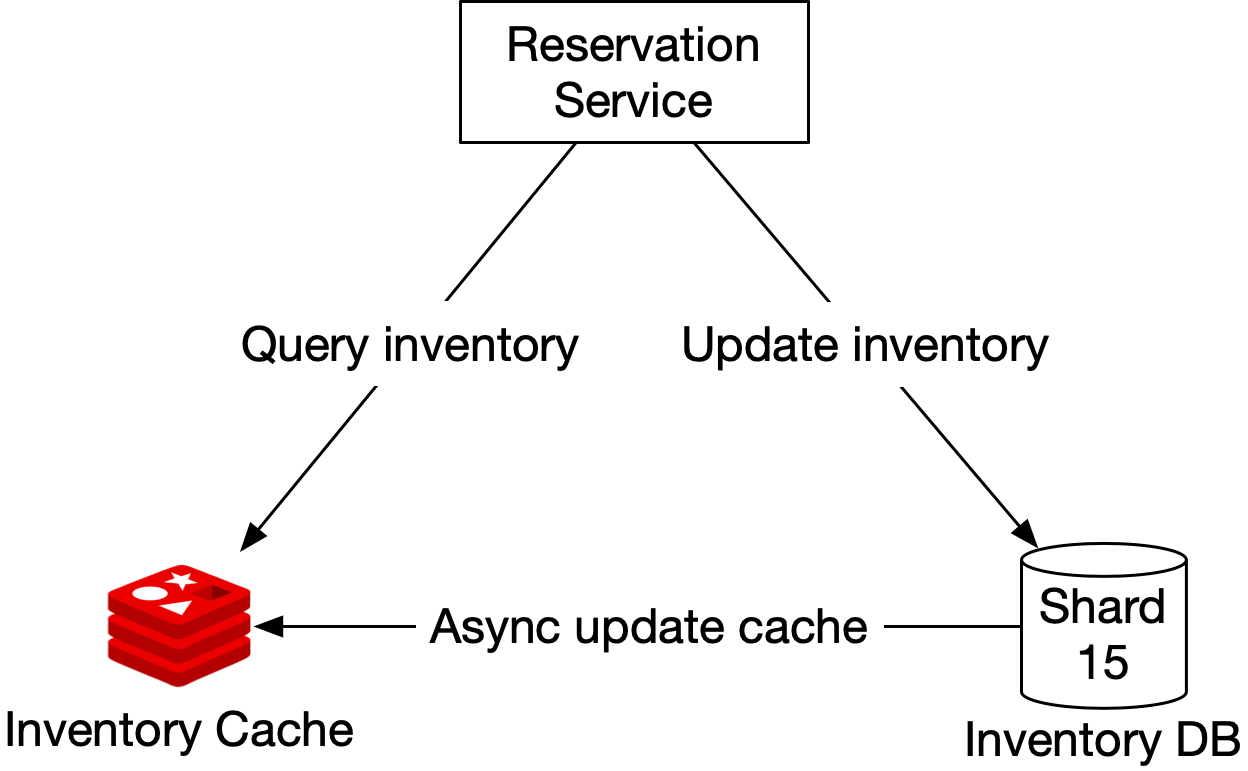
Рисунок 16 Caching
Коротко пройдемся по components.
Reservation service: поддерживает следующие inventory management APIs:
-
Запрос числа доступных rooms для заданных
hotel ID,room typeиdate range. -
Reservation room через операцию
total_reserved + 1. -
Обновление inventory, когда user отменяет reservation.
Inventory cache: все inventory management query operations выносятся в inventory cache (Redis), и inventory data туда нужно заранее pre-populate. Cache — это key-value store со следующей структурой:
key: hotelID_roomTypeID_{date}
value: the number of available rooms for the given hotel ID, room type ID and date.
Для hotel reservation system объем read operations (check room inventory) на порядок выше, чем write operations. Большая часть reads обслуживается cache.
Inventory DB: хранит inventory data как source of truth.
Новые сложности, которые приносит cache
Добавление cache layer сильно увеличивает scalability и throughput, но одновременно вносит новую сложность: как поддерживать data consistency между database и cache.
Когда user book-ит room, в happy path выполняются две операции:
-
Query room inventory, чтобы понять, остались ли rooms. Этот query идет в Inventory cache.
-
Update inventory data. Сначала обновляется Inventory DB, а затем change асинхронно распространяется в cache. Такой async cache update может выполняться application code после успешного сохранения в database. Либо propagation можно строить через change data capture (CDC) [8]. CDC — это механизм, который читает data changes из database и переносит их в другую data system. Один из популярных вариантов — Debezium [9]. Он использует source connector, чтобы читать changes из database и применять их к cache solutions вроде Redis [10].
Поскольку inventory сначала обновляется в database, есть шанс, что cache какое-то время не отражает актуальные inventory data. Например, cache может говорить, что еще есть room, тогда как database уже знает, что room закончились. Возможна и обратная ситуация.
Если подумать внимательно, inconsistency между inventory cache и database не так уж страшна, если database делает финальную inventory validation.
Рассмотрим пример. Пусть cache говорит, что свободная room еще есть, а database говорит, что нет. Тогда user проверяет inventory, видит доступность и пытается забронировать room. Когда request доходит до inventory database, database проводит validation и обнаруживает, что room больше нет. В этом случае client получает ошибку, что кто-то только что забронировал последнюю room. Если user обновит страницу, скорее всего он уже увидит, что room закончились, потому что database успела синхронизировать inventory data в cache.
Плюсы
-
Снижается нагрузка на database. Так как read queries обслуживаются cache layer, database load заметно уменьшается.
-
Высокая performance. Read queries очень быстрые, потому что results берутся из memory.
Минусы
- Поддерживать consistency между database и cache сложно. Нужно аккуратно оценить, как такая inconsistency влияет на user experience.
Data consistency между services
В традиционной monolithic architecture [11] shared relational database помогает обеспечивать data consistency. В нашем microservice design мы выбрали hybrid approach: Reservation Service обрабатывает и reservation APIs, и inventory APIs, так что reservation и inventory tables хранятся в одной и той же relational database. Как уже обсуждалось в разделе “Concurrency issues”, это позволяет аккуратно использовать ACID properties relational database и элегантно решать многие concurrency problems reservation flow.
Но если интервьюер — сторонник “чистых” microservices, он может возразить против такого hybrid approach. В его представлении каждая microservice должна иметь собственную database, как справа на рисунке 17.
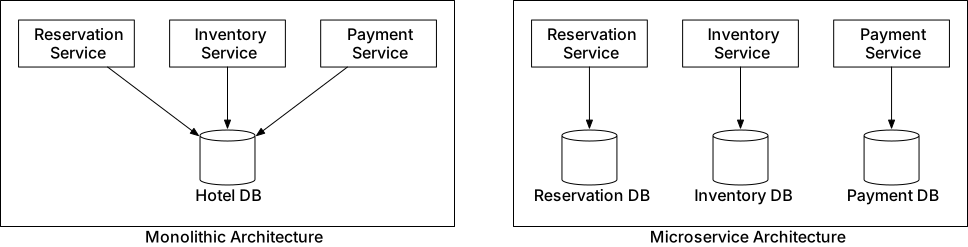
Рисунок 17 Monolithic vs microservice
Такой “чистый” design порождает много data consistency issues. Поскольку это первый раз, когда мы здесь обсуждаем microservices, поясним, как и почему это происходит. Чтобы было проще понимать, в обсуждении используются только два services. В реальном мире у компании их могут быть сотни.
В monolithic architecture, как на рисунке 18, разные operations можно завернуть в одну transaction и тем самым обеспечить ACID properties.

Рисунок 18 Monolithic architecture
Однако в microservice architecture у каждого service своя database. Одна логически атомарная operation может затрагивать несколько services. А значит, мы уже не можем использовать одну transaction для consistency. Как показано на рисунке 19, если update operation не удалась в reservation database, нужно откатить increment reserved room count в inventory database. В целом happy path у нас один, а вот failure cases, приводящих к inconsistency, много.

Рисунок 19 Microservice architecture
Чтобы решать проблему data inconsistency, можно опереться на несколько industry-proven techniques. Если хочется деталей, они есть в reference materials.
-
Two-phase commit (2PC) [12]. Это database protocol, который гарантирует atomic transaction commit на нескольких nodes: либо succeed-ят все, либо fail-ят все. Но 2PC — blocking protocol, поэтому failure одного node блокирует progress до восстановления. С точки зрения performance это не лучший вариант.
-
Saga. Saga — это последовательность local transactions. Каждая transaction делает update и публикует message, который запускает следующий шаг transaction chain. Если какой-то шаг fail-ится, saga запускает compensating transactions, чтобы откатить изменения предыдущих шагов [13]. В отличие от 2PC, который пытается дать единый ACID commit, Saga разбивает flow на несколько шагов и полагается на eventual consistency.
Важно заметить: решение проблемы data inconsistency между microservices требует довольно сложных mechanisms, а это заметно увеличивает общую сложность design. Здесь уже задача архитектора — решить, стоит ли эта дополнительная сложность выигрыша. Для данной задачи мы считаем, что нет, и поэтому выбираем более прагматичный подход: хранить reservation и inventory data в одной relational database.
Шаг 4 — Итоги
В этой главе мы спроектировали hotel reservation system. Сначала собрали requirements и сделали back-of-the-envelope estimation, чтобы понять масштаб. В high-level design обсудили API design, первую версию data model и architecture diagram. В deep dive мы пересмотрели schema design, когда стало ясно, что reservation нужно делать на уровне room type, а не конкретной комнаты. Затем подробно разобрали race conditions и предложили несколько решений:
-
pessimistic locking
-
optimistic locking
-
database constraints
После этого мы обсудили, как масштабировать систему, включая database sharding и Redis cache. Наконец, затронули проблемы data consistency в microservice architecture и кратко прошлись по нескольким способам их решать.
Поздравляю, вы дошли так далеко. Можно похлопать себе по плечу — хорошая работа.
Краткое содержание главы
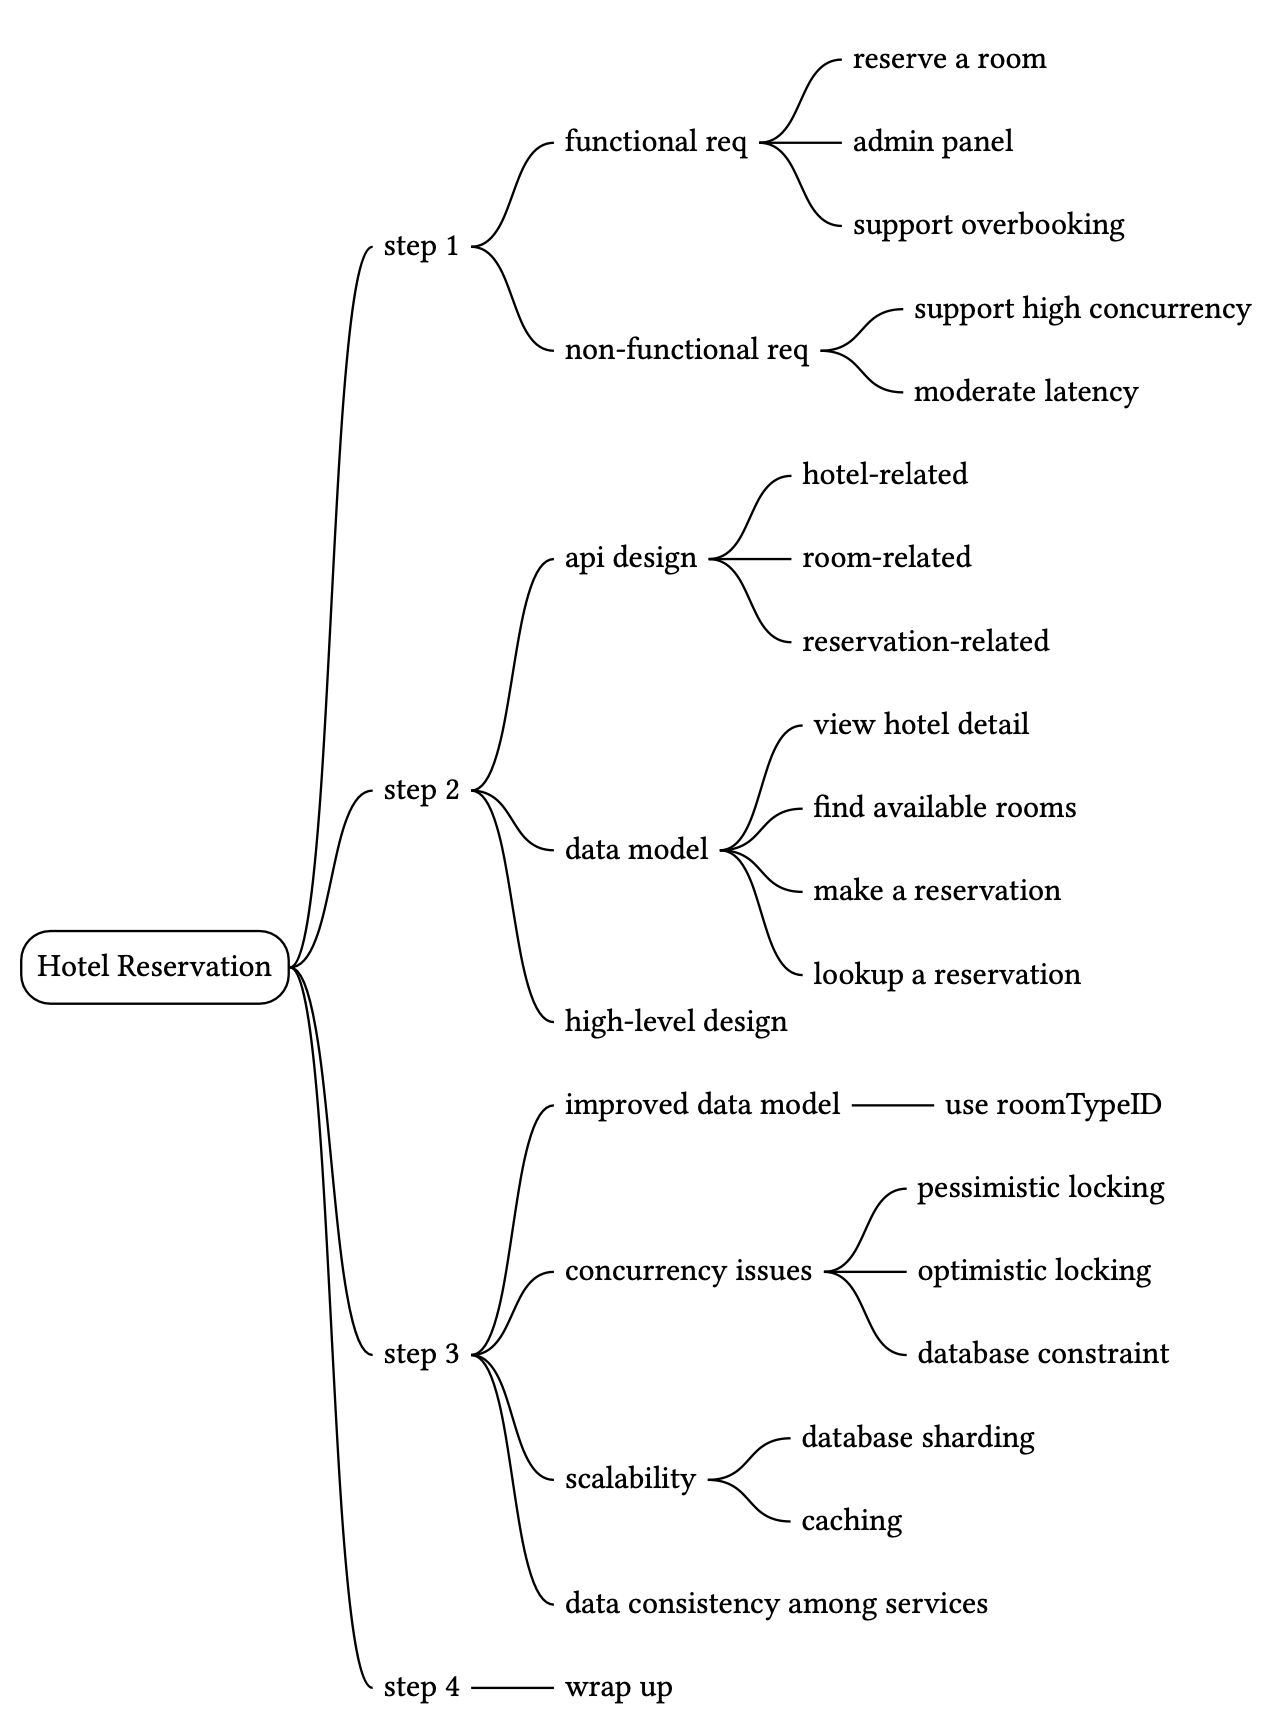
Краткое содержание главы
Reference Material
[1] Microservices: https://en.wikipedia.org/wiki/Microservices
[2] What Are The Benefits of Microservices Architecture?:
https://www.appdynamics.com/topics/benefits-of-microservices
[3] gRPC: https://www.grpc.io/docs/what-is-grpc/introduction/
[4] Source: Booking.com iOS app
[5] Serializability: https://en.wikipedia.org/wiki/Serializability
[6] Optimistic and pessimistic record locking: https://www.ibm.com/docs/en/rational-clearquest/10.0.7?topic=clearquest-optimistic-pessimistic-record-locking
[7] Optimistic concurrency control: https://en.wikipedia.org/wiki/Optimistic_concurrency_control
[8] Change data capture: https://docs.oracle.com/cd/B10500_01/server.920/a96520/cdc.htm
[9] Debezium: https://debezium.io/
[10] Redis sink: https://debezium.io/documentation/reference/stable/operations/debezium-server.html
[11] Monolithic Architecture: https://microservices.io/patterns/monolithic.html
[12] Two-phase commit protocol: https://en.wikipedia.org/wiki/Two-phase_commit_protocol