Распределенный почтовый сервис
В этой главе мы спроектируем large-scale email service, похожий на Gmail, Outlook или Yahoo Mail. Рост интернета привел к взрывному росту объема email. В 2020 году у Gmail было более 1.8 млрд active users, а у Outlook — более 400 млн пользователей по всему миру [1] [2].
Рисунок 1 Популярные email providers
Шаг 1 — Понять задачу и определить рамки дизайна
За годы email services сильно выросли и по сложности, и по масштабу. Современный email service — это сложная система с большим числом features. Реальную production-систему невозможно спроектировать за 45 минут, поэтому сначала нужно сузить scope с помощью уточняющих вопросов.
Кандидат: Сколько людей пользуются продуктом?
Интервьюер: Один миллиард users.
Кандидат: Думаю, важны следующие features:
-
Authentication
-
Send и receive emails
-
Fetch all emails
-
Filter emails по read и unread status
-
Search emails по
subject,senderиbody -
Anti-spam и anti-virus
Интервьюер: Хороший список. Authentication можно не учитывать. Давай сосредоточимся на остальных features.
Кандидат: Как users подключаются к mail servers?
Интервьюер: Традиционно users подключаются к mail servers через native clients, которые
используют SMTP, POP, IMAP и vendor-specific protocols. Эти protocols уже в какой-то степени
legacy, но все еще очень популярны. Для этого интервью предположим, что для client-server
communication используется HTTP.
Кандидат: Могут ли у emails быть attachments?
Интервьюер: Да.
Нефункциональные требования
Дальше пройдемся по самым важным non-functional requirements.
Reliability. Мы не должны терять email data.
Availability. Email и user data должны автоматически реплицироваться между несколькими nodes, чтобы обеспечивать availability. Кроме того, система должна продолжать работать даже при частичных failures.
Scalability. По мере роста числа users система должна справляться с ростом числа users и emails. Performance не должна деградировать просто из-за увеличения объема данных.
Flexibility и extensibility. Гибкая/расширяемая система позволяет легко добавлять новые features или повышать performance за счет новых components. Традиционные email protocols вроде POP и IMAP очень ограничены по функциональности, поэтому нам могут понадобиться custom protocols, если мы хотим добиться нужной flexibility и extensibility.
Back-of-the-envelope estimation
Сделаем грубую оценку, чтобы понять масштаб и заранее увидеть ключевые challenges. По своей природе email systems очень storage-heavy.
-
1 миллиард users
-
Предположим, что в среднем один человек отправляет 10 emails в день. Тогда QPS для sending emails =
10^9 * 10 / 10^5 = 100,000 -
Предположим, что в среднем человек получает 40 emails в день [3], а средний размер email metadata равен 50KB. Metadata — это все, что связано с email, кроме attachment files.
-
Предположим, metadata хранится в database. Storage для metadata за 1 год:
1 миллиард users * 40 emails / day * 365 days * 50 KB = 730 PB -
Предположим, что 20% emails содержат attachment, а средний размер attachment — 500KB.
-
Storage для attachments за 1 год:
1 миллиард users * 40 emails / day * 365 days * 20% * 500 KB = 1,460 PB
Из этих расчетов видно, что данных будет очень много. Значит, почти наверняка нам понадобится distributed database solution.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
В этом разделе сначала кратко разберем email basics и то, как mail servers эволюционировали со временем. Затем посмотрим на high-level design distributed email servers. Структура такая:
-
Email knowledge 101
-
Traditional mail servers
-
Distributed mail servers
Email knowledge 101
Существует несколько email protocols, используемых для отправки и получения emails. Исторически большинство mail servers опирались на POP, IMAP и SMTP.
Email protocols
SMTP: Simple Mail Transfer Protocol (SMTP) — стандартный protocol для отправки emails от одного mail server к другому.
Самые популярные protocols для получения emails — Post Office Protocol (POP) и Internet Mail Access Protocol (IMAP).
POP — стандартный mail protocol для получения и скачивания emails с remote mail server на local email client. После download письма удаляются с email server, а значит, получить доступ к ним можно только с одного устройства. POP описан в RFC 1939 [4]. POP требует скачивать email целиком, поэтому это может занимать много времени, если внутри большой attachment.
IMAP — тоже стандартный mail protocol для получения emails в local email client. Когда вы читаете письмо, вы подключены к внешнему mail server, и данные передаются на локальное устройство. IMAP скачивает сообщение только когда вы по нему кликаете, и emails не удаляются с server, поэтому их можно читать с нескольких устройств. Для individual email accounts IMAP — самый распространенный protocol. Он особенно удобен на медленном соединении, потому что до открытия письма скачиваются только header fields.
HTTPS технически не является mail protocol, но его можно использовать для доступа к mailbox, особенно в webmail. Например, Microsoft Outlook часто общается с mobile devices по HTTPS через custom protocol под названием ActiveSync [5].
Domain name service (DNS)
DNS server используется, чтобы найти mail exchanger record (MX record) для domain адресата. Если
сделать DNS lookup для gmail.com из command line, можно увидеть MX records как на рисунке 2.
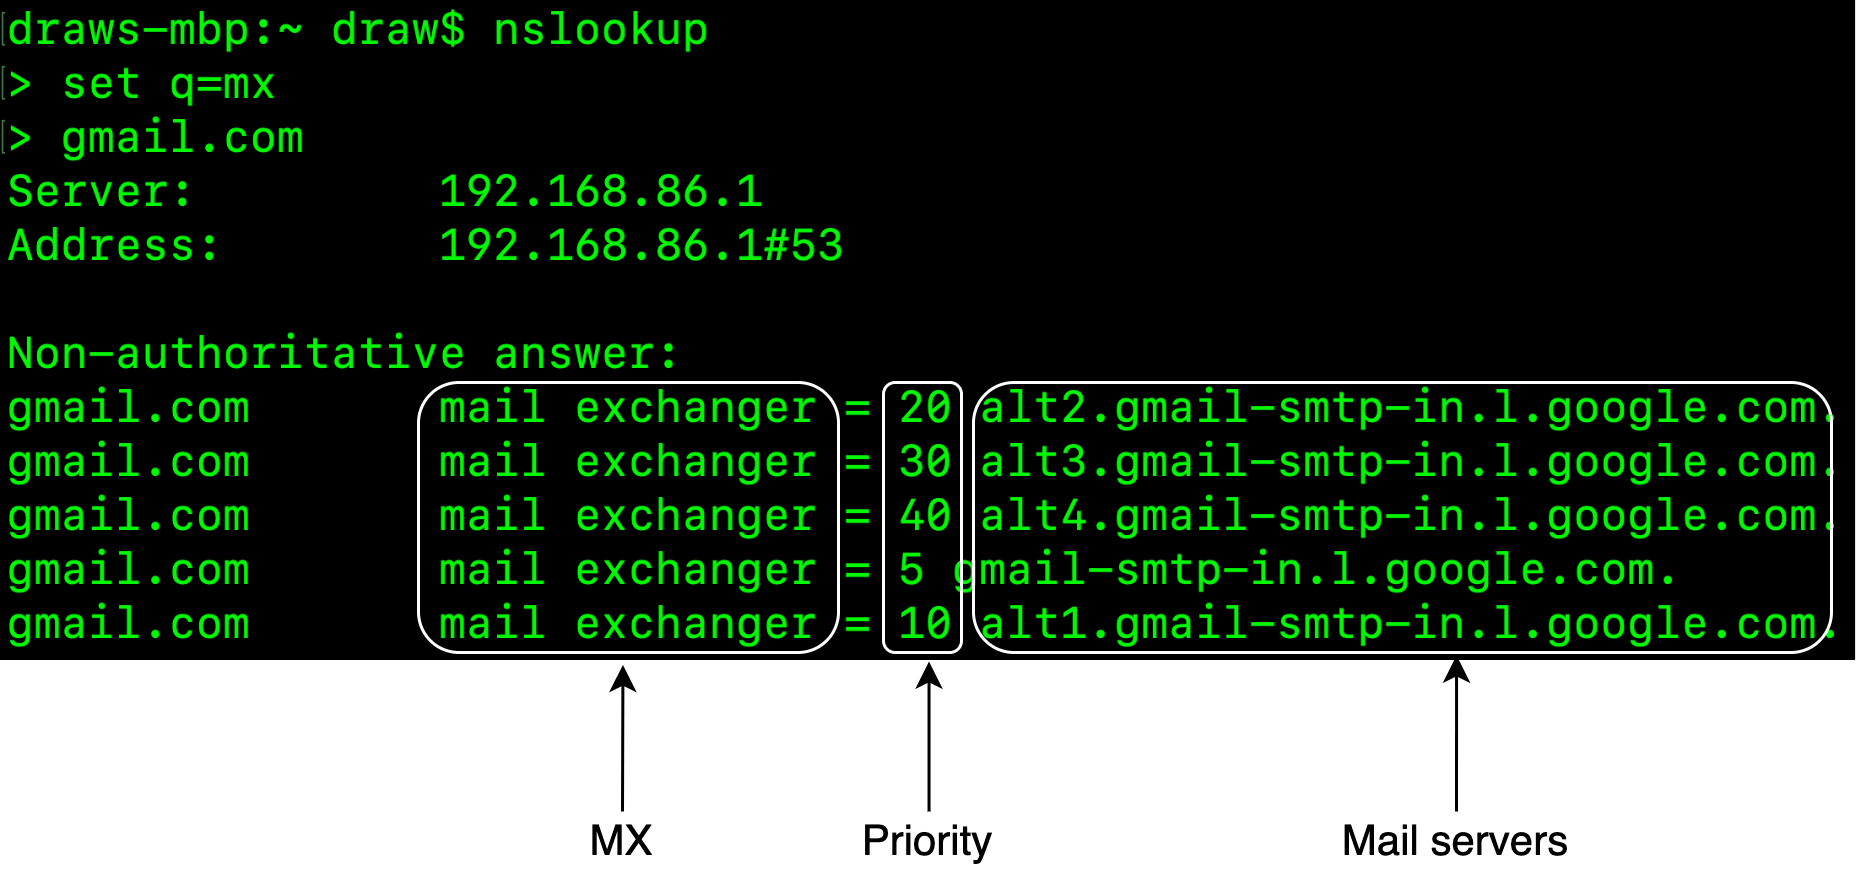
Рисунок 2 MX records
Числа priority показывают предпочтительность: чем меньше число, тем более предпочтителен mail
server. На рисунке 2 gmail-smtp-in.l.google.com используется первым (priority 5). Sending
mail server сначала попытается отправить письмо именно туда. Если connection fail-ится, он
переключится на server со следующим по величине приоритетом, например
alt1.gmail-smtp-in.l.google.com (priority 10).
Attachment
Email attachment отправляется вместе с email message, чаще всего в Base64 encoding [6]. У attachments обычно есть size limit. Например, Outlook и Gmail по состоянию на июнь 2021 ограничивали attachments 20MB и 25MB соответственно. Это значение highly configurable и различается между личными и корпоративными accounts. Multipurpose Internet Mail Extension (MIME) [7] — это спецификация, позволяющая передавать attachments через интернет.
Traditional mail servers
Прежде чем переходить к distributed mail servers, полезно немного посмотреть в историю и понять, как работали traditional mail servers. Это дает хорошие lessons о том, как затем масштабировать email system. Traditional mail server можно воспринимать как систему для небольшого числа users, обычно работающую на одном server.
Traditional mail server architecture
На рисунке 3 показано, что происходит, когда Alice отправляет email Bob-у через traditional mail servers.
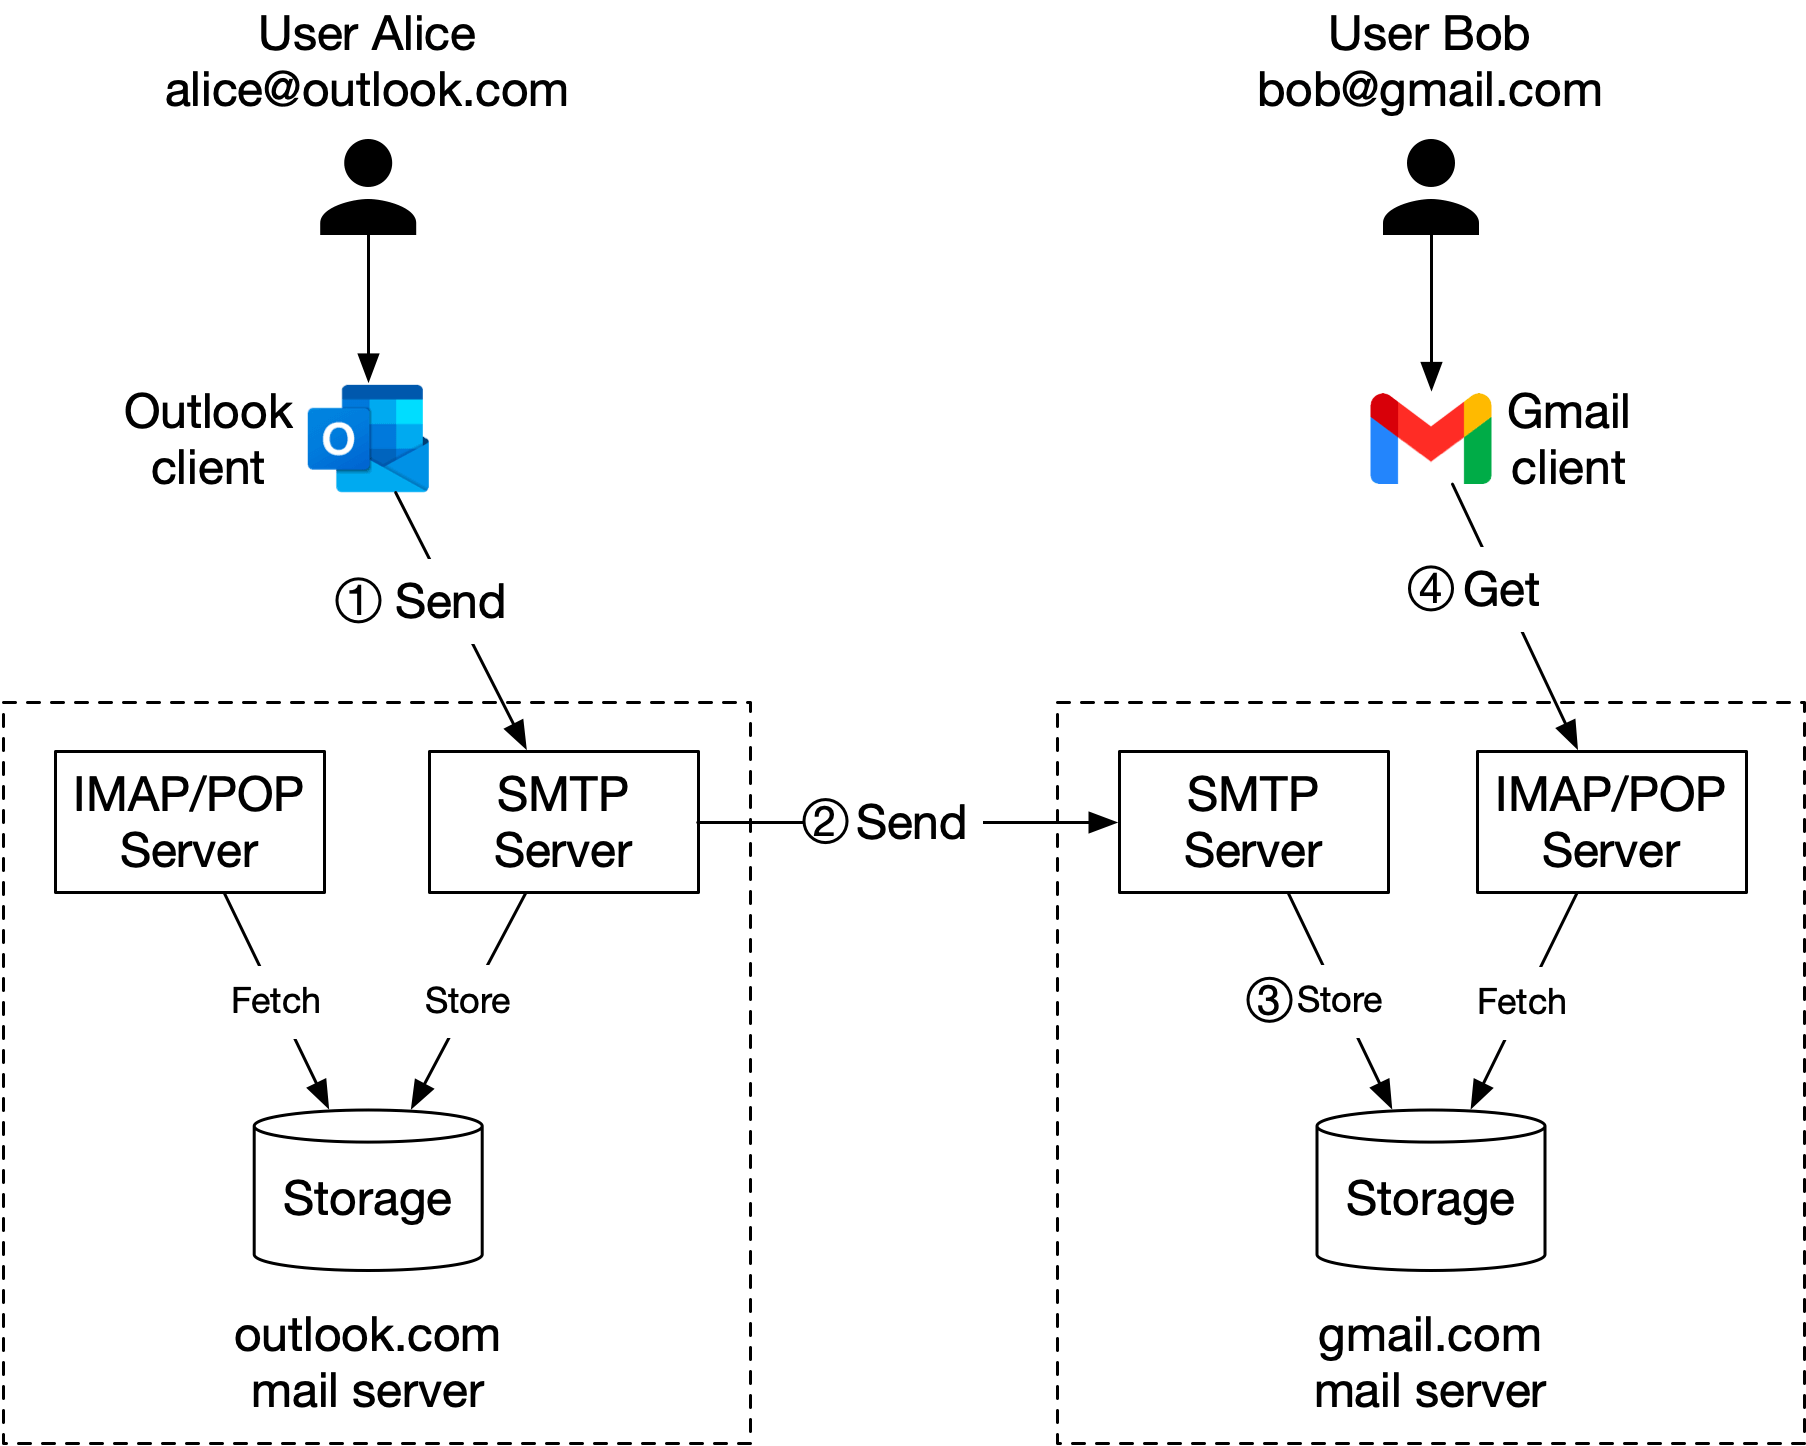
Рисунок 3 Traditional mail servers
Процесс состоит из 4 шагов:
-
Alice логинится в Outlook client, пишет email и нажимает
send. Письмо отправляется на Outlook mail server. Между client и mail server используется SMTP. -
Outlook mail server делает DNS lookup, чтобы найти адрес SMTP server получателя. В этом случае это Gmail SMTP server. После этого email передается на Gmail mail server. Между mail servers тоже используется SMTP.
-
Gmail server сохраняет email и делает его доступным для Bob.
-
Gmail client получает новые emails через IMAP/POP server, когда Bob логинится в Gmail.
Storage
В traditional mail server emails хранились в локальных file directories, причем каждый email лежал в отдельном file с уникальным именем. Каждый user имел свой directory для configuration data и mailboxes. Популярным способом хранения считался Maildir (рисунок 4).

Рисунок 4 Maildir
File directories хорошо работали при маленькой user base, но retrieval и backup миллиардов emails становились очень сложными. По мере роста email volume и усложнения file structure disk I/O становился bottleneck. Кроме того, локальные directories не удовлетворяют требованиям по high availability и reliability: disks могут ломаться, servers — падать. Значит, нам нужен более надежный distributed storage layer.
Email functionality прошла длинный путь с 1960-х — от текста к multimedia, threading [8], search, labels и т. д. Но сами protocols (POP, IMAP, SMTP) были придуманы очень давно. Они не проектировались ни под эти новые features, ни под scale в миллиарды users.
Distributed mail servers
Distributed mail servers нужны, чтобы поддерживать современные use cases и решать проблемы scale и resiliency. В этом разделе рассмотрим email APIs, distributed email server architecture, а также flows отправки и получения emails.
Email APIs
Понятие email APIs может означать очень разные вещи для разных mail clients и на разных этапах жизненного цикла email. Например:
-
SMTP/POP/IMAP APIs для native mobile clients
-
SMTP communications между sender и receiver mail servers
-
RESTful API поверх HTTP для full-featured webmail applications
Из-за ограничений по размеру главы мы разберем только часть наиболее важных APIs для webmail. Обычный вариант связи webmail с backend — через HTTP.
1. Endpoint: POST /v1/messages
Отправляет message адресатам из заголовков To, Cc и Bcc.
2. Endpoint: GET /v1/folders
Возвращает все folders email account.
Response:
[{id: string        Unique folder identifier.
  name: string      Name of the folder.
                    Согласно RFC6154 [9], default folders могут быть:
                    All, Archive, Drafts, Flagged, Junk, Sent,
                    и Trash.
  user_id: string   Reference to the account owner
}]
3. Endpoint: GET /v1/folders/{:folder_id}/messages
Возвращает все messages внутри folder. Это сильно упрощенный API. В реальности он обязательно должен поддерживать pagination.
Response:
Список message objects.
4. Endpoint: GET /v1/messages/{:message_id}
Возвращает всю информацию о конкретном message. Messages — базовые building blocks любой email application: sender, recipients, subject, body, attachments и т. д.
Response:
Объект message.
{
  user_id: string                      // Reference to the account owner.
  from: {name: string, email: string}  // <name, email> pair of the sender.
  to: [{name: string, email: string}]  // List of <name, email> pairs
  subject: string                      // Subject of an email
  body: string                         // Message body
  is_read: boolean                     // Indicates whether the message is read
}
Distributed mail server architecture
Хотя поднять email server для малого числа users несложно, масштабировать его дальше одного server трудно. Главная причина в том, что traditional mail servers были рассчитаны именно на single server. Синхронизация data между servers получается сложной, а еще очень непросто сделать так, чтобы recipient mail servers не классифицировали ваши emails как spam. В этом разделе посмотрим, как cloud technologies помогают с этим справиться. High-level design показан на рисунке 5.
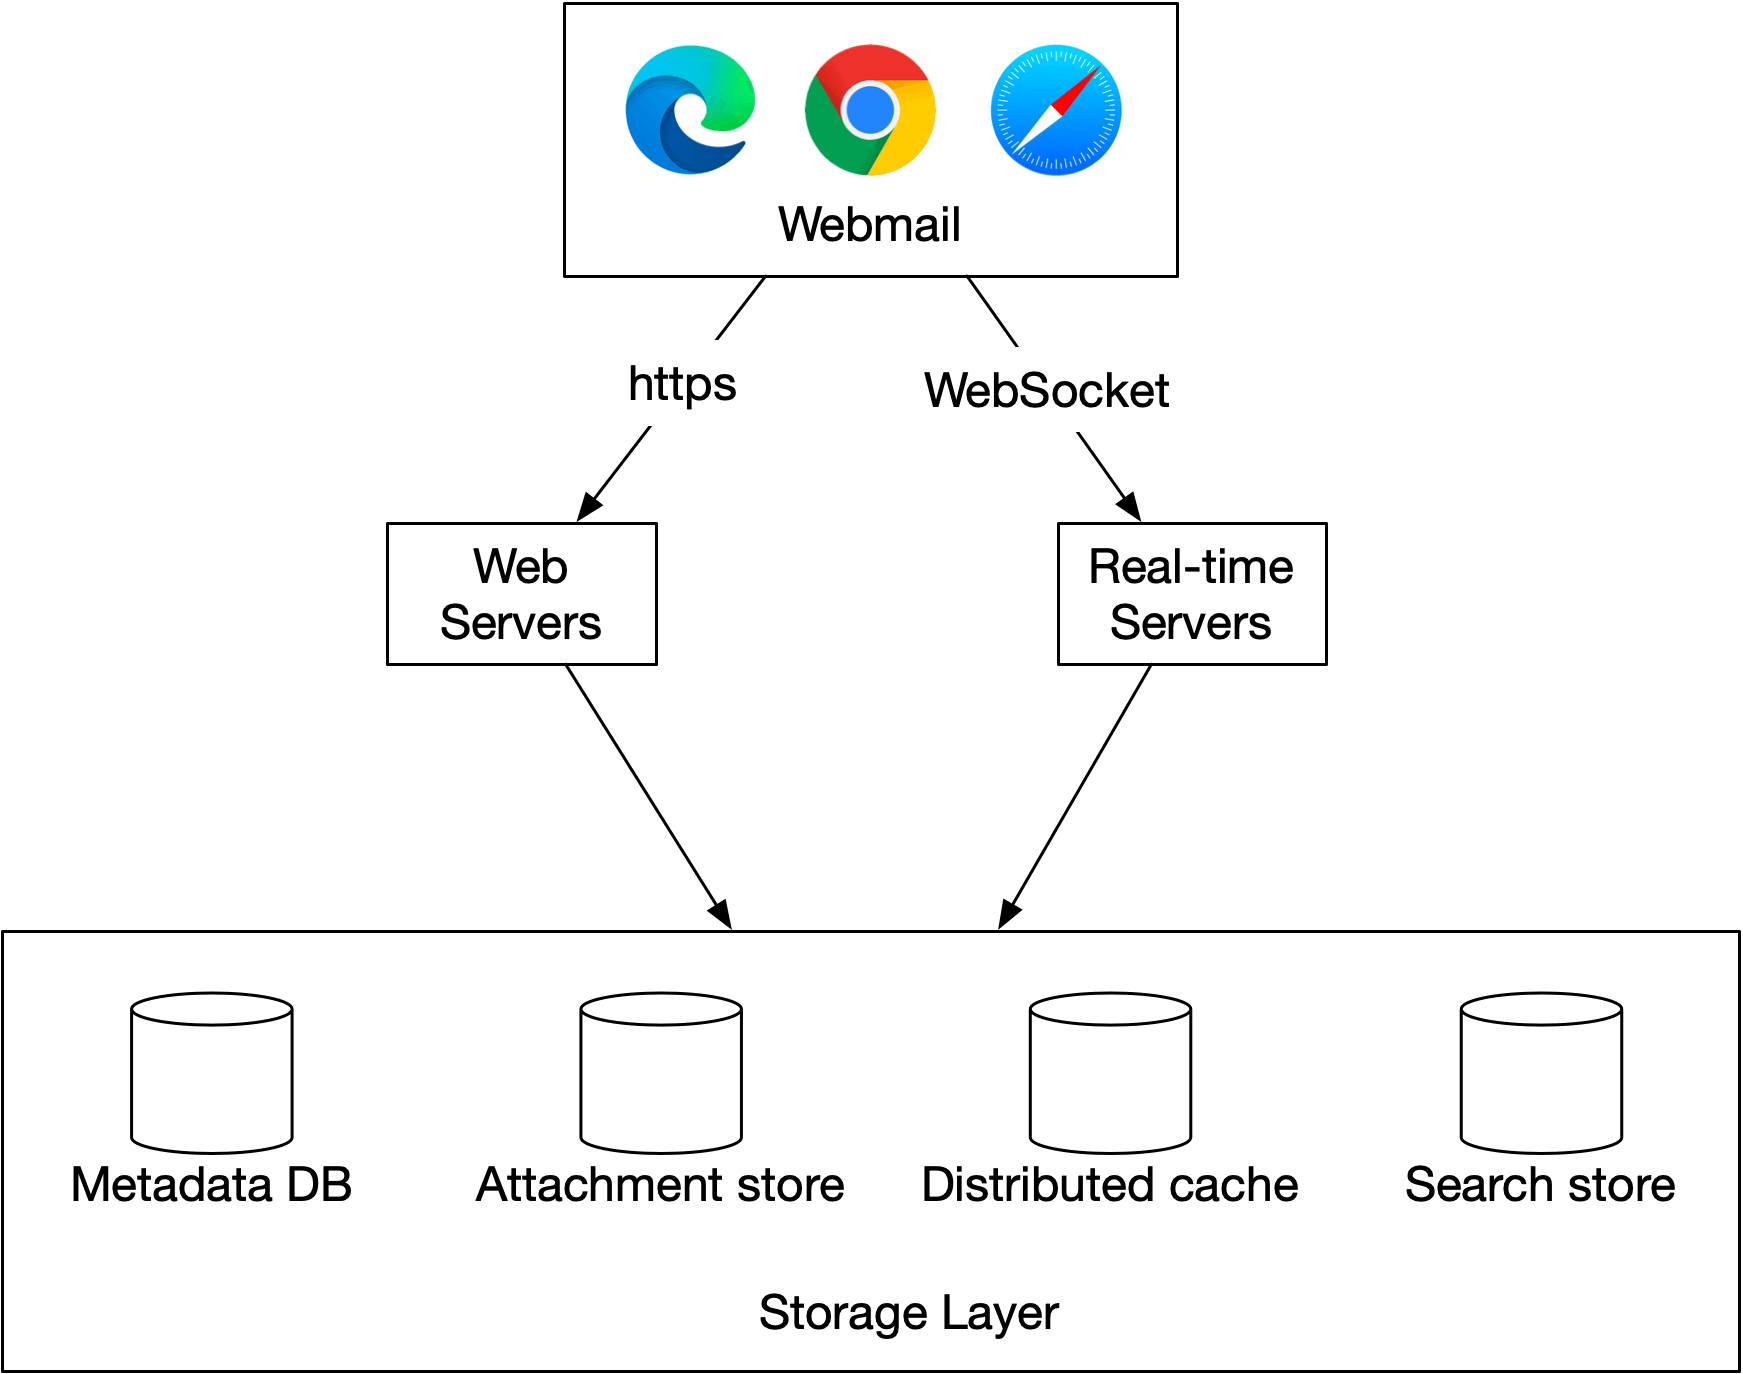
Рисунок 5 High-level design
Посмотрим на components по отдельности.
Webmail. Users используют web browsers для отправки и получения emails.
Web servers. Web servers — это public-facing request/response services для login, signup, user profile и т. д. В нашем design через web servers проходят все email APIs: отправка email, загрузка folders, загрузка всех писем в folder и т. д.
Real-time servers. Real-time servers отвечают за push обновлений о новых письмах клиентам в real-time. Это stateful servers, потому что им нужно держать persistent connections. Для real-time communication у нас есть варианты: long polling и WebSocket. WebSocket — более элегантное решение, но его минусом может быть browser compatibility. Практичный подход: использовать WebSocket, когда возможно, и long-polling как fallback.
Пример реальной системы — Apache James [10], который реализует JSON Meta Application Protocol (JMAP) subprotocol поверх WebSocket [11].
Metadata database. Здесь хранится mail metadata: subject, body, sender, recipients и т. д. Выбор database обсудим глубже в deep dive section.
Attachment store. Для attachments мы выбираем object stores, например Amazon S3. S3 хорошо масштабируется и подходит для больших files — images, videos, documents и т. д. Размер attachments может доходить до 25MB. NoSQL column-family databases вроде Cassandra здесь не очень подходят по двум причинам:
-
Хотя Cassandra поддерживает
blob, теоретический максимум 2GB, но practical limit заметно меньше 1MB [12]. -
Если складывать attachments в Cassandra, нельзя эффективно использовать row cache, потому что attachments занимают слишком много memory.
Distributed cache. Поскольку client постоянно перечитывает самые свежие emails, кэширование recent emails в memory сильно ускоряет loading time. Здесь подойдет Redis, потому что он дает удобные структуры данных вроде lists и его легко масштабировать.
Search store. Search store — это distributed document store. Он использует inverted index [13] для очень быстрого full-text search. Подробнее об этом позже.
Теперь, когда основные components понятны, соберем два главных workflows:
-
Email sending flow
-
Email receiving flow
Email sending flow
Email sending flow показан на рисунке 6.
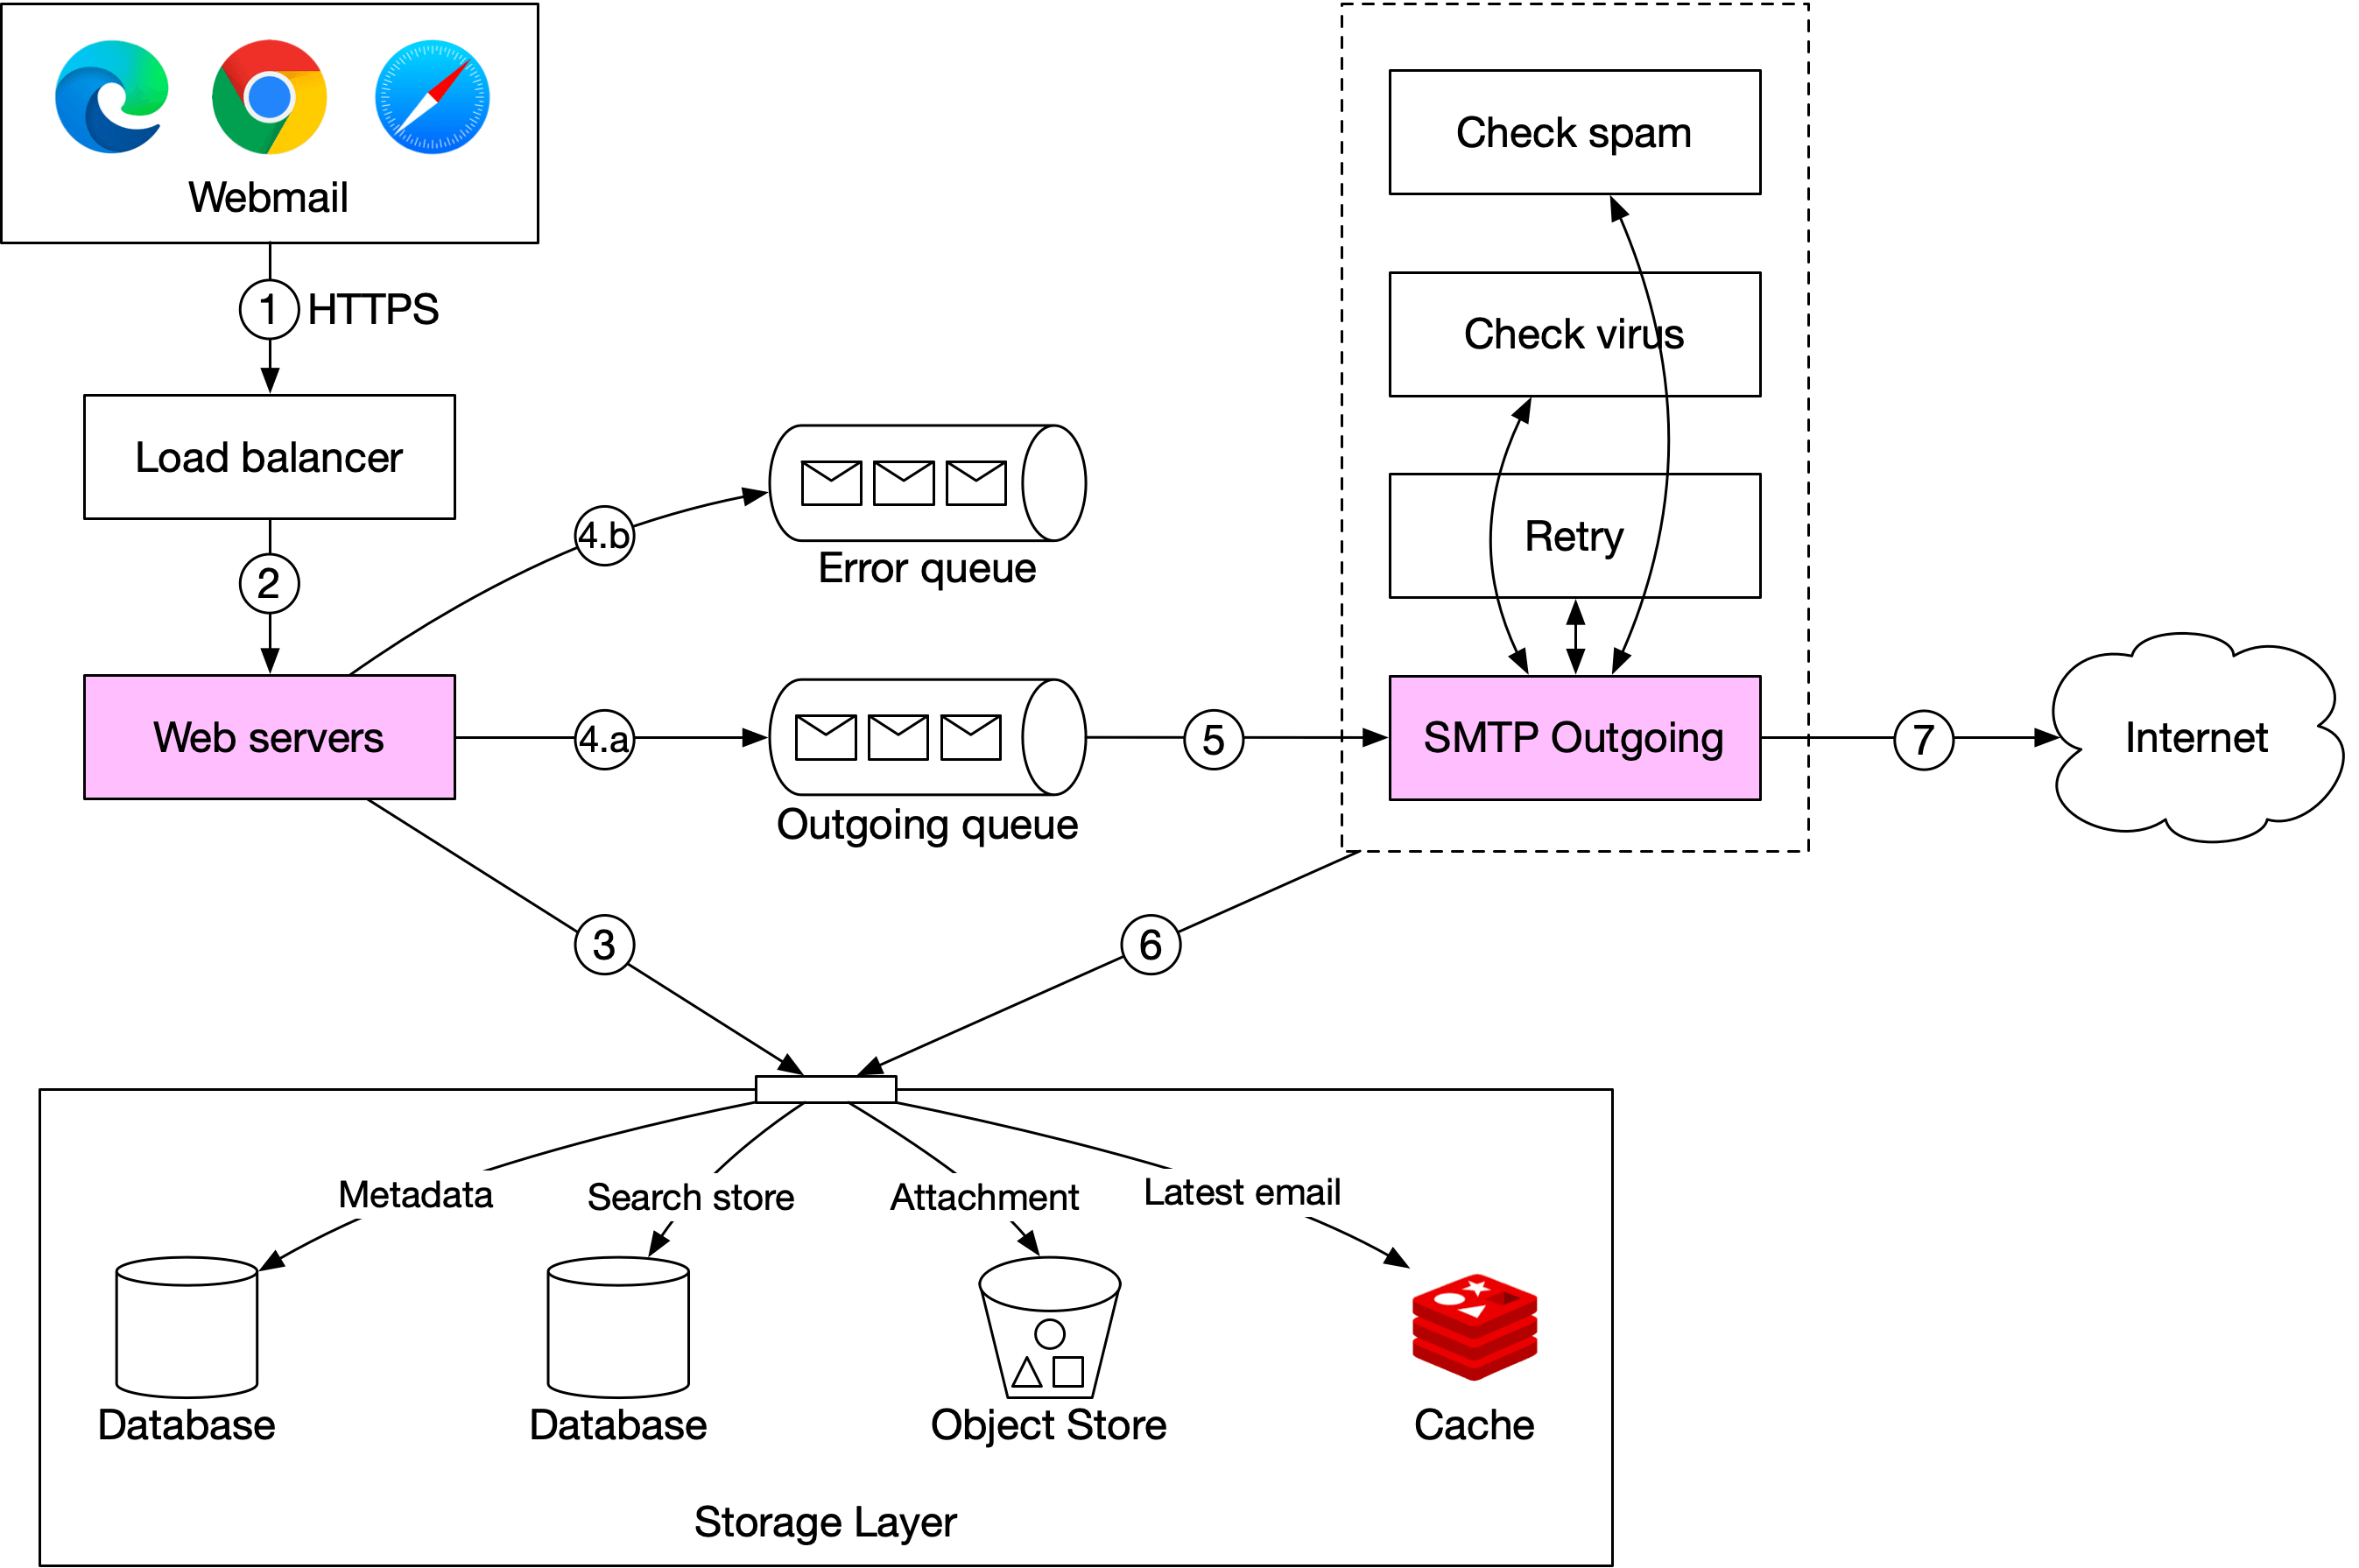
Рисунок 6 Email sending flow
-
User пишет email в webmail и нажимает
send. Request уходит на load balancer. -
Load balancer проверяет rate limit и маршрутизирует traffic на web servers.
-
Web servers отвечают за:
3a. Базовую email validation. Каждое incoming письмо проверяется по pre-defined rules, например по size limit.
3b. Проверку, совпадает ли domain у recipient email address с sender domain. Если совпадает, web server проверяет, что email data не содержит spam и viruses. Если все в порядке, email помещается в
Sent Folderотправителя иInbox Folderполучателя. Recipient сможет получить письмо напрямую через RESTful API. Переход к step 4 в этом case не нужен. -
Message queues.
4a. Если basic validation успешна, email data отправляется в outgoing queue. Если attachment слишком большой для queue, можно положить attachment в object store, а в queued message сохранить только object reference.
4b. Если basic validation failed, email уходит в error queue.
-
SMTP outgoing workers читают messages из outgoing queue и дополнительно убеждаются, что emails не содержат spam и viruses.
-
Outgoing email сохраняется в
Sent Folderвнутри storage layer. -
SMTP outgoing workers отправляют email на recipient mail server.
Каждое message в outgoing queue содержит всю metadata, необходимую для создания email. Distributed message queue — критически важный component, потому что позволяет делать mail processing asynchronously. Развязав SMTP outgoing workers и web servers, мы можем масштабировать outgoing workers независимо.
За размером outgoing queue нужно следить очень внимательно. Если emails начинают застревать в queue, нужно разбирать причину. Вот возможные причины:
-
Recipient mail server недоступен. Тогда надо retry-ить отправку позже. Хорошая стратегия — exponential backoff [14].
-
Недостаточно consumers для отправки emails. В этом случае нужно увеличивать число consumers.
Email receiving flow
Следующая диаграмма показывает email receiving flow.
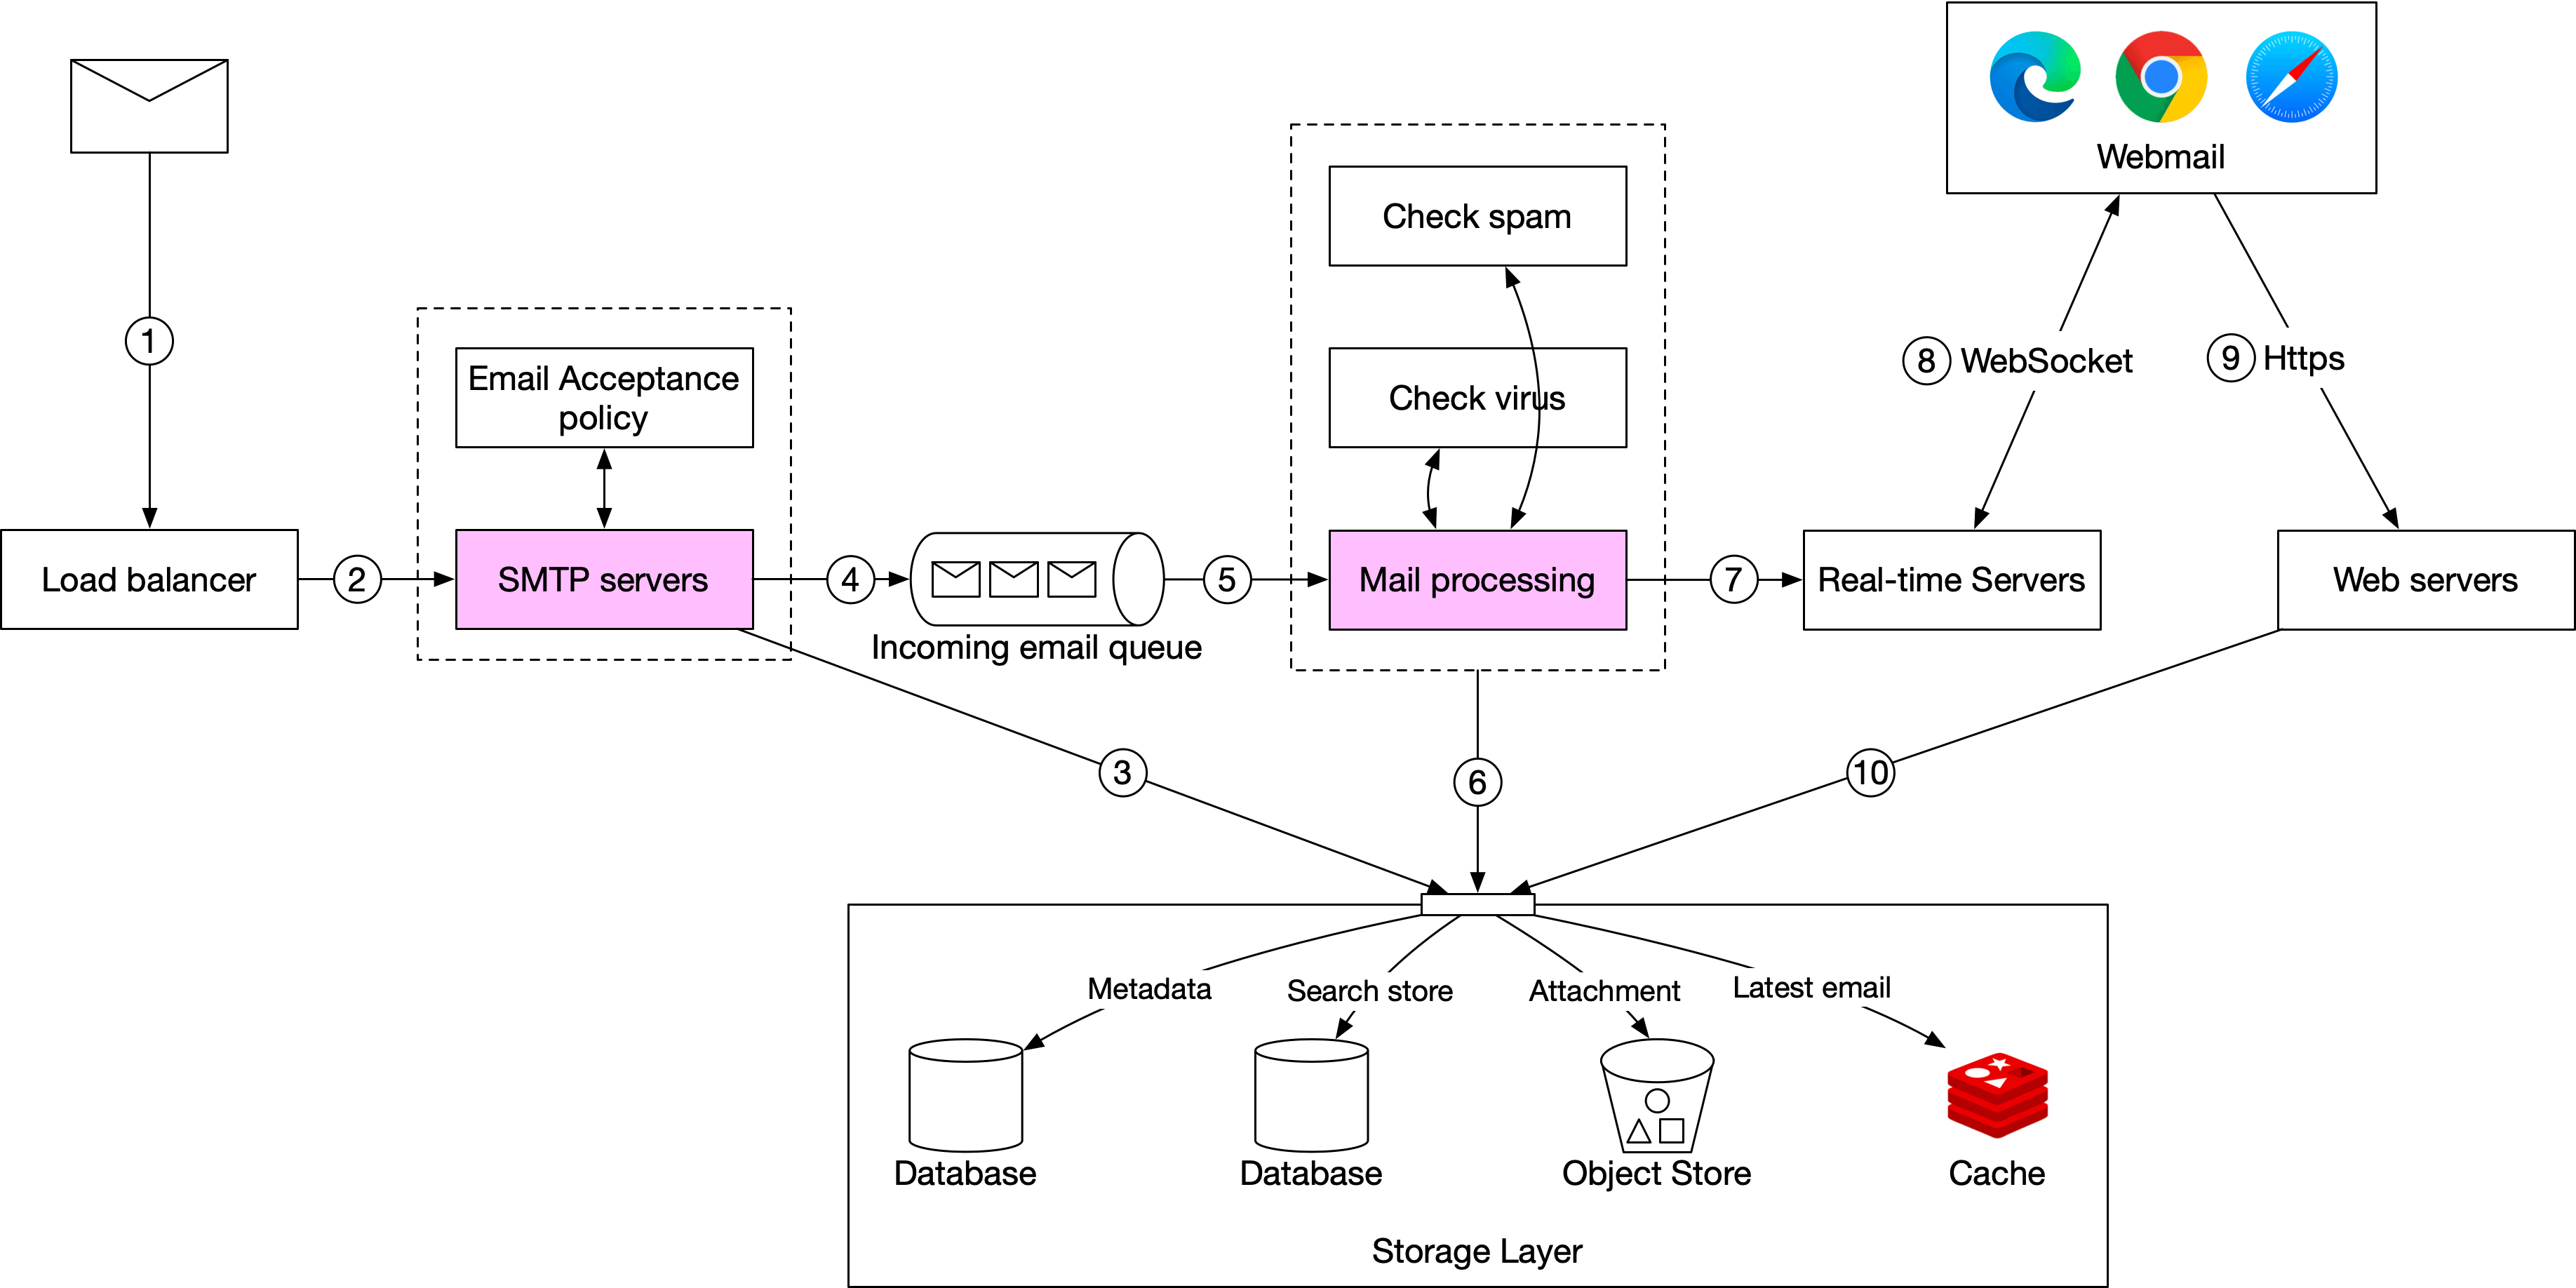
Рисунок 7 Email receiving flow
-
Incoming emails приходят на SMTP load balancer.
-
Load balancer распределяет traffic между SMTP servers. Email acceptance policy можно конфигурировать и применять уже на уровне SMTP connection. Например, invalid emails можно bounce-ить сразу, чтобы не тратить ресурсы на лишнюю обработку.
-
Если attachment слишком большой для queue, его можно положить в attachment store (S3).
-
Emails помещаются во incoming email queue. Queue развязывает SMTP servers и mail processing workers, чтобы их можно было масштабировать независимо. Кроме того, queue служит buffer на случай spikes email volume.
-
Mail processing workers отвечают за множество задач: spam filtering, virus blocking и т. д. Ниже предполагается, что письмо прошло validation.
-
Email сохраняется в mail storage, cache и object data store.
-
Если receiver сейчас online, email push-ится на real-time servers.
-
Real-time servers — это WebSocket servers, позволяющие clients получать новые emails в real-time.
-
Для offline users письма просто сохраняются в storage layer. Когда user снова online, webmail client подключается к web servers через RESTful API.
-
Web servers достают новые emails из storage layer и возвращают их client.
Шаг 3 — Погружение в детали дизайна
Теперь, когда все части email server уже обозначены, можно углубиться в ключевые components и посмотреть, как масштабировать систему.
-
Metadata database
-
Search
-
Deliverability
-
Scalability
Metadata database
В этом разделе обсудим свойства email metadata, выбор database, data model и conversation threads (как бонусный пункт).
Properties email metadata
-
Email headers обычно маленькие и часто запрашиваются.
-
Email body может быть и маленьким, и большим, но запрашивается нечасто. Обычно письмо читают один раз.
-
Большинство mail operations — fetching mails, mark as read, search — изолированы на уровне одного user. Другими словами, mails одного user доступны только ему, и все mail operations выполняются этим же user.
-
Recency сильно влияет на usage pattern. Users обычно читают самые свежие emails. 82% read queries приходятся на data младше 16 дней [15].
-
У data очень высокие требования по reliability. Data loss неприемлема.
Выбор правильной database
На масштабе Gmail или Outlook database system обычно custom-made, чтобы снижать IOPS [16], потому что именно input/output operations per second легко становятся major constraint. Выбрать database непросто, поэтому полезно пройтись по доступным вариантам.
-
Relational database. Главное искушение здесь — возможность эффективно search-ить emails через indexes по headers и body. Для простых queries это действительно быстро. Но relational databases обычно оптимизированы под сравнительно небольшие entries, а typical email может быть больше нескольких KB и легко превышать 100KB, особенно с HTML. Можно возразить, что есть BLOB, но search по неструктурированным BLOB данным неэффективен. Поэтому MySQL или PostgreSQL — не лучший fit.
-
Distributed object storage. Еще один вариант — хранить raw emails в cloud storage вроде S3. Это неплохо подходит для backup storage, но на такой базе сложно эффективно поддерживать mark as read, keyword search, threading и похожие features.
-
NoSQL databases. Google Bigtable используется в Gmail, значит это viable option. Но Bigtable не open source, и детали того, как в Gmail реализован search, неизвестны. Cassandra тоже выглядит как потенциальный вариант, хотя публичных примеров крупнейших email providers на ней немного.
Из анализа выше видно, что готовых решений, идеально закрывающих задачу, почти нет. Крупные email providers обычно строят собственные highly customized databases. В interview setting мы, конечно, не будем проектировать новую distributed database с нуля, но важно озвучить, какими свойствами она должна обладать:
-
Один column value может быть размером в single-digit MB
-
Strong data consistency
-
Дизайн, минимизирующий disk I/O
-
High availability и fault tolerance
-
Простое создание incremental backups
Data model
Один из вариантов — использовать user_id как partition key, чтобы данные одного user хранились на одном shard. Ограничение такого подхода в том, что messages не разделяются между несколькими users. Для нашей interview task это не requirement, так что нас это не беспокоит.
Теперь определим tables. Primary key содержит два компонента: partition key и clustering key.
-
Partition key: отвечает за распределение data между nodes. Как правило, хотим раскладывать data как можно равномернее.
-
Clustering key: отвечает за сортировку data внутри partition.
На high level email service должен поддерживать на data layer следующие queries:
-
Query 1: получить все folders пользователя
-
Query 2: показать все emails для конкретного folder
-
Query 3: создать/удалить/получить конкретный email
-
Query 4: получить все read или unread emails
-
Bonus point: conversation threads
Разберем их по очереди.
Query 1: получить все folders пользователя.
Как показано в таблице 1, user_id — partition key, так что folders одного user лежат в одной partition.
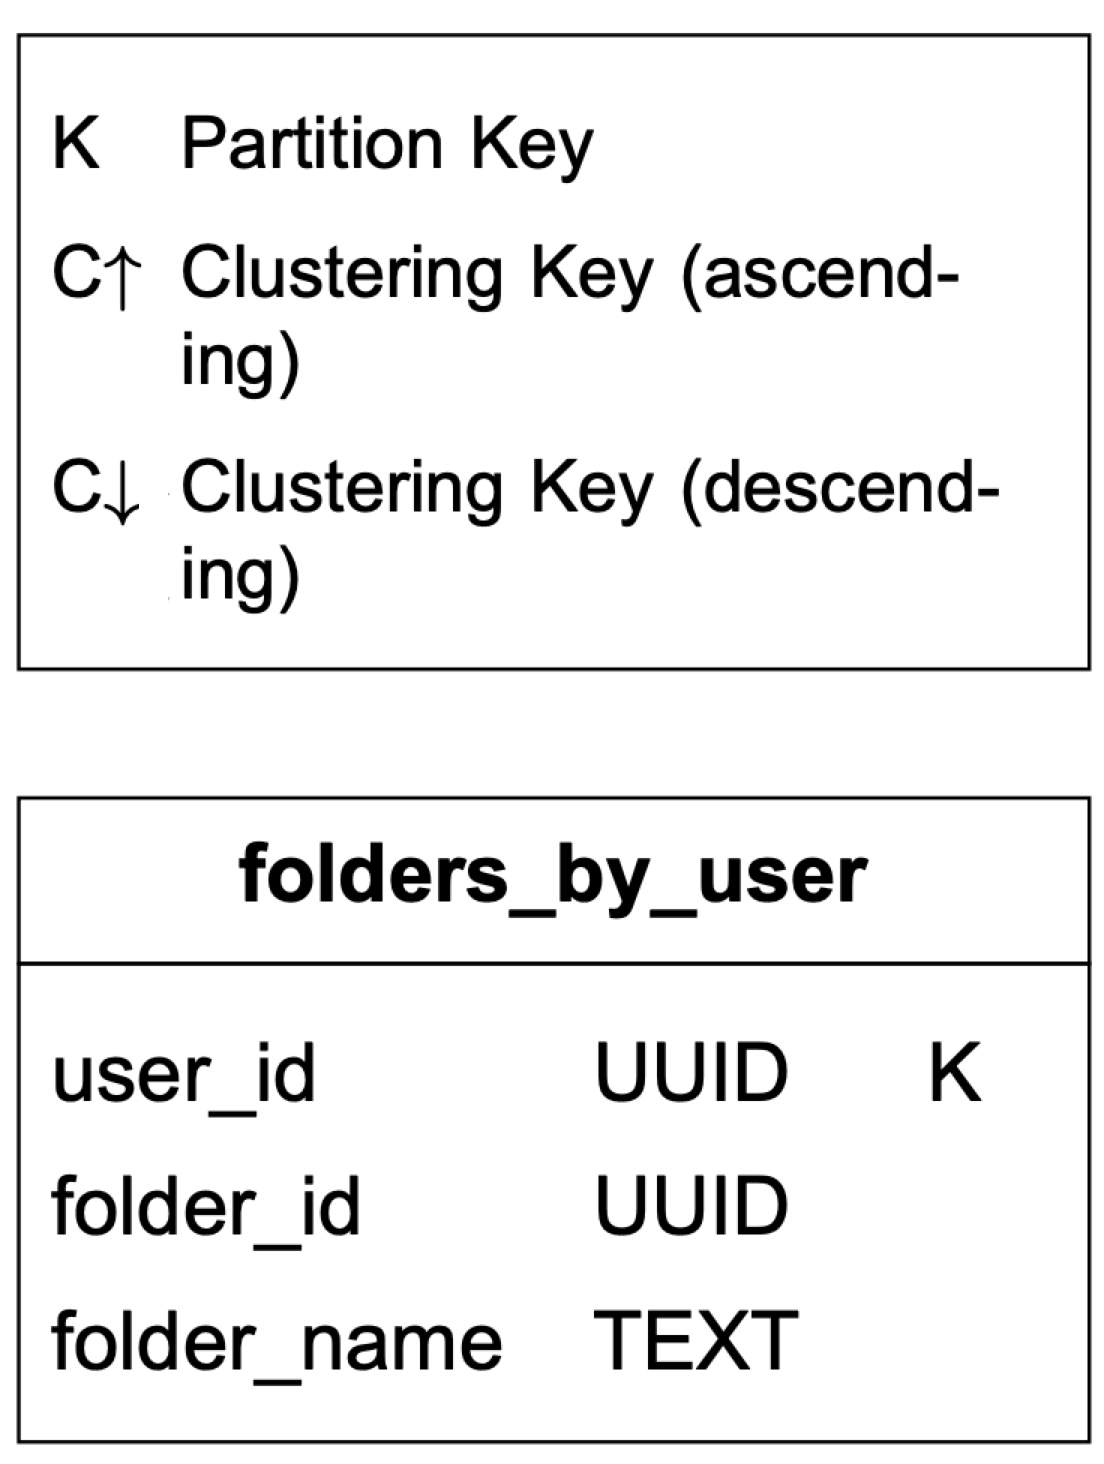
Таблица 1 Folders by user
Query 2: показать все emails для конкретного folder.
Когда user открывает inbox, emails обычно отсортированы по timestamp, самые новые сверху. Чтобы
все emails одного folder лежали в одной partition, используется composite partition key
<user_id, folder_id>. Еще важный столбец — email_id. Его тип — TIMEUUID [17], и он служит
clustering key для хронологической сортировки.
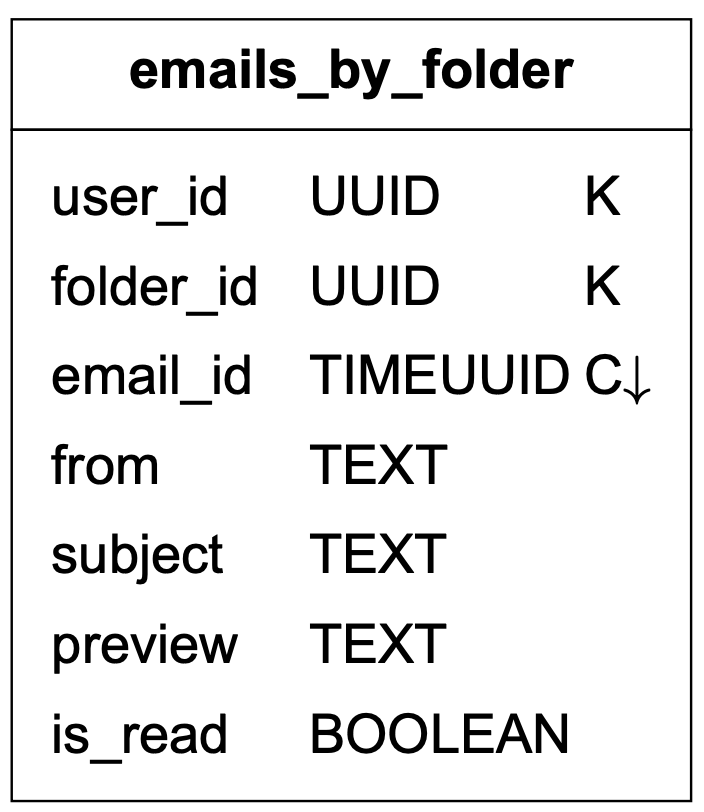
Таблица 2 Emails by folder
Query 3: create/delete/get an email
Из-за ограничений по месту подробно разберем только получение detailed information об email. Для этого используются две tables из таблицы 3. Упрощенный query выглядит так:
SELECT * FROM emails_by_user WHERE email_id = 123;
У email может быть несколько attachments, и их можно получить по комбинации полей email_id и filename.
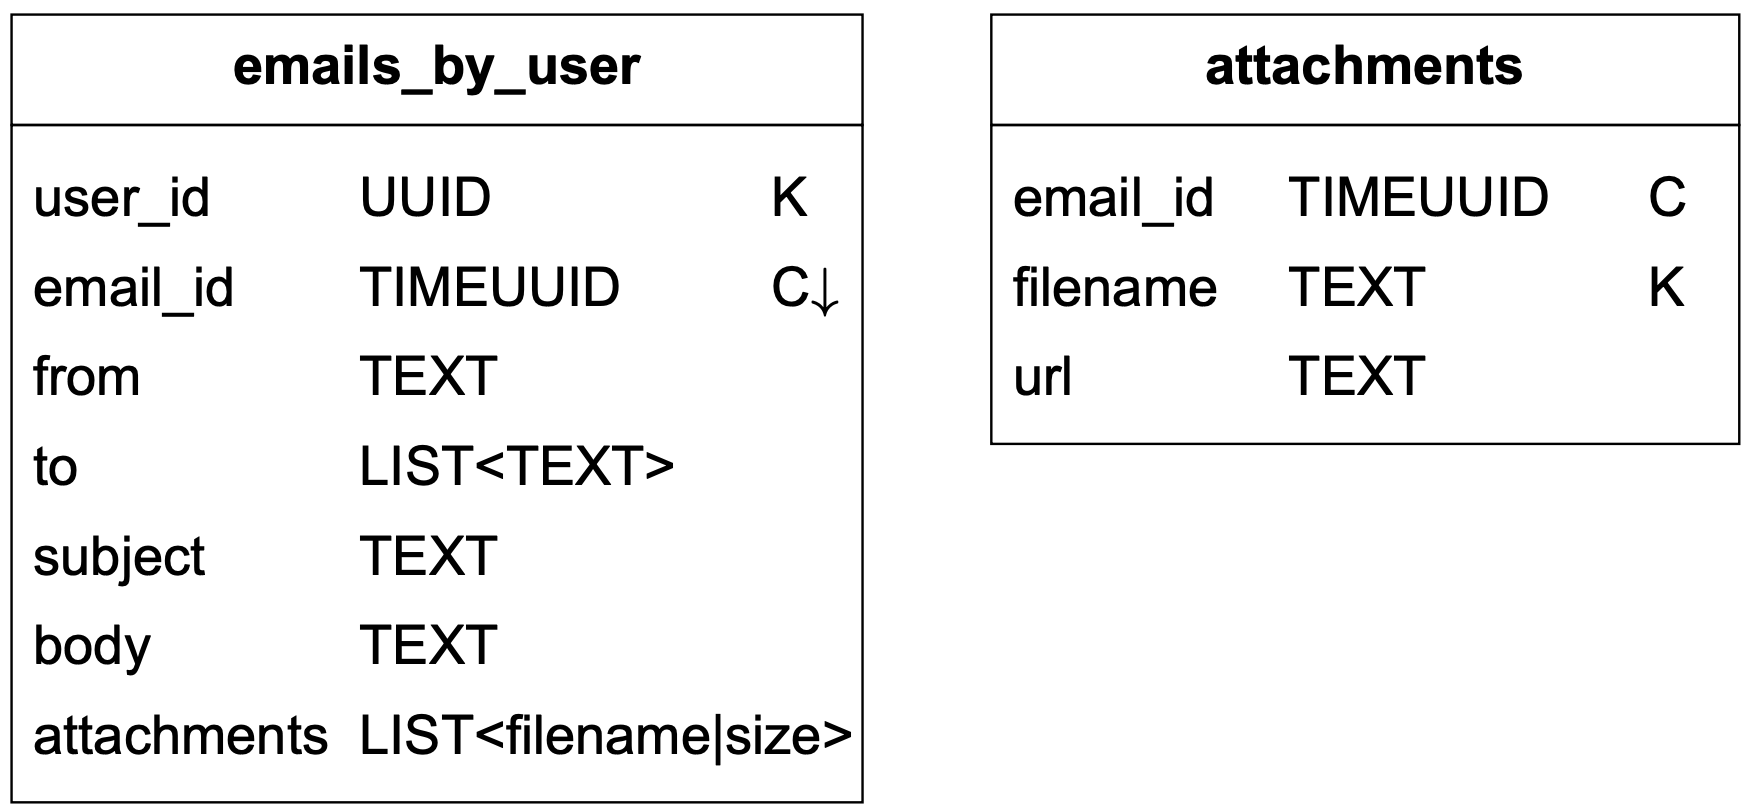
Таблица 3 Emails by user
Query 4: получить все read или unread emails
Если бы наш domain model был реляционным, query на все read emails выглядел бы так:
SELECT * FROM emails_by_folder
WHERE user_id = <user_id> and folder_id = <folder_id> and is_read = true
ORDER BY email_id;
Для unread emails он был бы почти тем же — достаточно заменить is_read = true на
is_read = false.
Но наш data model рассчитан на NoSQL. А NoSQL database обычно поддерживает queries только по partition и cluster keys. Так как is_read в emails_by_folder — ни то, ни другое, большинство NoSQL databases такой query отклонят.
Один из вариантов обойти ограничение — забирать весь folder целиком и фильтровать на стороне application. Для маленького email service это могло бы сработать, но на нашем масштабе — нет.
Обычное решение в NoSQL — denormalization. Чтобы поддержать read/unread queries, мы денормализуем данные emails_by_folder в две tables, как на таблице 4:
-
read_emails: хранит все emails со статусом read -
unread_emails: хранит все emails со статусом unread
Чтобы пометить UNREAD email как READ, письмо удаляется из unread_emails, а затем вставляется в
read_emails.
Чтобы получить все unread emails для конкретного folder, можно выполнить query:
SELECT * FROM unread_emails
WHERE user_id = <user_id> and folder_id = <folder_id>
ORDER BY email_id;
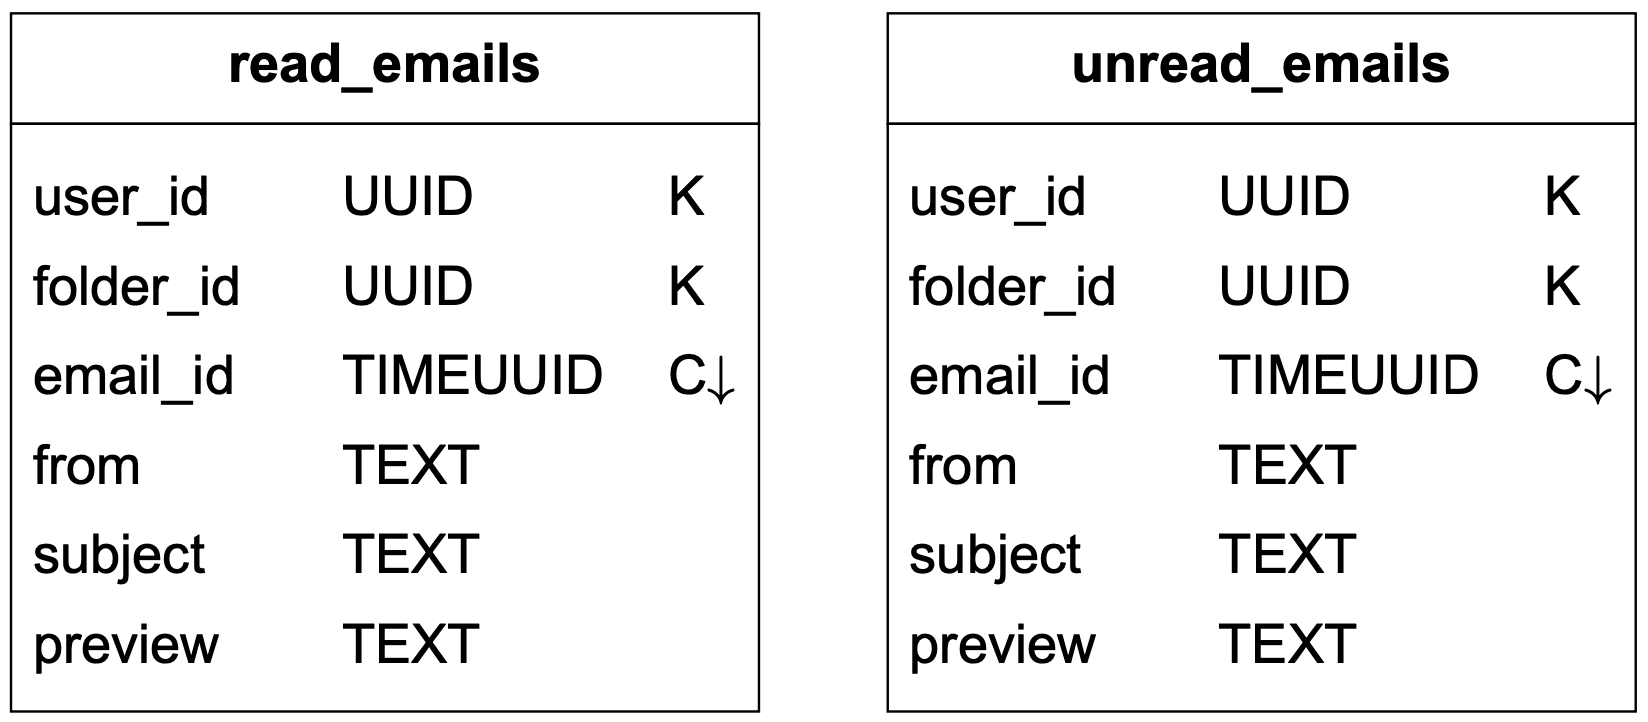
Таблица 4 Read and unread emails
Такой denormalization — обычная практика. Она делает application code сложнее и тяжелее в поддержке, но сильно повышает read performance на масштабе.
Bonus point: conversation threads
Threads — feature, которую поддерживают многие email clients. Она группирует replies вместе с original message [8], позволяя быстро получить все emails, относящиеся к одной conversation. Традиционно threads реализуются алгоритмами вроде JWZ [18]. Мы не будем влезать в детали алгоритма, а только объясним core idea. В header email обычно есть три поля:
{
  "headers" {
     "Message-Id": "<7BA04B2A-430C-4D12-8B57-862103C34501@gmail.com>",
     "In-Reply-To": "<CAEWTXuPfN=LzECjDJtgY9Vu03kgFvJnJUSHTt6TW@gmail.com>",
     "References": ["<7BA04B2A-430C-4D12-8B57-862103C34501@gmail.com>"]
  }
}
| Message-Id | Значение message ID. Генерируется client при отправке message. |
|---|---|
| In-Reply-To | Parent Message-Id, на который отвечает текущее message. |
| References | Список message IDs, связанных с thread. |
Таблица 5 Email header
Используя эти поля, email client может восстановить mail conversation по сообщениям, если все messages в reply chain уже загружены.
Consistency trade-off
Distributed databases, которые используют replication для high availability, обязаны делать базовый trade-off между consistency и availability. Для email systems correctness очень важна, поэтому по design мы хотим иметь один primary на любой given mailbox. Во время failover mailbox становится временно недоступной для clients, а значит sync/update operations paused до окончания failover. Это явный обмен availability на consistency.
Email deliverability
Поднять mail server и начать слать emails легко. Сложная часть — сделать так, чтобы письма реально попадали во inbox, а не в spam. Email spam — огромная проблема. По данным Statista [19], более 50% всех отправляемых emails — spam. Если поднять новый mail server с нуля, велика вероятность, что его письма будут попадать в spam folder, потому что у нового server нет reputation. Чтобы улучшить deliverability, надо учитывать несколько факторов.
Dedicated IPs. Для sending emails рекомендуется использовать dedicated IP addresses. Email providers гораздо менее охотно принимают письма с новых IP без истории.
Classify emails. Разные категории emails нужно отправлять с разных IP addresses. Например, не стоит смешивать marketing emails и важные transactional emails на одних и тех же servers, иначе ISPs могут начать помечать все письма как promotional.
Email sender reputation. Новые email server IP addresses надо прогревать постепенно, чтобы сформировать хорошую reputation. Тогда крупные providers вроде Office365, Gmail или Yahoo Mail будут реже отправлять ваши письма в spam. По данным Amazon Simple Email Service [20], прогрев IP занимает примерно от 2 до 6 недель.
Ban spammers quickly. Спамеров нужно блокировать быстро, пока они не испортили reputation server.
Feedback processing. Очень важно настроить feedback loops с ISPs, чтобы держать complaint rate низким и быстро банить spam accounts. Если email не доставлен или user пожаловался, происходит одно из следующих событий:
-
Hard bounce. Письмо отклонено ISP, потому что recipient email address невалиден.
-
Soft bounce. Временная проблема доставки, например ISP перегружен.
-
Complaint. Recipient нажал
report spam.
На рисунке 8 показан flow сбора и обработки bounces/complaints. Мы используем отдельные queues для soft bounces, hard bounces и complaints, чтобы управлять ими раздельно.
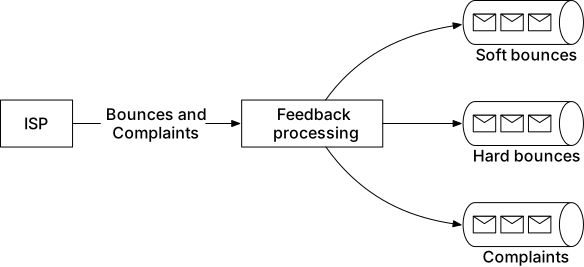
Рисунок 8 Обработка feedback loop
Email authentication. Согласно Verizon 2018 data breach investigation report, phishing и pretexting дают 93% breaches [21]. Среди частых техник борьбы с phishing — Sender Policy Framework (SPF) [22], DomainKeys Identified Mail (DKIM) [23] и Domain-based Message Authentication, Reporting and Conformance (DMARC) [24].
На рисунке 9 показан пример header у Gmail message. Как видно, sender @info6.citi.com
аутентифицирован через SPF, DKIM и DMARC.
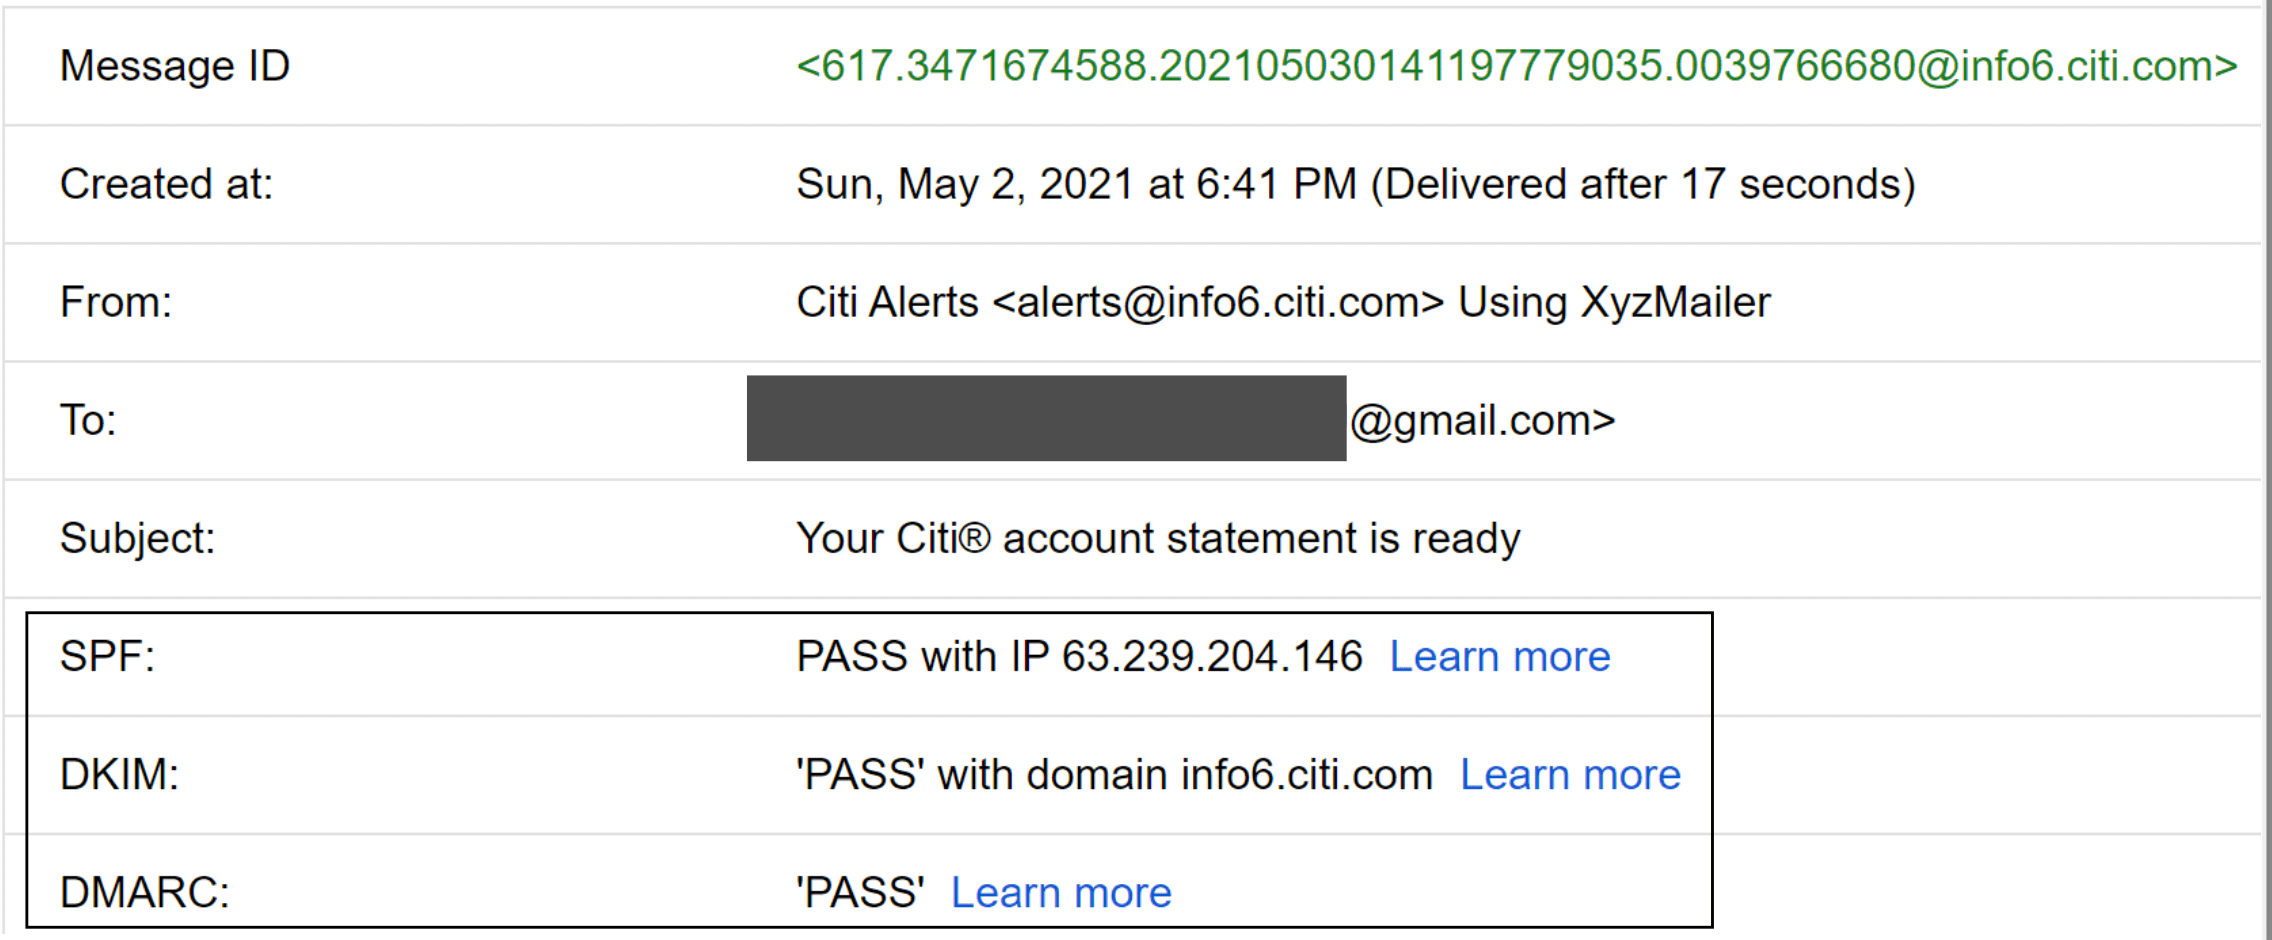
Рисунок 9 Пример Gmail header
Все эти термины запоминать не обязательно. Главное — помнить, что сделать так, чтобы email system работала как задумано, трудно. Нужны и domain knowledge, и хорошие отношения с ISPs.
Search
Basic mail search — это поиск emails, содержащих введенные keywords в subject или body.
Более продвинутые features включают filters по From, Subject, Unread и другим attributes.
С одной стороны, когда email отправляется, получается, удаляется, нам нужно делать reindexing. С
другой — search query выполняется только когда user нажимает search. Это значит, что в email
systems search существенно более write-heavy, чем read-heavy. По сравнению с Google search,
email search обладает другими характеристиками, как показано в таблице 6.
| Scope | Sorting | Accuracy | |
|---|---|---|---|
| Google search | Весь интернет | Сортировка по relevance | Indexing занимает время, поэтому некоторые items могут не появиться в search result сразу |
| Email search | Собственный mailbox user | Сортировка по attributes: time, has attachment, date within, is unread и т. д. | Indexing должно быть near real-time, а result — точным |
Таблица 6 Google search vs email search
Чтобы поддержать search functionality, сравним два подхода: Elasticsearch и native search, встроенный в datastore.
Вариант 1: Elasticsearch
High-level design email search с Elasticsearch показан на рисунке 10. Поскольку queries чаще всего выполняются по mailbox самого user, можно группировать underlying documents на одном node, используя user_id как partition key.
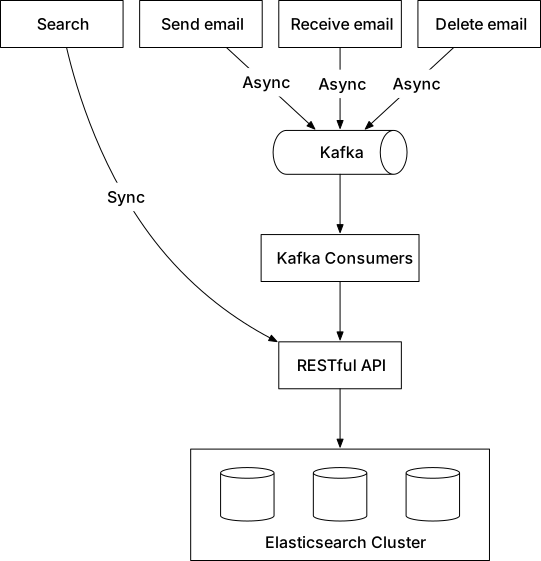
Рисунок 10 Elasticsearch
Когда user нажимает search, он ждет response, поэтому search request — synchronous. А вот
events вроде send email, receive email или delete email не требуют немедленного response,
связанного с search. Но reindexing при них нужен, и его можно выполнять offline jobs. Kafka в этом
design нужна для decoupling between services, которые порождают reindexing, и services, которые
его реально выполняют.
Elasticsearch — самый популярный search-engine database по состоянию на июнь 2021 [25], и он очень хорошо поддерживает full-text search по emails. Главный challenge при его добавлении — синхронизация с primary email store. Например, Tencent QQ Email использует Elasticsearch [26].
Вариант 2: Custom search solution
Крупные email providers обычно разрабатывают собственные custom search engines, чтобы точнее попасть в свои requirements. Проектирование email search engine — очень сложная тема и вне scope этой главы. Здесь кратко затронем disk I/O bottleneck — одну из главных проблем такого решения.
Как показали расчеты выше, объем metadata и attachments, добавляемых ежедневно, измеряется petabytes. При этом один email account легко может содержать более полумиллиона emails. Поэтому главный bottleneck index server обычно — disk I/O.
Так как index building write-heavy, хорошей стратегией может быть использование Log-Structured Merge-Tree (LSM) [27] для организации index data на disk (рисунок 11). Write path оптимизируется за счет того, что система делает только sequential writes. LSM trees лежат в основе BigTable, Cassandra и RocksDB. Когда приходит новый email, он сначала попадает в level 0 in-memory cache, а когда data size достигает threshold, данные merge-ятся на следующий level. Еще одна причина использовать LSM — возможность отделить data, которая часто меняется, от data, которая почти не меняется. Например, email data обычно стабильна, а folder information меняется заметно чаще из-за filter rules. Тогда их можно хранить в разных секциях: folder changes обновляются отдельно, а email data не трогаются.
Если хочется глубже почитать про email search, очень полезно посмотреть, как search устроен в Microsoft Exchange servers [28].
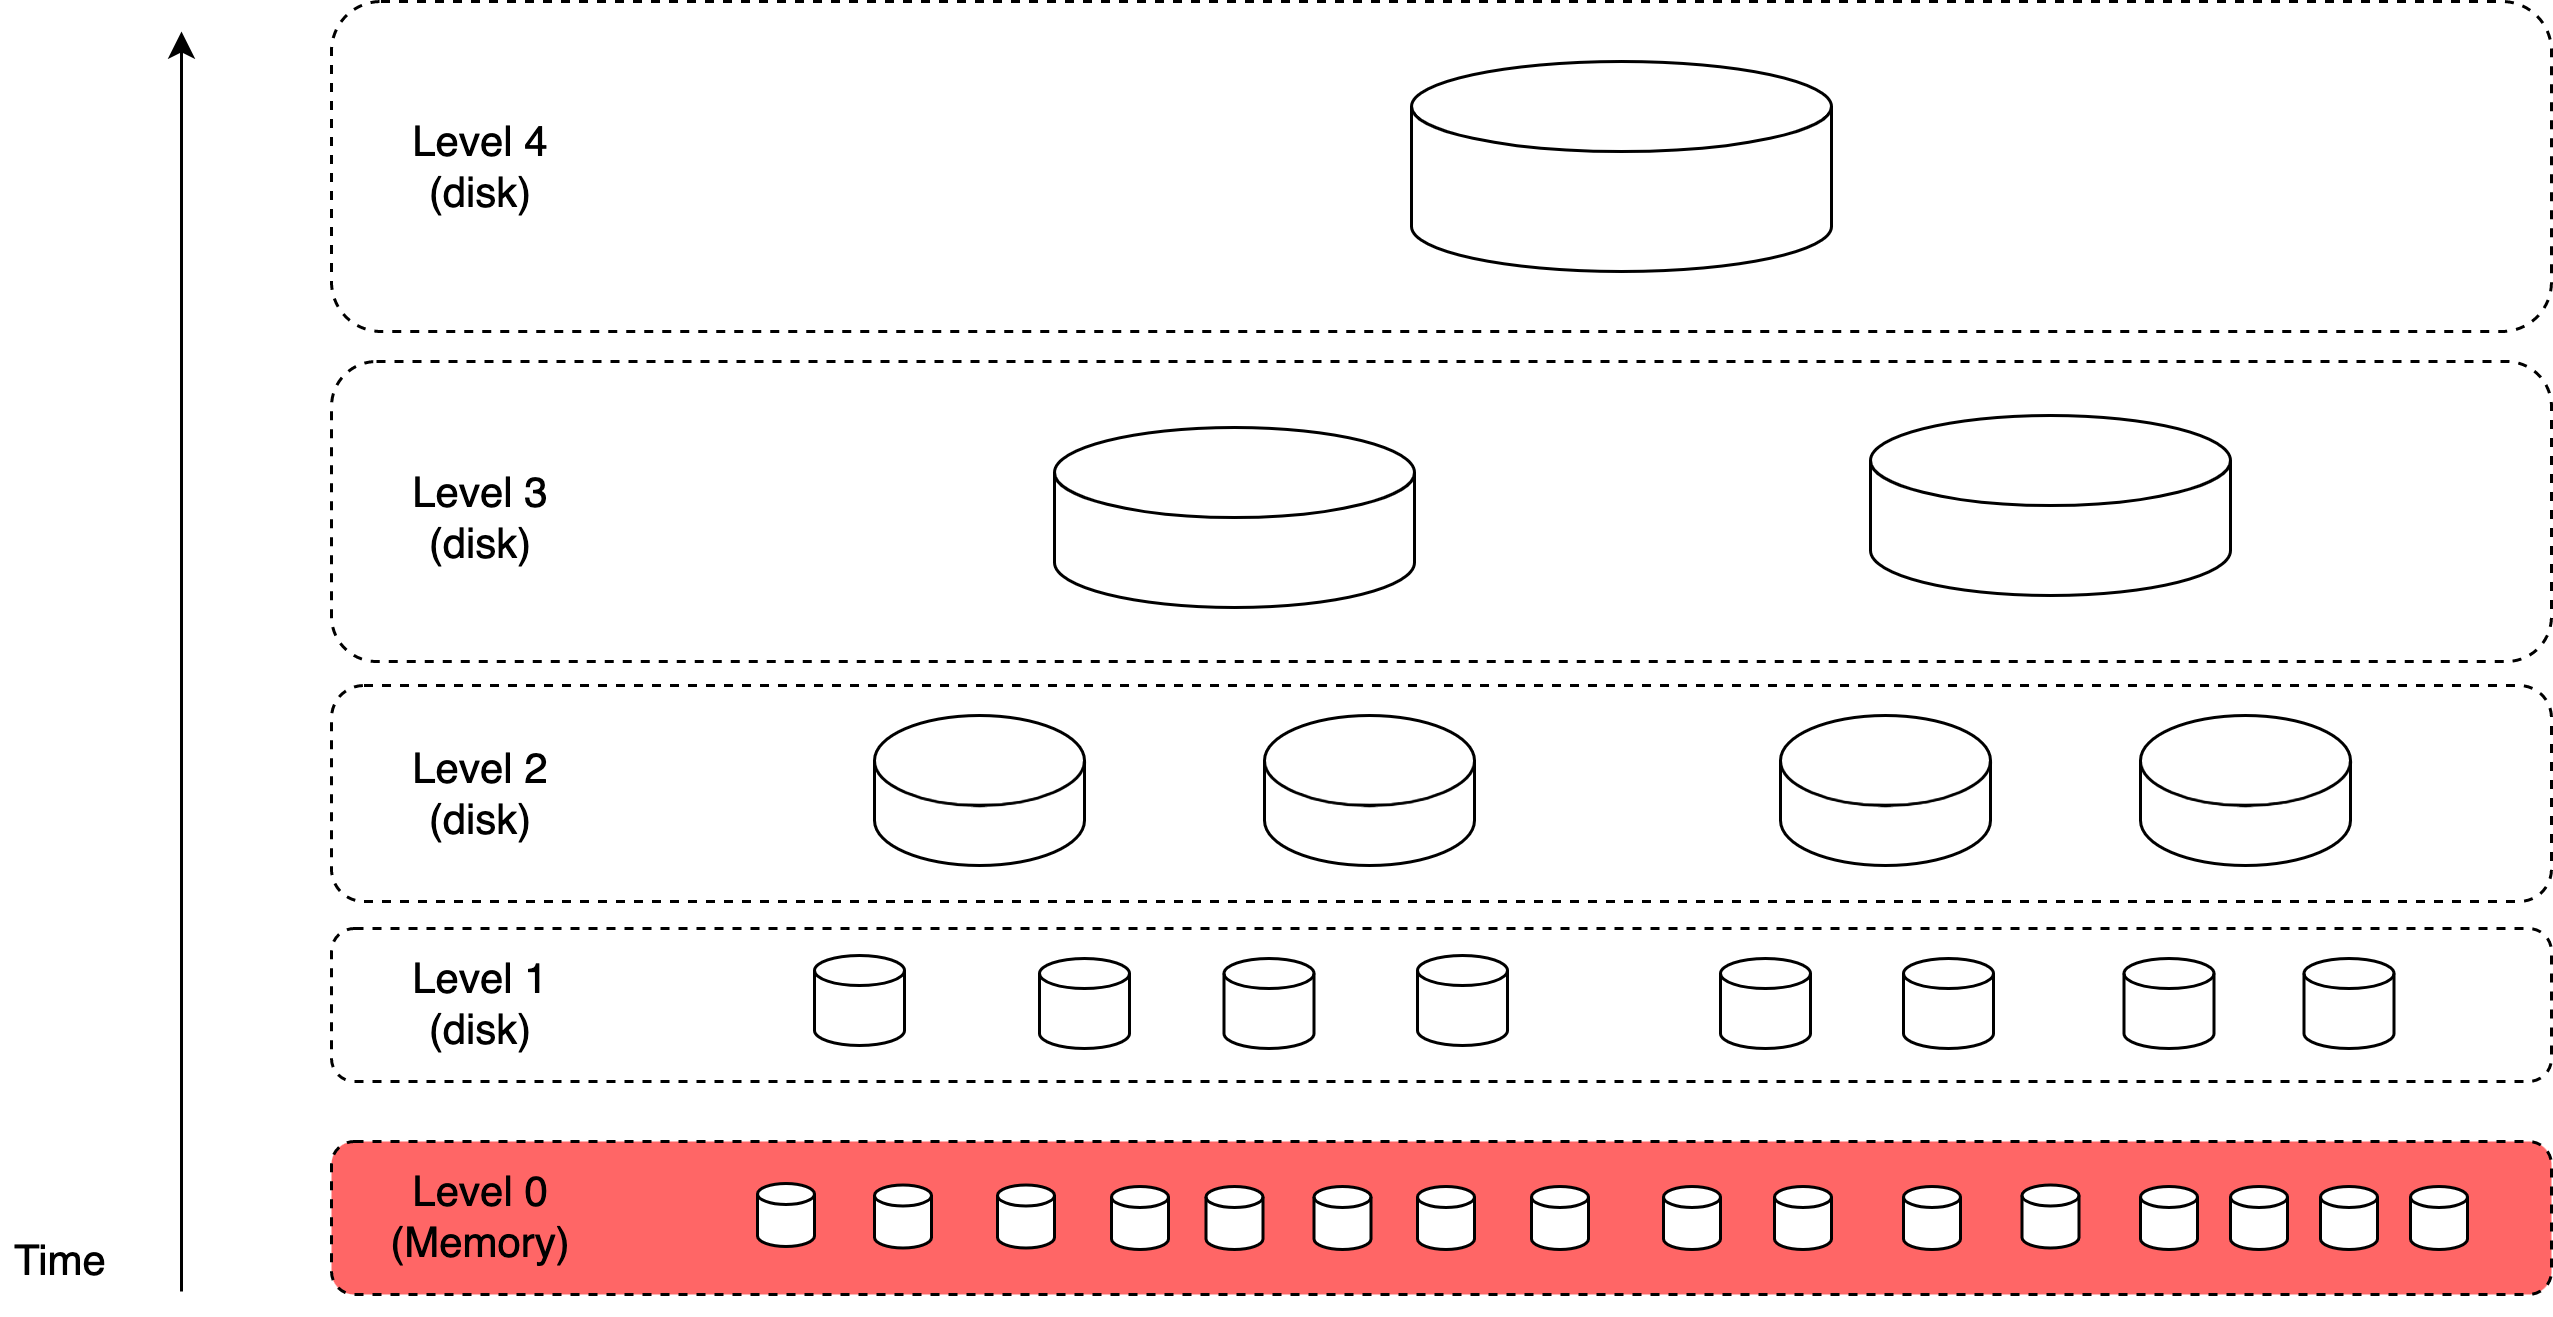
Рисунок 11 LSM tree
У обоих подходов есть плюсы и минусы:
| Feature | Elasticsearch | Custom search engine |
|---|---|---|
| Scalability | Масштабируется до определенного предела | Легче масштабировать, так как систему можно оптимизировать под email use case |
| System complexity | Нужно поддерживать две системы: datastore и Elasticsearch | Одна система |
| Data consistency | Две copies data: одна в metadata datastore, другая в Elasticsearch. Consistency поддерживать сложно | Одна copy data в metadata datastore |
| Data loss possible | Нет. При failure можно rebuild index Elasticsearch из primary storage | Нет |
| Development effort | Легко интегрировать. Но для large-scale email search может понадобиться dedicated Elasticsearch team | Требуются значительные engineering efforts |
Таблица 7 Elasticsearch vs custom search engine
Общее практическое правило такое: для smaller-scale email system Elasticsearch — хороший option, потому что его легко интегрировать и он не требует гигантских engineering efforts. На larger scale он тоже может работать, но, возможно, уже понадобится dedicated team для развития и сопровождения search infrastructure. Для масштаба Gmail или Outlook, вероятно, разумнее иметь native search, встроенный в database, а не отдельный indexing pipeline.
Scalability и availability
Поскольку patterns доступа отдельных users независимы друг от друга, можно ожидать, что большая часть components в системе хорошо масштабируется горизонтально.
Для лучшей availability data реплицируется между несколькими data centers. Users общаются с тем mail server, который ближе к ним по network topology. Во время network partition users могут получать доступ к messages из других data centers (рисунок 12).
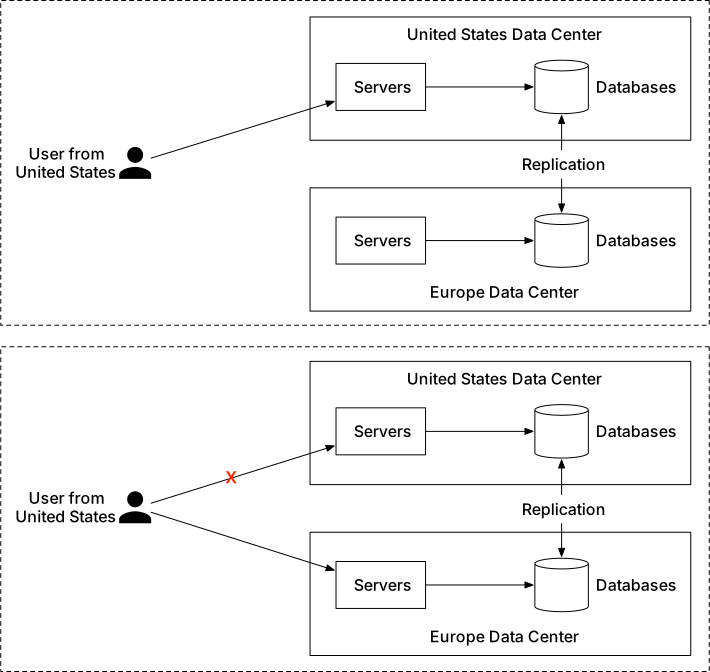
Рисунок 12 Multi-data-center setup
Шаг 4 — Итоги
В этой главе мы представили design large-scale email servers. Сначала собрали requirements и сделали back-of-the-envelope calculations, чтобы понять масштаб. В high-level design обсудили, как устроены traditional email servers и почему они не подходят для современных use cases. Затем разобрали email APIs и high-level designs для sending и receiving flows. Наконец, углубились в metadata database design, email deliverability, search и scalability.
Если в конце interview остается extra time, можно затронуть еще несколько тем:
-
Fault tolerance. Во многих местах системы возможны failures, и можно обсудить handling node failures, network issues, event delays и т. д.
-
Compliance. Email service работает по всему миру, а значит есть legal regulations. Например, PII европейских users нужно хранить и обрабатывать в соответствии с GDPR [29]. Legal intercept — еще одна типичная тема здесь [30].
-
Security. Email security важна, потому что emails содержат sensitive information. Gmail, например, использует phishing protections, safe browsing, proactive alerts, account safety, confidential mode и email encryption [31].
-
Optimizations. Иногда один и тот же email отправляется нескольким recipients, а один и тот же attachment несколько раз сохраняется в object store (S3) для group emails. Одна из optimizations — проверять, существует ли attachment в storage, до того как делать дорогую save operation.
Поздравляю, вы дошли до конца. Можно похлопать себе по плечу — хорошая работа.
Краткое содержание главы
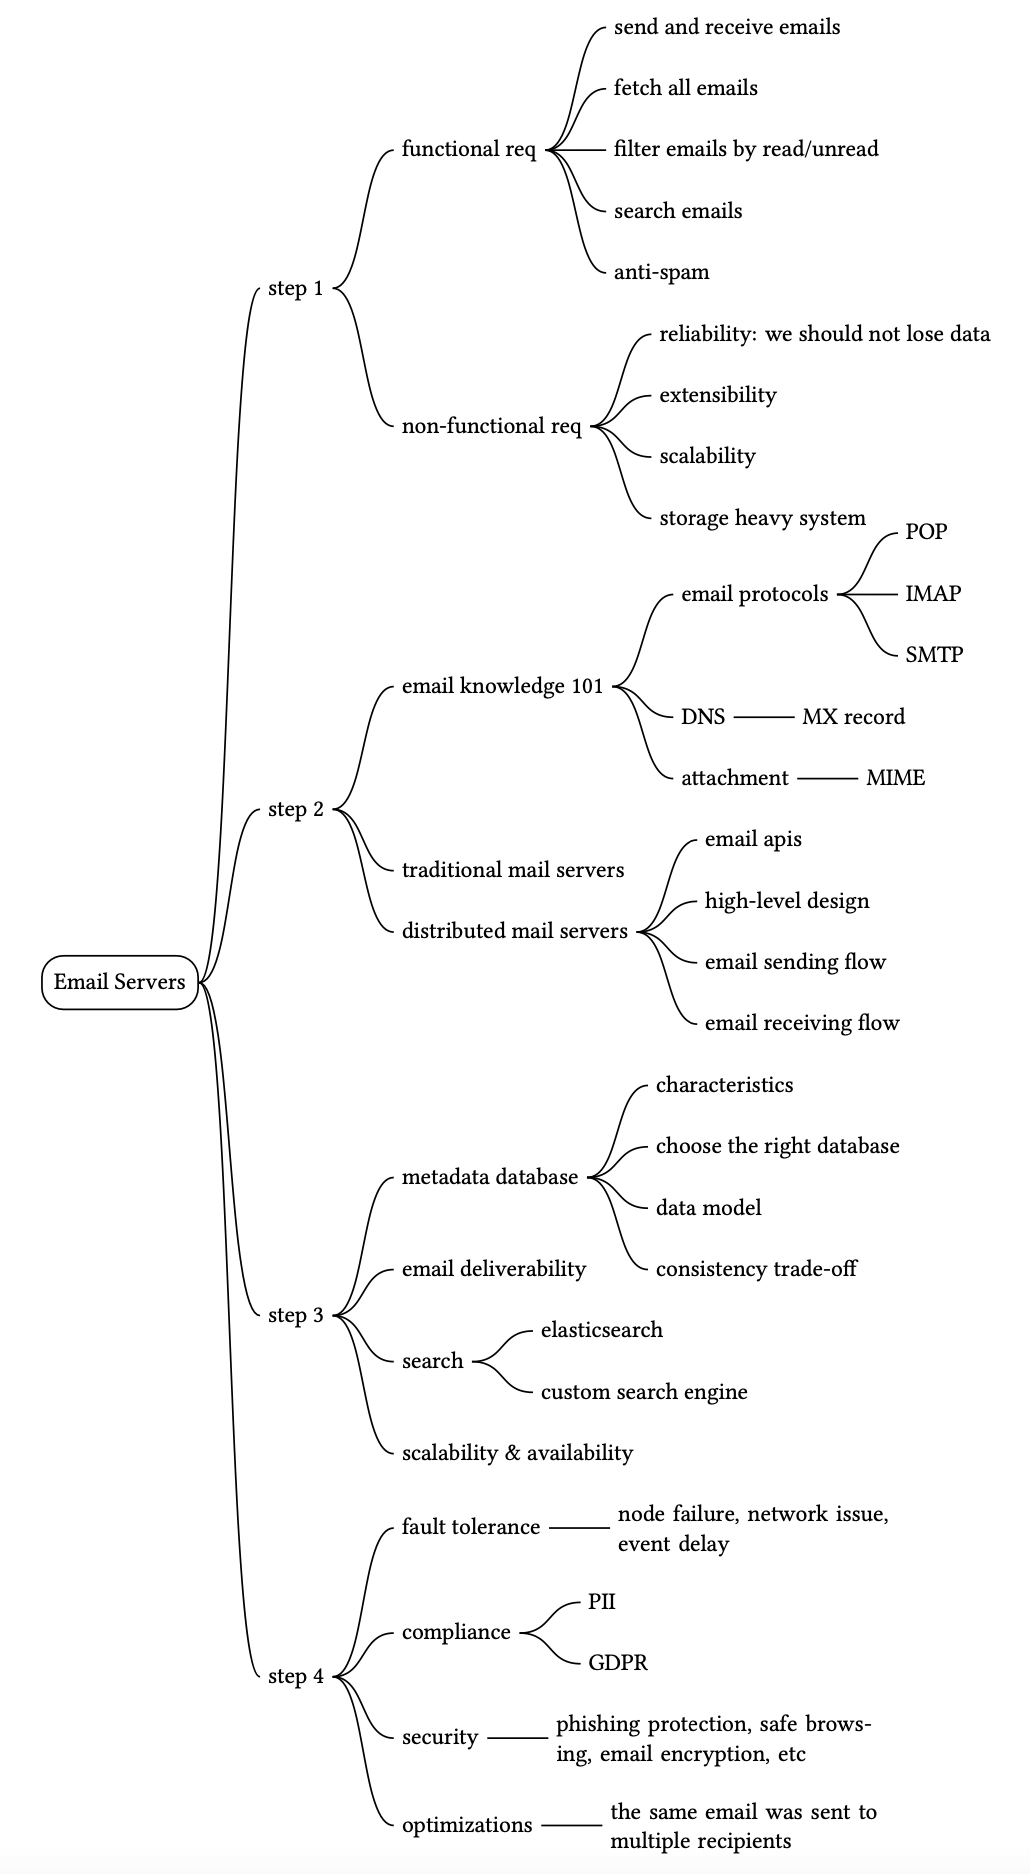
Reference Materials
[1] Number of Active Gmail Users: https://financesonline.com/number-of-active-gmail-users/
[2] Outlook: https://en.wikipedia.org/wiki/Outlook.com
[3] How Many Emails Are Sent Per Day in 2021?:
https://review42.com/resources/how-many-emails-are-sent-per-day/
[4] RFC 1939 - Post Office Protocol - Version 3:
http://www.faqs.org/rfcs/rfc1939.html
[5] ActiveSync: https://en.wikipedia.org/wiki/ActiveSync
[6] Email attachment: https://en.wikipedia.org/wiki/Email_attachment
[7] MIME: https://en.wikipedia.org/wiki/MIME
[8] Threading: https://en.wikipedia.org/wiki/Conversation_threading
[9] IMAP LIST Extension for Special-Use Mailboxes:
https://datatracker.ietf.org/doc/html/rfc6154
[10] Apache James: https://james.apache.org/
[11] A JSON Meta Application Protocol (JMAP) Subprotocol for WebSocket:
https://datatracker.ietf.org/doc/rfc8887/
[12] Cassandra Limitations:
https://cwiki.apache.org/confluence/display/CASSANDRA2/CassandraLimitations
[13] Inverted index: https://en.wikipedia.org/wiki/Inverted_index
[14] Exponential backoff: https://en.wikipedia.org/wiki/Exponential_backoff
[15] Why are emails so hard to understand? Exploring the metadata footprint of email messages:
https://www.usenix.org/conference/atc17/technical-sessions/presentation/hacigumus
[16] IOPS: https://en.wikipedia.org/wiki/Input/output_operations_per_second
[17] TimeUUID: https://www.datastax.com/blog/what-timeuuid-got-do-it
[18] The jwz threading algorithm:
http://www.jwz.org/doc/threading.html
[19] Spam Statistics 2021:
https://www.statista.com/statistics/420391/spam-email-traffic-share/
[20] Slowly ramp up email sending to warm up dedicated IP addresses:
https://docs.aws.amazon.com/ses/latest/dg/dedicated-ip-warming.html
[21] 2018 Data Breach Investigations Report:
https://www.verizon.com/business/resources/reports/2018/DBIR_Executive_Summary.pdf
[22] Sender Policy Framework (SPF):
https://en.wikipedia.org/wiki/Sender_Policy_Framework
[23] DomainKeys Identified Mail (DKIM):
https://en.wikipedia.org/wiki/DomainKeys_Identified_Mail
[24] DMARC: https://en.wikipedia.org/wiki/DMARC
[25] DB-Engines Ranking: https://db-engines.com/en/ranking/search+engine
[26] Tencent QQ Mail practice:
https://www.elastic.co/blog/using-elasticsearch-and-logstash-to-serve-billions-of-searchable-events-for-customers
[27] LSM Tree: https://en.wikipedia.org/wiki/Log-structured_merge-tree
[28] Search in Microsoft Exchange Server:
https://techcommunity.microsoft.com/t5/exchange-team-blog/exchange-search-architecture/ba-p/595991
[29] GDPR: https://gdpr-info.eu/
[30] Legal intercept:
https://en.wikipedia.org/wiki/Lawful_interception
[31] Gmail Security & Privacy settings: https://safety.google/gmail/