Поиск и отображения "друзей" поблизости
В этой главе мы проектируем масштабируемую backend-систему для новой функции мобильного приложения
под названием Nearby Friends. Для пользователя, который явно согласился делиться геолокацией,
мобильный клиент показывает список друзей, находящихся поблизости. Если нужен реальный пример,
посмотрите статью [1] о похожей функции в приложении Facebook.
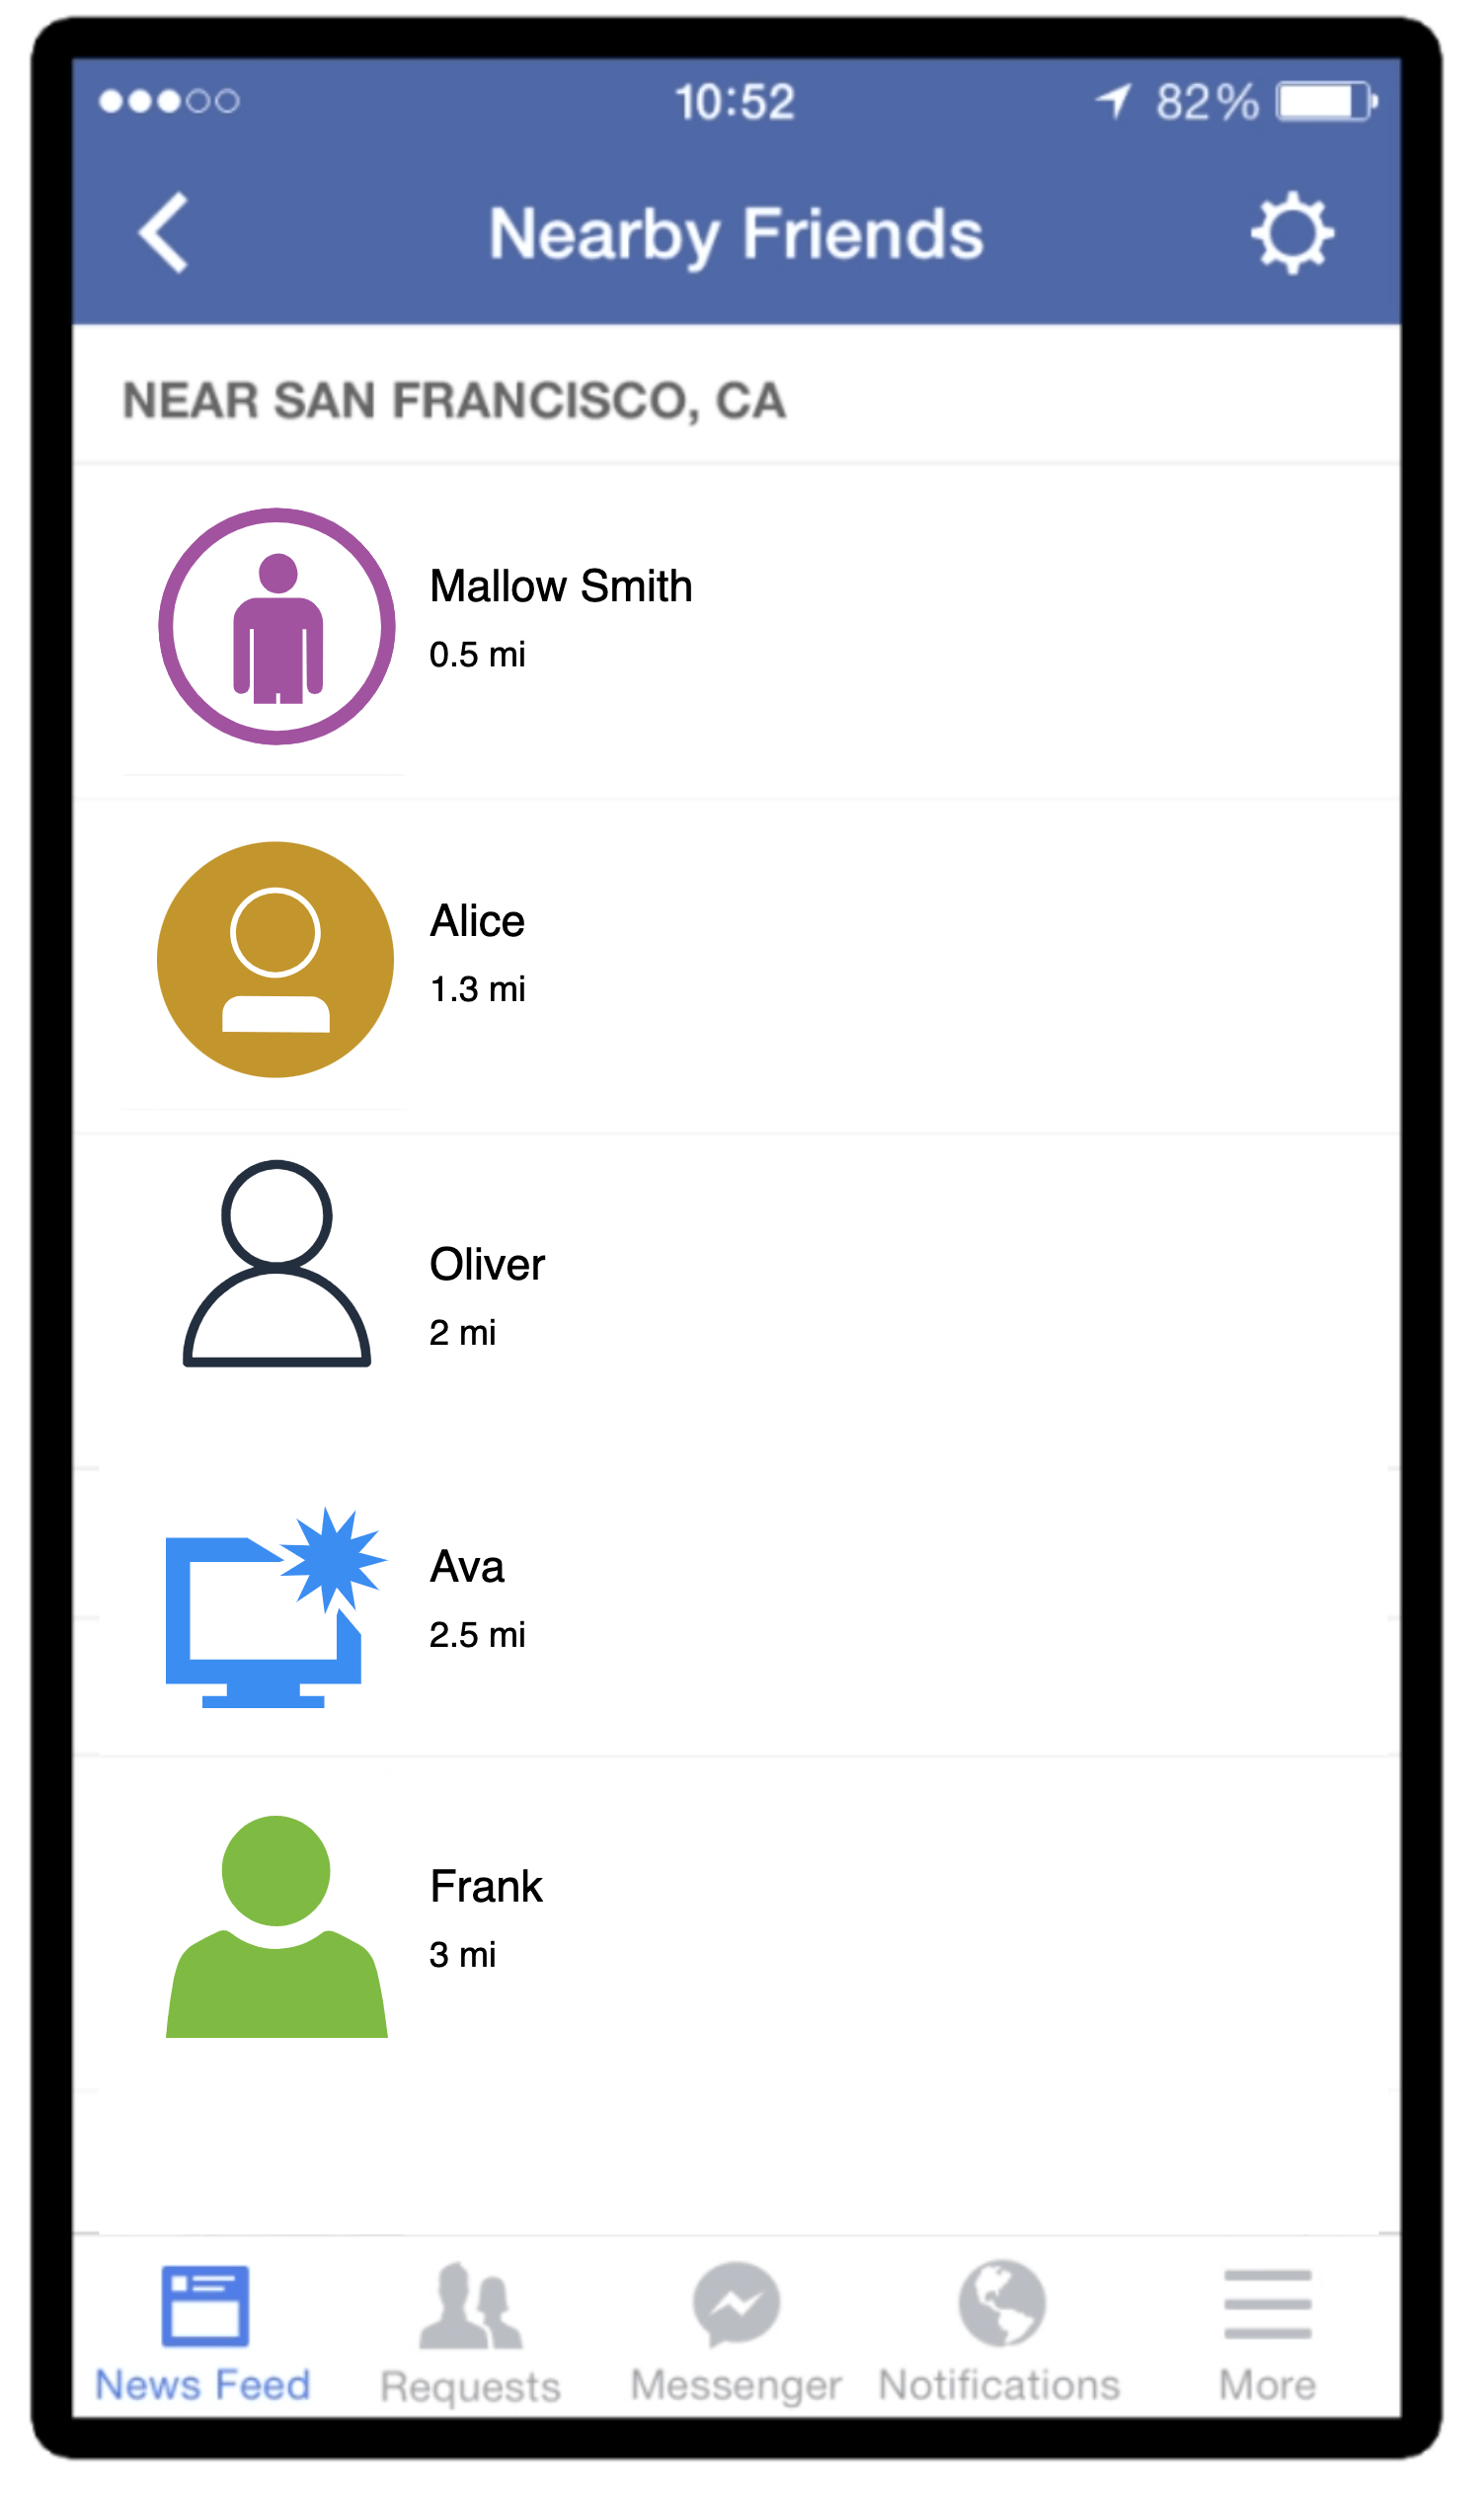
Рисунок 1 Facebook Nearby Friends
Если вы уже читали главу про Proximity Service, может возникнуть вопрос, зачем нужна отдельная
глава про nearby friends, ведь задача выглядит похожей. Но если присмотреться внимательнее,
разница существенная. В proximity service адреса бизнесов статичны, потому что их местоположение
не меняется, а в nearby friends данные гораздо динамичнее, так как локации пользователей часто
обновляются.
Шаг 1 — Понять задачу и определить рамки дизайна
Любая backend-система масштаба Facebook сложна. Прежде чем начинать дизайн, нужно задать уточняющие вопросы и сузить scope.
Кандидат: Насколько близко должен находиться человек, чтобы считаться nearby?
Интервьюер: 5 миль. Это значение должно быть конфигурируемым.
Кандидат: Можно ли считать расстояние как расстояние по прямой между двумя пользователями? В
реальности между ними, например, может быть река, и путь окажется длиннее.
Интервьюер: Да, это разумное предположение.
Кандидат: Сколько пользователей у приложения? Могу ли я предположить 1 миллиард пользователей
и что 10% из них используют функцию nearby friends?
Интервьюер: Да, это разумное предположение.
Кандидат: Нужно ли хранить историю перемещений?
Интервьюер: Да, история геолокации может быть полезна, например, для machine learning.
Кандидат: Можно ли предположить, что если друг неактивен больше 10 минут, он исчезает из
списка nearby friends? Или нужно показывать последнюю известную локацию?
Интервьюер: Предположим, что неактивные друзья больше не отображаются.
Кандидат: Нужно ли учитывать privacy и законы вроде GDPR или CCPA?
Интервьюер: Хороший вопрос. Для простоты пока не будем об этом беспокоиться.
Функциональные требования
-
Пользователь должен видеть nearby friends в мобильном приложении. У каждой записи в списке есть расстояние и timestamp, показывающий, когда расстояние обновлялось в последний раз.
-
Список nearby friends должен обновляться каждые несколько секунд.
Нефункциональные требования
-
Низкая latency. Важно получать обновления локации друзей без большой задержки.
-
Надежность. Система в целом должна быть надежной, но редкая потеря отдельных точек данных допустима.
-
Eventual consistency. Хранилище локаций не обязано быть строго консистентным. Задержка в несколько секунд при распространении данных между репликами допустима.
Оценка на салфетке
Сделаем быструю оценку, чтобы понять возможный масштаб и основные сложности. Ниже несколько ограничений и допущений:
-
Nearby friends — это друзья, чьи локации находятся в радиусе 5 миль.
-
Интервал обновления локации — 30 секунд. Причина в том, что человек идет медленно (в среднем 3–4 мили в час), и расстояние, пройденное за 30 секунд, не оказывает большого влияния на функцию
nearby friends. -
В среднем 100 миллионов пользователей используют функцию
nearby friendsкаждый день. -
Предположим, число concurrent users равно 10% от DAU, то есть 10 миллионов.
-
В среднем у пользователя 400 друзей. Предположим, что все они используют функцию
nearby friends. -
Приложение показывает 20 nearby friends на странице и по запросу может подгружать больше.
| Расчет QPS
| | --- | |
-
100 миллионов DAU
-
Concurrent users: 10% * 100 миллионов = 10 миллионов
-
Пользователи отправляют свою локацию каждые 30 секунд.
-
QPS обновлений локации = 10 миллионов / 30 = ~334,000
|
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
В этом разделе мы обсудим:
-
High-level design
-
API design
-
Data model
В других главах мы обычно обсуждаем API design и data model до high-level design. Но в этой задаче протокол общения между клиентом и сервером может быть не простым HTTP, потому что нам нужно пушить location data всем друзьям. Без понимания high-level design трудно понять, какими будут API. Поэтому сначала обсудим high-level design.
High-level design
На высоком уровне задача требует дизайна с эффективной передачей сообщений. Концептуально каждый пользователь хотел бы получать обновления локации от каждого активного друга, который находится рядом. Теоретически это можно было бы сделать полностью по peer-to-peer модели: пользователь поддерживал бы постоянное соединение с каждым другим активным другом поблизости (рисунок 2).
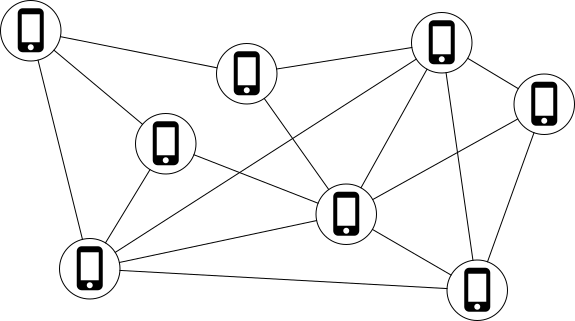
Рисунок 2 Peer-to-peer
Такое решение непрактично для мобильного устройства с нестабильным соединением и жесткими ограничениями по энергопотреблению, но сама идея помогает понять общее направление дизайна.
Более практичный вариант — общий backend, который выглядит так:

Рисунок 3 Shared backend
Какие обязанности у backend на рисунке 3?
-
Принимать обновления локации от всех активных пользователей.
-
Для каждого обновления находить всех активных друзей, которым его нужно отправить, и пересылать обновление на устройства этих пользователей.
-
Если расстояние между двумя пользователями превышает заданный порог, не пересылать обновление получателю.
Звучит довольно просто. В чем же проблема? На таком масштабе это непросто. У нас 10 миллионов
активных пользователей. Если каждый отправляет обновление локации каждые 30 секунд, получаем 334K
обновлений в секунду. Если у пользователя в среднем 400 друзей и примерно 10% из них онлайн и
находятся рядом, backend каждую секунду пересылает
334K * 400 * 10% = 14 миллионов обновлений локации. Это очень большой поток.
Предлагаемый дизайн
Сначала построим high-level design для меньшего масштаба. Позже в deep dive оптимизируем его под масштаб.
На рисунке 4 показан базовый дизайн, который должен покрывать функциональные требования. Разберем его по компонентам.
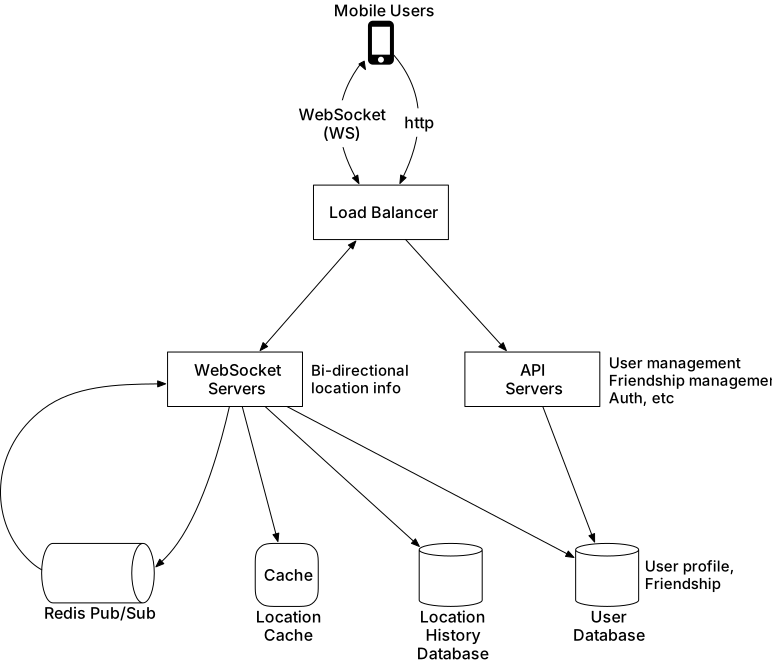
Рисунок 4 High-level design
Load balancer
Load balancer стоит перед RESTful API servers и stateful двунаправленными WebSocket servers. Он распределяет трафик между ними, чтобы равномерно разносить нагрузку.
RESTful API servers
Это кластер stateless HTTP-серверов, который обрабатывает типичный request/response-трафик. Поток API-запросов выделен на рисунке 5. Этот слой отвечает за вспомогательные задачи вроде добавления и удаления друзей, обновления профиля пользователя и так далее. Эти сценарии очень стандартны, и мы не будем углубляться в них.
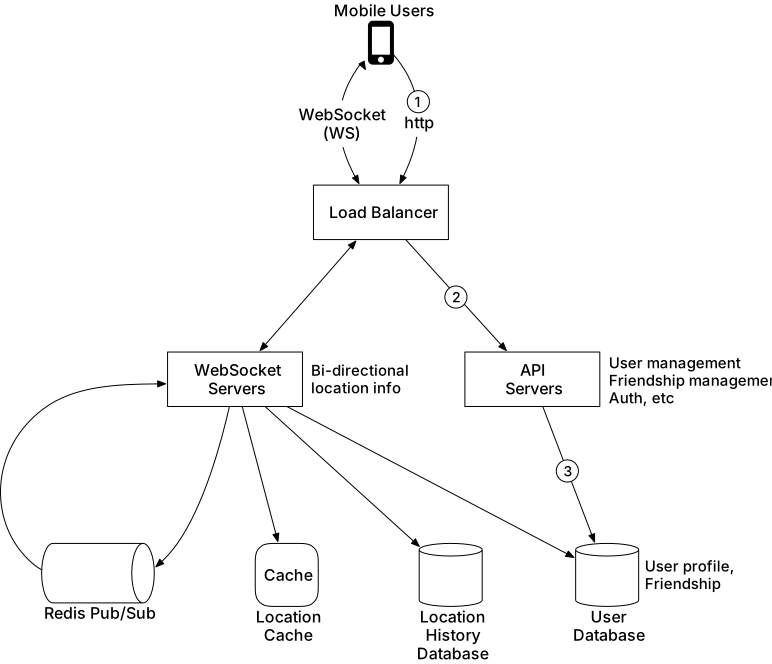
Рисунок 5 Поток RESTful API-запросов
WebSocket servers
Это кластер stateful серверов, который обрабатывает почти real-time обновления локаций друзей. Каждый клиент поддерживает одно постоянное WebSocket-соединение с одним из этих серверов. Когда друг, находящийся в пределах радиуса поиска, обновляет свою локацию, обновление отправляется по этому соединению клиенту.
Еще одна важная обязанность WebSocket servers — инициализация клиента для функции
nearby friends. Сервер заполняет мобильный клиент начальными координатами всех nearby online
friends. Позже мы разберем это подробнее.
Замечание: термины WebSocket connection и WebSocket connection handler в этой главе
взаимозаменяемы.
Redis location cache
Redis используется для хранения самых свежих location data каждого активного пользователя. Для каждой записи в cache задан Time to Live (TTL). Когда TTL истекает, пользователь считается неактивным, а его location data удаляется из cache. Каждое обновление продлевает TTL. Можно использовать и другие KV-store, поддерживающие TTL.
User database
User database хранит user data и data о дружеских связях. Для этого можно использовать как реляционную, так и NoSQL-базу.
Location history database
Эта база хранит исторические location data пользователей. Она не относится напрямую к функции
nearby friends.
Redis pub/sub server
Redis pub/sub [2] — очень легковесная message bus. Каналы в Redis pub/sub очень дешево создавать. Современный Redis-сервер с гигабайтами памяти может держать миллионы каналов (их также можно называть topics). На рисунке 6 показано, как работает Redis Pub/Sub.

Рисунок 6 Redis Pub/Sub
В этом дизайне location updates, полученные через WebSocket server, публикуются в собственный канал пользователя в Redis pub/sub server. Для каждого активного друга выделенный WebSocket connection handler подписывается на этот канал. Когда приходит location update, handler срабатывает и для каждого активного друга пересчитывает расстояние. Если новое расстояние попадает в радиус поиска, новая локация и timestamp отправляются на клиент друга через WebSocket. Можно использовать и другие message bus с легковесными каналами.
Теперь, когда мы понимаем назначение каждого компонента, посмотрим, что происходит с точки зрения системы, когда у пользователя меняется локация.
Периодическое обновление локации
Мобильный клиент периодически отправляет обновления локации по постоянному WebSocket-соединению. Поток показан на рисунке 7.
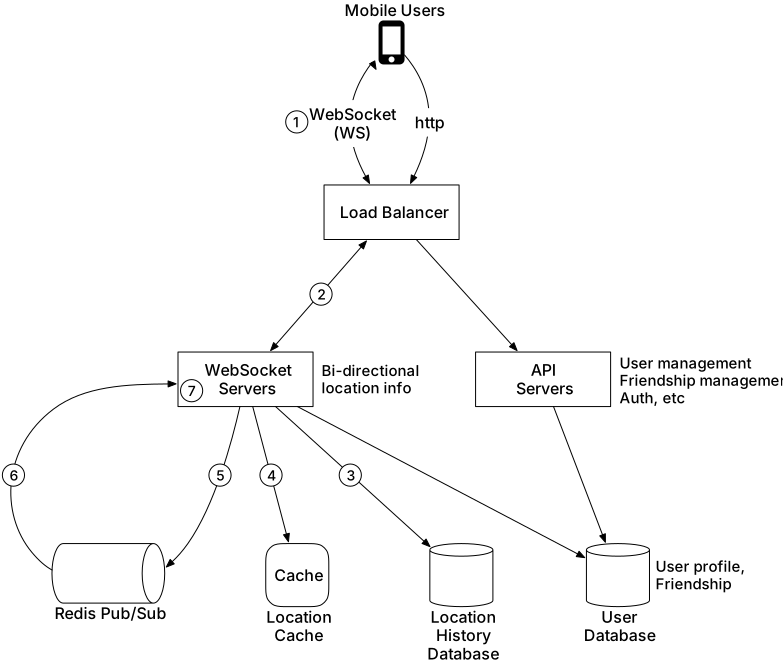
Рисунок 7 Periodic location update
-
Мобильный клиент отправляет location update в load balancer.
-
Load balancer направляет location update в persistent connection на WebSocket server, к которому подключен данный клиент.
-
WebSocket server сохраняет location data в location history database.
-
WebSocket server обновляет location cache новой локацией. Обновление продлевает TTL. Также WebSocket server сохраняет новую локацию в переменной внутри WebSocket connection handler этого пользователя для последующих вычислений расстояния.
-
WebSocket server публикует новую локацию в канал пользователя в Redis pub/sub server. Шаги 3–5 можно выполнять параллельно.
-
Когда Redis pub/sub получает location update в канале, он рассылает его всем subscribers. В данном случае subscribers — это WebSocket connection handlers всех online friends пользователя, отправившего обновление. Для каждого subscriber, то есть для каждого друга этого пользователя, его WebSocket connection handler получит обновление локации.
-
Получив сообщение, WebSocket server, на котором живет connection handler, вычисляет расстояние между пользователем, отправившим новую локацию (данные локации находятся в сообщении), и subscriber-ом (его локация хранится в переменной внутри WebSocket connection handler).
-
Этот шаг не нарисован на диаграмме. Если расстояние не превышает радиус поиска, новая локация и timestamp последнего обновления отправляются клиенту subscriber-а. Иначе обновление отбрасывается.
Поскольку понимание этого потока критически важно, посмотрим на него еще раз на конкретном примере, показанном на рисунке 8. Перед началом сделаем несколько допущений.
-
Друзья пользователя 1: пользователь 2, пользователь 3 и пользователь 4.
-
Друзья пользователя 5: пользователь 4 и пользователь 6.
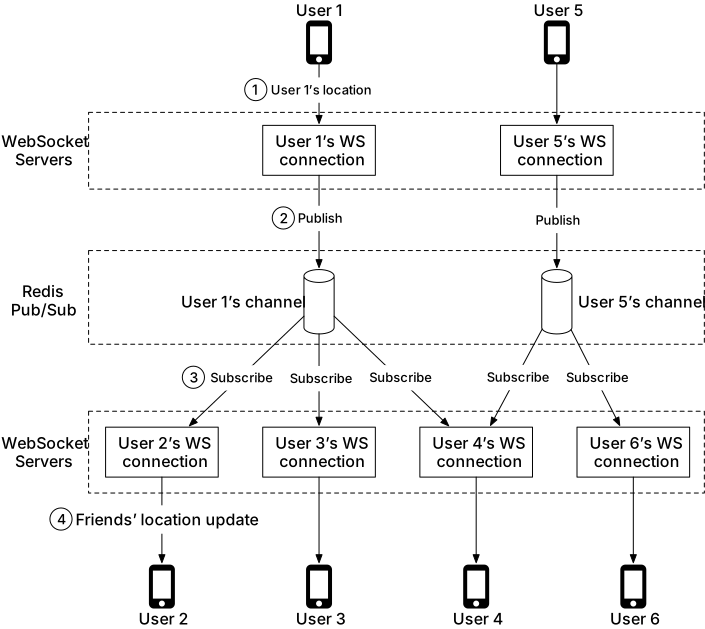
Рисунок 8 Отправка обновления локации друзьям
-
Когда у пользователя 1 меняется локация, обновление отправляется на WebSocket server, который держит его соединение.
-
Локация публикуется в канал пользователя 1 в Redis pub/sub server.
-
Redis pub/sub server рассылает location update всем subscribers. В этом случае subscribers — это WebSocket connection handlers друзей пользователя 1.
-
Если расстояние между пользователем, отправившим локацию (пользователь 1), и subscriber-ом (пользователь 2) не превышает радиус поиска, новая локация отправляется клиенту пользователя 2.
Это вычисление повторяется для каждого subscriber-а канала. Поскольку в среднем у пользователя 400 друзей и мы предполагаем, что 10% из них онлайн и рядом, для каждого location update нужно переслать примерно 40 обновлений.
API design
Теперь, когда у нас есть high-level design, перечислим нужные API.
WebSocket: пользователи отправляют и получают location updates через протокол WebSocket. На минимальном уровне нам нужны следующие API.
1. Периодическое обновление локации
Request: клиент отправляет latitude, longitude и timestamp.
Response: ничего.
2. Клиент получает обновления локации
Отправляемые данные: location data друга и timestamp.
3. Инициализация WebSocket
Request: клиент отправляет latitude, longitude и timestamp.
Response: клиент получает location data друзей.
4. Подписка на нового друга
Request: WebSocket server отправляет friend ID.
Response: последняя latitude, longitude и timestamp друга.
5. Отписка от друга
Request: WebSocket server отправляет friend ID.
Response: ничего.
HTTP requests: API servers обрабатывают задачи вроде добавления и удаления друзей, обновления профиля пользователя и т. д. Это стандартные сценарии, поэтому мы не будем разбирать их подробно.
Data model
Еще один важный элемент обсуждения — data model. Про User DB мы уже говорили в high-level design, поэтому сосредоточимся на location cache и location history database.
Location cache
Location cache хранит последние локации всех активных пользователей, у которых включена функция
nearby friends. Для этого cache мы используем Redis. Ключ и значение показаны в таблице 1.
| key | value |
|---|---|
| user_id | {latitude, longitude, timestamp} |
Таблица 1. Location cache
Почему мы не используем database для хранения location data?
Функции nearby friends нужна только текущая локация пользователя. Поэтому нам достаточно
хранить одну локацию на пользователя. Redis отлично подходит, потому что дает очень быстрые read и
write операции. Он поддерживает TTL, который мы используем для автоматического удаления из cache
пользователей, больше не являющихся активными. Текущие локации не нужно хранить надежно и
долговечно. Если инстанс Redis упадет, мы можем заменить его новым пустым инстансом и дать cache
заполниться по мере поступления новых location updates. Активные пользователи могут пропустить
один-два цикла обновлений друзей, пока новый cache прогревается. Для этой функции такой
trade-off допустим. В deep dive мы обсудим, как уменьшить влияние подобной замены на пользователей.
Location history database
Location history database хранит исторические location data пользователей и имеет такую схему:
| user_id | latitude | longitude | timestamp |
|---|
Нам нужна база данных, хорошо справляющаяся с heavy-write workload и умеющая горизонтально
масштабироваться. Cassandra — хороший кандидат. Можно использовать и реляционную базу. Но в
случае реляционной базы исторические данные не поместятся на одном инстансе, поэтому потребуется
sharding. Самый базовый подход — shard по user ID. Такая схема равномерно распределяет нагрузку
между shard-ами и operationally проста в поддержке.
Шаг 3 — Deep Dive дизайна
High-level design из предыдущего раздела работает в большинстве случаев, но на нашем масштабе он скорее всего начнет ломаться. В этом разделе мы вместе найдем bottlenecks, возникающие при росте масштаба, и по пути подумаем, как их устранять.
Насколько хорошо масштабируется каждый компонент?
API servers
Методы масштабирования RESTful API tiers хорошо известны. Это stateless servers, и есть множество способов автоматически масштабировать их по CPU usage, load или I/O. Подробно останавливаться на этом не будем.
WebSocket servers
Для WebSocket cluster несложно настроить auto-scaling по нагрузке. Однако WebSocket servers —
stateful, поэтому при удалении существующих узлов нужно действовать аккуратно. Перед тем как узел
будет убран, все существующие соединения нужно дать корректно завершить. Для этого можно пометить
узел как draining на уровне load balancer, чтобы новые WebSocket connections больше не
маршрутизировались на draining-server. Когда все существующие соединения закроются
(или пройдет достаточно много времени), сервер можно удалить.
Релиз новой версии приложения на WebSocket server требует той же осторожности.
Важно отметить, что эффективный auto-scaling stateful servers — задача хорошего load balancer. Большинство cloud load balancers умеют это очень хорошо.
Инициализация клиента
При старте мобильный клиент устанавливает persistent WebSocket connection с одним из инстансов WebSocket server. Каждое соединение долгоживущее. Большинство современных языков способны удерживать много long-running connections при довольно скромном потреблении памяти.
Когда WebSocket connection инициализируется, клиент отправляет начальную локацию пользователя, а сервер внутри WebSocket connection handler выполняет следующие действия:
-
Обновляет локацию пользователя в location cache.
-
Сохраняет локацию в переменную внутри connection handler для последующих расчетов.
-
Загружает всех друзей пользователя из user database.
-
Делает batched request в location cache, чтобы получить локации всех друзей. Поскольку на каждой записи в location cache задан TTL, совпадающий с timeout-периодом неактивности, если друг неактивен, его локации в cache не будет.
-
Для каждой локации, возвращенной cache, сервер вычисляет расстояние между пользователем и другом в этой локации. Если расстояние попадает в радиус поиска, профиль друга, его локация и timestamp последнего обновления возвращаются клиенту по WebSocket connection.
-
Для каждого друга сервер подписывается на канал друга в Redis pub/sub server. О том, как именно используется Redis pub/sub, мы поговорим чуть позже. Поскольку создавать новый канал дешево, пользователь подписывается на всех друзей, и активных, и неактивных. Неактивные друзья займут немного памяти на Redis pub/sub server, но не будут тратить CPU или I/O (потому что не публикуют обновления), пока не станут online.
-
Сервер отправляет текущую локацию пользователя в канал самого пользователя в Redis pub/sub server.
User database
User database хранит два разных набора данных: user profiles (user ID, username, profile URL
и т. д.) и friendship data. При нашем масштабе дизайна эти данные, скорее всего, не поместятся в
один инстанс реляционной базы. Хорошая новость в том, что данные хорошо масштабируются
горизонтально через sharding по user ID. Sharding реляционных БД — очень распространенная
техника.
Небольшое замечание: на масштабе, под который мы проектируем, данные о пользователях и дружбе, скорее всего, обслуживаются отдельной командой и доступны через внутренний API. В таком сценарии WebSocket servers будут использовать внутренний API вместо прямых запросов в базу для получения user- и friendship-related data. С точки зрения функциональности и производительности разница небольшая.
Location cache
Мы выбираем Redis для кэширования самых свежих локаций всех активных пользователей. Как уже говорилось, для каждого ключа также задается TTL. TTL продлевается при каждом обновлении локации. Это ограничивает максимальный объем памяти. Если пик — 10 миллионов активных пользователей, а одна локация занимает не более 100 байт, то один современный Redis server с большим объемом памяти должен без труда хранить location information всех пользователей.
Однако при 10 миллионах активных пользователей, которые обновляют локацию примерно каждые
30 секунд, Redis server придется выдерживать 334K updates в секунду. Это, скорее всего, уже
слишком много даже для современного high-end сервера. К счастью, эти cache data легко shard-ить.
Location data каждого пользователя независимы, и мы можем равномерно распределить нагрузку между
несколькими Redis servers, shard-ив location data по user ID.
Чтобы повысить availability, можно реплицировать location data каждого shard-а на standby node. Если primary node упадет, standby можно быстро повысить до primary и минимизировать downtime.
Redis pub/sub server
Pub/sub server используется как routing layer, направляющий сообщения (обновления локации) от одного пользователя всем его online friends. Как уже говорилось, мы выбираем Redis pub/sub, потому что в нем очень дешево создавать новые каналы. Новый канал создается, когда кто-то на него подписывается. Если сообщение публикуется в канал без subscribers, оно просто отбрасывается, создавая минимальную нагрузку на сервер. При создании канала Redis использует небольшой объем памяти для hash table и linked list [3], в которых отслеживаются subscribers. Если пользователь offline и в канале нет обновлений, после создания канала CPU больше не расходуется. Мы используем это в дизайне так:
-
Каждому пользователю, использующему функцию
nearby friends, назначается уникальный канал. При инициализации приложения пользователь подписывается на канал каждого друга, независимо от того, online друг или нет. Это упрощает дизайн, потому что backend не нужно отдельно подписываться на канал друга, когда тот становится активным, и отписываться, когда тот становится неактивным. -
Trade-off состоит в том, что дизайн использует больше памяти. Как увидим позже, память здесь вряд ли будет bottleneck. Поэтому обменять больший расход памяти на более простую архитектуру — разумно.
Сколько Redis pub/sub servers нам нужно?
Давайте посчитаем memory usage и CPU usage.
Использование памяти
Если для каждого пользователя, использующего nearby friends, выделяется отдельный канал, нам нужно
100 миллионов каналов (1 миллиард * 10%). Предположим, что в среднем у пользователя 100
активных друзей, использующих эту функцию
(сюда входят и nearby-друзья, и те, кто просто активен, но не рядом), и на отслеживание каждого
subscriber-а во внутренней hash table и linked list уходит около 20 байт указателей. Тогда для
всех каналов понадобится около 200 ГБ
(100 миллионов * 20 bytes * 100 friends / 10^9 = 200 GB). Для современного сервера с 100 ГБ
памяти потребуется примерно 2 Redis pub/sub servers, чтобы удержать все каналы.
Использование CPU
Как мы уже посчитали, pub/sub server пересылает subscribers около 14 миллионов обновлений в
секунду. Точно оценить, сколько сообщений в секунду может вытолкнуть современный Redis server без
реального benchmarking, сложно, но можно смело предположить, что одного Redis server не хватит.
Возьмем консервативную оценку и предположим, что современный сервер с гигабитной сетью способен
обрабатывать примерно 100,000 pushes в секунду. С учетом того, насколько малы наши сообщения об
обновлении локации, эта оценка, скорее всего, даже излишне консервативна. При такой оценке нам
понадобится распределить нагрузку между 14 миллионов / 100,000 = 140 Redis servers. И это,
вероятно, завышенная цифра; реальное число серверов может быть заметно ниже.
Из этих расчетов делаем вывод:
-
Bottleneck Redis pub/sub server — это CPU usage, а не память.
-
Чтобы поддержать наш масштаб, нам нужен распределенный Redis pub/sub cluster.
Распределенный кластер Redis pub/sub servers
Как распределить каналы между сотнями Redis servers? Хорошая новость в том, что каналы независимы
друг от друга. Это заметно упрощает распределение каналов по нескольким pub/sub servers через
sharding по publisher user ID. Но на практике, если у нас сотни pub/sub servers, полезно чуть
подробнее описать, как это устроено operationally, потому что серверы неизбежно иногда падают.
Здесь мы вводим в дизайн компонент service discovery. Существует много пакетов для service discovery; среди самых популярных — etcd [4] и Zookeeper [5]. Наши требования к этому компоненту очень просты. Нам нужны две возможности:
-
Уметь хранить список серверов в service discovery и иметь простой UI или API для его обновления. По сути, service discovery — это небольшой key-value store для конфигурационных данных. Например, как на рисунке 9, ключ и значение для hash ring могут выглядеть так:
Key:/config/pub_sub_ring
Value:[ “p_1”, “p_2”, “p_3”, “p_4” ] -
Уметь давать клиентам (в нашем случае WebSocket servers) подписываться на любые обновления этого
Value(списка Redis pub/sub servers).
Под Key, упомянутым в пункте 1, мы храним hash ring всех активных Redis pub/sub servers в
service discovery component (о деталях hash ring см. главу про consistent hashing в первом томе
System Design Interview или [6]). Hash ring используется publishers и subscribers Redis pub/sub,
чтобы определить, к какому pub/sub server нужно обращаться для каждого канала. Например, канал 2
на рисунке 9 живет в Redis pub/sub server 1.
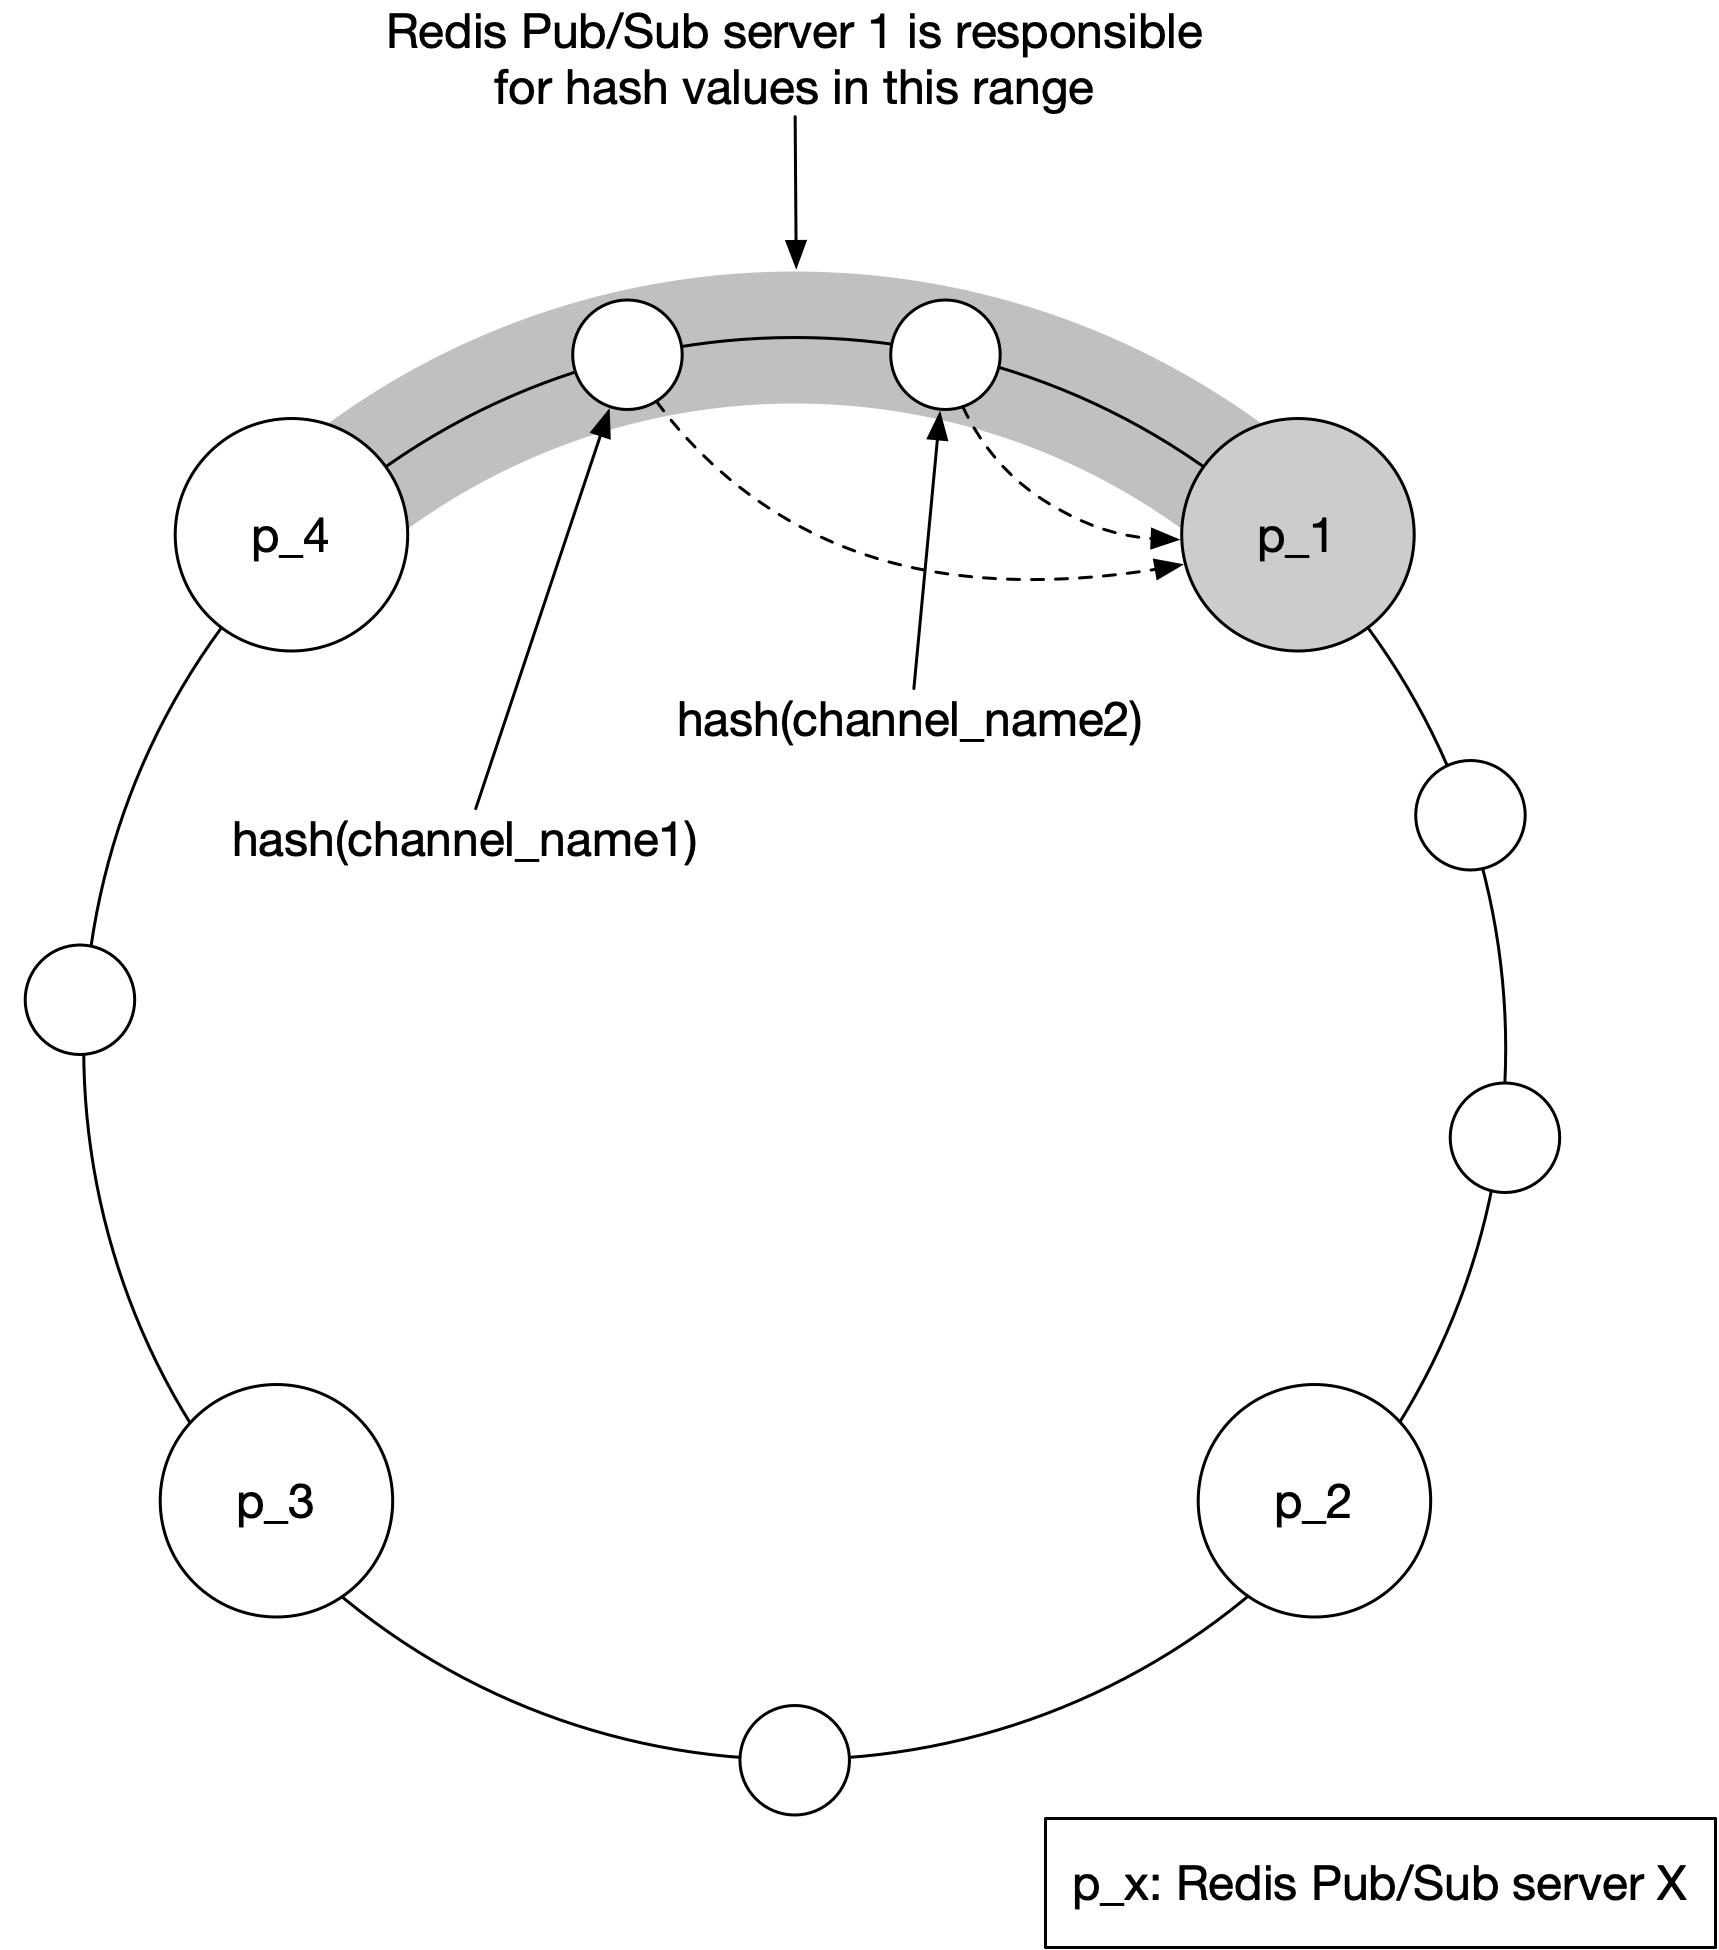
Рисунок 9 Consistent hashing
На рисунке 10 показано, что происходит, когда WebSocket server публикует обновление локации в канал пользователя.
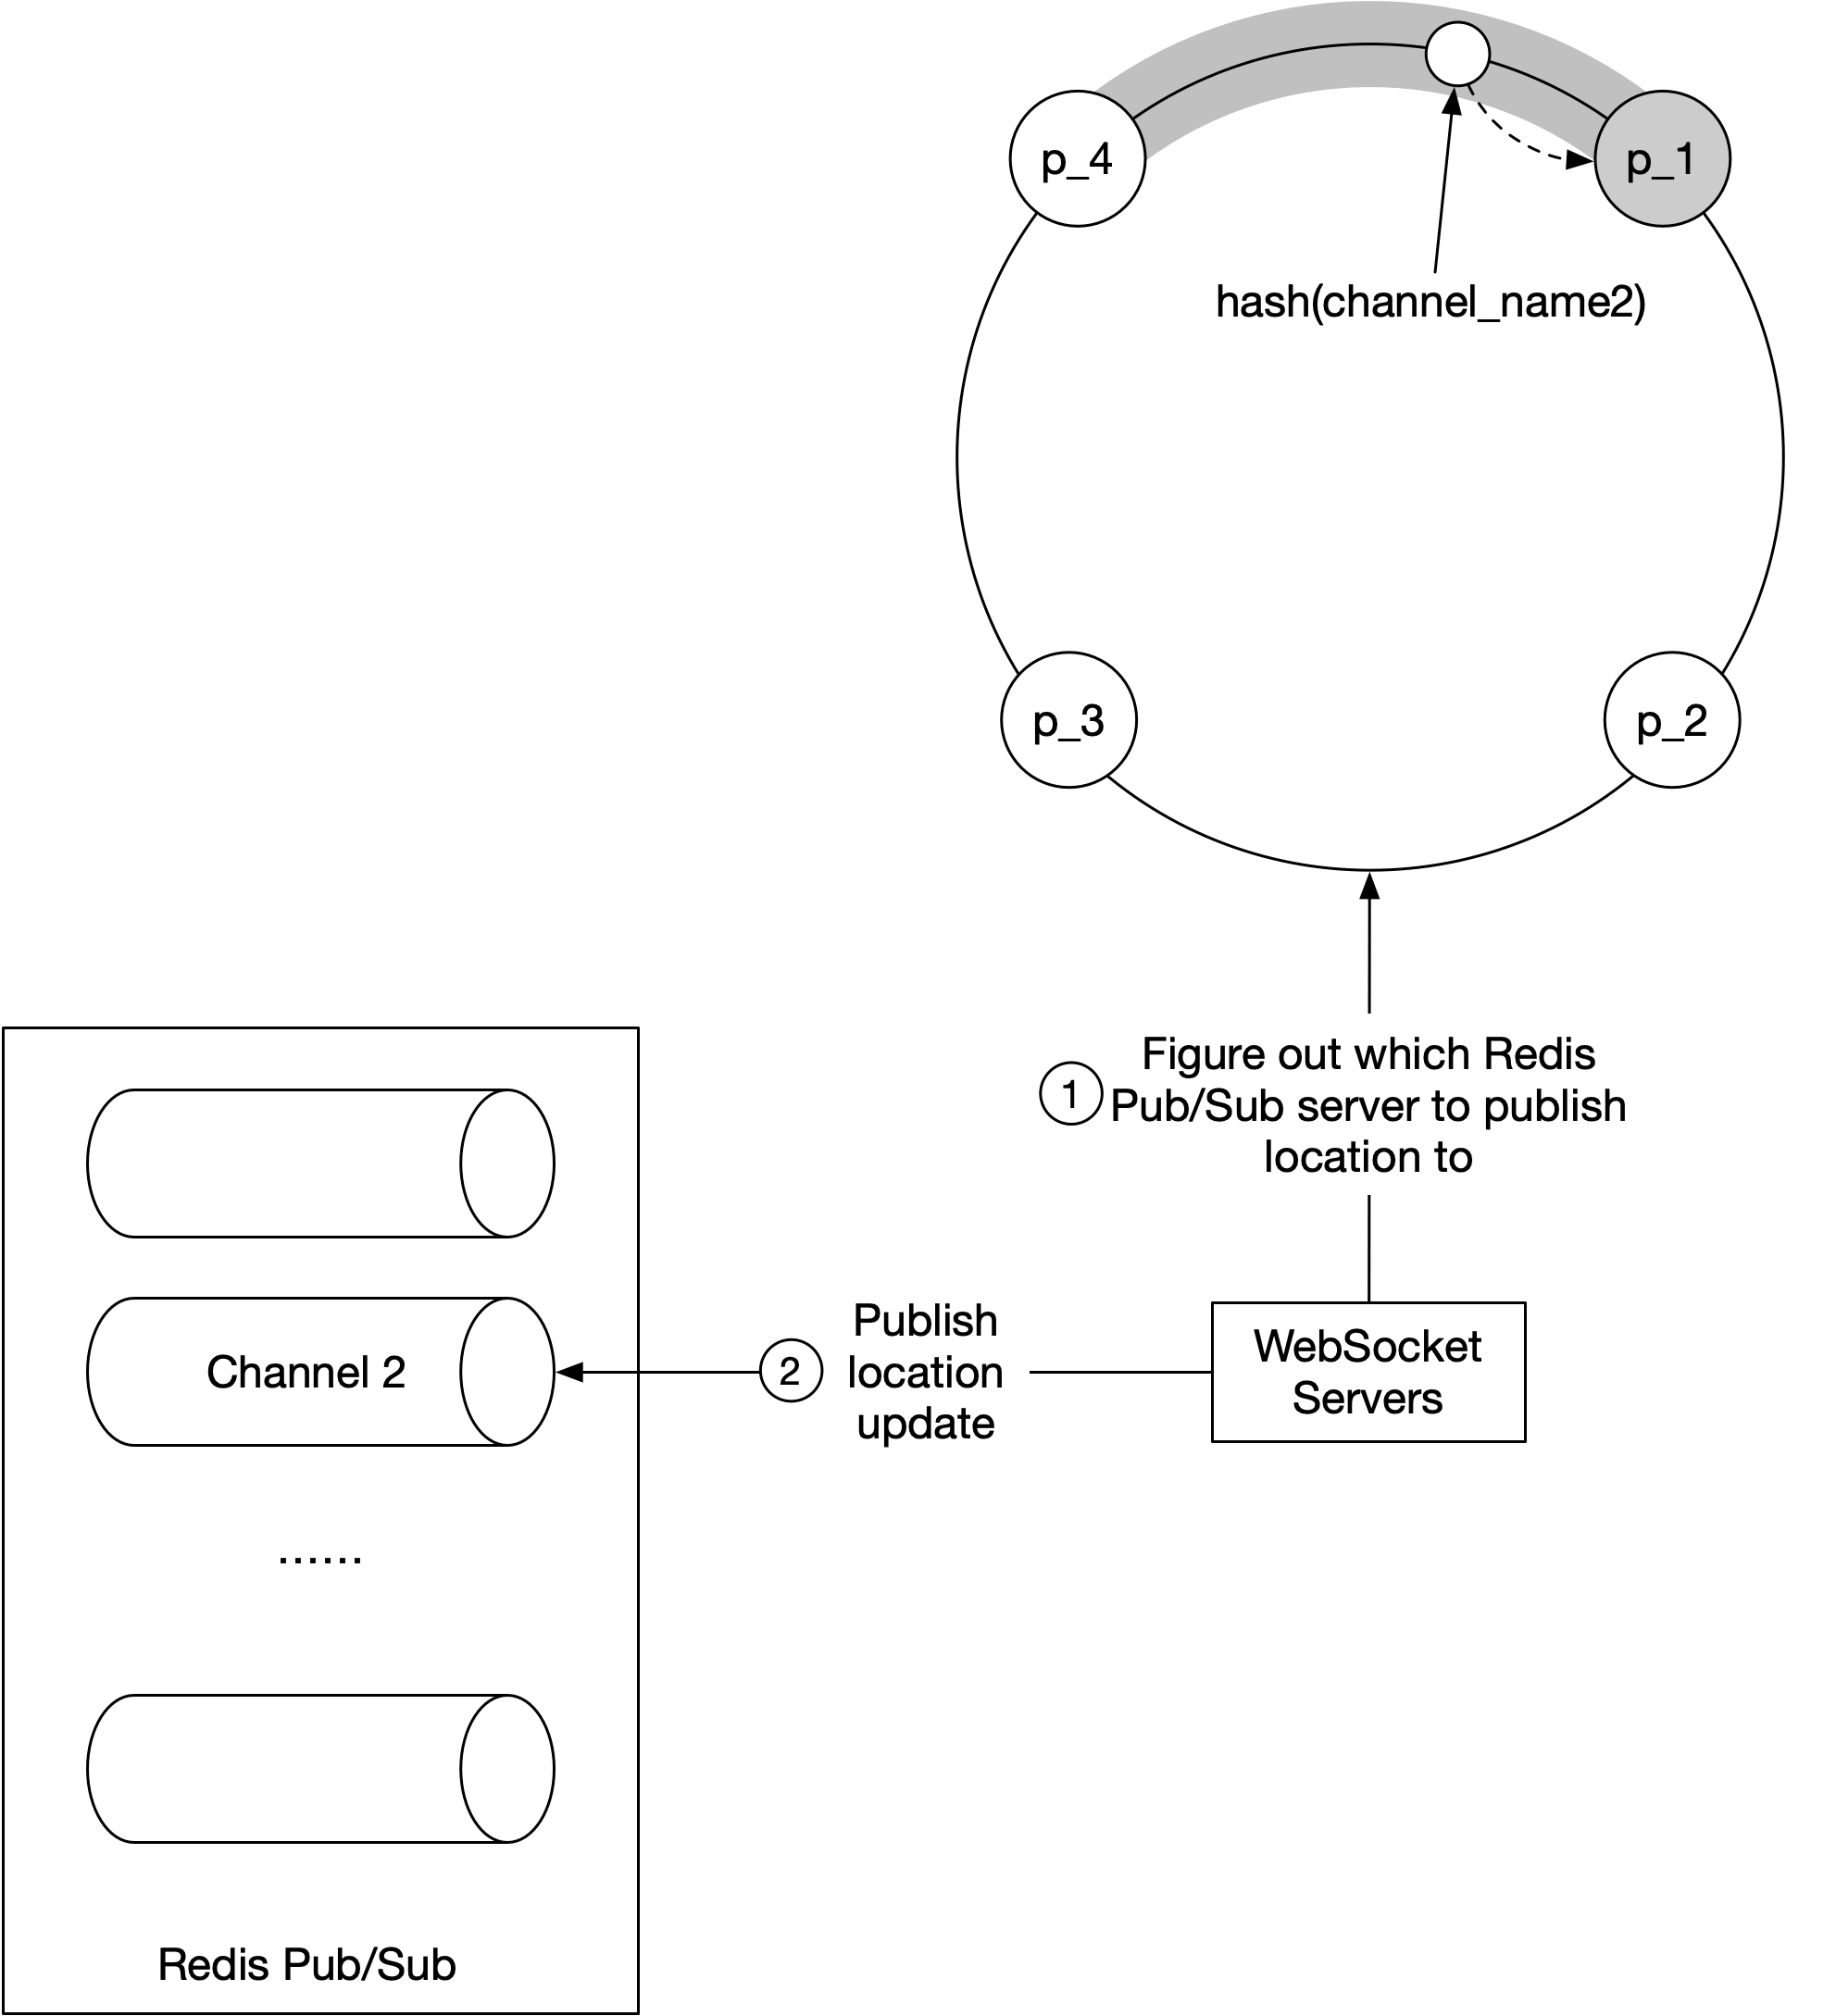
Рисунок 10 Определение правильного Redis pub/sub server
-
WebSocket server обращается к hash ring, чтобы определить, в какой Redis pub/sub server писать. Источник истины хранится в service discovery, но для эффективности копия hash ring может кэшироваться на каждом WebSocket server. WebSocket server подписывается на обновления hash ring, чтобы держать локальную in-memory copy актуальной.
-
WebSocket server публикует location update в канал пользователя на соответствующем Redis pub/sub server.
Подписка на канал для получения location updates использует тот же самый механизм.
Соображения по масштабированию Redis pub/sub servers
Как нам масштабировать Redis pub/sub cluster? Нужно ли ежедневно расширять и сужать его в зависимости от трафика? Для stateless servers это обычная практика: она малорисковая и помогает экономить. Чтобы ответить, посмотрим на свойства Redis pub/sub cluster.
-
Сообщения, отправляемые в pub/sub channel, не сохраняются ни в памяти, ни на диске. Они рассылаются всем subscribers канала и сразу удаляются. Если subscribers нет, сообщения просто отбрасываются. В этом смысле данные, проходящие через pub/sub channel, stateless.
-
Однако pub/sub servers все-таки хранят состояния для каналов. В частности, subscriber list каждого канала — это ключевая часть state, которую отслеживают pub/sub servers. Если канал переезжает, что может случиться при замене pub/sub server, либо когда на hash ring добавляется новый server или убирается старый, каждый subscriber этого канала должен об этом узнать, чтобы отписаться от канала на старом сервере и заново подписаться на replacement channel на новом сервере. В этом смысле pub/sub server stateful, и координацию со всеми subscribers нужно оркестрировать так, чтобы минимизировать перебои в сервисе.
По этим причинам к Redis pub/sub cluster стоит относиться как к stateful cluster, почти как к storage cluster. Для stateful clusters масштабирование вверх и вниз несет operational overhead и риски, поэтому его нужно делать аккуратно и осознанно. Обычно cluster слегка over-provisioned, чтобы уверенно выдерживать ежедневный пик трафика с запасом и не делать лишних resizing-операций.
Когда масштабироваться все же приходится, стоит помнить о таких потенциальных проблемах:
-
При resizing cluster многие каналы переедут на другие servers на hash ring. Когда service discovery сообщит всем WebSocket servers об обновлении hash ring, возникнет огромный поток запросов на повторную подписку.
-
Во время таких массовых resubscription events клиенты могут пропустить часть location updates. Хотя редкие пропуски для нашего дизайна допустимы, число таких ситуаций стоит минимизировать.
-
Из-за потенциальных перебоев resizing лучше делать в то время суток, когда нагрузка минимальна.
Как именно делается resizing? Довольно просто:
-
Определяем новый размер ring и, если масштабируемся вверх, поднимаем нужное число новых серверов.
-
Обновляем ключ hash ring новыми значениями.
-
Следим за dashboard. В WebSocket cluster должен наблюдаться всплеск CPU usage.
Если взять hash ring с рисунка 9 и добавить два новых узла, p_5 и p_6, hash ring обновится
так:
Old: [ “p_1”, “p_2”, “p_3”, “p_4” ]
New: [ “p_1”, “p_2”, “p_3”, “p_4”, “p_5”, “p_6” ]
Operational considerations для Redis pub/sub servers
Operational risk при замене существующего Redis pub/sub server намного, намного ниже. Такая замена не вызывает массового перемещения каналов. Обрабатывать придется только каналы с заменяемого сервера. Это хорошо, потому что серверы неизбежно время от времени падают и требуют замены.
Когда pub/sub server падает, monitoring software должен оповестить on-call инженера. Точно описывать, как monitoring software определяет здоровье pub/sub server, мы не будем — это вне scope главы. On-call инженер обновляет ключ hash ring в service discovery, заменяя упавший узел на свежий standby node. WebSocket servers получают уведомление об обновлении, после чего каждый сервер уведомляет свои connection handlers о необходимости заново подписаться на каналы на новом pub/sub server. Каждый WebSocket handler хранит список всех каналов, на которые он подписан, и после получения уведомления от сервера проверяет каждый канал по hash ring, чтобы определить, нужно ли переподписаться на новый server.
Если использовать hash ring с рисунка 9 и представить, что p_1 упал, а мы заменили его на
p_1_new, hash ring обновится так:
Old: [ “p_1”, “p_2”, “p_3”, “p_4” ]
New: [ “p_1_new”, “p_2”, “p_3”, “p_4” ]
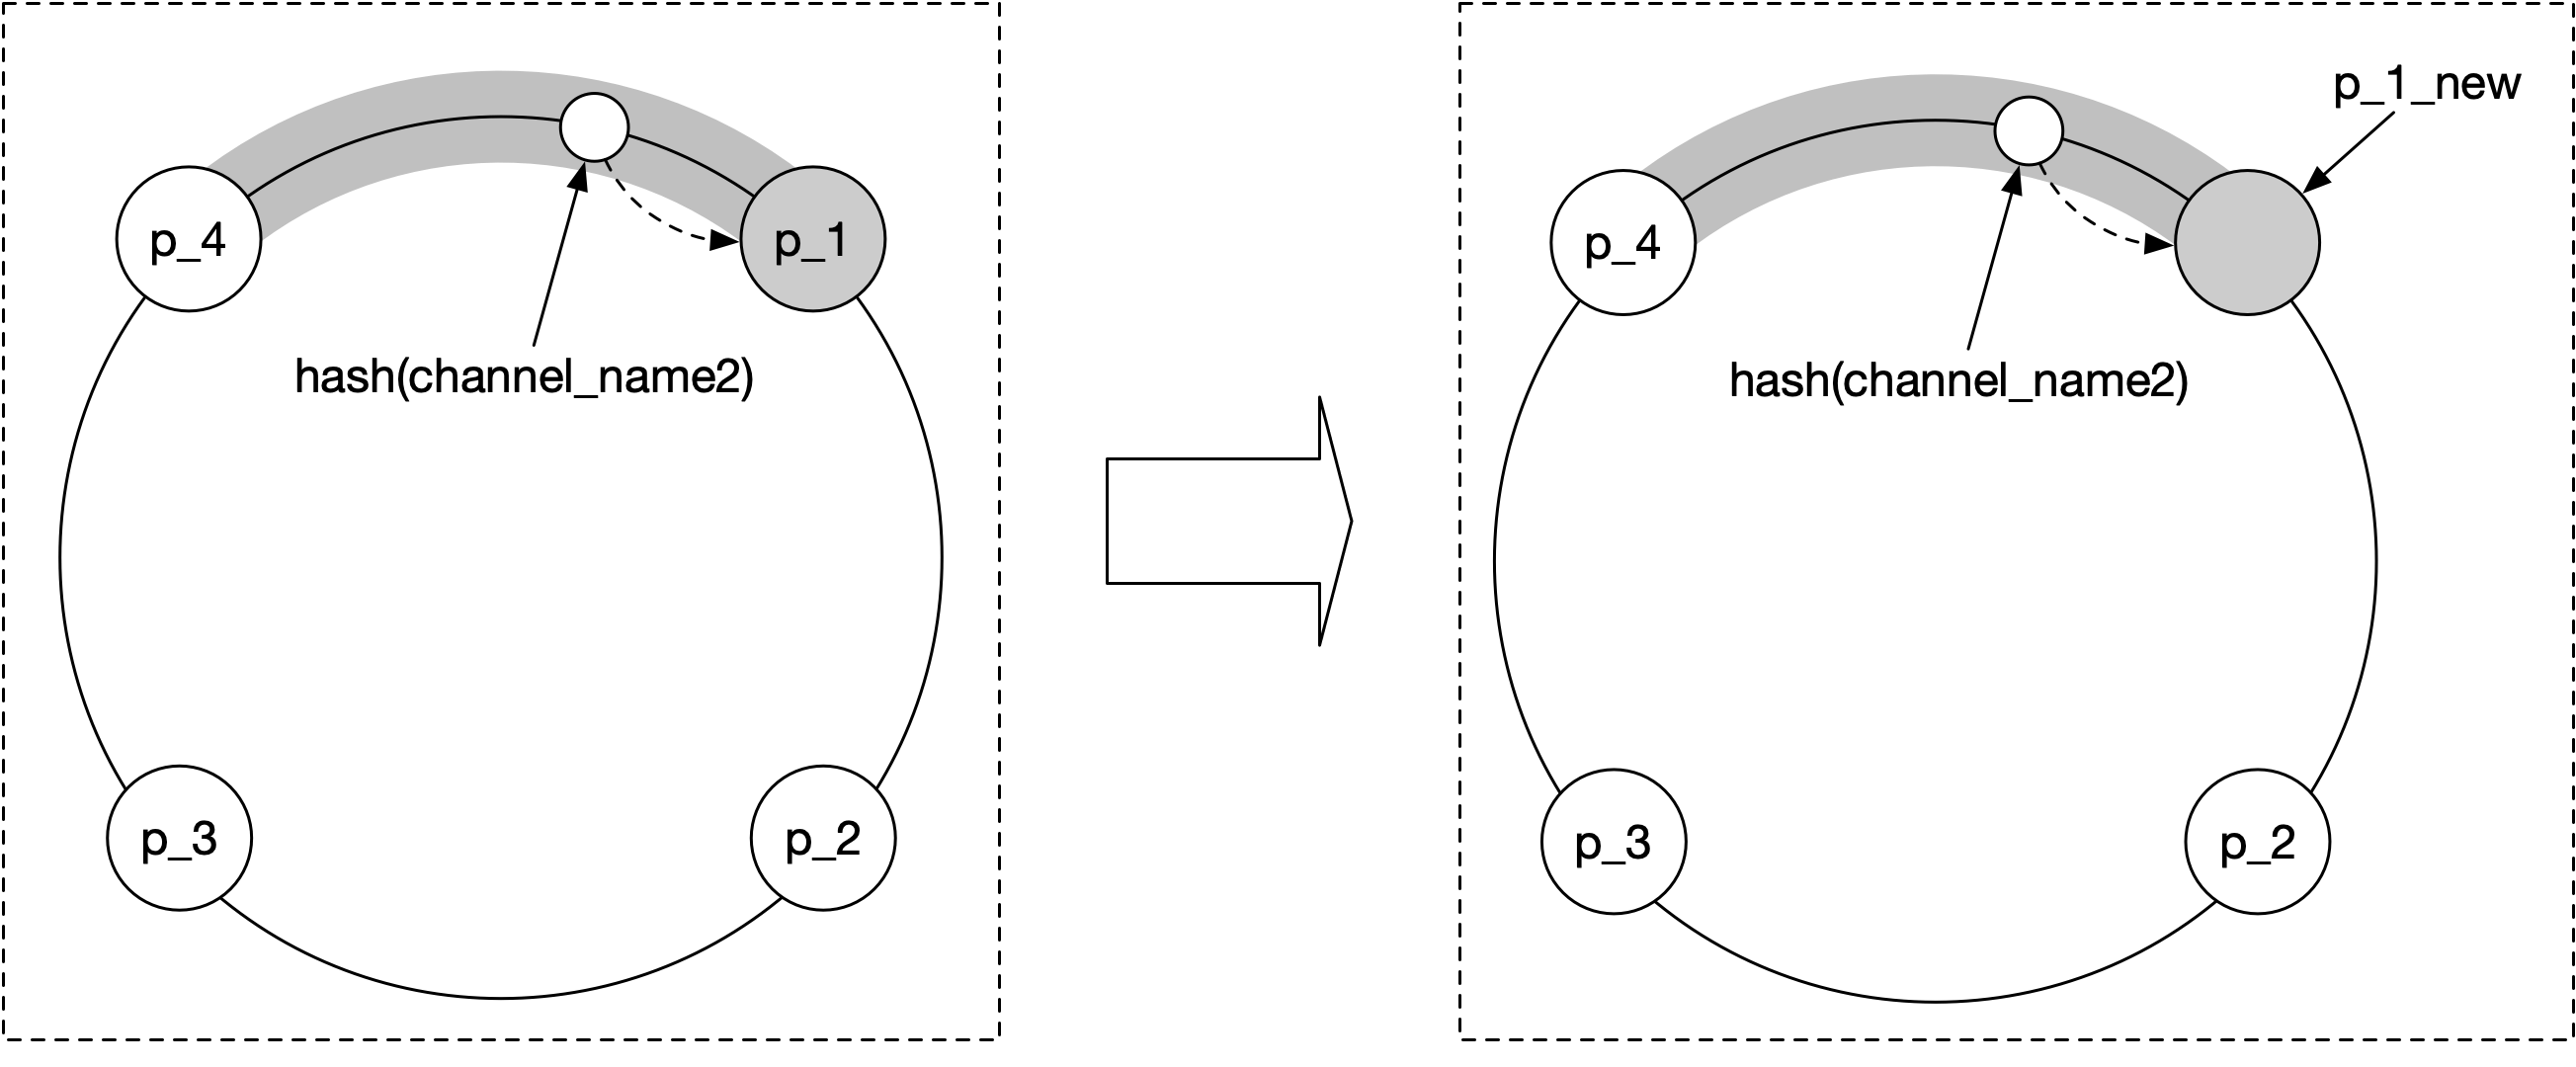
Рисунок 11 Замена pub/sub server
Добавление и удаление друзей
Что должен делать клиент, когда пользователь добавляет или удаляет друга? Когда добавляется новый друг, WebSocket connection handler клиента на сервере должен быть уведомлен, чтобы подписаться на канал нового друга в pub/sub.
Поскольку функция nearby friends является частью экосистемы большого приложения, можно
предположить, что на мобильном клиенте эта функция сможет зарегистрировать callback, который
срабатывает при добавлении нового друга. Этот callback, будучи вызванным, отправляет сообщение на
WebSocket server с запросом подписаться на канал нового друга. WebSocket server также возвращает
сообщение с последней локацией и timestamp нового друга, если тот активен.
Аналогично клиент может зарегистрировать callback, который вызывается, когда друг удаляется. Такой callback отправит на WebSocket server сообщение об отписке от канала этого друга.
Этот subscribe/unsubscribe callback можно использовать и в ситуации, когда друг явно включил или выключил передачу своей геолокации.
Пользователи с большим числом друзей
Стоит обсудить, может ли пользователь с большим числом друзей создать hotspots в нашем дизайне. Мы предполагаем, что существует жесткий cap на число друзей (например, у Facebook лимит — 5,000 друзей). Friendships двунаправленные. Мы не рассматриваем follower-модель, где у знаменитости могут быть миллионы подписчиков.
В сценарии с тысячами друзей pub/sub subscribers будут разбросаны по множеству WebSocket servers в кластере. Нагрузка от обновлений распределится между ними, поэтому hotspots маловероятны.
Пользователь создаст чуть большую нагрузку на тот pub/sub server, где живет его канал. Но так как
у нас более 100 pub/sub servers, такие whale users распределятся по ним, и дополнительная
нагрузка не должна перегрузить ни один отдельный сервер.
Nearby random person
Этот раздел можно считать бонусным: его не было в исходных функциональных требованиях. Что если интервьюер захочет расширить дизайн и показывать случайных людей поблизости, которые тоже согласились делиться локацией?
Один из способов сделать это, опираясь на наш дизайн, — добавить набор pub/sub channels по geohash. Подробности о geohash есть в главе про Proximity Service. Как показано на рисунке 12, область делится на четыре geohash grid, и для каждой grid создается канал.

Рисунок 12 Redis pub/sub channels (источник карты: [7])
Любой пользователь внутри grid подписывается на один и тот же канал. Возьмем для примера grid
9q8znd, как на рисунке 13.
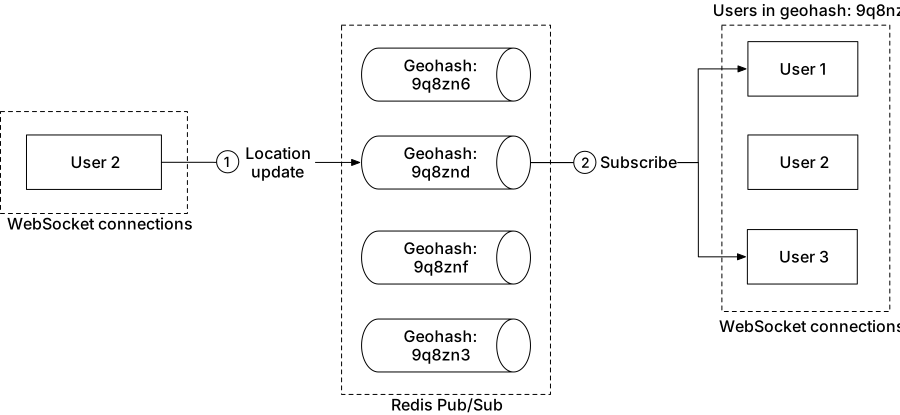
Рисунок 13 Публикация location update случайному nearby-пользователю
-
Когда пользователь 2 обновляет свою локацию, WebSocket connection handler вычисляет geohash ID пользователя и отправляет локацию в канал соответствующего geohash.
-
Любой nearby-пользователь, подписанный на этот канал (кроме отправителя), получит location update message.
Чтобы корректно обрабатывать людей у границы geohash grid, каждый клиент может подписываться на geohash, в котором находится пользователь, и на восемь окружающих geohash grids. Пример, где выделены все девять geohash grids, показан на рисунке 14.
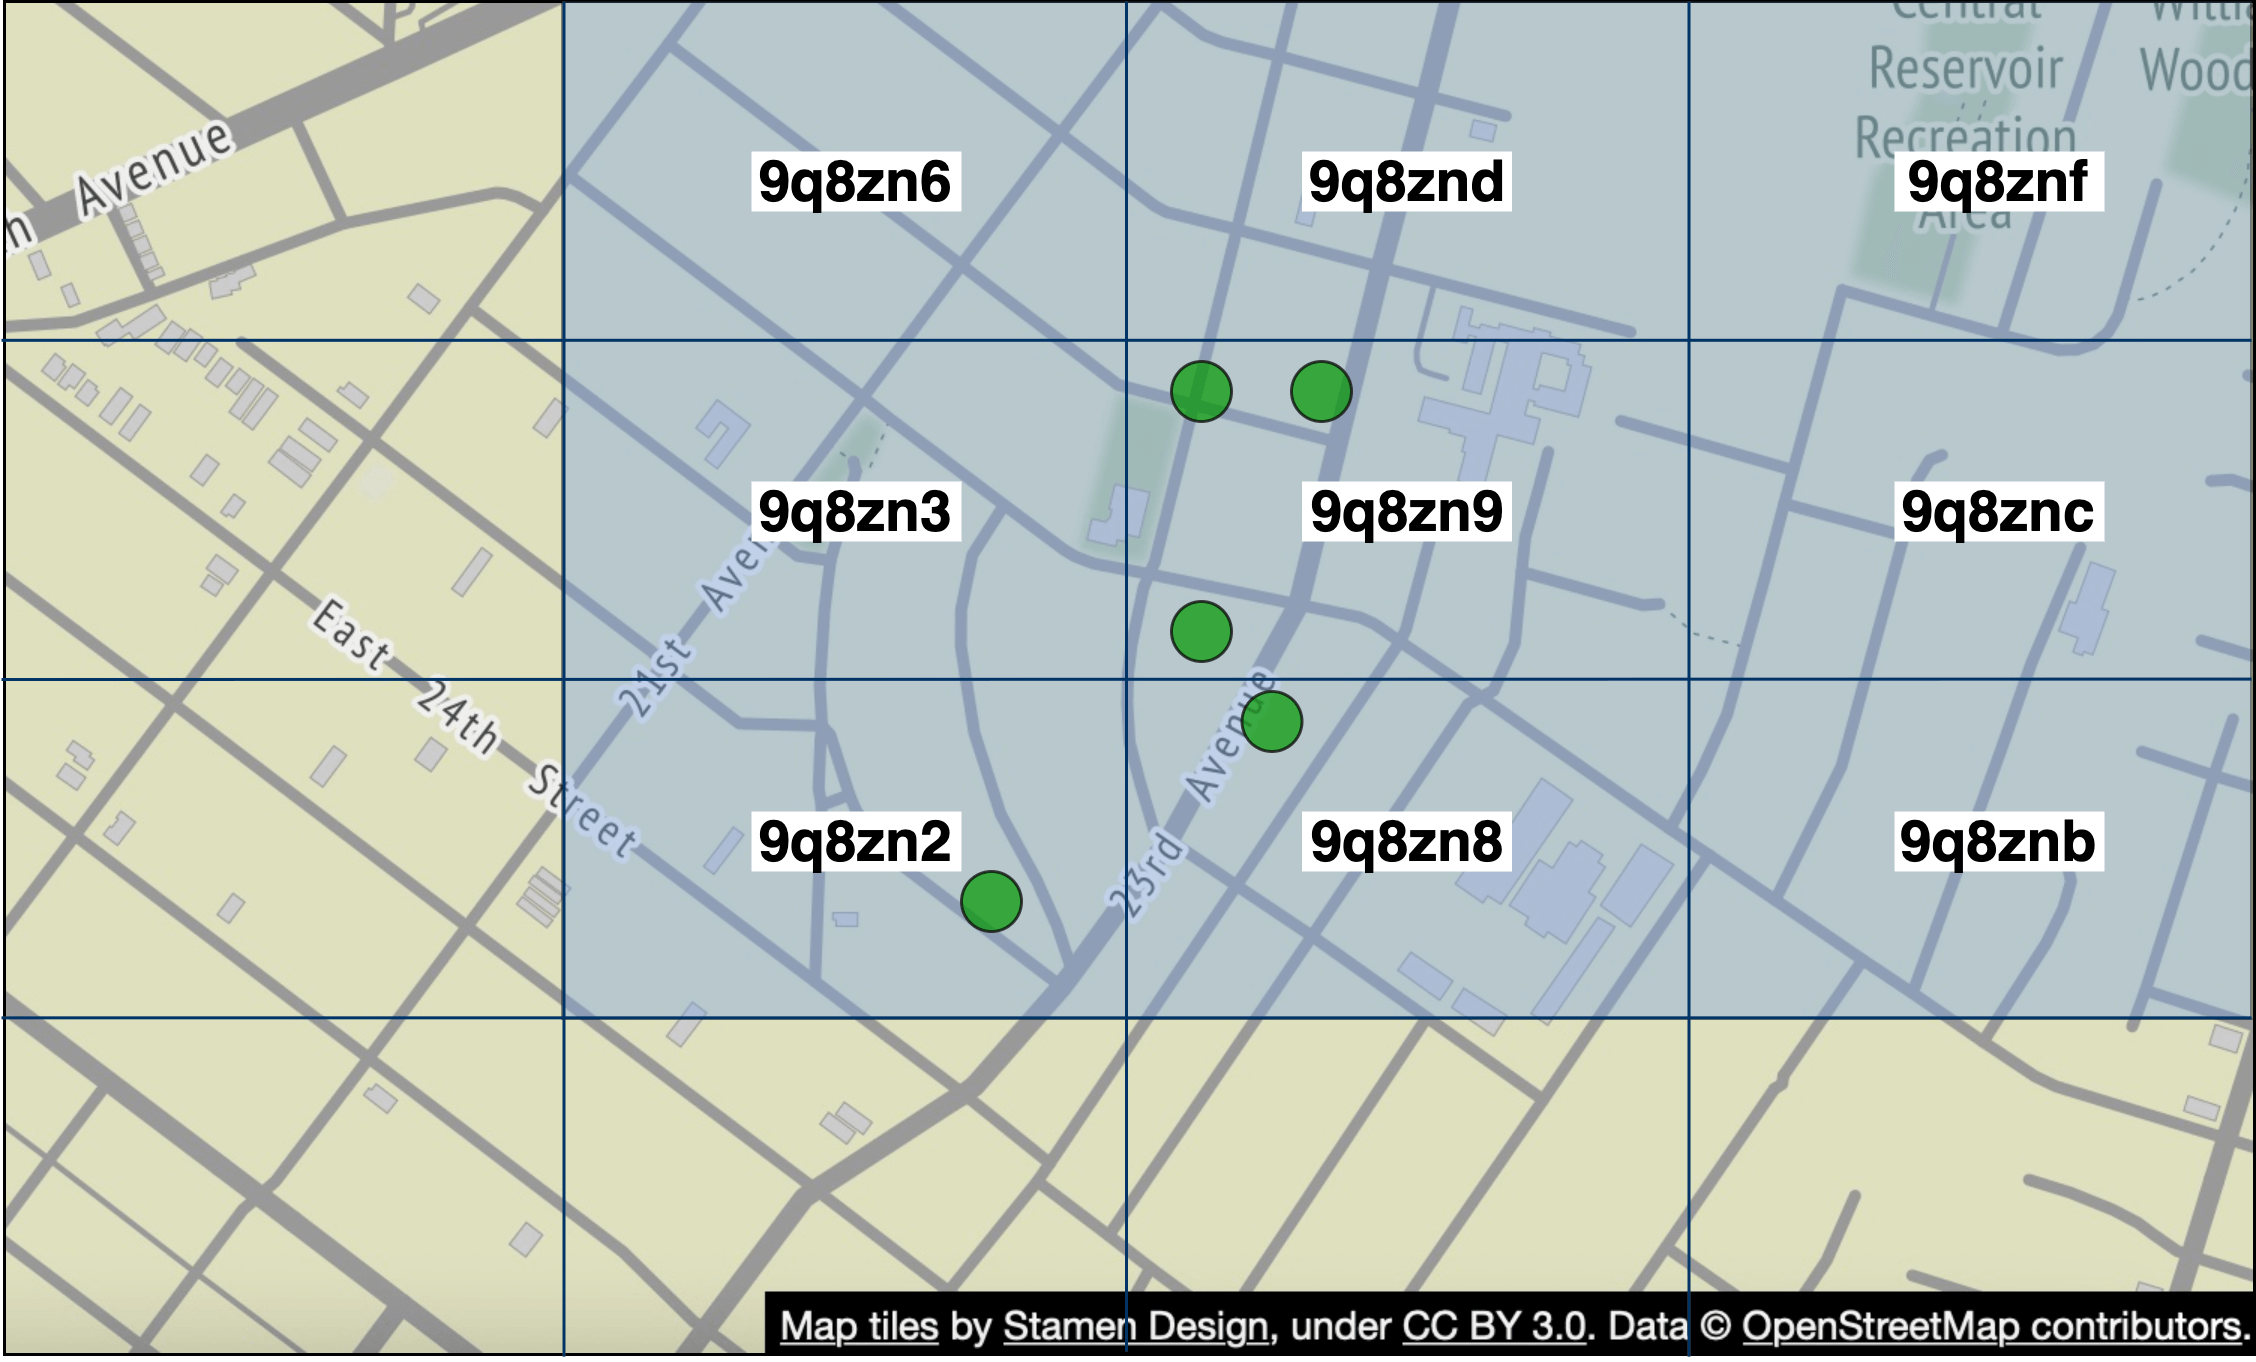
Рисунок 14 Девять geohash grids (источник карты: [7])
Альтернатива Redis pub/sub
Есть ли хорошая альтернатива Redis pub/sub как routing layer? Да, и очень хорошая. Erlang [8] — отличное решение именно для этой задачи. Мы бы даже сказали, что Erlang лучше, чем предложенный выше Redis pub/sub. Но Erlang — достаточно нишевая технология, и хороших Erlang-разработчиков сложно нанимать. Если же в команде есть экспертиза в Erlang, это отличный вариант.
Почему именно Erlang? Erlang — это язык общего назначения и runtime environment, созданные для
сильно распределенных и highly concurrent приложений. Когда мы говорим здесь Erlang, мы имеем в
виду весь Erlang ecosystem. Сюда входят языковая часть (Erlang или Elixir [9]), runtime
environment и библиотеки (Erlang virtual machine под названием BEAM [10] и runtime-библиотеки
Erlang под названием OTP [11]).
Сила Erlang — в его легковесных процессах. Erlang process — это сущность, выполняющаяся на BEAM VM. Создавать такие процессы на порядки дешевле, чем Linux process. Минимальный Erlang process занимает около 300 байт, и на одном современном сервере можно держать миллионы таких процессов. Если в Erlang process нет работы, он просто висит, не потребляя CPU cycles. Иными словами, модель, в которой каждый из 10 миллионов активных пользователей в нашем дизайне представлен отдельным Erlang process, оказывается крайне дешевой.
Кроме того, Erlang очень легко распределяется между большим числом Erlang servers. Operational overhead здесь низкий, при этом есть отличные инструменты для безопасной отладки живых production-проблем. Deployment tools тоже очень сильные.
Как использовать Erlang в нашем дизайне? Мы могли бы реализовать WebSocket service на Erlang, а также заменить весь cluster Redis pub/sub распределенным Erlang-приложением. В таком приложении каждый пользователь моделируется Erlang process-ом. User process получал бы обновления от WebSocket server, когда клиент обновляет свою локацию. Этот же process подписывался бы на обновления от Erlang processes друзей пользователя. Подписка нативно поддерживается в Erlang/OTP, и ее легко построить. В итоге получается mesh из соединений, который эффективно маршрутизирует обновления локации от одного пользователя ко многим друзьям.
Шаг 4 — Wrap-up
В этой главе мы представили дизайн, поддерживающий функцию nearby friends. Концептуально нам нужно построить систему, которая эффективно передает обновления локации от одного пользователя его друзьям.
Некоторые из ключевых компонентов:
-
WebSocket: real-time communication между клиентами и сервером.
-
Redis: быстрые read и write операции для location data.
-
Redis pub/sub: routing layer, направляющий location updates от одного пользователя всем online friends.
Сначала мы предложили high-level design для меньшего масштаба, а затем обсудили сложности, появляющиеся при росте масштаба. Мы разобрали, как масштабировать:
-
RESTful API servers
-
WebSocket servers
-
Data layer
-
Redis pub/sub servers
-
Альтернативу Redis pub/sub
В конце мы обсудили возможные bottlenecks для пользователя с большим числом друзей и предложили
дизайн для функции nearby random person.
Поздравляю, вы дошли до конца! Можно похлопать себе по плечу — отличная работа.
Краткое содержание главы
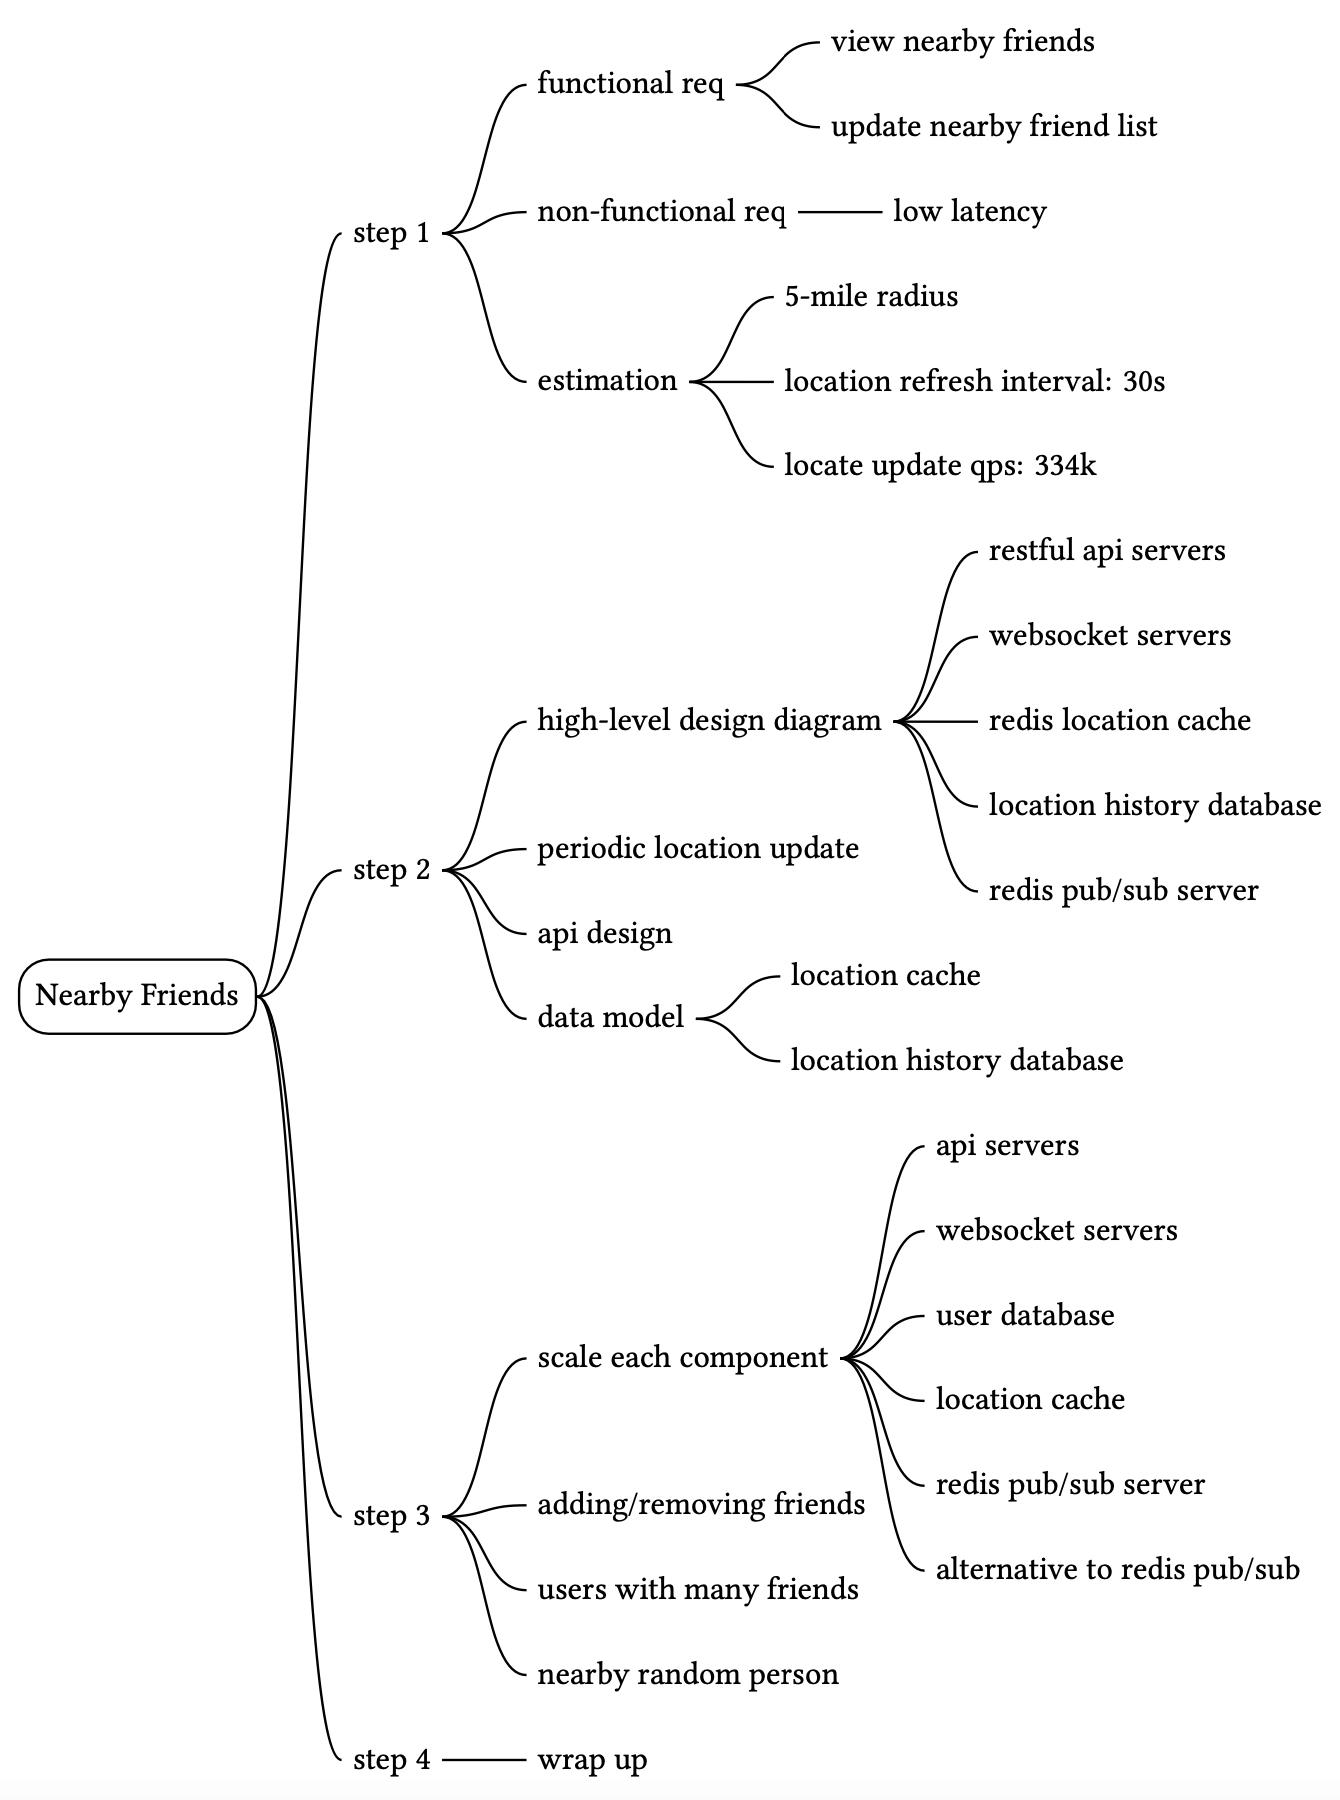
Справочные материалы
[1] Facebook Launches “Nearby Friends”: https://techcrunch.com/2014/04/17/facebook-nearby-friends/
[2] Redis Pub/Sub: https://redis.io/topics/pubsub
[3] Redis Pub/Sub under the hood: https://jameshfisher.com/2017/03/01/redis-pubsub-under-the-hood/
[4] etcd: https://etcd.io/
[5] Zookeeper: https://zookeeper.apache.org/
[6] Consistent hashing: https://www.toptal.com/big-data/consistent-hashing
[7] OpenStreetMap: www.openstreetmap.org
[8] Erlang: https://www.erlang.org/
[9] Elixir: https://elixir-lang.org/
[10] A brief introduction to BEAM: https://www.erlang.org/blog/a-brief-beam-primer/
[11] OTP: https://www.erlang.org/doc/design_principles/des_princ.html