Поиск ближайших объектов
В этой главе мы проектируем proximity service. Такой сервис используется для поиска ближайших объектов, например ресторанов, отелей, кинотеатров, музеев и т. д. Это базовый компонент, на котором строятся функции вроде поиска лучших ресторанов поблизости в Yelp или k ближайших заправок в Google Maps. На рисунке 1 показан интерфейс, через который можно искать ближайшие рестораны в Yelp [1]. Обратите внимание: map tiles, использованные в этой главе, взяты у Stamen Design [2], а данные — из OpenStreetMap [3].
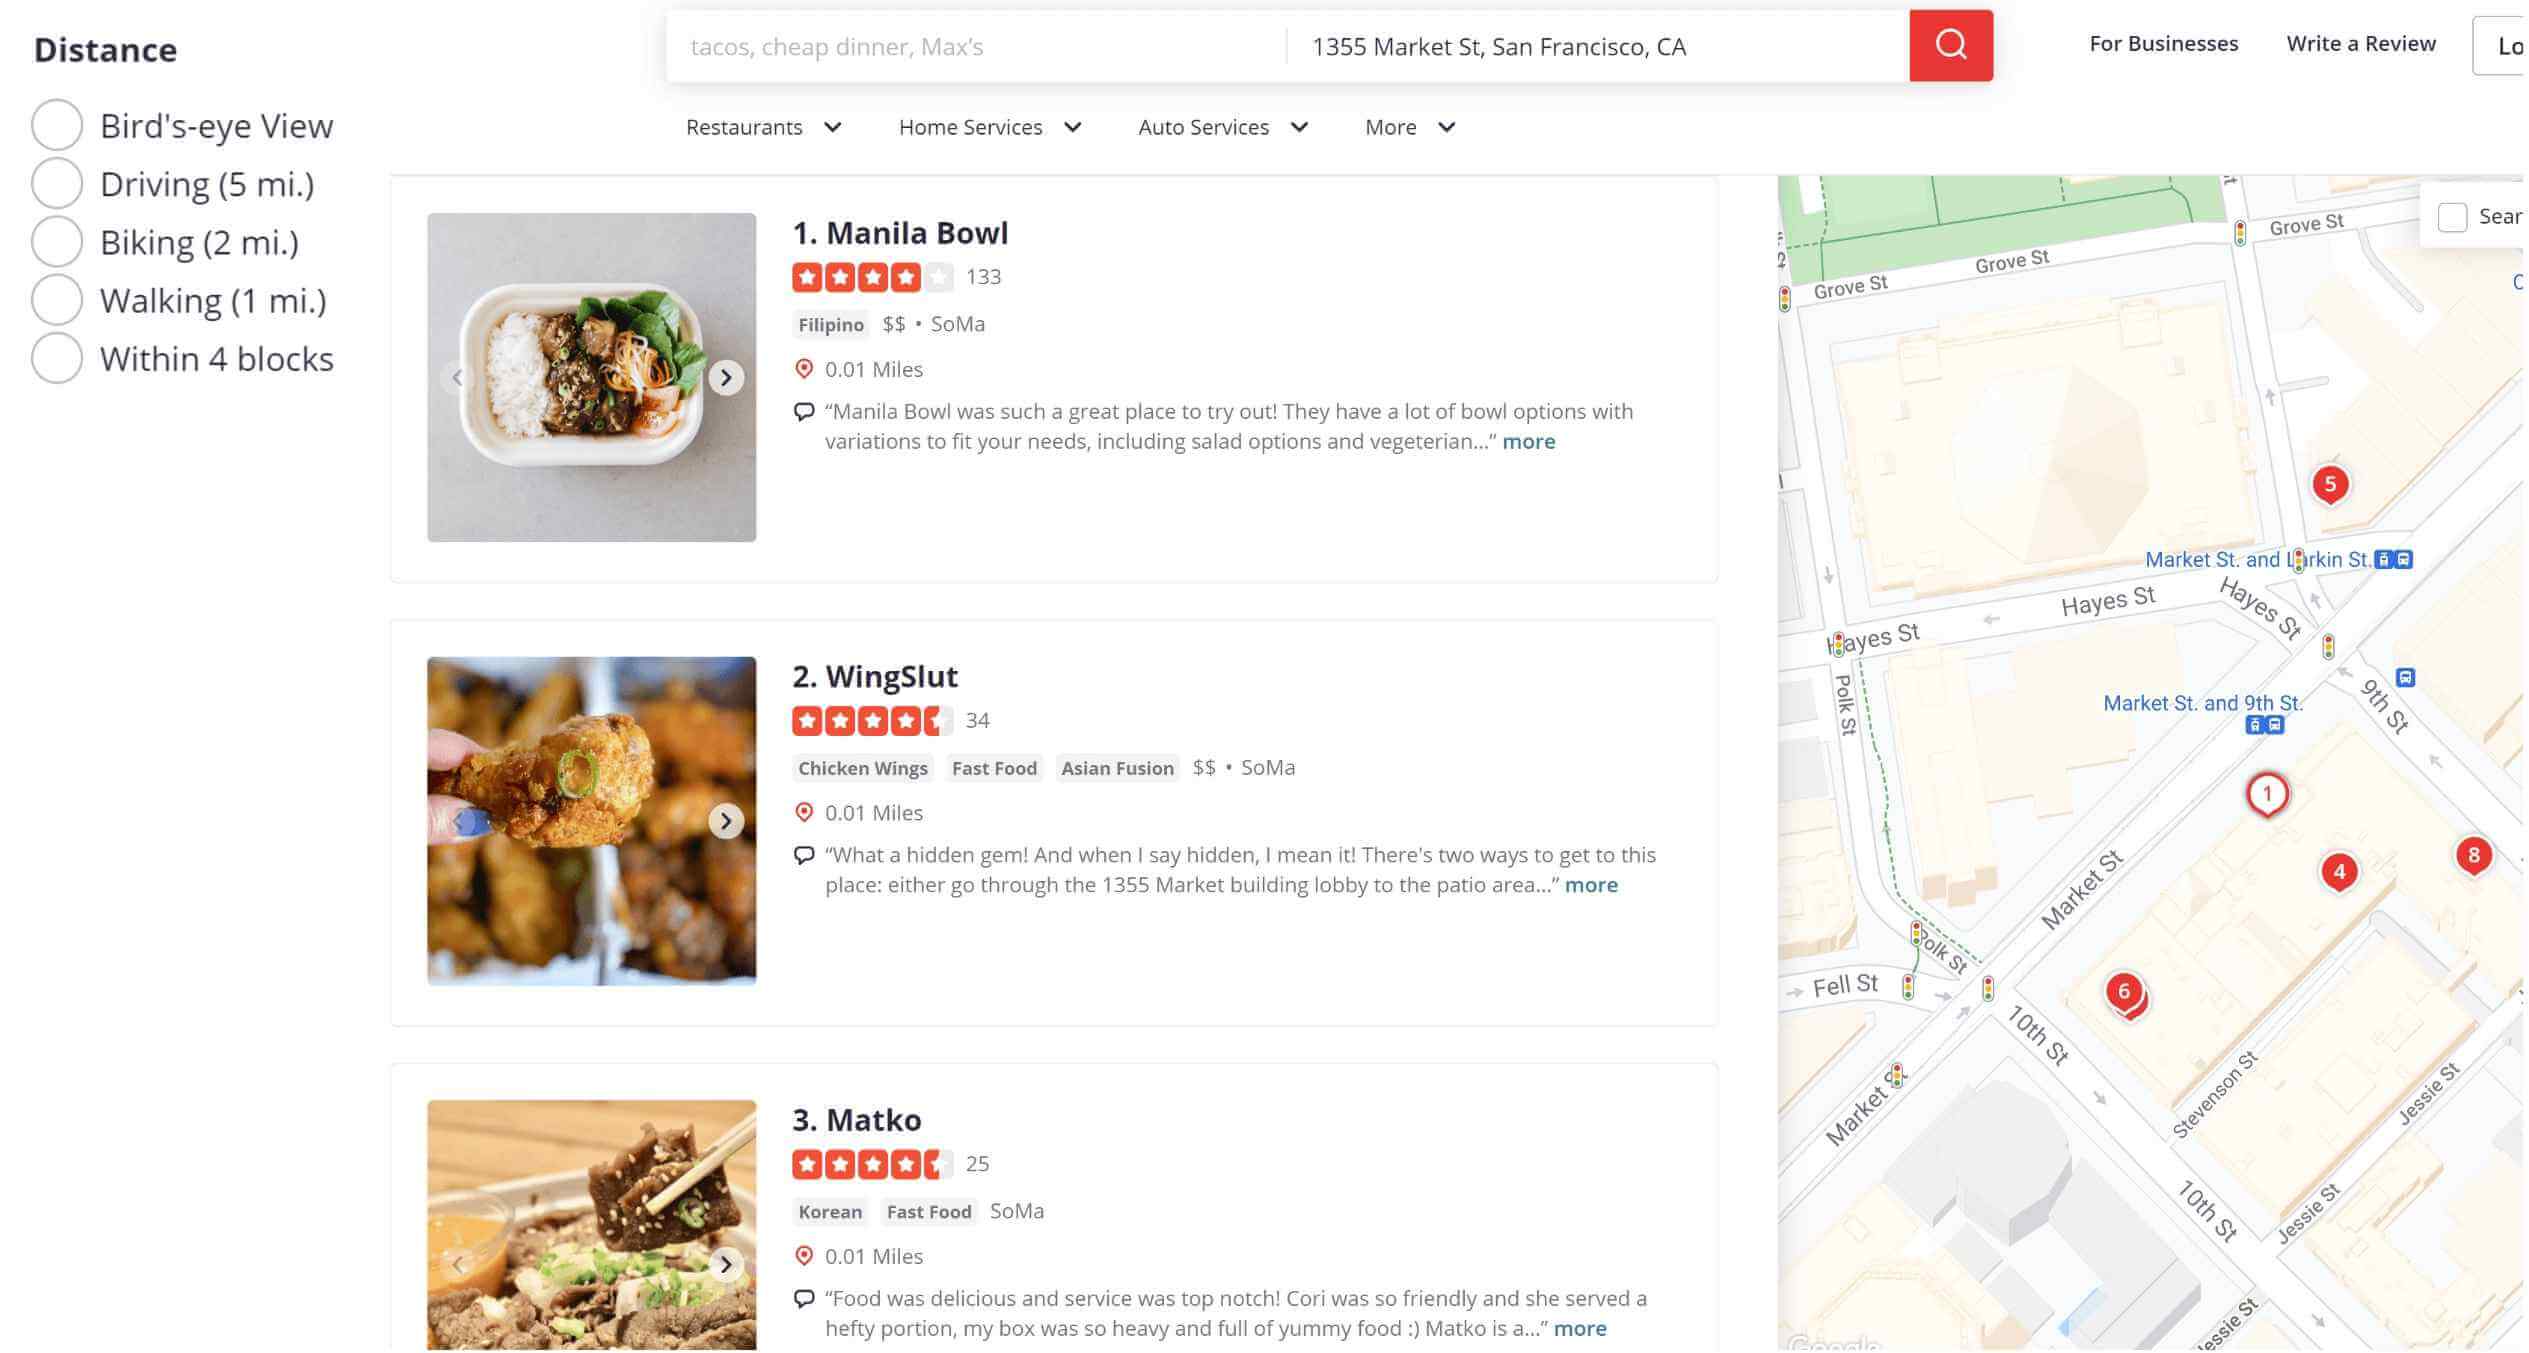
Рисунок 1 Поиск nearby-мест в Yelp (источник: [1])
Шаг 1 — Понять задачу и определить рамки дизайна
Yelp поддерживает много функций, и спроектировать их все за одну интервью-сессию невозможно, поэтому важно сузить scope с помощью вопросов. Диалог между интервьюером и кандидатом может выглядеть так:
Кандидат: Может ли пользователь задавать радиус поиска? Если в радиусе недостаточно
бизнесов, расширяет ли система поиск?
Интервьюер: Хороший вопрос. Давайте предположим, что нас интересуют только бизнесы в пределах
заданного радиуса. Если останется время, обсудим, как расширять поиск, если результатов мало.
Кандидат: Какой максимальный радиус разрешен? Можно предположить, что это 20 км
(12.5 мили)?
Интервьюер: Да, это разумное предположение.
Кандидат: Может ли пользователь менять радиус поиска в UI?
Интервьюер: Да, есть такие варианты: 0.5 км (0.31 мили), 1 км (0.62 мили), 2 км (1.24 мили),
5 км (3.1 мили) и 20 км (12.42 мили).
Кандидат: Как информация о бизнесе добавляется, удаляется или обновляется? Нужно ли отражать
эти операции в real time?
Интервьюер: Владельцы бизнеса могут добавлять, удалять и обновлять данные о заведении.
Предположим, что у нас есть бизнес-договоренность: новые и обновленные записи вступают в силу на
следующий день.
Кандидат: Пользователь может перемещаться, пока пользуется приложением или сайтом, поэтому
результаты со временем могут немного меняться. Нужно ли обновлять страницу, чтобы поддерживать
актуальность?
Интервьюер: Предположим, что пользователь движется медленно и нам не нужно постоянно
обновлять страницу.
Функциональные требования
Из этого разговора видно, что мы фокусируемся на 3 ключевых возможностях:
-
Возвращать все бизнесы на основе локации пользователя (пара latitude/longitude) и радиуса.
-
Владельцы бизнеса могут добавлять, удалять и обновлять карточку бизнеса, но отражать изменения в real time не требуется.
-
Клиенты могут просматривать подробную информацию о бизнесе.
Нефункциональные требования
Из бизнес-требований можно вывести список нефункциональных требований. Их тоже полезно уточнить у интервьюера.
-
Низкая latency. Пользователь должен быстро видеть nearby-бизнесы.
-
Privacy данных. Информация о местоположении чувствительна. При проектировании location-based service (LBS) нужно всегда учитывать приватность пользователя. Мы должны соответствовать законам о защите данных, например General Data Protection Regulation (GDPR) [4] и California Consumer Privacy Act (CCPA) [5].
-
Высокая availability и scalability. Система должна выдерживать всплески трафика в пиковые часы в густонаселенных районах.
Оценка на салфетке
Посмотрим на несколько быстрых оценок, чтобы понять возможный масштаб и основные сложности. Предположим, что у нас 100 миллионов daily active users и 200 миллионов бизнесов.
| Расчет QPS |
|---|
-
Секунд в сутках = 24 * 60 * 60 = 86,400. Для упрощения округлим до 10^5. 10^5 используется по всей книге для обозначения числа секунд в сутках.
-
Предположим, что пользователь делает 5 поисковых запросов в день.
-
Search QPS = 100 миллионов * 5 / 10^5 = 5,000
|
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
В этом разделе мы обсудим:
-
API design
-
high-level design
-
алгоритмы поиска nearby-бизнесов
-
data model
API Design
Для упрощенной версии API используем RESTful-подход.
GET /v1/search/nearby
Этот endpoint возвращает бизнесы по заданным критериям поиска. В реальных приложениях результаты обычно paginated. Pagination [6] не является фокусом этой главы, но на интервью про нее полезно упомянуть.
Параметры запроса:
| Поле | Описание | Тип |
|---|---|---|
| latitude | Широта заданной точки | decimal |
| longitude | Долгота заданной точки | decimal |
| radius | Необязательно. По умолчанию 5000 метров (~3 мили) | int |
Таблица 1. Параметры запроса
Тело ответа:
{
  "total": 10,
  "businesses":[{business object}]
}
Объект business содержит все, что нужно для отображения страницы результатов поиска, но для
страницы с деталями бизнеса могут понадобиться дополнительные атрибуты: фотографии, отзывы,
star rating и т. д. Поэтому, когда пользователь открывает детальную страницу, обычно требуется
дополнительный endpoint для загрузки полной информации о бизнесе.
API для business
API, относящиеся к объекту business, показаны в таблице ниже.
| API | Описание |
|---|---|
GET /v1/businesses/{:id} | Вернуть подробную информацию о бизнесе |
| POST /v1/businesses | Добавить бизнес |
PUT /v1/businesses/{:id} | Обновить информацию о бизнесе |
DELETE /v1/businesses/{:id} | Удалить бизнес |
Таблица 2. API для business
Если вам интересны реальные API для поиска мест и бизнесов, можно посмотреть на Google Places API [7] и Yelp Reservation API [8].
Data model
В этом разделе мы разберем read/write ratio и схему данных. Масштабирование базы данных подробно обсудим в deep dive.
Read/write ratio
Объем чтений высокий, потому что следующие две функции используются очень часто:
-
Поиск nearby-бизнесов.
-
Просмотр подробной информации о бизнесе.
С другой стороны, объем записей низкий, потому что добавление, удаление и редактирование данных о бизнесе происходят редко.
Для read-heavy системы хорошим выбором может быть реляционная база данных, например MySQL. Рассмотрим схему данных подробнее.
Схема данных
Ключевые таблицы базы данных — это таблица business и таблица geospatial index.
Таблица business
Таблица business содержит подробную информацию о бизнесе. Она показана в таблице 3, а ее
primary key — business_id.
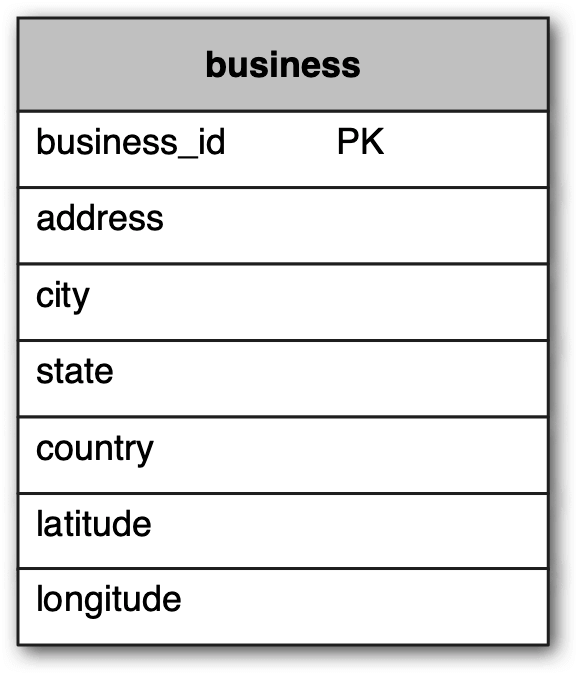
Таблица 3. Таблица business
Таблица geo index
Таблица geo index используется для эффективной обработки пространственных операций. Поскольку для нее нужны базовые знания о geohash, подробнее мы обсудим ее в разделе “Scale the database” в deep dive.
High-level design
Высокоуровневая схема показана на рисунке 2. Система состоит из двух частей: location-based service (LBS) и business-related service. Посмотрим на каждый компонент по отдельности.
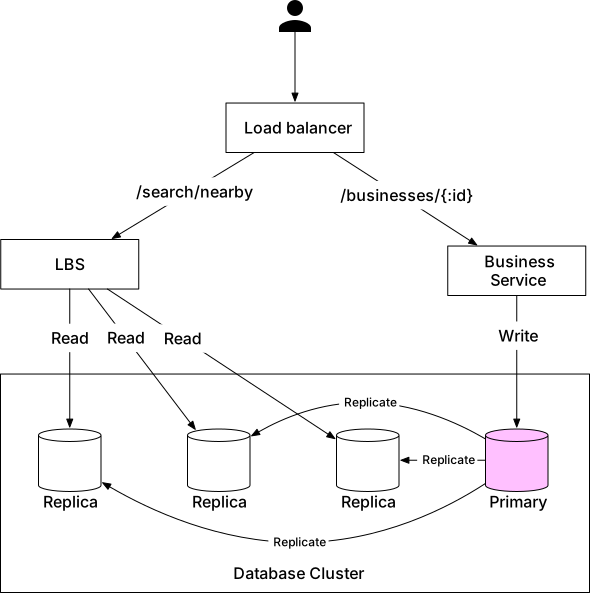
Рисунок 2 High-level design
Load balancer
Load balancer автоматически распределяет входящий трафик между несколькими сервисами. Обычно компания предоставляет единую DNS entry point, а внутри маршрутизирует API-вызовы к нужным сервисам на основе URL path.
Location-based service (LBS)
LBS — ключевая часть системы, которая находит nearby-бизнесы по заданным радиусу и координатам. У этого сервиса есть несколько важных характеристик:
-
Это read-heavy сервис без write-запросов.
-
QPS высокий, особенно в пиковые часы в плотных районах.
-
Сервис stateless, поэтому его легко горизонтально масштабировать.
Business service
Business service в основном обрабатывает два типа запросов:
-
Владельцы бизнеса создают, обновляют или удаляют карточки бизнеса. Это в основном write-операции с невысоким QPS.
-
Клиенты просматривают подробную информацию о бизнесе. В пиковые часы у этого сценария высокий QPS.
Database cluster
Кластер базы данных можно построить по схеме primary-secondary. В этом случае primary database обрабатывает все write-операции, а несколько replica используются для чтений. Данные сначала записываются в primary, затем реплицируются в replica. Из-за replication delay возможны небольшие расхождения между тем, что читает LBS, и тем, что уже записано в primary database. Обычно это не проблема, потому что информация о бизнесе не обязана обновляться в real time.
Scalability business service и LBS
И business service, и LBS — stateless services, поэтому можно автоматически добавлять серверы под пиковую нагрузку (например, во время обеда) и удалять их в непиковые часы (например, ночью). Если система работает в облаке, можно развернуть ее в нескольких регионах и availability zones, чтобы дополнительно повысить availability [9]. Подробнее это разберем в deep dive.
Алгоритмы поиска nearby-бизнесов
В реальной жизни компании могут использовать готовые geospatial databases, например Geohash в Redis [10] или Postgres с расширением PostGIS [11]. На интервью от вас не ожидают знания внутренностей этих решений. Намного лучше показать problem-solving skills и техническое понимание, объяснив, как работает geospatial index, вместо того чтобы просто назвать несколько баз данных.
Следующий шаг — рассмотреть разные варианты поиска nearby-бизнесов. Мы перечислим несколько опций, пройдемся по ходу рассуждений и обсудим trade-offs.
Вариант 1: двумерный поиск
Самый интуитивный, но наивный способ — нарисовать круг с заданным радиусом и найти все бизнесы внутри него, как на рисунке 3.
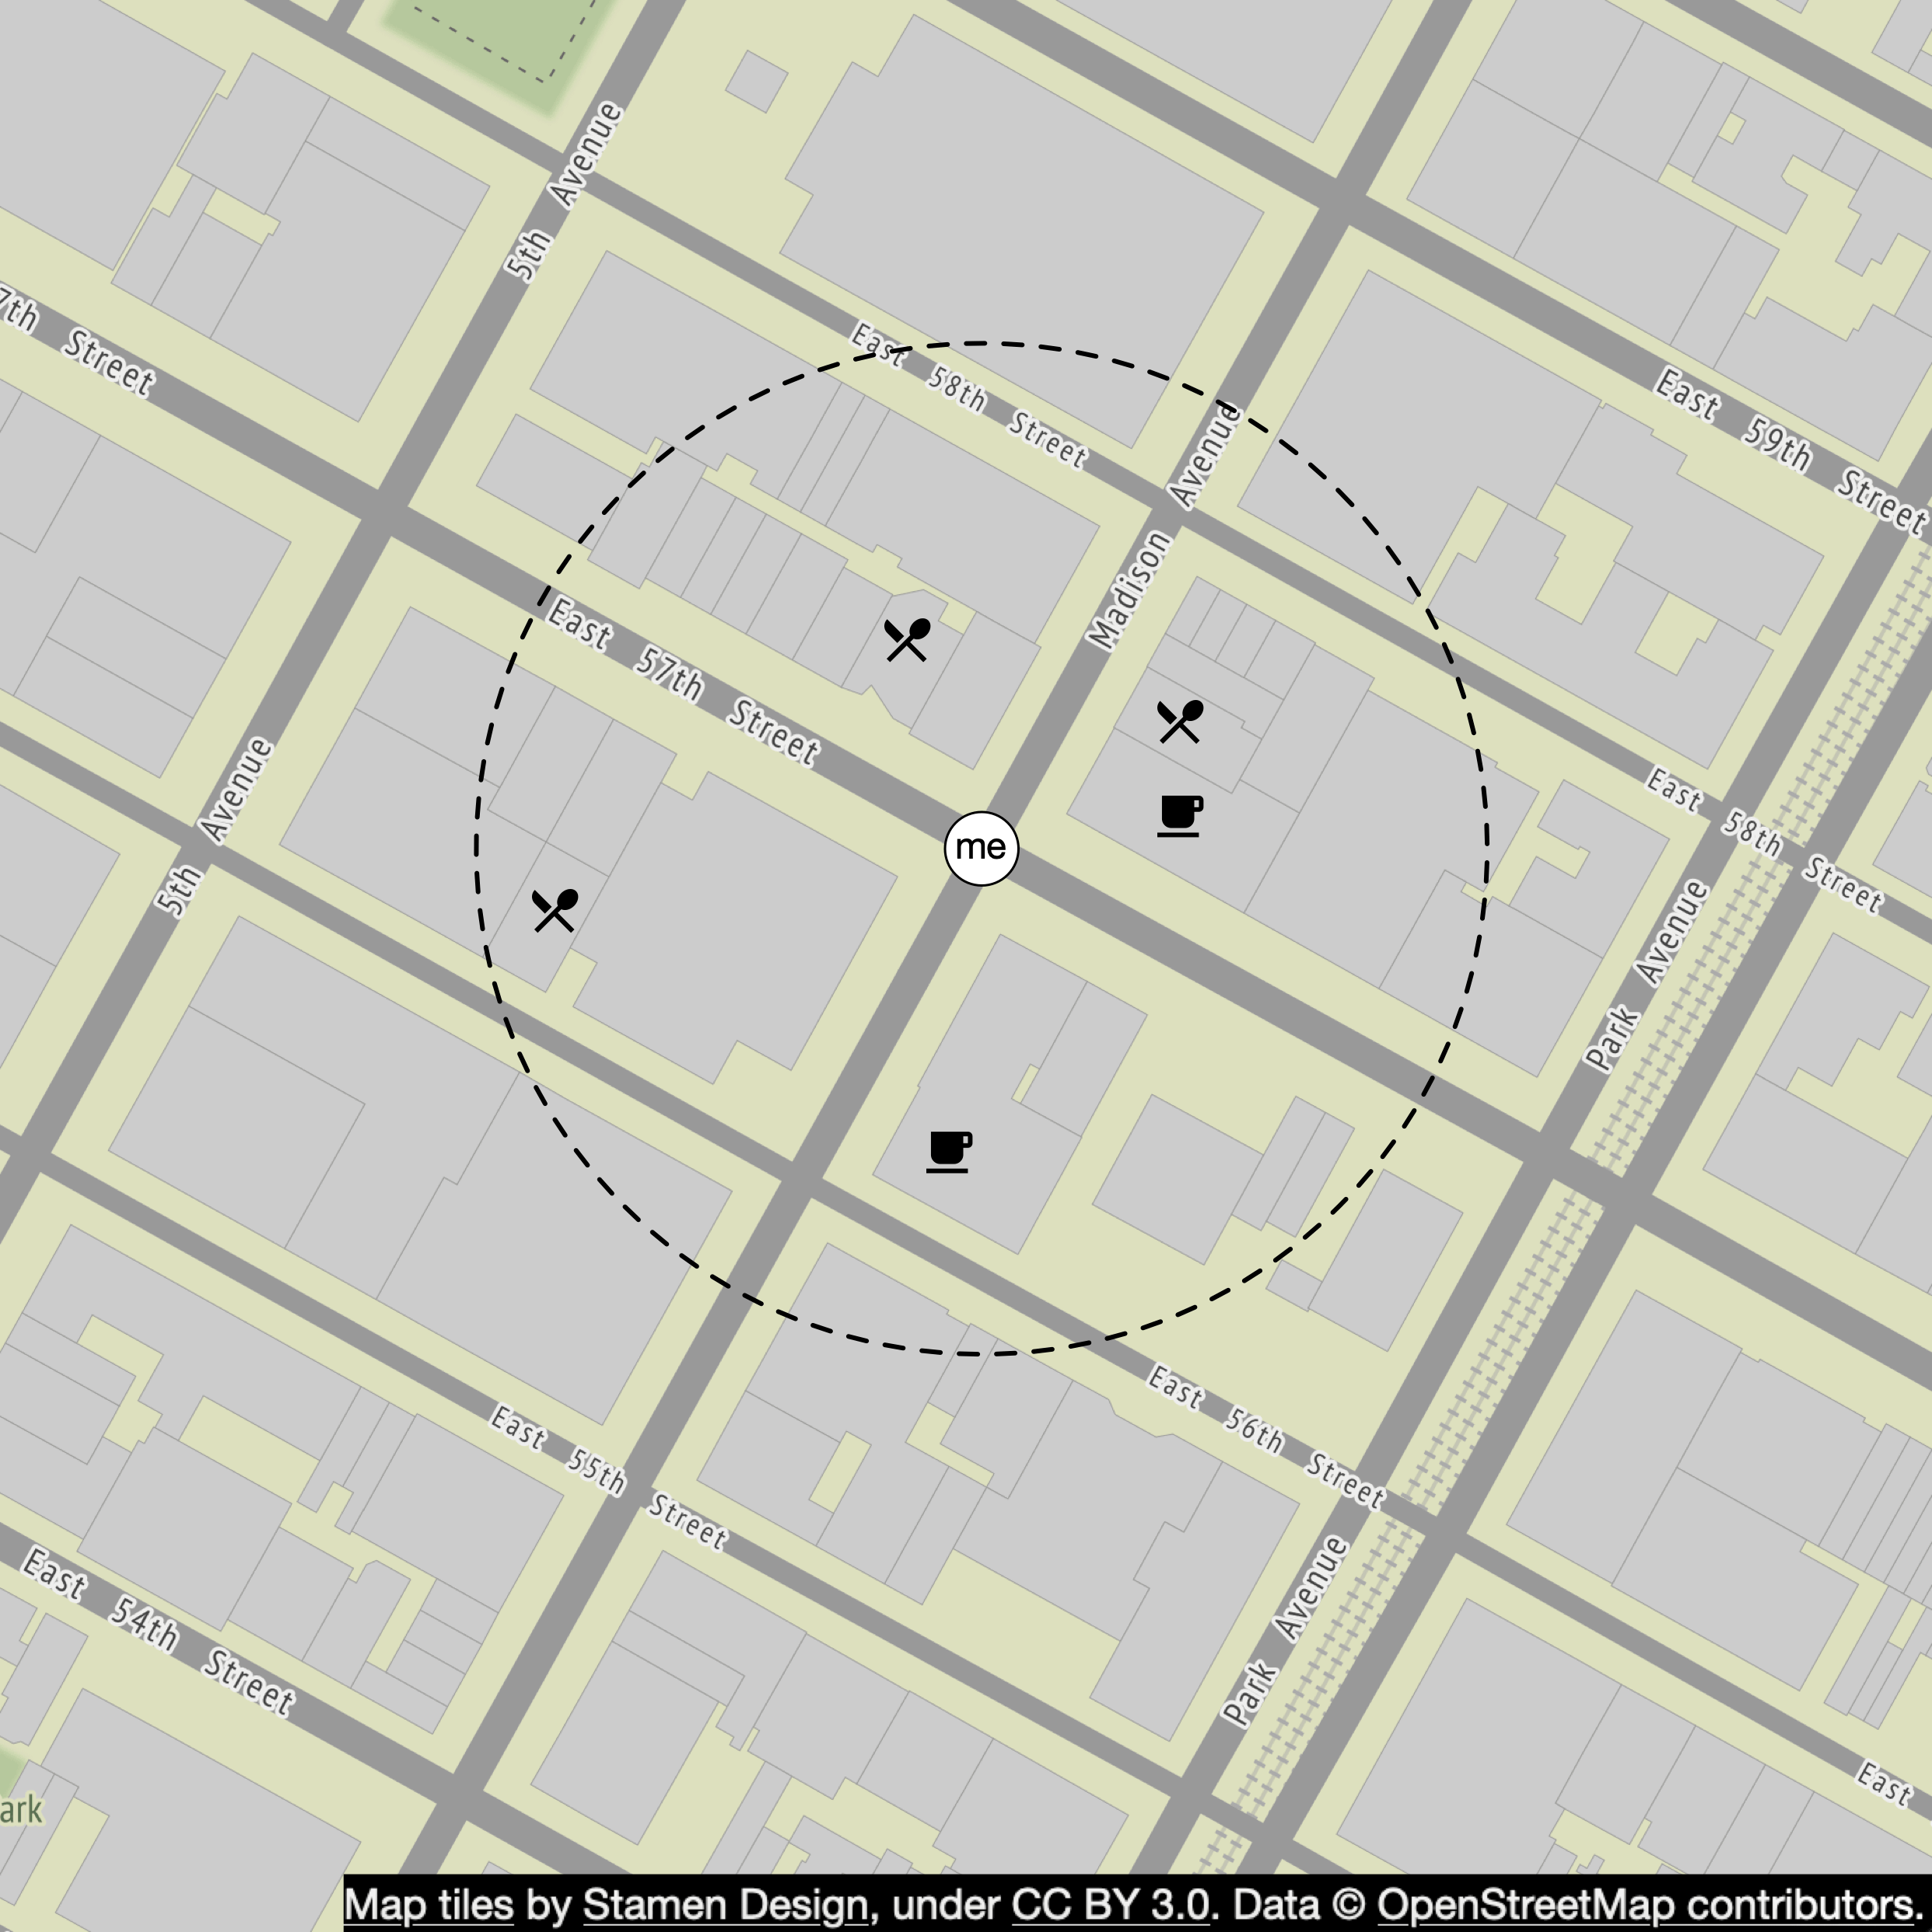
Рисунок 3 Двумерный поиск
Этот процесс можно выразить следующим псевдо-SQL-запросом:
SELECT business_id, latitude, longitude,
FROM business
WHERE (latitude BETWEEN {:my_lat} - radius AND {:my_lat} + radius) AND
      (longitude BETWEEN {:my_long} - radius AND {:my_long} + radius)
Этот запрос неэффективен, потому что требует сканировать всю таблицу. Что если построить индексы
по колонкам longitude и latitude? Улучшение будет незначительным. Проблема в том, что у нас
двумерные данные, и набор данных, возвращаемый по каждому измерению, все равно может быть очень
большим. Например, как показано на рисунке 4, благодаря индексам по longitude и latitude мы
можем быстро получить dataset 1 и dataset 2. Но чтобы выбрать бизнесы в пределах радиуса, нужно
выполнить операцию пересечения этих двух наборов. Это неэффективно, потому что каждый набор
содержит много данных.
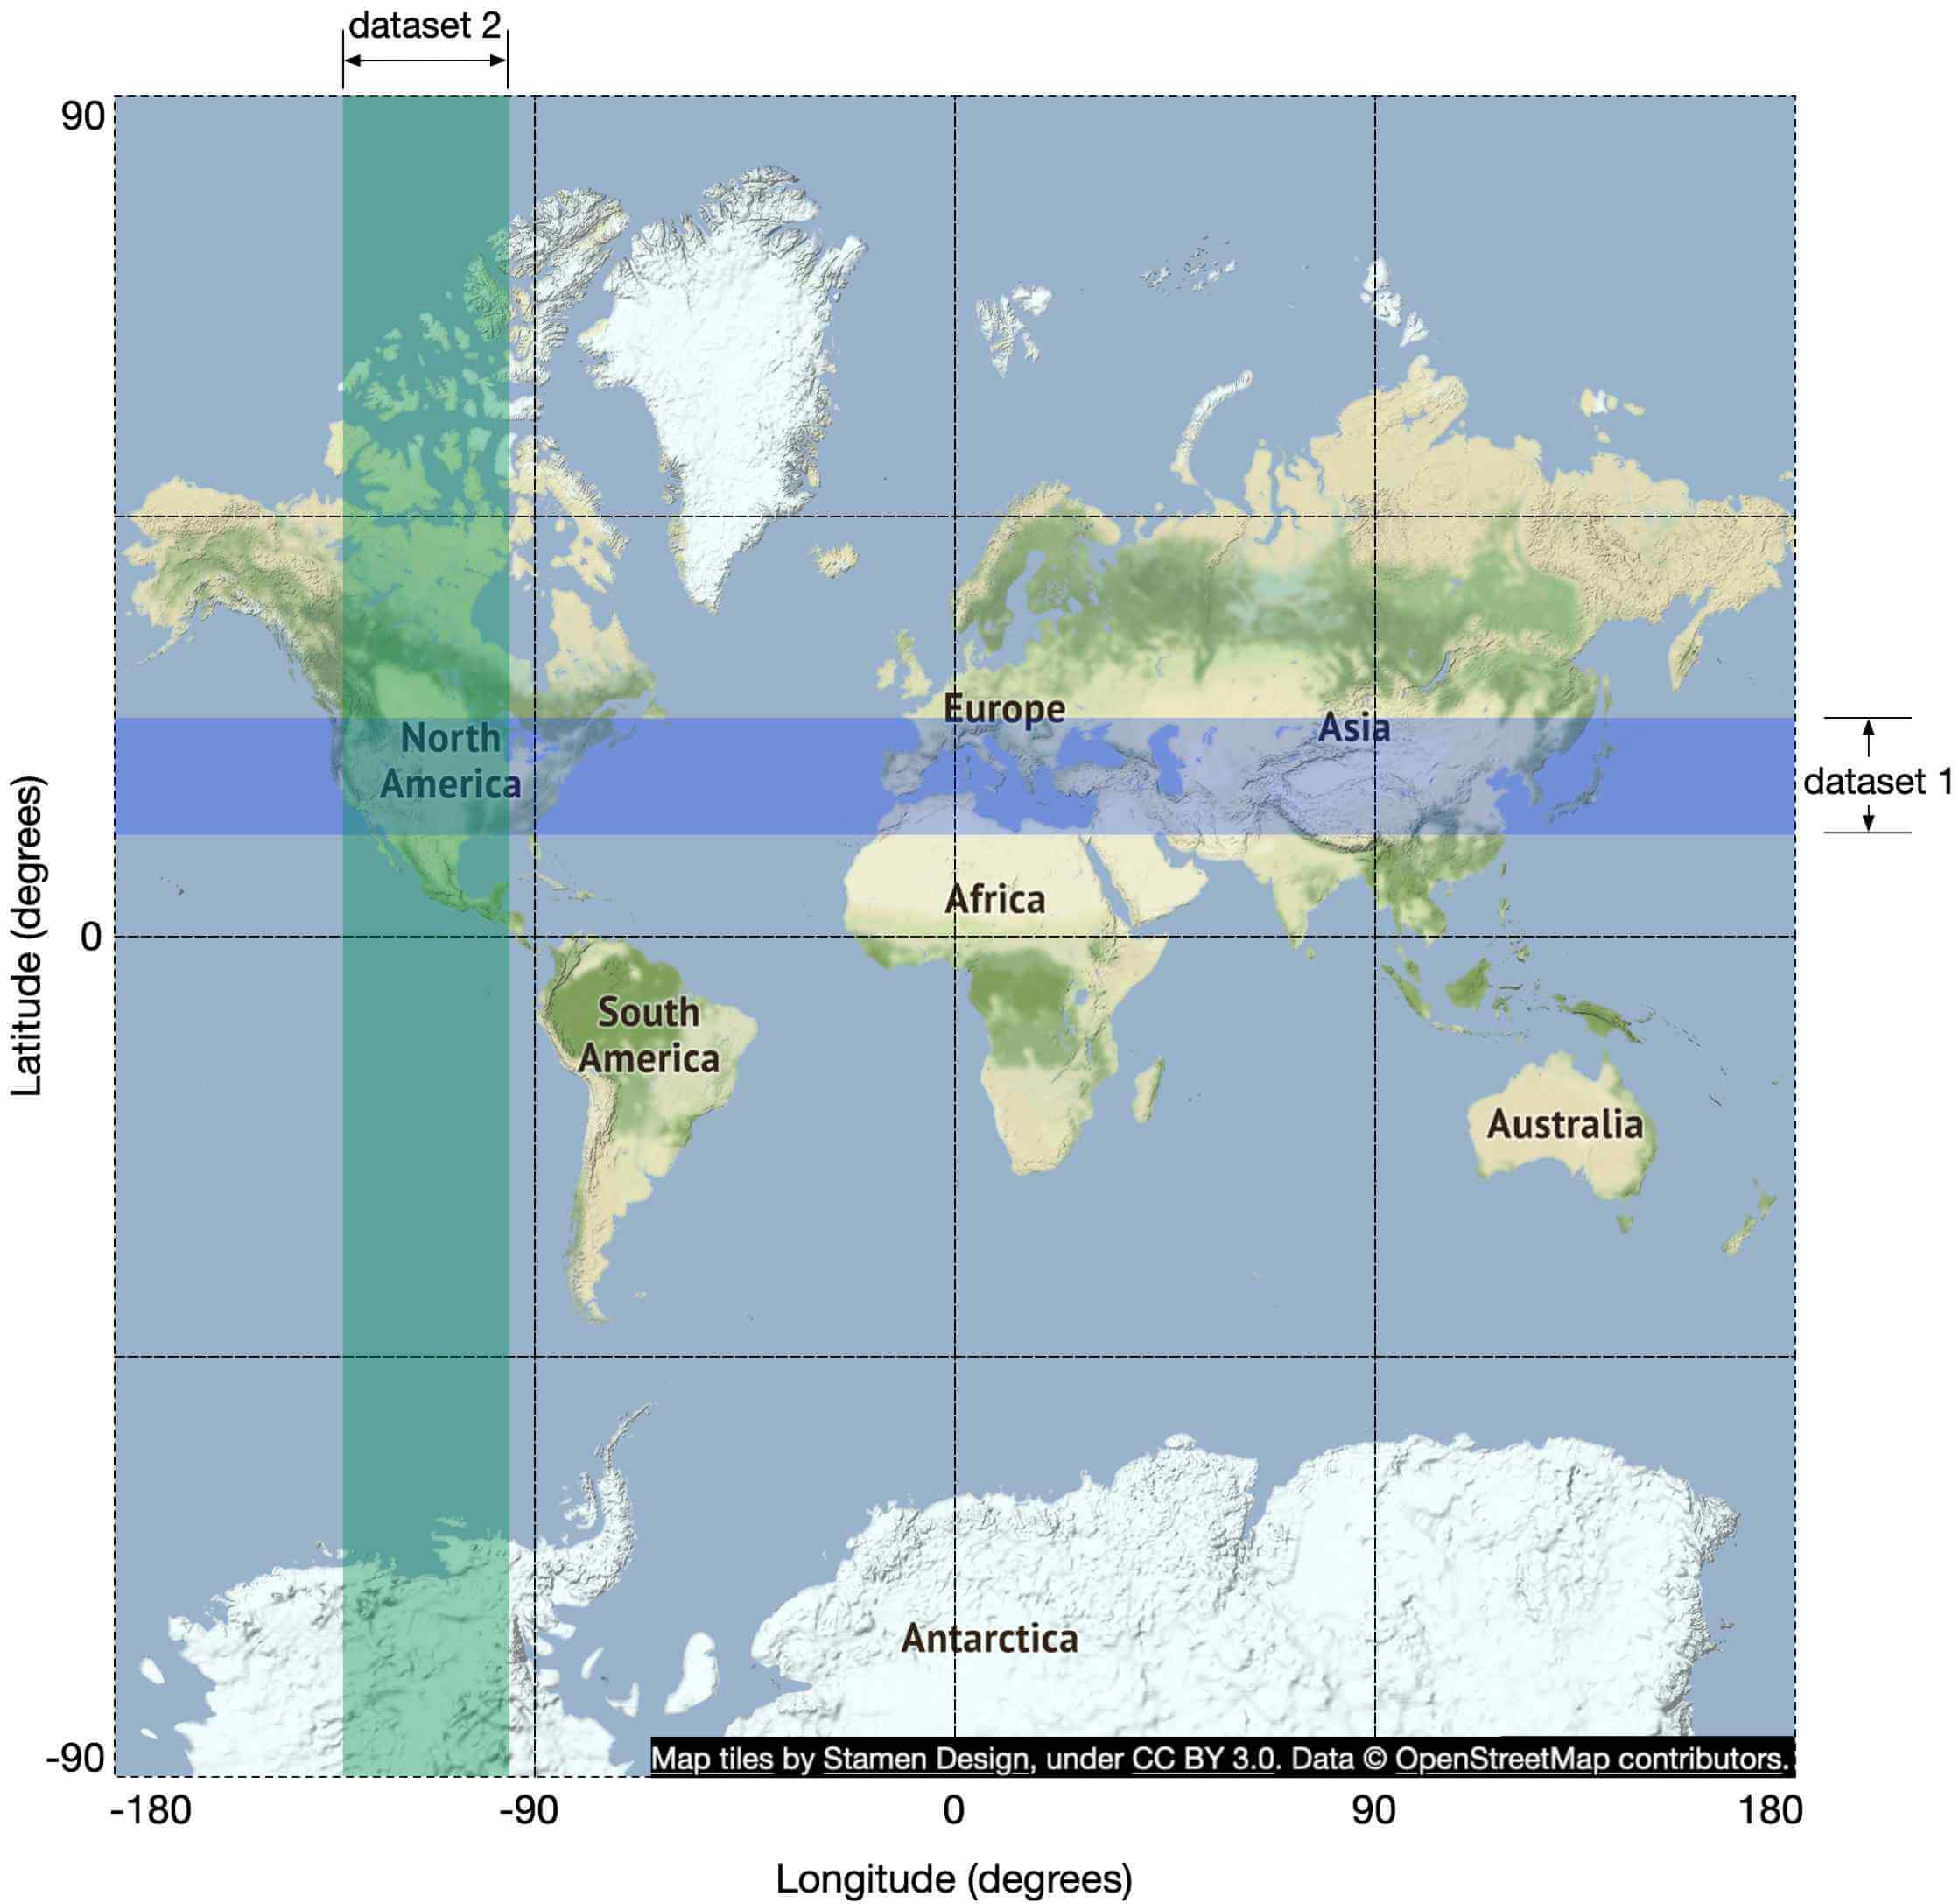
Рисунок 4 Пересечение двух наборов данных
Проблема предыдущего подхода в том, что индекс базы данных может ускорять поиск только по одному измерению. Возникает естественный вопрос: можем ли мы отобразить двумерные данные в одно измерение? Да, можем.
Прежде чем перейти к ответам, посмотрим на разные типы индексации. В широком смысле есть два типа geospatial indexing, как показано на рисунке 5. Выделенные варианты — те алгоритмы, которые мы разберем подробнее, потому что они широко применяются в индустрии.
-
Hash: even grid, geohash, cartesian tiers [12] и т. д.
-
Tree: quadtree, Google S2, RTree [13] и т. д.

Рисунок 5 Разные типы geospatial indexes
Хотя внутренние реализации этих подходов различаются, общая идея одна и та же: разбить карту на более мелкие области и построить индексы для быстрого поиска. Из них geohash, quadtree и Google S2 чаще всего используются в реальных приложениях. Рассмотрим их по очереди.
| Напоминание |
|---|
| На реальном интервью обычно не нужно объяснять детали реализации всех вариантов индексации. Но важно понимать, зачем нужен geospatial indexing, как он работает на высоком уровне и какие у него есть ограничения. |
Вариант 2: равномерная сетка
Один простой подход — равномерно разбить мир на небольшие grid-ячейки (рисунок 6). Тогда одна ячейка может содержать несколько бизнесов, и каждый бизнес на карте принадлежит одной ячейке.
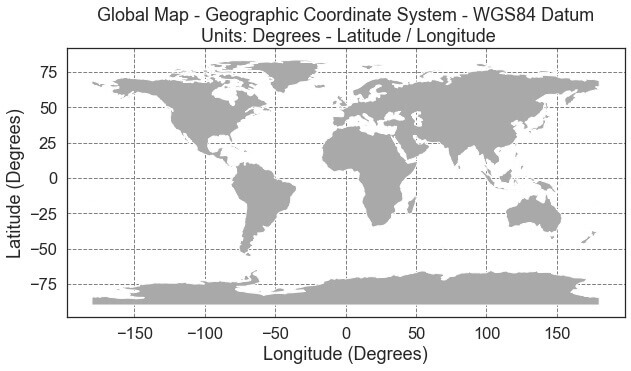
Рисунок 6 Глобальная карта (источник: [14])
Этот подход в какой-то степени работает, но у него есть серьезная проблема: распределение бизнесов неравномерно. В центре Нью-Йорка может быть очень много бизнесов, а в пустынях и океанах — ни одного. Разбивая мир на одинаковые grid-ячейки, мы получаем крайне неравномерное распределение данных. В идеале нам нужны более мелкие grid-ячейки для плотных районов и более крупные — для разреженных. Еще одна возможная сложность — поиск соседних ячеек для фиксированной grid-ячейки.
Вариант 3: Geohash
Geohash лучше, чем равномерная сетка. Он работает, сводя двумерные данные longitude/latitude к одномерной строке из букв и цифр. Алгоритм geohash рекурсивно делит мир на все более мелкие ячейки с каждым добавленным битом. Разберем его на высоком уровне.
Сначала делим планету на четыре квадранта по prime meridian и экватору.
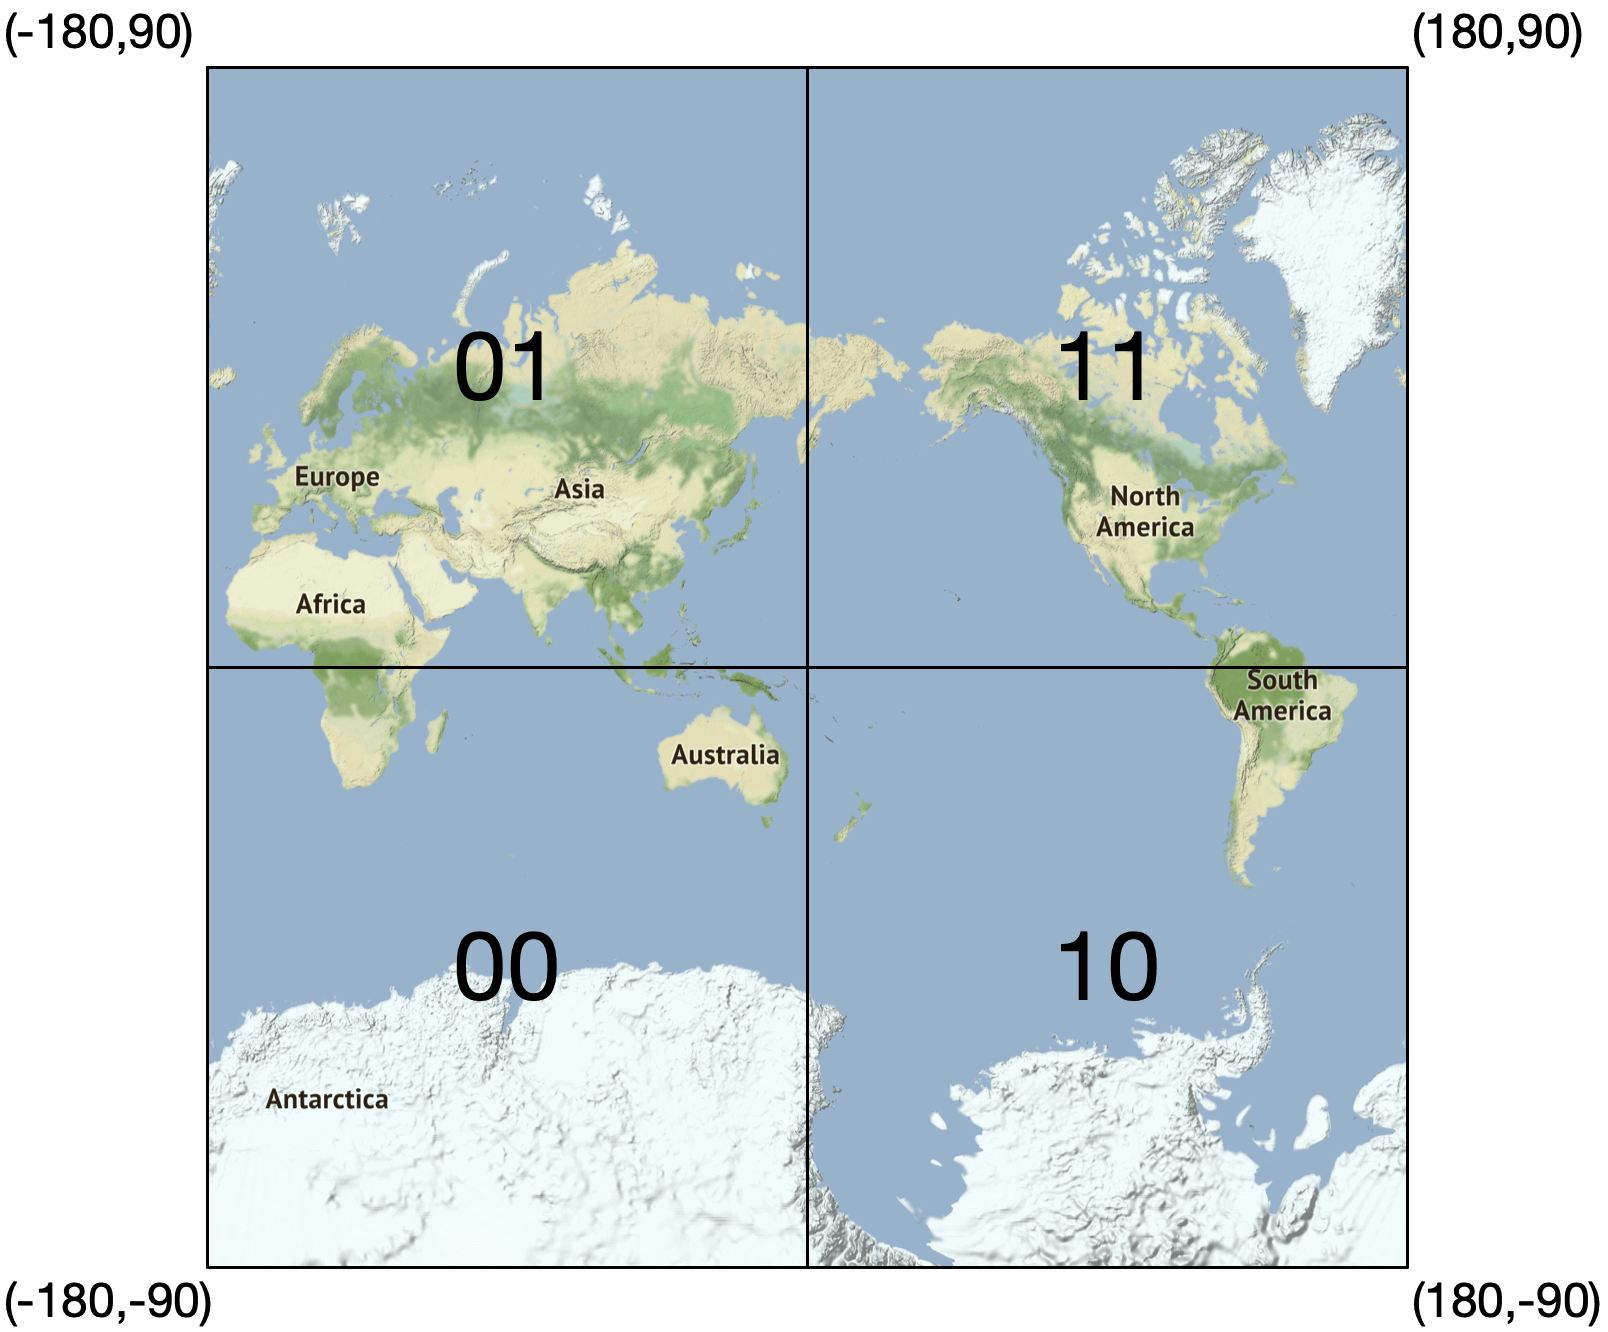
Рисунок 7 Geohash
-
Диапазон latitude [-90, 0] представляется как 0
-
Диапазон latitude [0, 90] представляется как 1
-
Диапазон longitude [-180, 0] представляется как 0
-
Диапазон longitude [0, 180] представляется как 1
Затем делим каждую ячейку еще на четыре меньшие. Каждую ячейку можно представить, чередуя бит longitude и бит latitude.
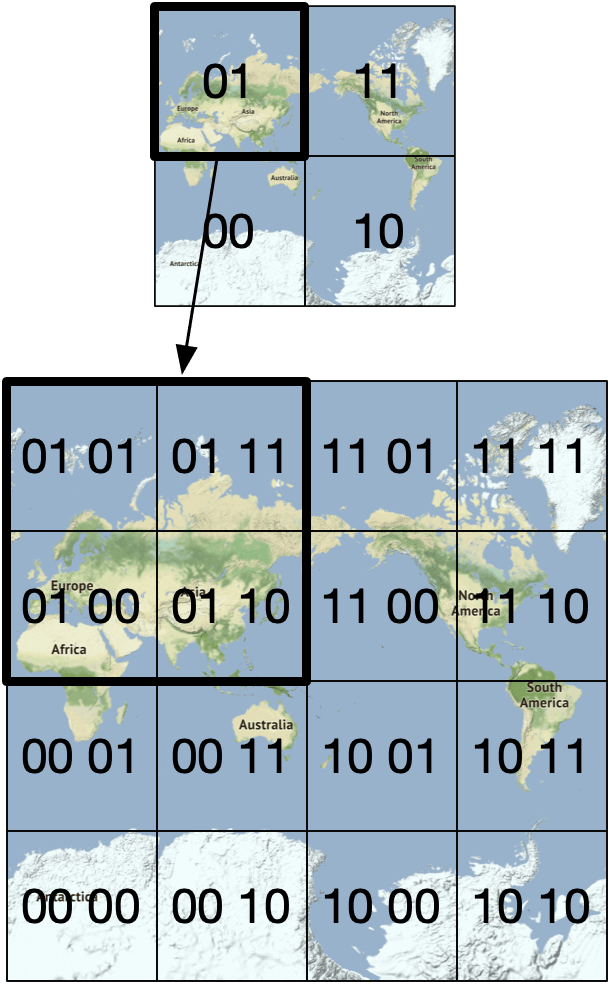
Рисунок 8 Разбиение сетки
Повторяем это деление, пока размер grid-ячейки не достигнет нужной точности. Geohash обычно использует представление base32 [15]. Посмотрим на два примера.
-
Geohash штаб-квартиры Google (длина = 6):
1001 10110 01001 10000 11011 11010 (base32 in binary) → 9q9hvu (base32) -
Geohash штаб-квартиры Facebook (длина = 6):
1001 10110 01001 10001 10000 10111 (base32 in binary) → 9q9jhr (base32)
У geohash есть 12 уровней точности (precision), как показано в таблице 4. Фактор точности определяет размер ячейки. Нас интересуют geohash длиной от 4 до 6. Если длина больше 6, ячейка становится слишком маленькой; если меньше 4 — слишком большой (см. таблицу 4).
| Длина geohash | Ширина x высота ячейки |
|---|---|
| 1 | 5,009.4 км x 4,992.6 км (размер планеты) |
| 2 | 1,252.3 км x 624.1 км |
| 3 | 156.5 км x 156 км |
| 4 | 39.1 км x 19.5 км |
| 5 | 4.9 км x 4.9 км |
| 6 | 1.2 км x 609.4 м |
| 7 | 152.9 м x 152.4 м |
| 8 | 38.2 м x 19 м |
| 9 | 4.8 м x 4.8 м |
| 10 | 1.2 м x 59.5 см |
| 11 | 14.9 см x 14.9 см |
| 12 | 3.7 см x 1.9 см |
Таблица 4. Соответствие длины geohash размеру ячейки (источник: [16])
Как выбрать подходящую точность? Нам нужна минимальная длина geohash, покрывающая весь круг, заданный пользователем. Соответствие между радиусом и длиной geohash показано в таблице ниже.
| Радиус (километры) | Длина geohash |
|---|---|
| 0.5 км (0.31 мили) | 6 |
| 1 км (0.62 мили) | 5 |
| 2 км (1.24 мили) | 5 |
| 5 км (3.1 мили) | 4 |
| 20 км (12.42 мили) | 4 |
Таблица 5. Соответствие радиуса и geohash
Этот подход отлично работает в большинстве случаев, но есть несколько edge cases, связанных с обработкой границ geohash, которые стоит обсудить с интервьюером.
Проблемы границ
Geohash гарантирует, что чем длиннее общий prefix у двух geohash, тем ближе точки друг к другу.
Как показано на рисунке 9, все ячейки имеют общий prefix 9q8zn.
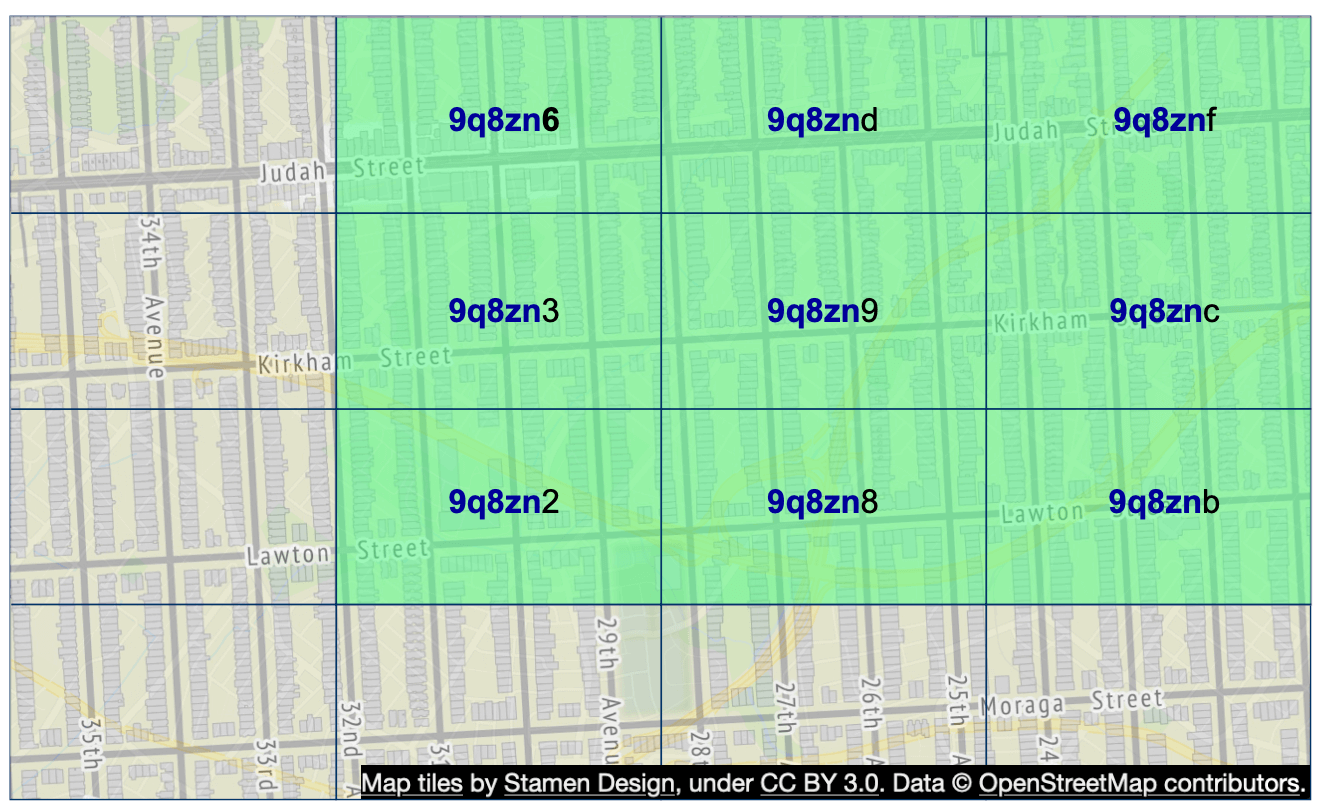
Рисунок 9 Общий prefix
Проблема границы 1
Однако обратное неверно: две точки могут быть очень близко, но не иметь общего prefix вообще. Это
происходит потому, что две близкие точки по разные стороны экватора или prime meridian попадают в
разные “половины” мира. Например, во Франции La Roche-Chalais (geohash: u000) находится всего в
30 км от Pomerol (geohash: ezzz), но их geohash не имеют общего prefix [17].
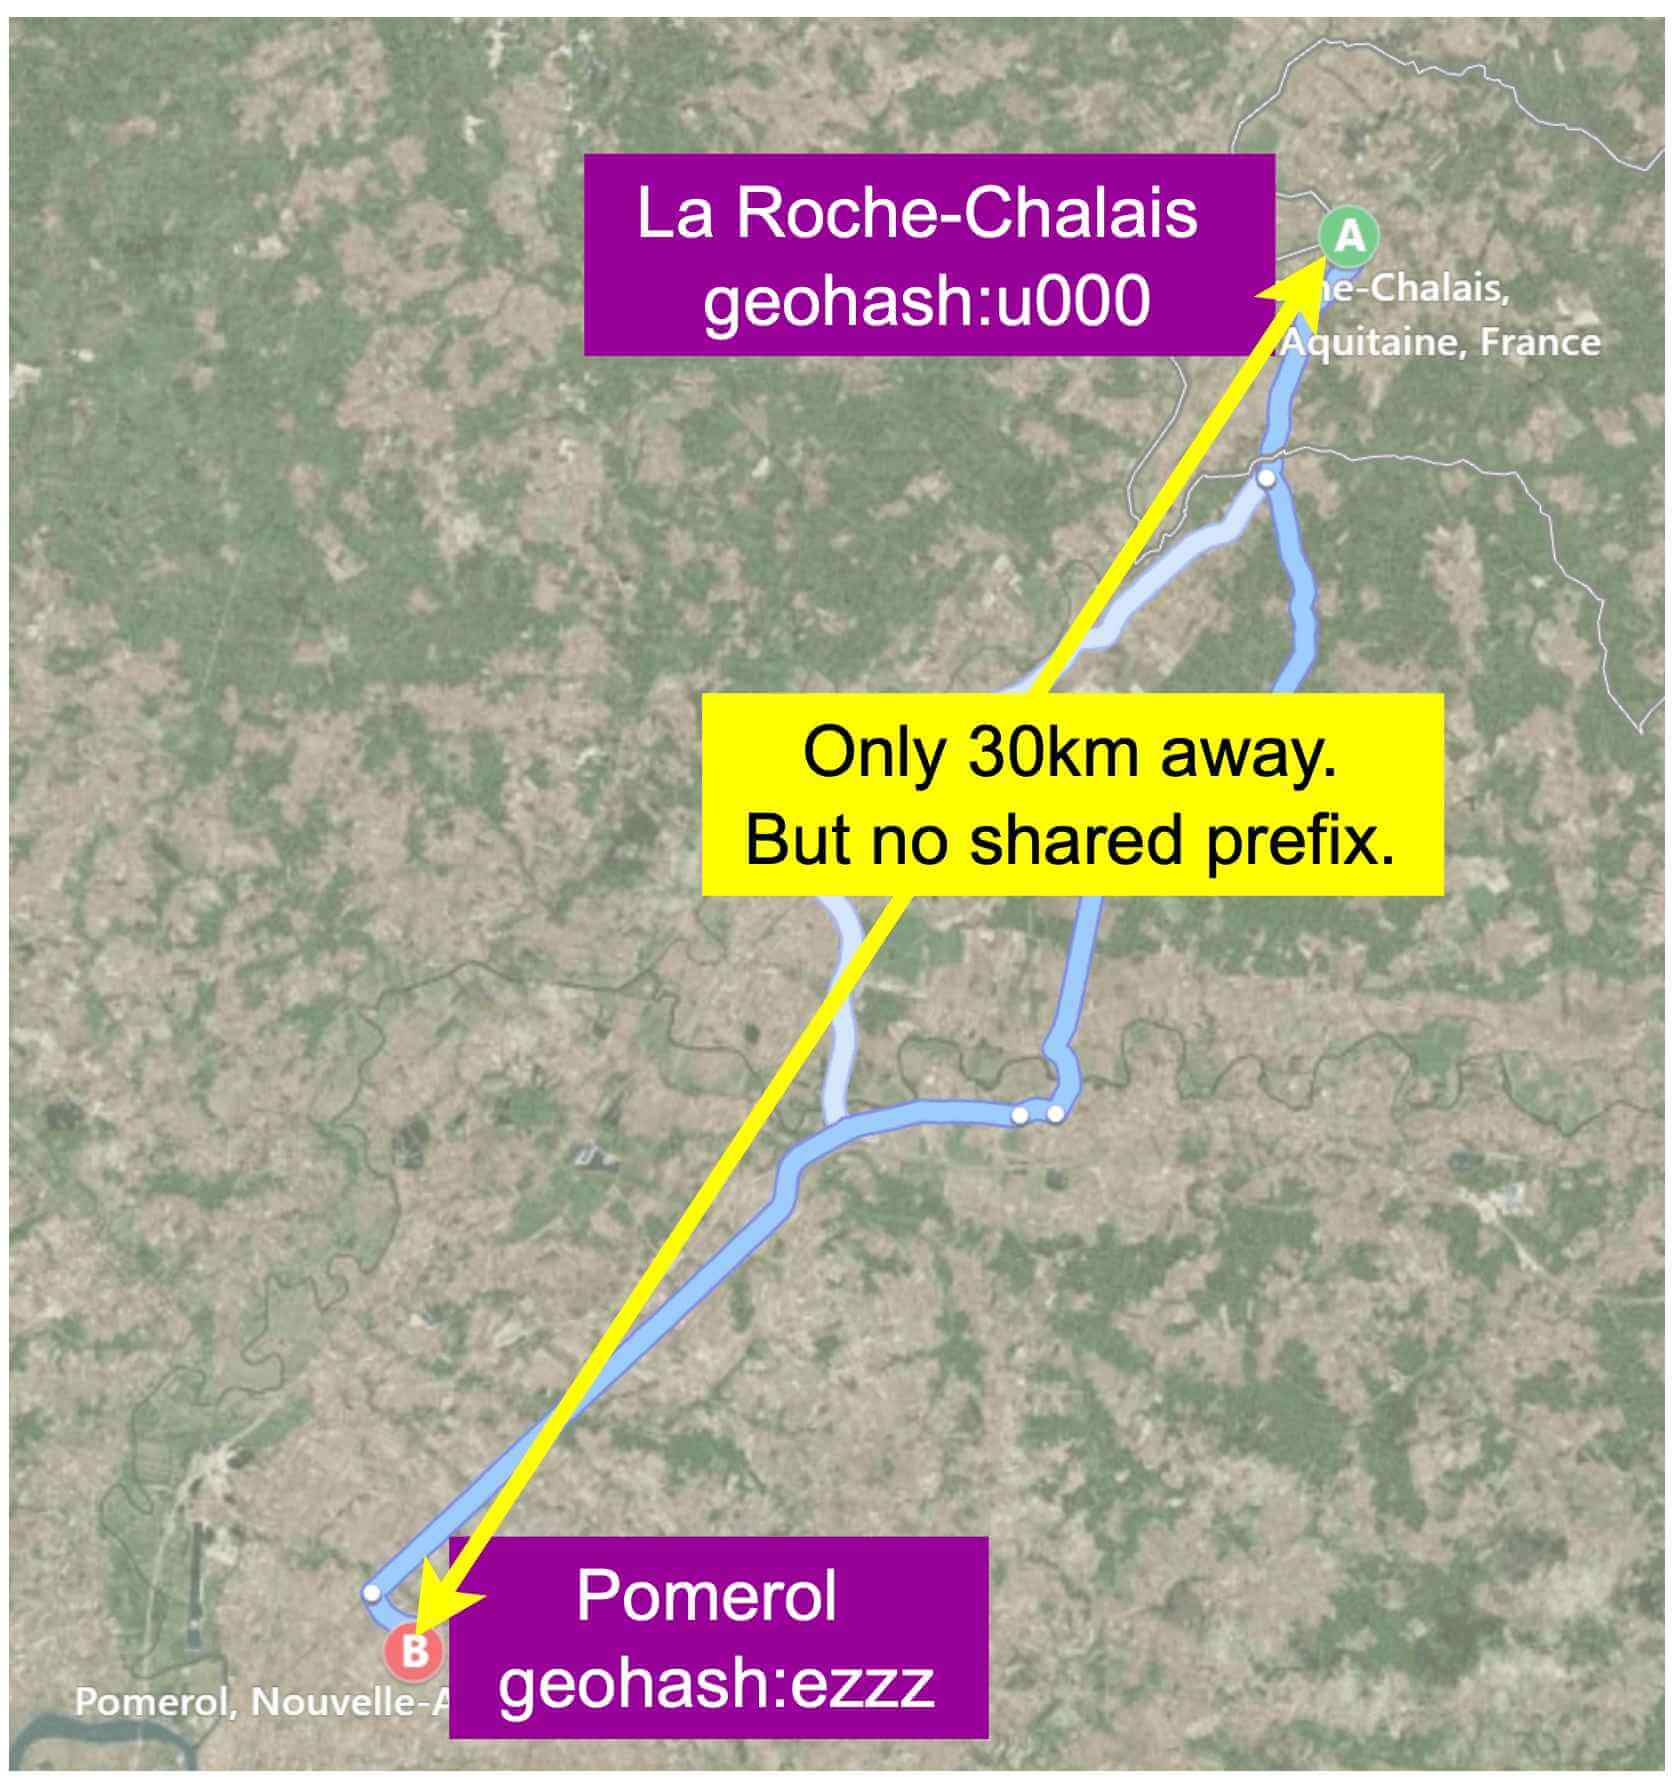
Рисунок 10 Нет общего prefix
Из-за этой проблемы простой prefix SQL-запрос ниже не сможет вернуть все nearby-бизнесы.
SELECT * FROM geohash_index WHERE geohash LIKE `9q8zn%`
Проблема границы 2
Еще одна проблема в том, что две позиции могут иметь длинный общий prefix, но принадлежать разным geohash, как показано на рисунке 11.
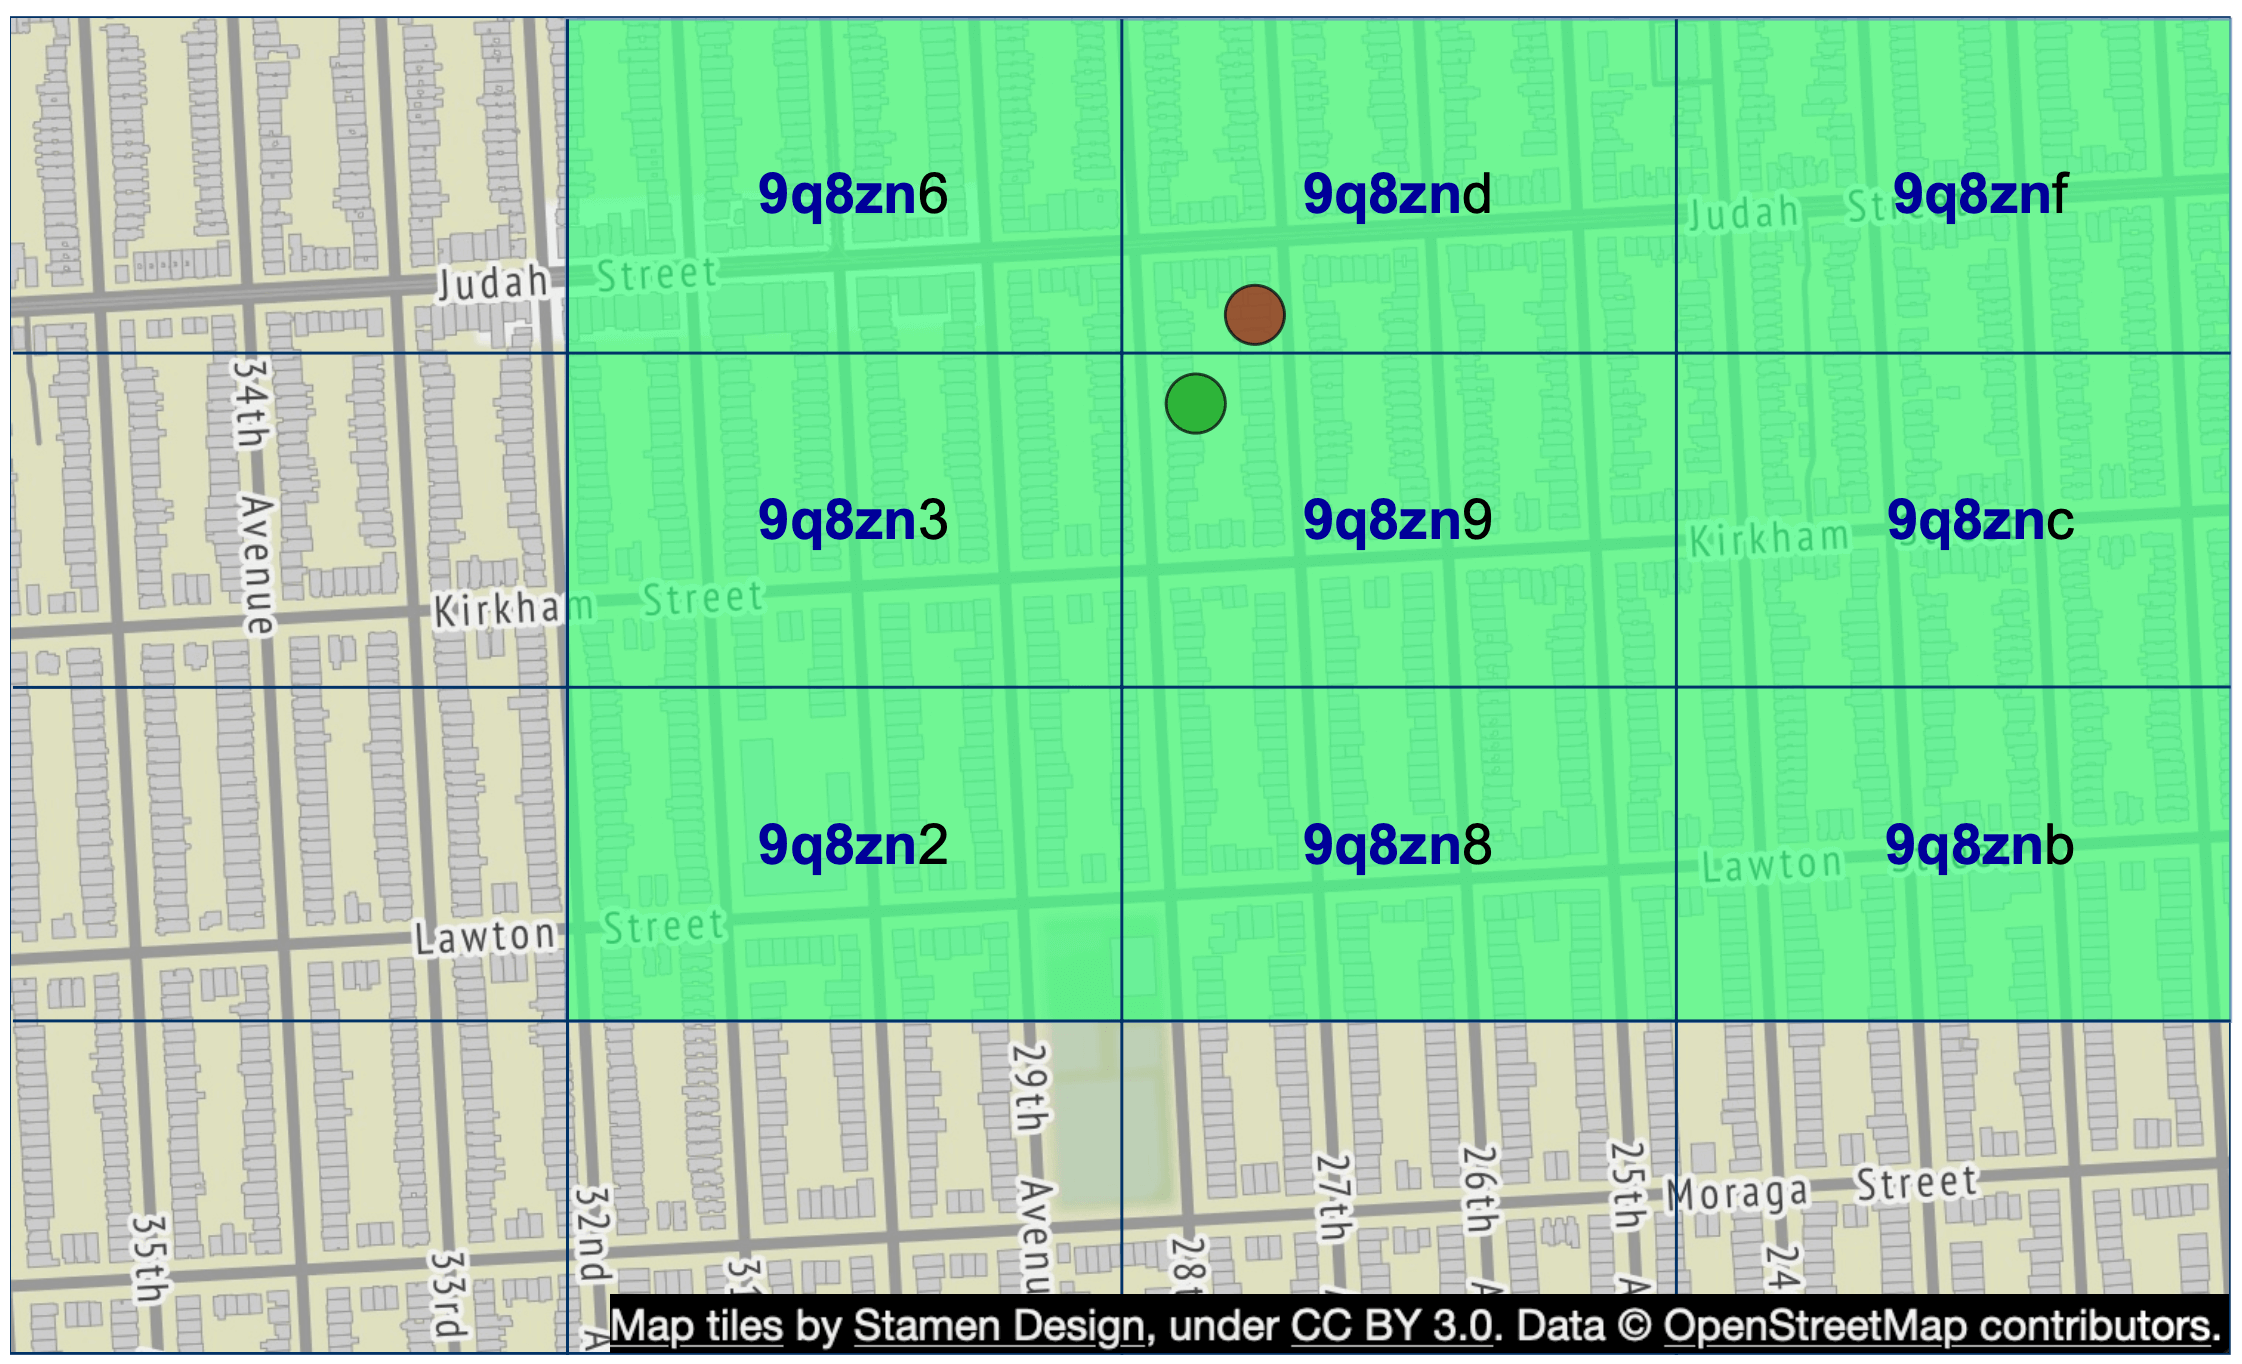
Рисунок 11 Проблема границы
Распространенное решение — искать бизнесы не только в текущей ячейке, но и в соседних. Geohash соседей вычисляются за константное время; подробности можно найти здесь [17].
Недостаточно бизнесов
Теперь разберем бонусный вопрос. Что делать, если текущая ячейка вместе со всеми соседями возвращает недостаточно бизнесов?
Вариант 1: возвращать только бизнесы в пределах радиуса. Реализовать это просто, но недостаток очевиден: пользователю может не хватить результатов.
Вариант 2: увеличивать радиус поиска. Можно удалить последнюю цифру geohash и использовать новый geohash для поиска nearby-бизнесов. Если результатов все еще мало, продолжаем расширять область, удаляя еще одну цифру. Так размер ячейки постепенно увеличивается, пока число результатов не превысит нужный порог. На рисунке 12 показана концептуальная схема такого расширения поиска.
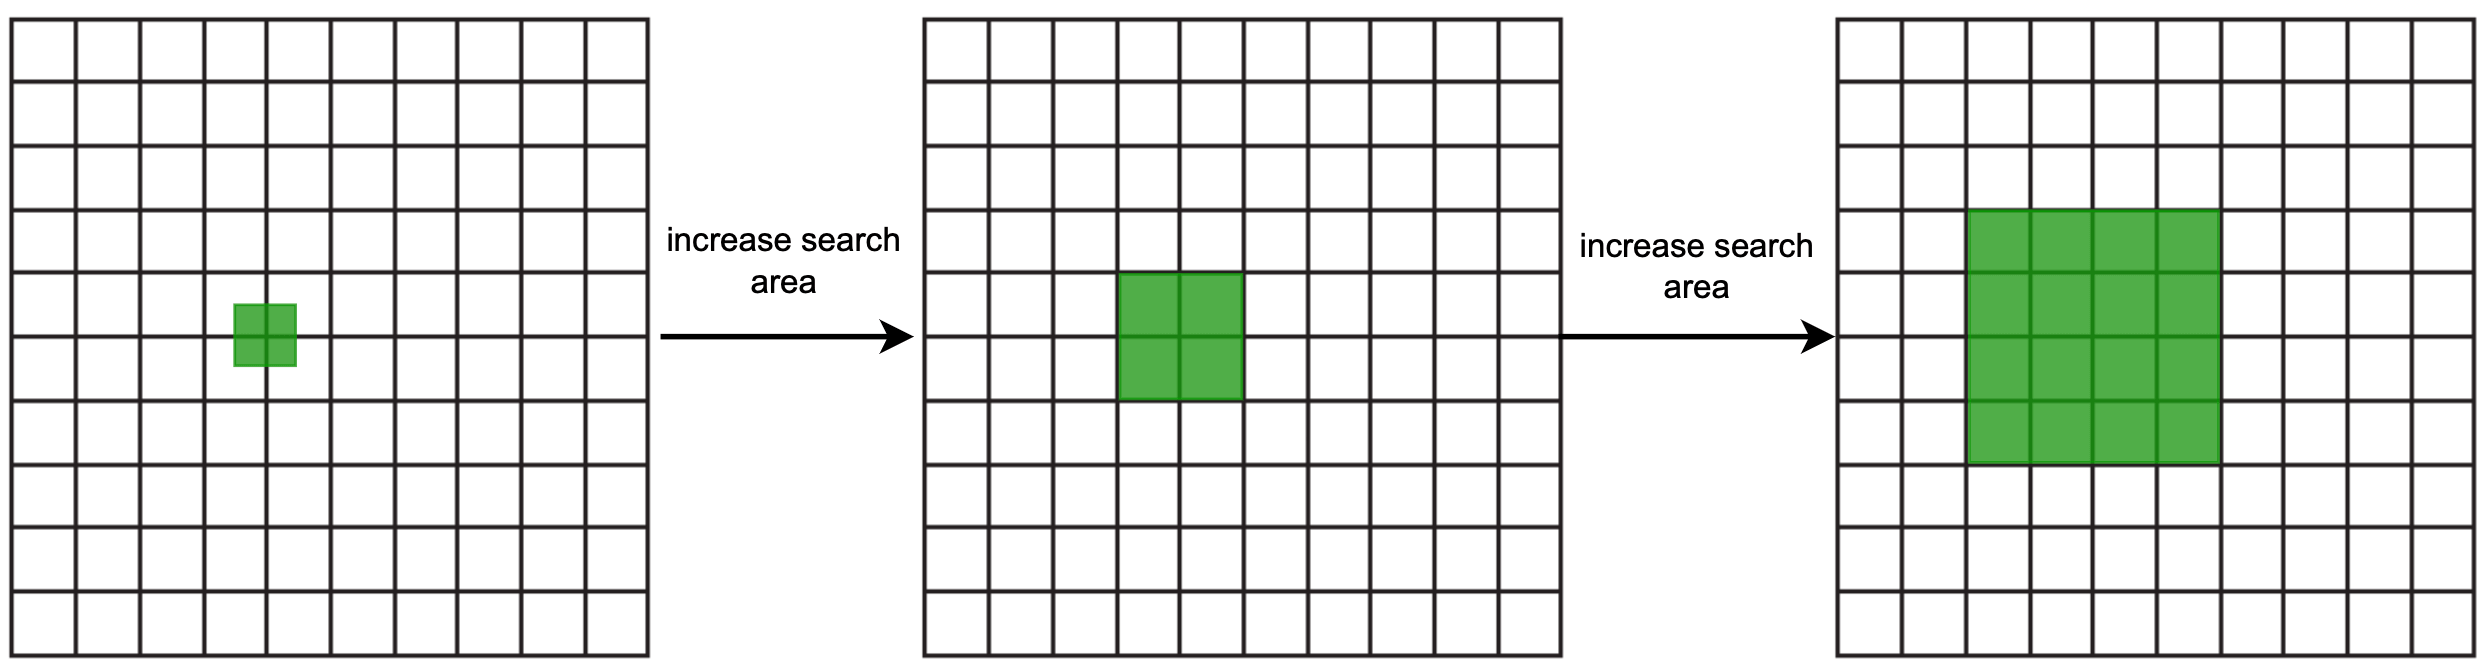
Рисунок 12 Процесс расширения области поиска
Вариант 4: Quadtree
Еще одно популярное решение — quadtree. Quadtree [18] — это структура данных, часто используемая для разбиения двумерного пространства путем рекурсивного деления его на четыре квадранта (grid-ячейки), пока содержимое ячеек не начнет удовлетворять некоторому критерию. Например, можно делить, пока в ячейке не останется не более 100 бизнесов. Это число выбрано произвольно; в реальности его задают исходя из требований бизнеса. При использовании quadtree мы строим in-memory tree structure для ответа на запросы. Важно: quadtree — это in-memory data structure, а не database solution. Она работает на каждом LBS server и строится во время старта сервера.
Следующий рисунок визуализирует концептуальный процесс разбиения мира в quadtree. Предположим, что в мире 200 миллионов бизнесов.
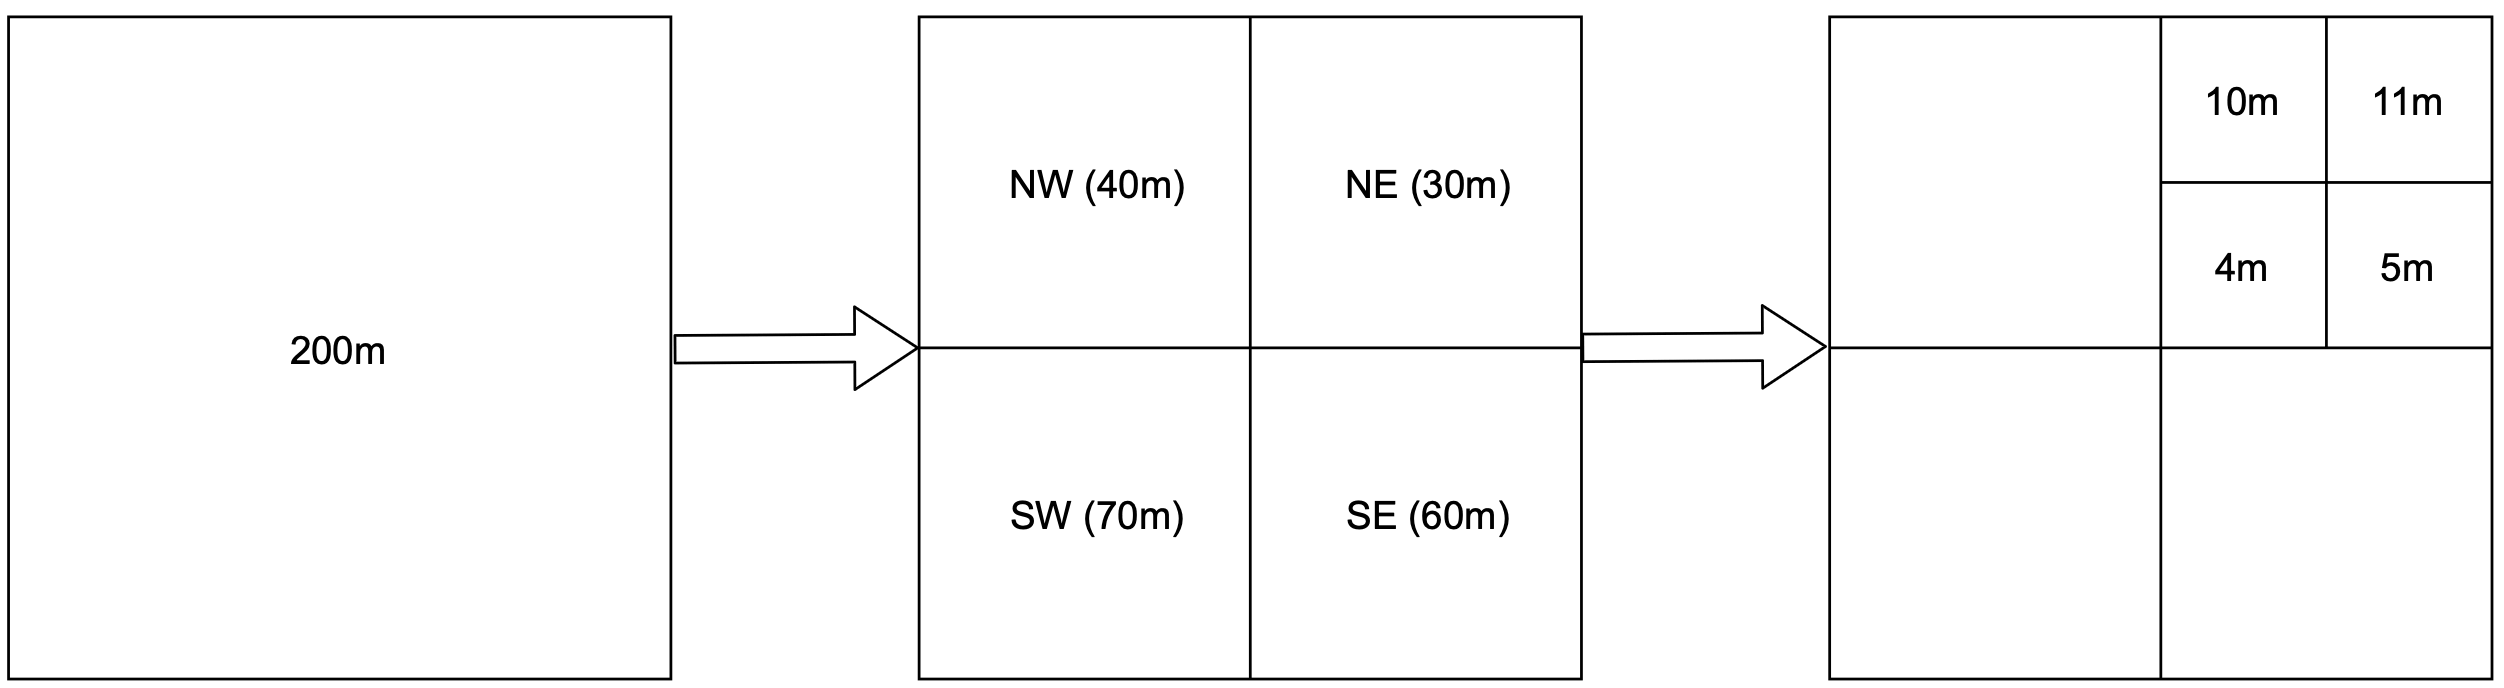
Рисунок 13 Quadtree
Рисунок 14 подробнее объясняет процесс построения quadtree. Root node представляет всю карту мира. Он рекурсивно разбивается на 4 квадранта, пока не останется узлов, содержащих больше 100 бизнесов.
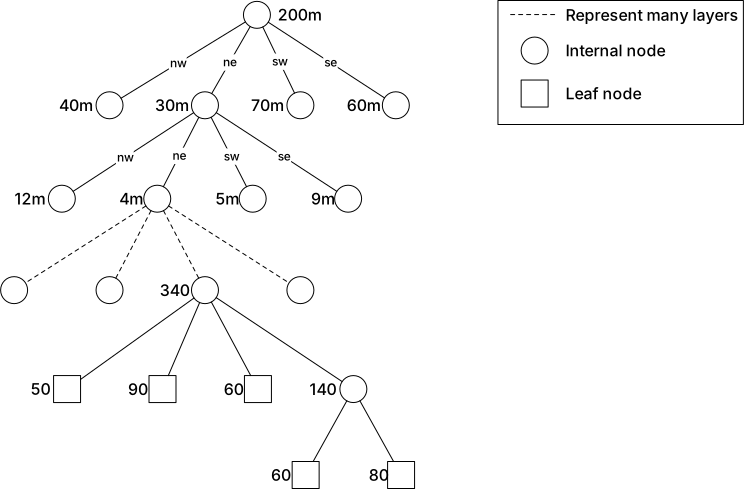
Рисунок 14 Построение quadtree
Псевдокод построения quadtree выглядит так:
public void buildQuadtree(TreeNode node) {
    if (countNumberOfBusinessesInCurrentGrid(node) > 100) {
        node.subdivide();
        for (TreeNode child : node.getChildren()) {
            buildQuadtree(child);
        }
    }
}
Чтобы ответить на вопрос о памяти, нужно понять, какие данные хранятся в узлах.
Данные в leaf node
| Название | Размер |
|---|---|
| Координаты верхнего левого и нижнего правого углов для идентификации ячейки | 32 байта (8 байт * 4) |
Список business_id в ячейке | 8 байт на ID * 100 (максимальное число бизнесов в одной ячейке) |
| Итого | 832 байта |
Таблица 6. Leaf node
Данные во internal node
| Название | Размер |
|---|---|
| Координаты верхнего левого и нижнего правого углов для идентификации ячейки | 32 байта (8 байт * 4) |
| Указатели на 4 дочерних узла | 32 байта (8 байт * 4) |
| Итого | 64 байта |
Таблица 7. Internal node
Хотя процесс построения дерева зависит от числа бизнесов в ячейке, это число не нужно хранить в узле quadtree, потому что его можно вывести из записей в базе данных.
Теперь, когда мы понимаем структуру данных каждого узла, оценим использование памяти.
-
Каждая ячейка может хранить максимум 100 бизнесов.
-
Число leaf nodes = ~200 миллионов / 100 = ~2 миллиона.
-
Число internal nodes = 2 миллиона * 1/3 = ~0.67 миллиона. Если вы не знаете, почему число internal nodes составляет треть от числа leaf nodes, посмотрите reference material [19].
-
Общий объем памяти = 2 миллиона * 832 байта + 0.67 миллиона * 64 байта = ~1.71 ГБ. Даже если добавить некоторый overhead на построение дерева, требования к памяти остаются небольшими.
На реальном интервью такие подробные вычисления обычно не нужны. Главное здесь — quadtree index не занимает слишком много памяти и легко помещается на одном сервере. Значит ли это, что нам достаточно одного сервера с quadtree index? Нет. В зависимости от read volume у одного сервера может не хватить CPU или network bandwidth для обслуживания всех чтений. В этом случае придется распределять read-нагрузку между несколькими quadtree-серверами.
Сколько времени занимает построение всего quadtree?
Каждый leaf node содержит примерно 100 business_id. Временная сложность построения дерева —
(N/100) lg(N/100), где N — общее число бизнесов. Для 200 миллионов бизнесов построение всего
quadtree может занять несколько минут.
Как получать nearby-бизнесы с quadtree?
-
Построить quadtree в памяти.
-
После построения дерева начать поиск с root и обходить его, пока не найдем leaf node, в которой находится точка начала поиска. Если в leaf node 100 бизнесов, вернуть ее. Иначе добавить бизнесы из соседних ячеек, пока результатов не станет достаточно.
Operational considerations для quadtree
Как уже говорилось, построение quadtree для 200 миллионов бизнесов при старте сервера может занимать несколько минут. Важно учитывать operational implications такого долгого старта. Пока quadtree строится, сервер не может обслуживать трафик. Поэтому новый релиз стоит выкатывать постепенно, на небольшую часть серверов за раз. Это позволяет не уронить заметную часть кластера и не вызвать brownout сервиса. Можно использовать и blue/green deployment [20], но если целый кластер новых серверов одновременно начнет забирать из database service 200 миллионов бизнесов, на систему ляжет большая нагрузка. Такое решение возможно, но усложняет дизайн, и на интервью это стоит проговорить.
Еще один operational question — как обновлять quadtree по мере добавления и удаления бизнесов. Самый простой подход — инкрементально пересобирать quadtree на небольшой подгруппе серверов, пока не обновится весь кластер. Но тогда часть серверов будет недолго возвращать устаревшие данные. Обычно это допустимый компромисс с учетом требований. Его можно дополнительно смягчить бизнес- договоренностью, что новые и обновленные бизнесы вступают в силу только на следующий день. Тогда cache можно обновлять nightly job. Потенциальная проблема такого подхода — огромное число ключей будет инвалидировано одновременно, что создаст тяжелую нагрузку на cache servers.
Также можно обновлять quadtree на лету при добавлении и удалении бизнесов. Но это заметно усложняет дизайн, особенно если к структуре quadtree одновременно обращаются несколько потоков. Понадобится locking mechanism, который может сильно усложнить реализацию.
Реальный пример quadtree
Yext предоставила изображение (рисунок 15), на котором показан построенный quadtree рядом с Денвером. Нам нужны более мелкие, детальные ячейки для плотных районов и более крупные — для разреженных.
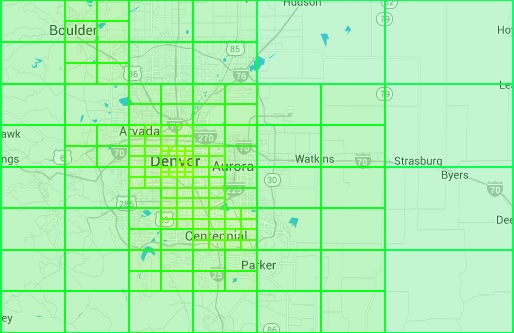
Рисунок 15 Реальный пример quadtree
Вариант 5: Google S2
Библиотека Google S2 geometry [22] — еще один крупный игрок в этой области. Как и quadtree, это in-memory solution. Она отображает сферу в 1D index на основе кривой Гильберта (space-filling curve) [23]. У кривой Гильберта есть очень важное свойство: две точки, близкие друг к другу на кривой, близки и в 1D space (рисунок 16). Поиск в 1D значительно эффективнее, чем в 2D. Любознательные читатели могут поиграться с online tool [24] для кривой Гильберта.
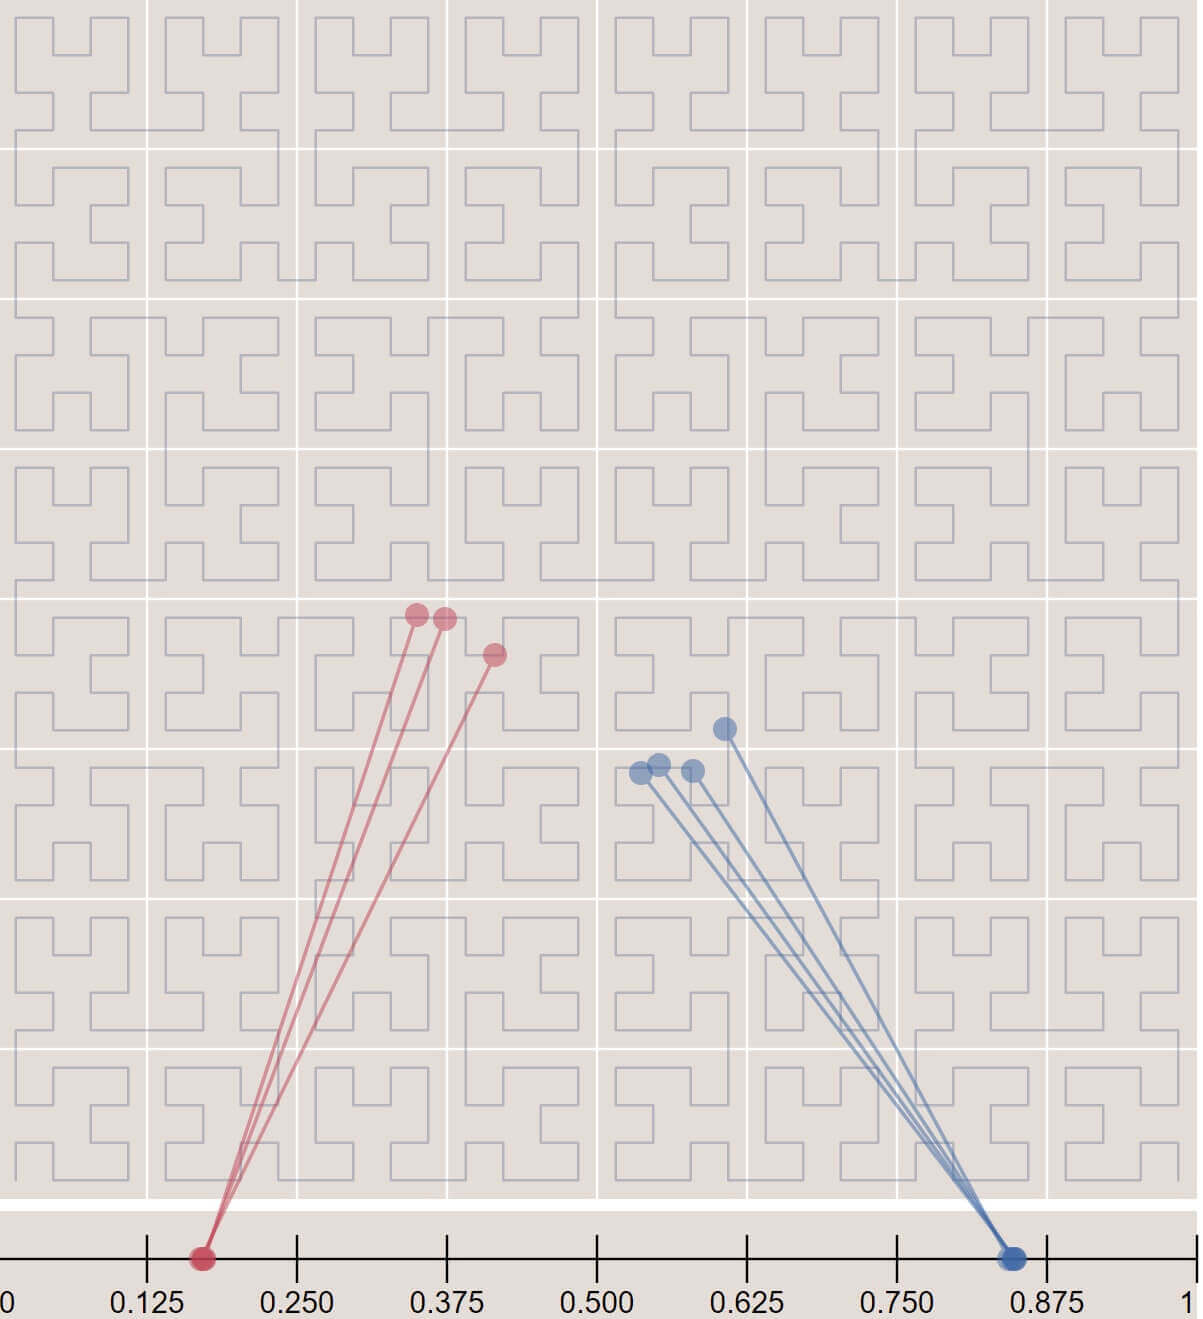
Рисунок 16 Кривая Гильберта (источник: [24])
S2 — сложная библиотека, и на интервью от вас не ждут объяснения ее внутренностей. Но, поскольку она широко используется в Google, Tinder и других компаниях, мы коротко разберем ее плюсы.
-
S2 отлично подходит для geofencing, потому что умеет покрывать произвольные области ячейками разных уровней (рисунок 17). Согласно Wikipedia, “A geofence is a virtual perimeter for a real-world geographic area. A geo-fence could be dynamically generated — as in a radius around a point location, or a geo-fence can be a predefined set of boundaries (such as school zones or neighborhood boundaries)” [25].
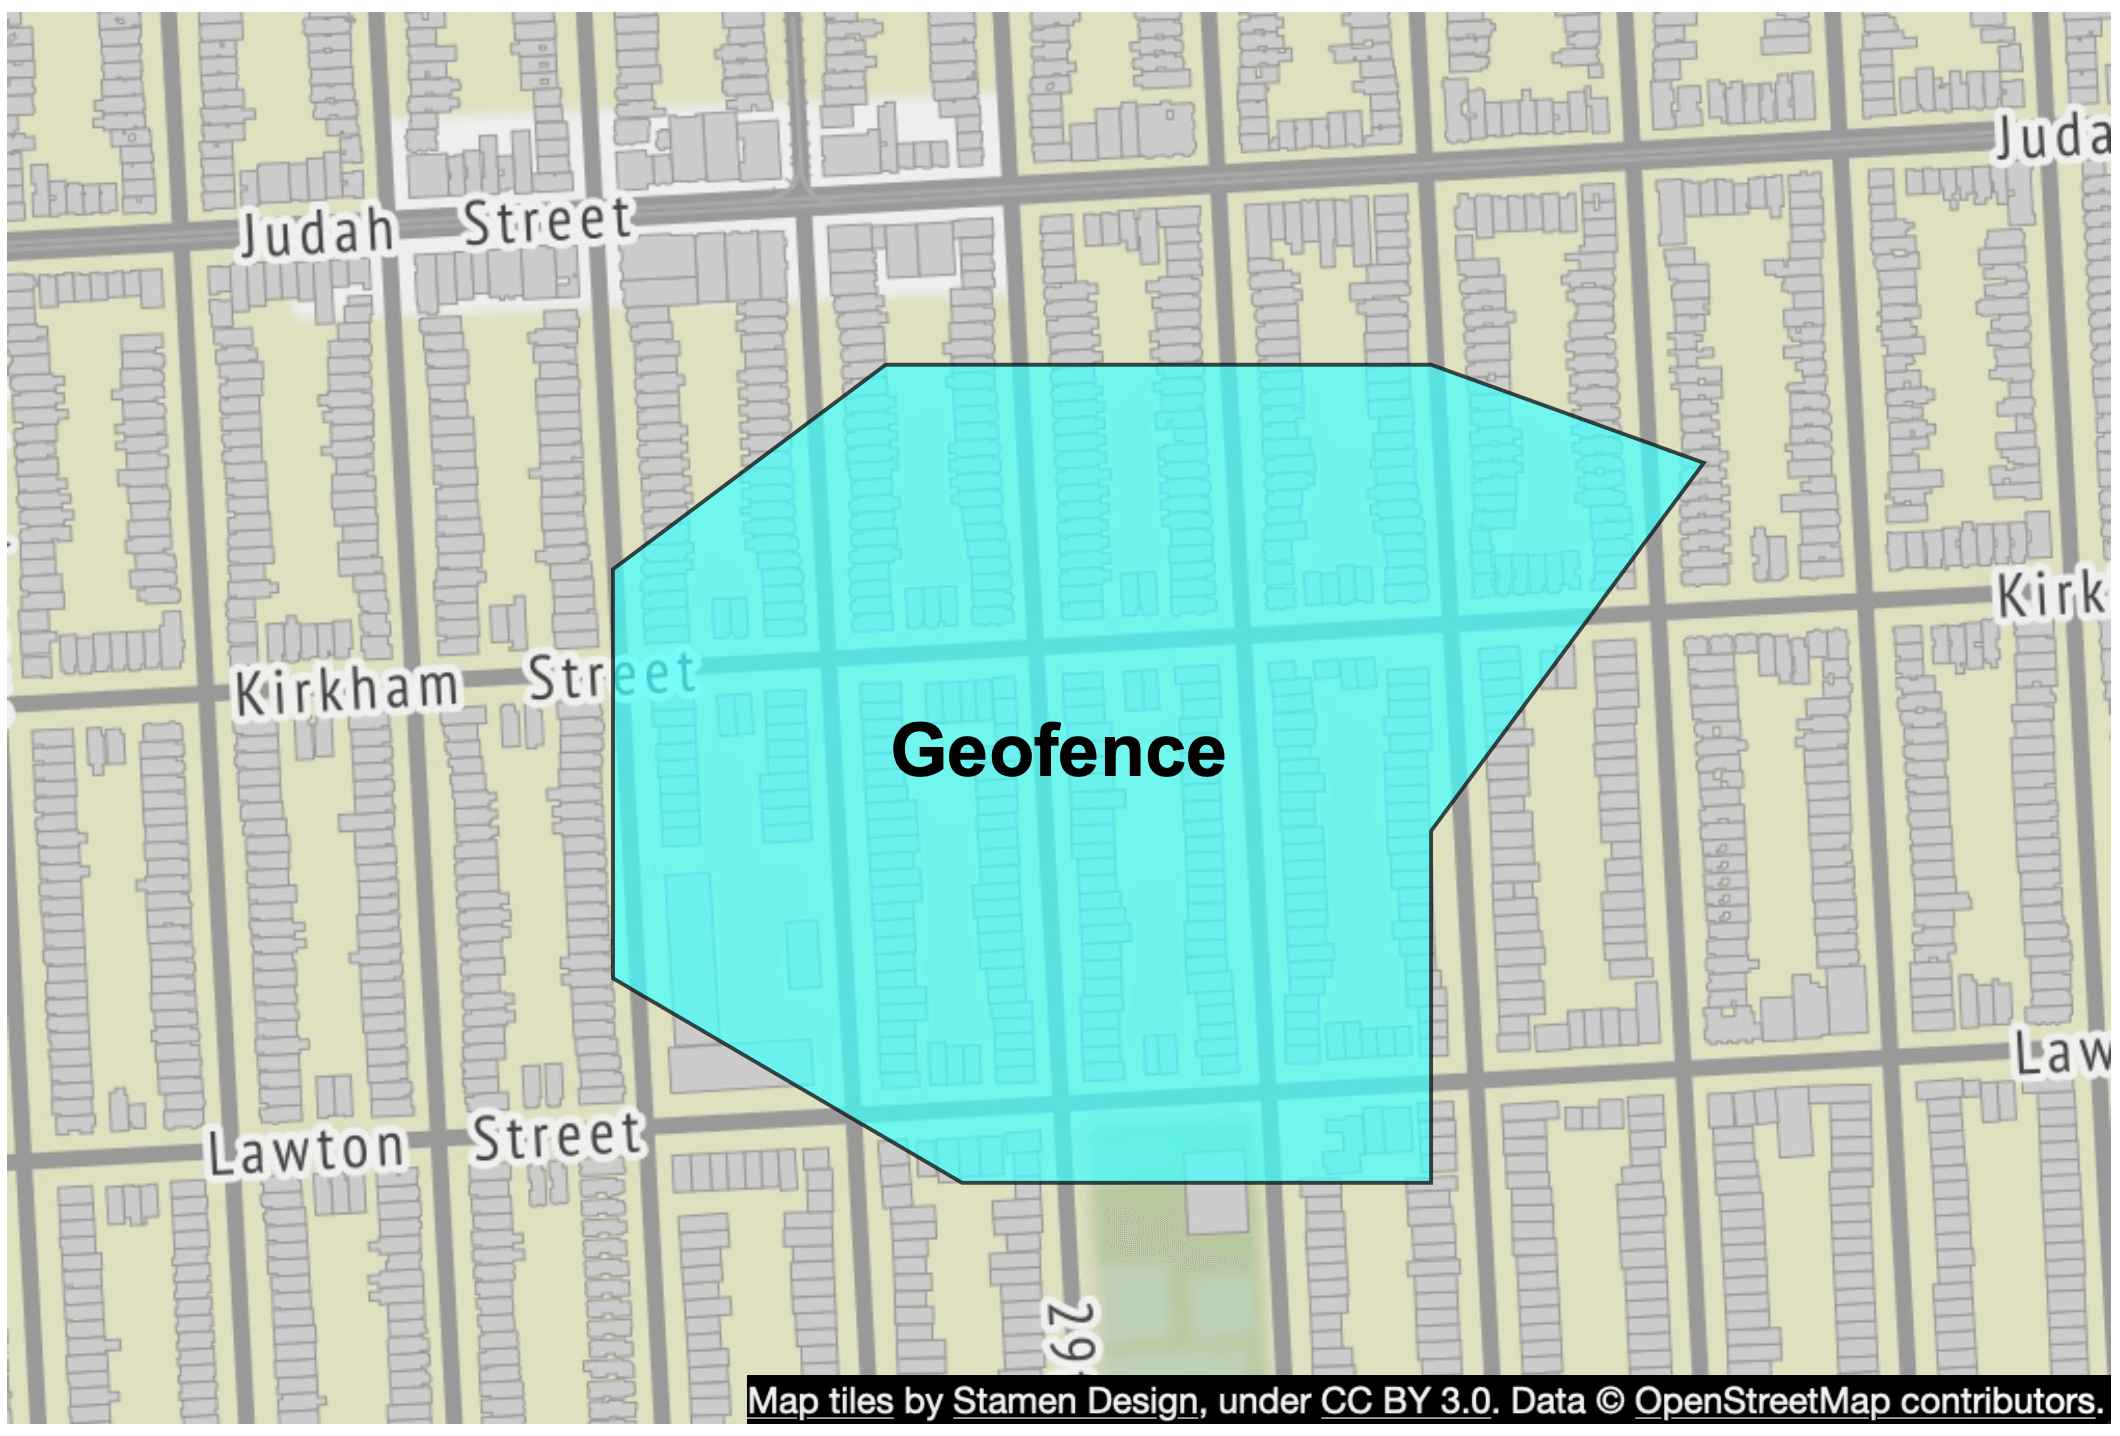
Рисунок 17 Geofence
Geofencing позволяет задавать периметры вокруг интересующих областей и отправлять уведомления пользователям, которые находятся вне этих областей. Это дает более богатые возможности, чем просто возврат nearby-бизнесов.
-
Еще одно преимущество S2 — его алгоритм Region Cover [26]. В отличие от geohash, где уровень точности фиксирован, в S2 можно задавать
min level,max levelиmax cells. Результат у S2 получается более детализированным, потому что размеры ячеек гибкие. Если хочется узнать подробнее, посмотрите S2 tool [26].
Рекомендация
Для эффективного поиска nearby-бизнесов мы обсудили несколько вариантов: geohash, quadtree и S2. Как видно из таблицы 8, разные компании и технологии используют разные подходы.
| Geo Index | Компании |
|---|---|
| Geohash | Bing map [27], Redis [10], MongoDB [28], Lyft [29] |
| Quadtree | Yext [21] |
| И geohash, и quadtree | Elasticsearch [30] |
| S2 | Google Maps, Tinder [31] |
Таблица 8. Разные типы geo indexes
На интервью мы рекомендуем выбирать geohash или quadtree, потому что S2 сложнее объяснить четко и коротко.
Geohash vs quadtree
Прежде чем закончить этот раздел, быстро сравним geohash и quadtree.
Geohash
-
Прост в использовании и реализации. Не нужно строить дерево.
-
Поддерживает возврат бизнесов в пределах заданного радиуса.
-
Если precision (level) у geohash фиксирована, размер ячейки тоже фиксирован. Он не умеет сам динамически подстраивать размер ячейки под плотность населения. Для этого нужна дополнительная логика.
-
Индекс легко обновлять. Например, чтобы удалить бизнес из индекса, достаточно удалить его из соответствующей строки с тем же
geohashиbusiness_id. См. рисунок 18.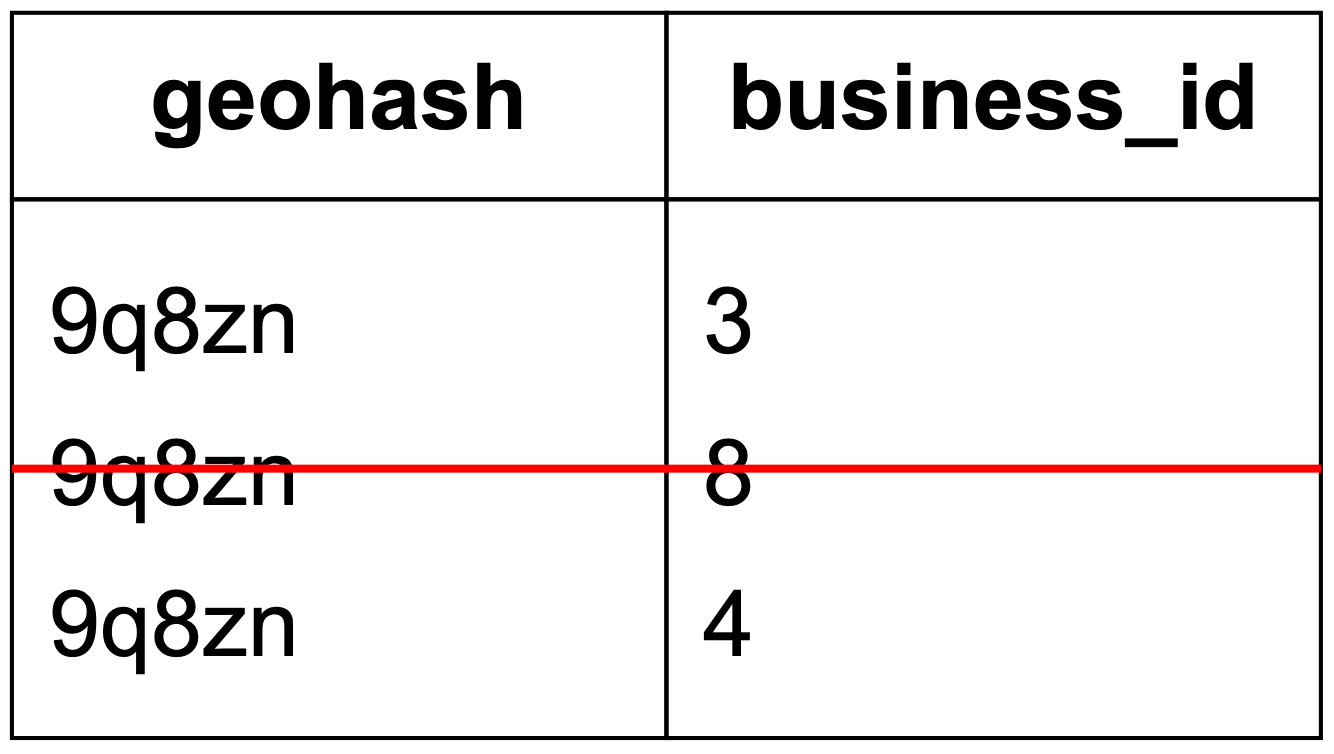
Рисунок 18 Удаление бизнеса
Quadtree
-
Немного сложнее в реализации, потому что нужно строить дерево.
-
Поддерживает сценарий поиска k ближайших бизнесов. Иногда нам нужно просто вернуть k ближайших объектов и неважно, укладываются ли они в заданный радиус. Например, в поездке, когда в машине заканчивается бензин, вы хотите найти ближайшие k заправок. Они могут быть не очень близко, но приложение должно вернуть именно ближайшие k результатов. Для такого типа запросов quadtree подходит хорошо, потому что его разбиение завязано на число
kи он может автоматически расширять область поиска, пока не получитkрезультатов. -
Может динамически подстраивать размер ячейки под плотность населения (см. пример с Денвером на рисунке 15).
-
Обновлять индекс сложнее, чем в geohash. Quadtree — это tree structure. Если бизнес удаляется, нужно пройти от root до leaf node и удалить его там. Например, если мы хотим удалить бизнес с
ID = 2, придется пройти от root до leaf node, как показано на рисунке 19. Обновление индекса занимаетO(logn), но реализация усложняется, если структуру данных использует многопоточная программа, потому что нужен locking. Кроме того, сложным может быть и rebalancing дерева. Ребалансировка нужна, например, если в leaf node больше нет места для новой записи. Возможное решение — изначально выделять диапазоны с запасом.
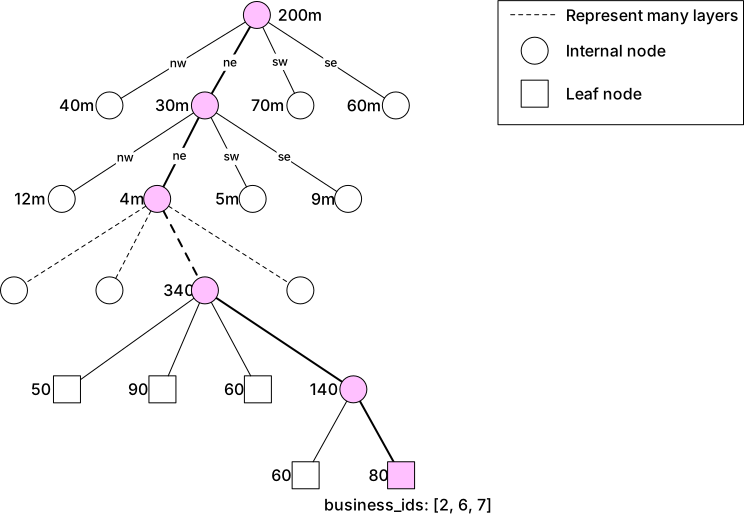
Рисунок 19 Обновление quadtree
Шаг 3 — Deep Dive дизайна
К этому моменту у нас уже должна сложиться хорошая картина всей системы. Теперь углубимся в несколько областей.
-
Масштабирование базы данных
-
Кэширование
-
Regions и availability zones
-
Фильтрация результатов по времени или типу бизнеса
-
Финальная архитектурная диаграмма
Scale the database
Обсудим, как масштабировать две важнейшие таблицы: business и geospatial index table.
Таблица business
Данные таблицы business могут не поместиться на одном сервере, поэтому это хороший кандидат на
sharding. Самый простой подход — shard everything by business_id. Такая схема распределяет
нагрузку между shard-ами довольно равномерно и с operational point of view проста в поддержке.
Таблица geospatial index
И geohash, и quadtree широко используются. Из-за простоты geohash возьмем его как пример. Есть два способа организовать такую таблицу.
Вариант 1: для каждого ключа geohash в одной строке хранится JSON array из business_id. То
есть все business_id в пределах одного geohash лежат в одной записи.

Таблица 9. list_of_business_ids — это JSON array
Вариант 2: если в одном geohash несколько бизнесов, у каждого бизнеса будет своя строка. То есть
разные business_id внутри одного geohash хранятся в разных строках.

Таблица 10. business_id — это отдельный ID
Ниже приведен пример строк для варианта 2.
| geohash | business_id |
|---|---|
| 32feac | 343 |
| 32feac | 347 |
| f3lcad | 112 |
| f3lcad | 113 |
Таблица 11. Пример строк в geospatial index table
Рекомендация: мы рекомендуем вариант 2 по следующим причинам.
В варианте 1, чтобы обновить бизнес, нужно сначала получить массив business_id, затем просканить
его целиком и найти нужный бизнес. При вставке нового бизнеса придется снова сканировать весь
массив, чтобы убедиться, что дубликата нет. Кроме того, нужно блокировать строку, чтобы
предотвратить concurrent updates. Возникает множество edge cases.
В варианте 2, если у нас есть две колонки с compound key из (geohash, business_id), добавление
и удаление бизнеса становятся очень простыми. Ничего блокировать не нужно.
Масштабирование geospatial index
Одна из частых ошибок в разговоре о масштабировании geospatial index — слишком быстро перейти к sharding-схеме, не оценив реальный размер таблицы. В нашем случае полный dataset geospatial index не так уж велик (quadtree index занимает всего 1.71 ГБ памяти, а требования к хранению для geohash index сопоставимы). Весь geospatial index легко помещается в working set современного database server. Однако, в зависимости от read volume, одному серверу может не хватить CPU или network bandwidth для обработки всех чтений. Если это так, нужно распределить read-нагрузку между несколькими database servers.
Существует два общих подхода к распределению нагрузки реляционной базы: можно добавить read replicas или shard-ить базу.
Многие инженеры любят говорить о sharding на интервью. Но для geohash table это может быть не лучший выбор, потому что sharding усложняет систему. Например, sharding logic придется добавлять на уровень application layer. Иногда sharding — единственный вариант. Но здесь все помещается в working set одного database server, так что сильной технической причины shard-ить данные между несколькими серверами нет.
В данном случае лучше использовать набор read replicas, чтобы снять read-нагрузку. Такой подход намного проще в разработке и поддержке. Поэтому для geospatial index table рекомендуется масштабирование через replicas.
Caching
Прежде чем вводить слой cache, стоит спросить себя: действительно ли он нужен?
Неочевидно, что cache здесь даст сильный выигрыш:
-
Нагрузка read-heavy, а dataset сравнительно небольшой. Данные могут поместиться в working set любого современного database server. Значит, запросы не будут I/O bound и могут выполняться почти так же быстро, как и из in-memory cache.
-
Если read performance становится bottleneck, можно просто добавить database read replicas и увеличить throughput по чтению.
Обсуждая caching с интервьюером, важно быть аккуратным: здесь нужны тщательные benchmarking и cost analysis. Если выяснится, что cache соответствует бизнес-требованиям, тогда уже можно переходить к стратегии кэширования.
Cache key
Самый очевидный вариант cache key — координаты пользователя (latitude, longitude). Но у такого
решения есть несколько проблем:
-
Координаты, полученные с мобильных телефонов, неточны и являются лишь лучшей оценкой [32]. Даже если вы стоите на месте, телефон может возвращать немного разные координаты каждый раз.
-
Пользователь может слегка переместиться, из-за чего координаты немного поменяются. Для большинства приложений такое изменение несущественно.
Поэтому координаты — плохой cache key. В идеале небольшие изменения положения должны по-прежнему сопоставляться с тем же cache key. Решения на основе geohash/quadtree отлично решают эту задачу, потому что все бизнесы внутри одной grid-ячейки мапятся на один и тот же geohash.
Какие данные кэшировать
Как показано в таблице 12, есть два типа данных, которые можно кэшировать для улучшения общей производительности системы:
| Ключ | Значение |
|---|---|
| geohash | Список business_id в ячейке |
| business_id | Объект business |
Таблица 12. Key-value пары в cache
Список business_id в grid-ячейке
Поскольку данные о бизнесах относительно стабильны, мы заранее вычисляем список business_id для
данного geohash и храним его в key-value store, например Redis. Посмотрим на конкретный пример
получения nearby-бизнесов при включенном cache.
-
Получить список
business_idдля заданного geohash.SELECT business_id FROM geohash_index WHERE geohash LIKE `{:geohash}%` -
Сохранить результат в Redis, если произошел cache miss.
public List<String> getNearbyBusinessIds(String geohash) {
    String cacheKey = hash(geohash);
    List<string> listOfBusinessIds = Redis.get(cacheKey);
    if (listOfBusinessIDs  == null) {
        listOfBusinessIds = Run the select SQL query above;
        Cache.set(cacheKey, listOfBusinessIds, "1d");
    }
    return listOfBusinessIds;
}
Когда бизнес добавляется, редактируется или удаляется, база данных обновляется, а cache инвалидируется. Поскольку объем таких операций относительно мал и для geohash-подхода не нужен locking, обновления обрабатывать несложно.
Согласно требованиям, пользователь может выбрать на клиенте следующие радиусы: 500 м, 1 км, 2 км
и 5 км. Эти радиусы отображаются в geohash длины 4, 5, 5 и 6 соответственно. Чтобы быстро
получать nearby-бизнесы для разных радиусов, мы кэшируем данные в Redis на всех трех уровнях
точности (geohash_4, geohash_5 и geohash_6).
Как уже говорилось, у нас 200 миллионов бизнесов, и каждый бизнес принадлежит одной grid-ячейке на каждом уровне точности. Следовательно, общий требуемый объем памяти:
-
Память под значения Redis:
8 bytes * 200 million * 3 precisions = ~5 GB -
Память под ключи Redis: пренебрежимо мала
-
Итого:
~5 GB
С точки зрения памяти нам может хватить одного современного Redis server, но для высокой availability и уменьшения межконтинентальной latency мы разворачиваем Redis cluster по всему миру. С учетом оцененного объема данных мы можем хранить одинаковую копию cache глобально. В финальной архитектурной диаграмме (рисунок 21) мы называем этот Redis cache “Geohash”.
Business data, нужные для отрисовки страниц на клиенте
Этот тип данных кэшировать очень просто. Ключ — business_id, значение — объект business,
содержащий название бизнеса, адрес, image URLs и т. д. В финальной архитектурной диаграмме
(рисунок 21) мы называем этот Redis cache “Business info”.
Regions и availability zones
Мы разворачиваем location-based service в нескольких регионах и availability zones, как показано на рисунке 21. Это дает несколько преимуществ:
-
Делает пользователей физически “ближе” к системе. Пользователи с US West подключаются к дата-центрам в этом регионе, а пользователи из Европы — к дата-центрам в Европе.
-
Дает гибкость в равномерном распределении трафика по популяции. Некоторые регионы, например Япония и Корея, имеют высокую плотность населения. Может быть разумно выделить их в отдельные регионы или даже развернуть LBS в нескольких availability zones, чтобы распределить нагрузку.
-
Privacy laws. Некоторые страны требуют, чтобы пользовательские данные использовались и хранились локально. В этом случае можно поднять регион внутри такой страны и через DNS routing направлять все запросы из этой страны только в этот регион.
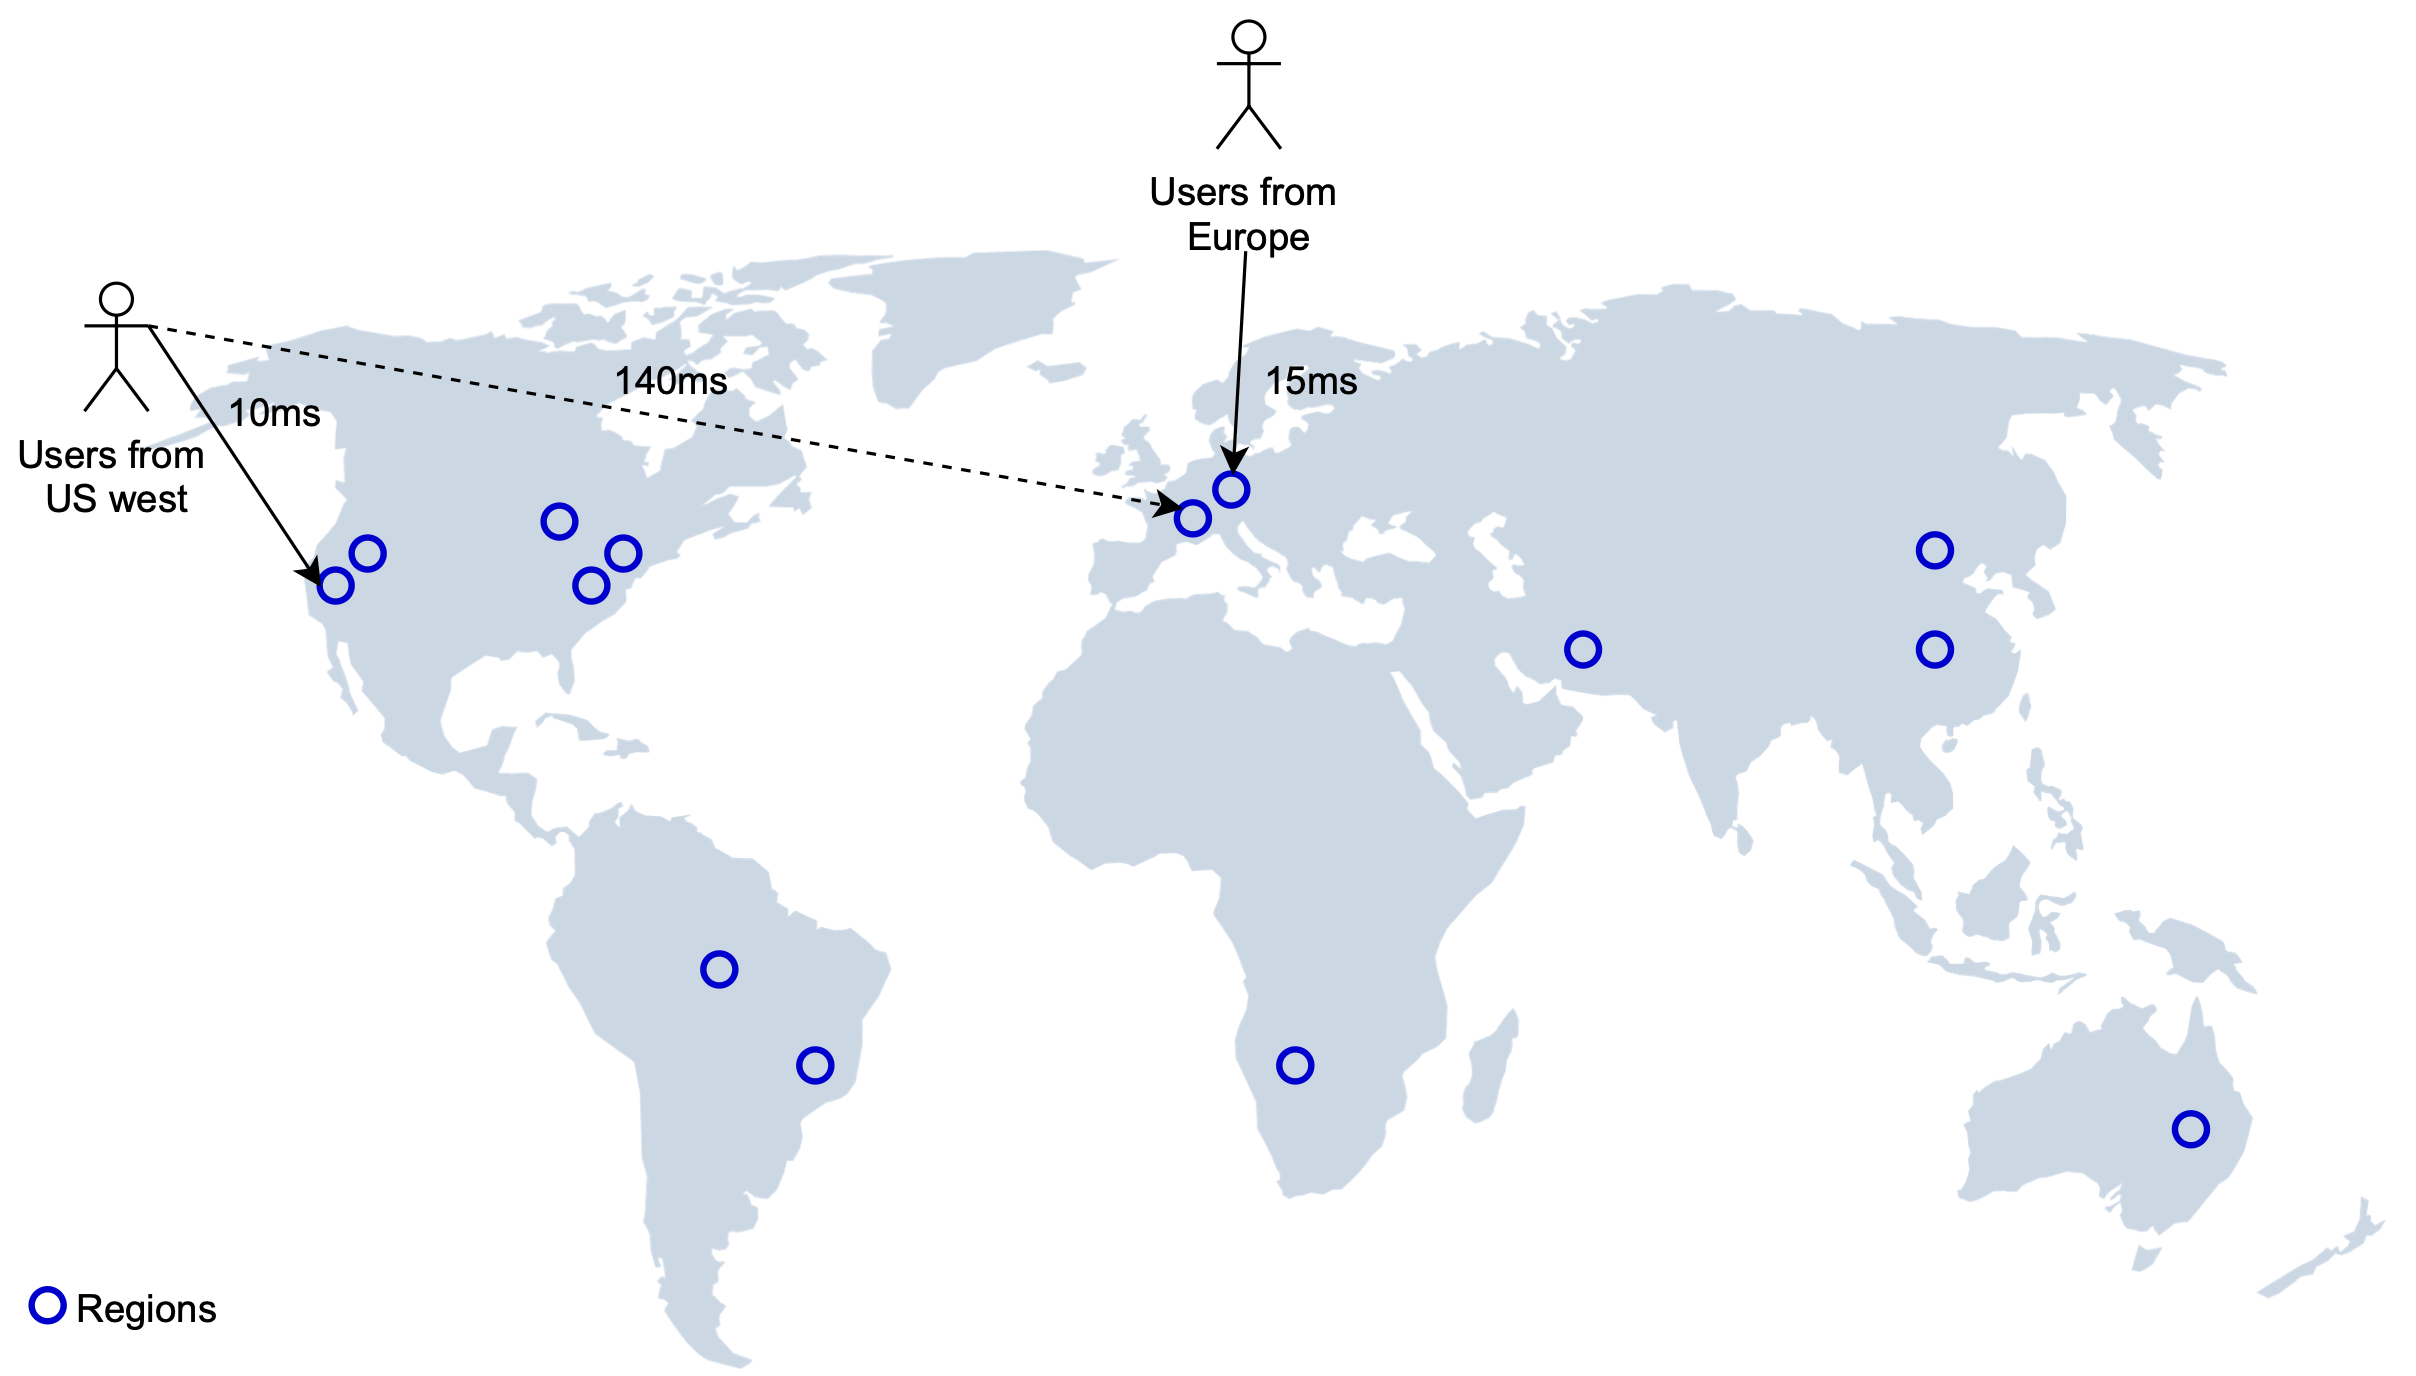
Рисунок 20 Размещение LBS ближе к пользователю
Дополнительный вопрос: фильтрация результатов по времени или типу бизнеса
Интервьюер может спросить: как возвращать только те бизнесы, которые сейчас открыты, или только рестораны?
Кандидат: Когда мир разбит на небольшие grid-ячейки с помощью geohash или quadtree, число
бизнесов в результате поиска относительно мало. Поэтому допустимо сначала вернуть business_id,
потом гидрировать объекты business, а затем отфильтровать их по времени работы или типу бизнеса.
Это решение предполагает, что часы работы и тип бизнеса хранятся в таблице business.
Финальная диаграмма дизайна
Соберем все вместе и получим следующую диаграмму.
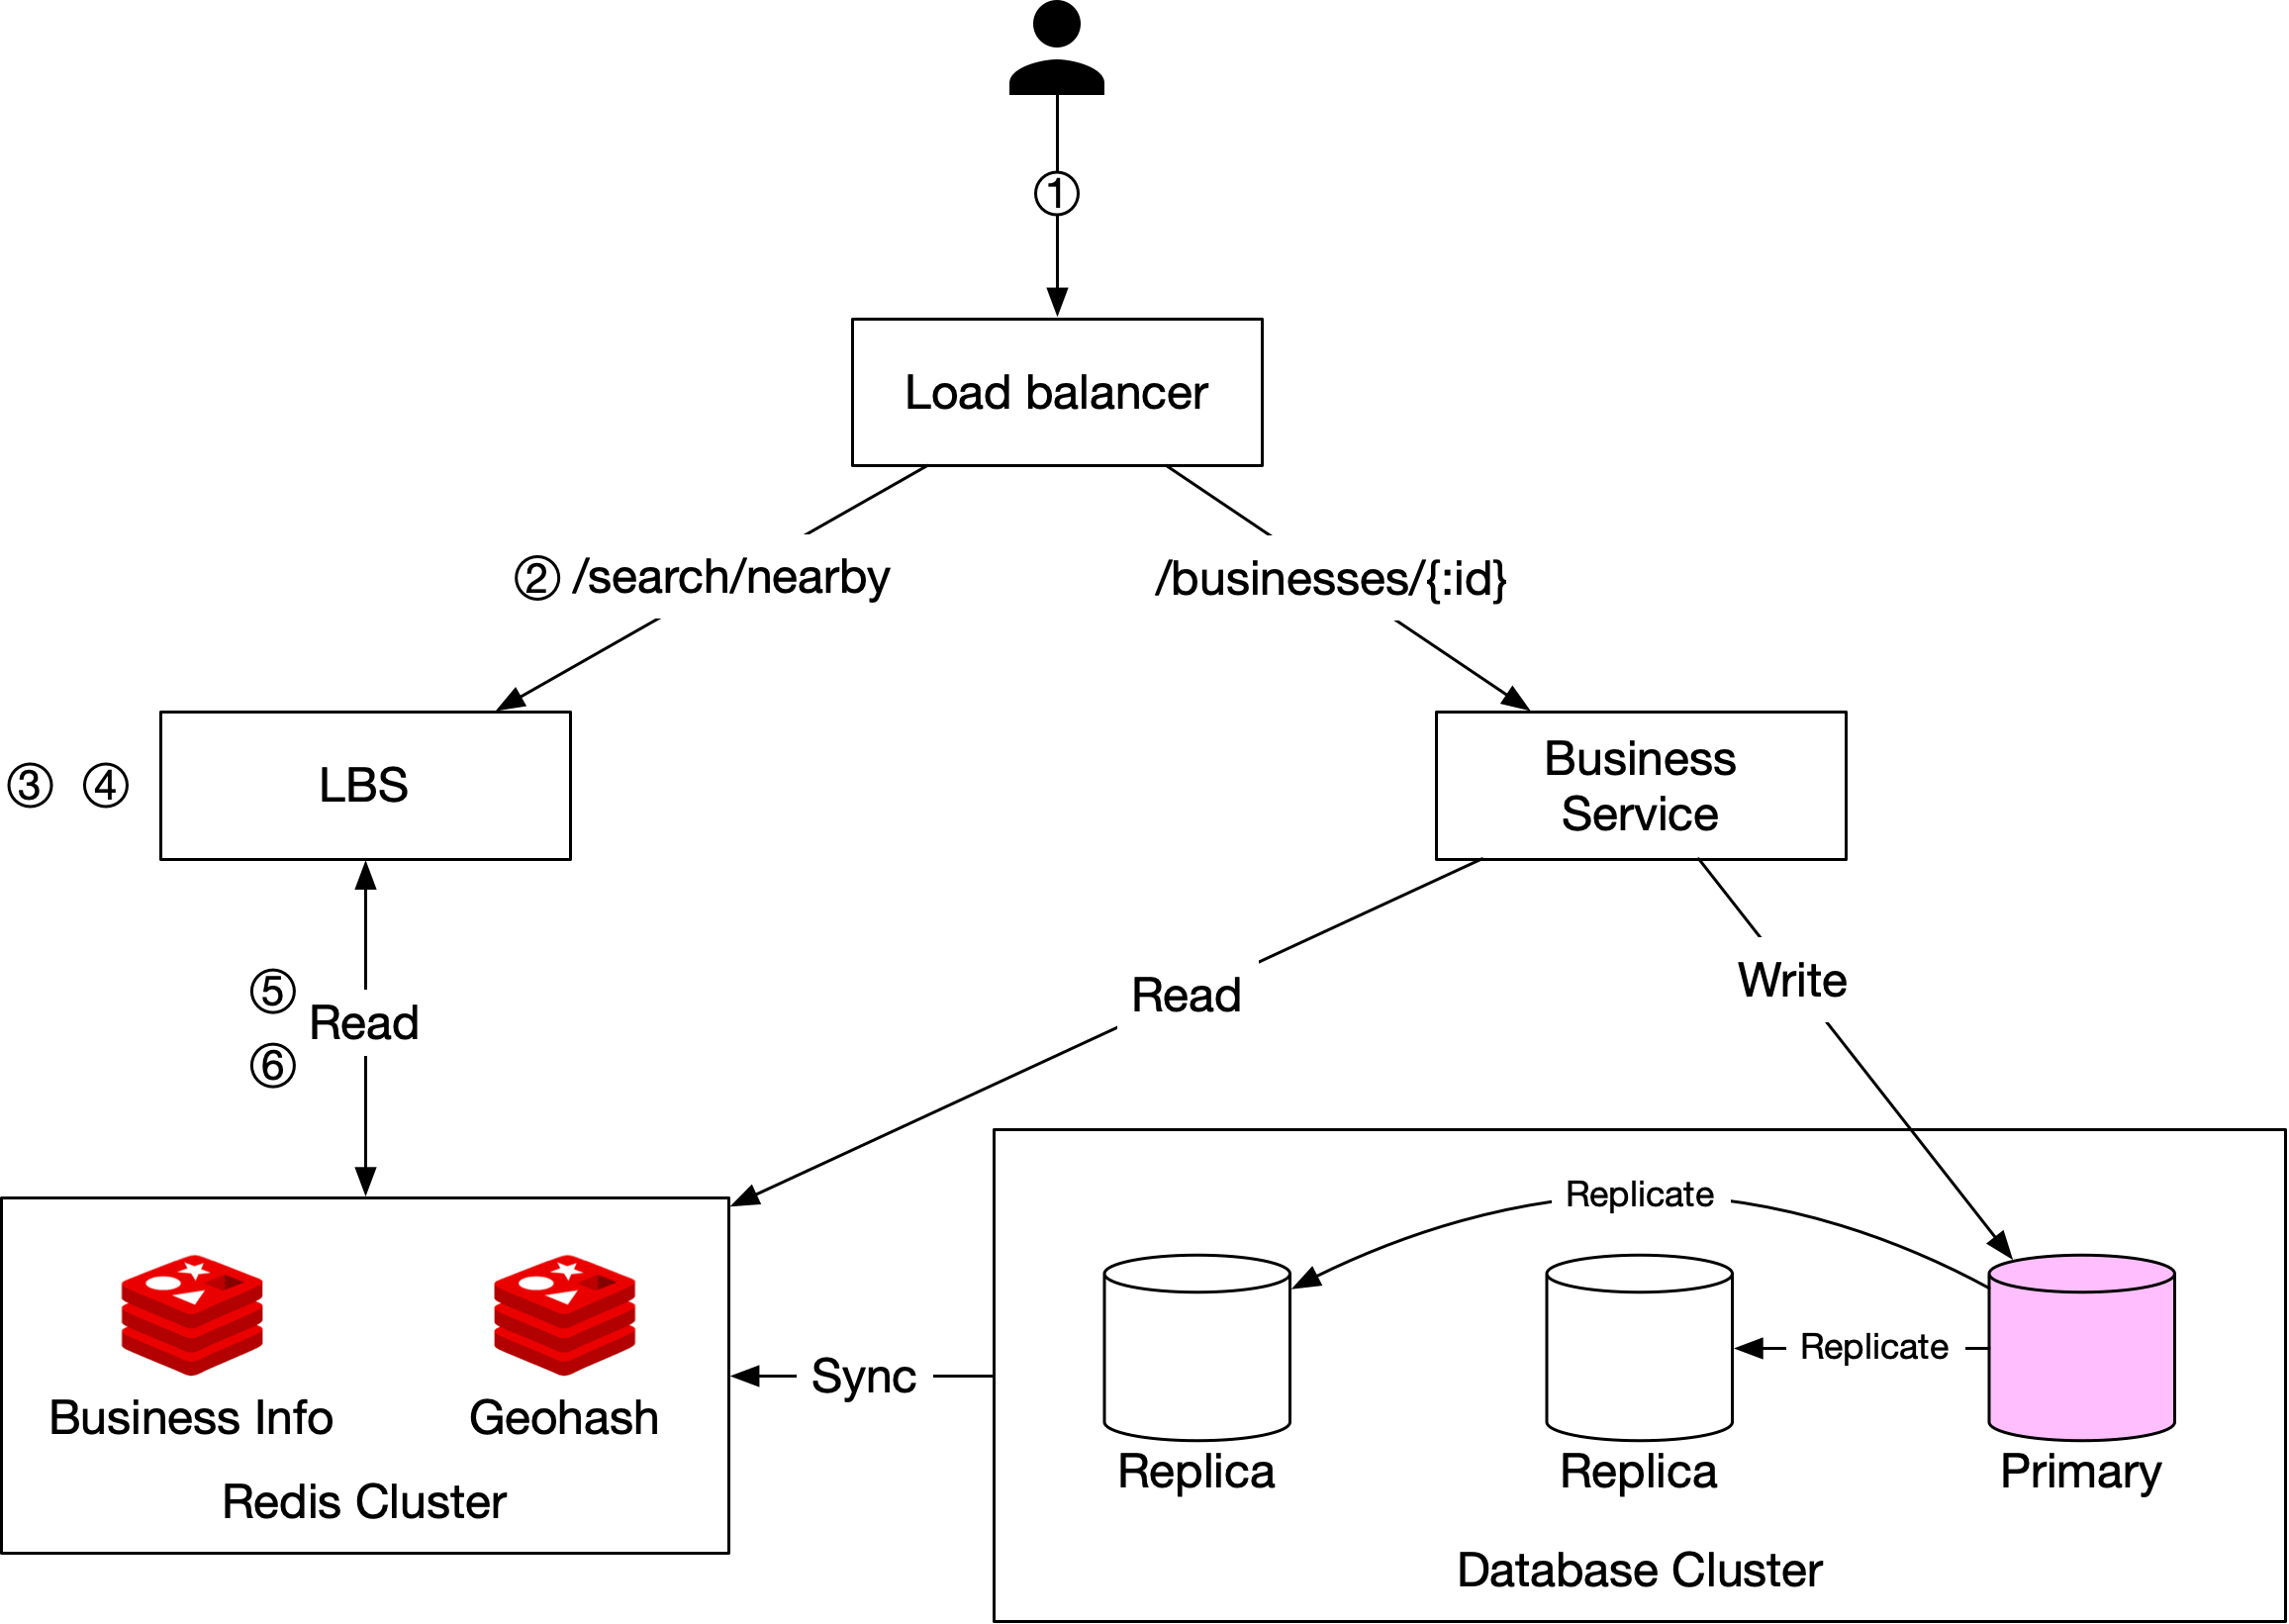
Рисунок 21 Архитектурная диаграмма
Получение nearby-бизнесов
-
Вы пытаетесь найти рестораны в радиусе 500 метров в Yelp. Клиент отправляет в load balancer координаты пользователя (
latitude = 37.776720,longitude = -122.416730) и радиус (500 м). -
Load balancer перенаправляет запрос в LBS.
-
На основе координат и радиуса LBS определяет длину geohash, соответствующую этому поиску. Согласно таблице 5, 500 м соответствуют
geohash length = 6. -
LBS вычисляет geohash соседних ячеек и добавляет их в список. Получается что-то вроде:
list_of_geohashes = [my_geohash, neighbor1_geohash, neighbor2_geohash, …, neighbor8_geohash]. -
Для каждого geohash из
list_of_geohashesLBS обращается к Redis-серверу “Geohash”, чтобы получить соответствующиеbusiness_id. Чтобы уменьшить latency, вызовы для разных geohash можно выполнять параллельно. -
Используя полученный список
business_id, LBS запрашивает полную информацию о бизнесах из Redis-сервера “Business info”, затем вычисляет расстояния между пользователем и бизнесами, ранжирует их и возвращает результат клиенту.
Просмотр, обновление, добавление и удаление бизнеса
Все API, связанные с business, отделены от LBS. Чтобы получить подробную информацию о бизнесе, business service сначала проверяет, есть ли данные в Redis cache “Business info”. Если есть, он возвращает cached data клиенту. Если нет, сервис читает данные из database cluster, затем кладет их в Redis cache, чтобы последующие запросы получали ответ уже из cache.
Поскольку у нас есть предварительная договоренность с бизнесом, что новые и обновленные данные вступают в силу на следующий день, cached business data обновляются nightly job.
Шаг 4 — Wrap-up
В этой главе мы представили дизайн proximity service. Это типичный LBS, использующий geospatial indexing. Мы обсудили несколько вариантов индексации:
-
Двумерный поиск
-
Равномерную сетку
-
Geohash
-
Quadtree
-
Google S2
Geohash, quadtree и S2 широко используются разными технологическими компаниями. В качестве основного примера мы выбрали geohash, чтобы показать, как работает geospatial index.
В deep dive мы обсудили, почему caching помогает снижать latency, что именно нужно кэшировать и как использовать cache для быстрого получения nearby-бизнесов. Также мы рассмотрели, как масштабировать базу данных с помощью replication и sharding.
Затем мы посмотрели, как разворачивать LBS в разных регионах и availability zones, чтобы повысить availability, приблизить пользователей к серверам и лучше соответствовать локальным privacy laws.
Поздравляю, вы дошли до конца этой главы. Можно похлопать себе по плечу — отличная работа!
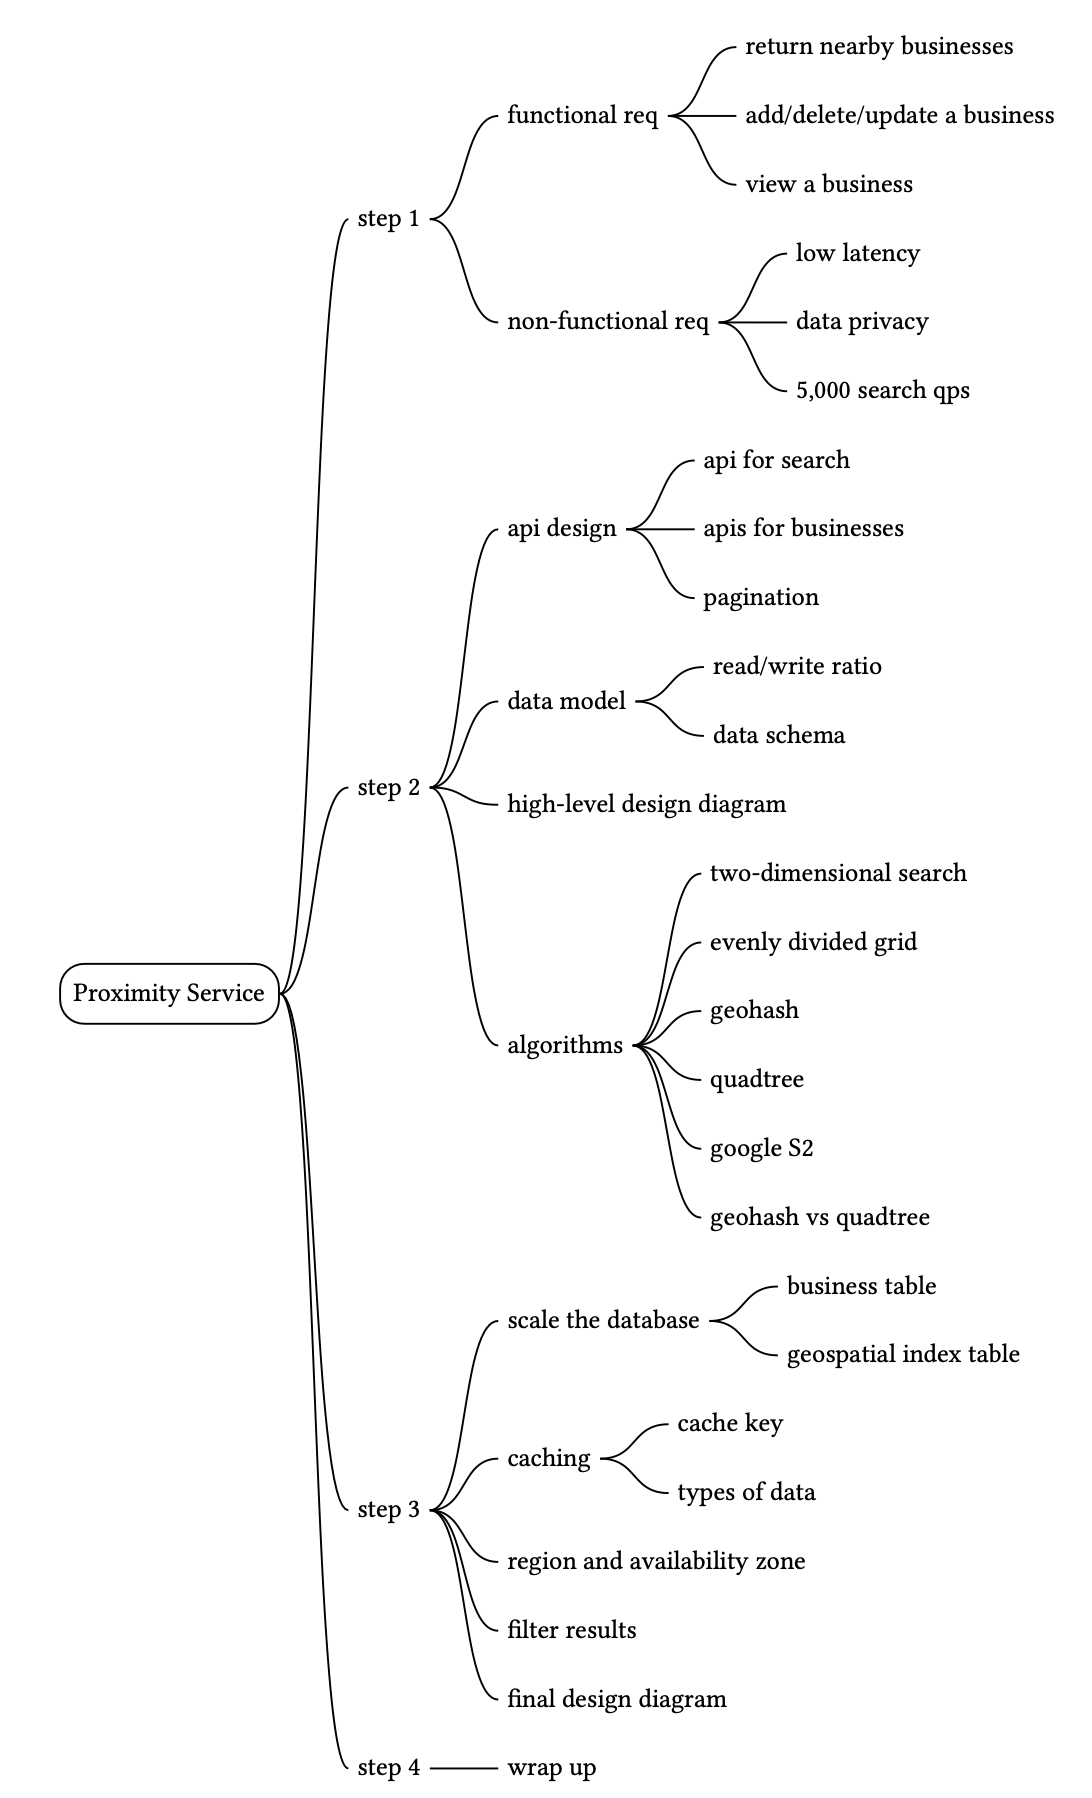
Краткое содержание главы
Справочные материалы
[1] Yelp: https://www.yelp.com/
[2] Map tiles by Stamen Design:
http://maps.stamen.com/
[3] OpenStreetMap: https://www.openstreetmap.org
[4] GDPR: https://en.wikipedia.org/wiki/General_Data_Protection_Regulation
[5] CCPA: https://en.wikipedia.org/wiki/California_Consumer_Privacy_Act
[6] Pagination in the REST API:
https://developer.atlassian.com/server/confluence/pagination-in-the-rest-api/
[7] Google places API: https://developers.google.com/maps/documentation/places/web-service/search
[8] Yelp reservation API:
https://docs.developer.yelp.com/docs/reservation
[9] Regions and Zones:
https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/using-regions-availability-zones.html
[10] Redis GEOHASH: https://redis.io/commands/GEOHASH
[11] POSTGIS: https://postgis.net/
[12] Cartesian tiers: http://www.nsshutdown.com/projects/lucene/whitepaper/locallucene_v2.html
[13] R-tree: https://en.wikipedia.org/wiki/R-tree
[14] Global map in a Geographic Coordinate Reference System:
https://bit.ly/3DsjAwg
[15] Base32: https://en.wikipedia.org/wiki/Base32
[16] Geohash grid aggregation: https://bit.ly/3kKl4e6
[17] Geohash: https://www.movable-type.co.uk/scripts/geohash.html
[18] Quadtree: https://en.wikipedia.org/wiki/Quadtree
[19] How many leaves has a quadtree:
https://stackoverflow.com/questions/35976444/how-many-leaves-has-a-quadtree
[20] Blue green deployment: https://martinfowler.com/bliki/BlueGreenDeployment.html
[21] Yext: Maps and Location Support:
https://www.yext.com/platform/features/maps-and-location-support
[22] S2: http://s2geometry.io/
[23] Hilbert curve: https://en.wikipedia.org/wiki/Hilbert_curve
[24] Hilbert mapping: http://bit-player.org/extras/hilbert/hilbert-mapping.html
[25] Geo-fence: https://en.wikipedia.org/wiki/Geo-fence
[26] Region cover: http://s2geometry.io/devguide/s2cell_hierarchy
[27] Bing map: https://bit.ly/30ytSfG
[28] MongoDB: https://docs.mongodb.com/manual/tutorial/build-a-2d-index/
[29] Geospatial Indexing: The 10 Million QPS Redis Architecture Powering Lyft:
https://www.youtube.com/watch?v=cSFWlF96Sds&t=2155s
[30] Geo Shape Type:
https://www.elastic.co/guide/en/elasticsearch/reference/1.6/mapping-geo-shape-type.html
[31] Geosharded Recommendations Part 1: Sharding Approach:
https://medium.com/tinder-engineering/geosharded-recommendations-part-1-sharding-approach-d5d54e0ec77a
[32] Get the last known location:
https://developer.android.com/training/location/retrieve-current#Challenges