Ограничитель скорости запросов (триттлинг)
В сетевой системе ограничитель скорости запросов (rate limiter) используется для контроля скорости трафика, отправляемого клиентом или сервисом. В мире HTTP rate limiter ограничивает количество клиентских запросов, которые можно отправить за определенный период времени. Если число API-запросов превышает порог, заданный rate limiter, все лишние вызовы блокируются. Вот несколько примеров:
-
Пользователь может публиковать не более 2 постов в секунду.
-
С одного IP-адреса можно создавать максимум 10 аккаунтов в день.
-
С одного устройства можно получать награды не более 5 раз в неделю.
В этой главе нам нужно спроектировать rate limiter. Но прежде чем переходить к дизайну, сначала посмотрим, какие преимущества дает API rate limiter:
-
Предотвращение истощения ресурсов из-за атак типа Denial of Service (DoS) [1]. Почти все API, публикуемые крупными технологическими компаниями, используют ту или иную форму rate limiting. Например, Twitter ограничивает число твитов до 300 за 3 часа [2]. API Google Docs по умолчанию имеют следующее ограничение: 300 запросов на пользователя за 60 секунд для операций чтения [3]. Rate limiter предотвращает DoS-атаки, как намеренные, так и случайные, блокируя лишние вызовы.
-
Снижение затрат. Ограничение лишних запросов означает меньшее число серверов и возможность выделить больше ресурсов более приоритетным API. Rate limiting крайне важен для компаний, использующих платные сторонние API. Например, следующие внешние API тарифицируются за каждый вызов: проверка кредитоспособности, проведение платежа, получение медицинских записей и т. д. Поэтому ограничение количества вызовов критично для снижения расходов.
-
Предотвращение перегрузки серверов. Чтобы уменьшить нагрузку на серверы, rate limiter отфильтровывает лишние запросы, вызванные ботами или некорректным поведением пользователей.
Шаг 1 — Понять задачу и определить рамки дизайна
Rate limiting можно реализовать разными алгоритмами, у каждого из которых есть свои плюсы и минусы. Взаимодействие между интервьюером и кандидатом помогает уточнить, какой именно тип rate limiter мы пытаемся построить.
Кандидат: Какой именно rate limiter мы проектируем? Это клиентский rate limiter или серверный
API rate limiter?
Интервьюер: Отличный вопрос. Мы фокусируемся на серверном API rate limiter.
Кандидат: Ограничитель будет дросселировать API-запросы по IP-адресу, user ID или по другим
свойствам?
Интервьюер: Rate limiter должен быть достаточно гибким, чтобы поддерживать разные наборы
правил ограничения.
Кандидат: Каков масштаб системы? Она строится для стартапа или для крупной компании с большой
пользовательской базой?
Интервьюер: Система должна уметь обрабатывать большое число запросов.
Кандидат: Система будет работать в распределенной среде?
Интервьюер: Да.
Кандидат: Rate limiter — это отдельный сервис, или он должен быть реализован в коде
приложения?
Интервьюер: Это решение по дизайну остается за вами.
Кандидат: Нужно ли информировать пользователей, чьи запросы ограничиваются?
Интервьюер: Да.
Требования
Ниже приведено краткое резюме требований к системе:
-
Точно ограничивать избыточные запросы.
-
Низкая задержка. Rate limiter не должен замедлять время HTTP-ответа.
-
Использовать как можно меньше памяти.
-
Распределенное ограничение скорости. Один и тот же rate limiter может использоваться несколькими серверами или процессами.
-
Обработка исключений. Пользователи должны видеть понятные сообщения об ошибках, когда их запросы ограничиваются.
-
Высокая отказоустойчивость. Если с rate limiter возникают проблемы, например, кэш-сервер уходит в офлайн, это не должно влиять на всю систему целиком.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
Для простоты будем использовать базовую модель клиента и сервера.
Где размещать rate limiter?
Интуитивно rate limiter можно реализовать либо на стороне клиента, либо на стороне сервера.
-
Реализация на стороне клиента. Вообще говоря, клиент — ненадежное место для реализации rate limiting, потому что клиентские запросы могут быть легко подделаны злоумышленниками. Кроме того, у нас может не быть контроля над реализацией клиента.
-
Реализация на стороне сервера. На рисунке 1 показан rate limiter, размещенный на стороне сервера.
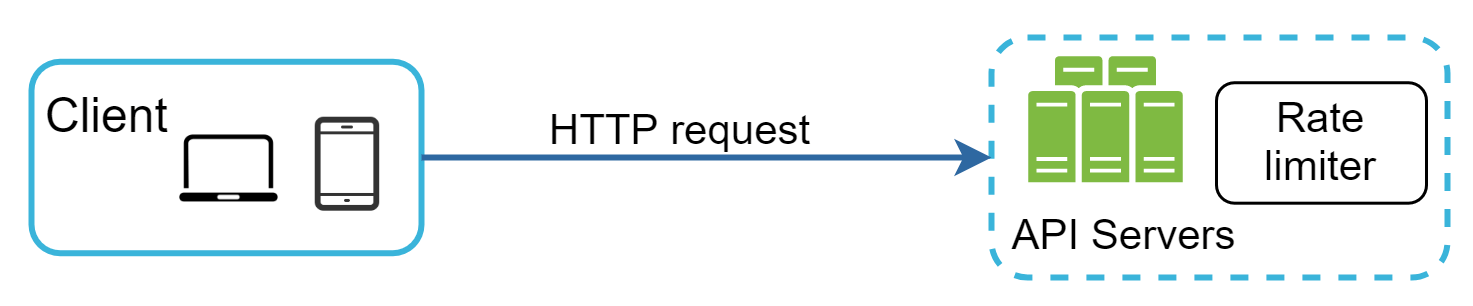
Рисунок 1
Помимо клиентской и серверной реализации существует и альтернативный вариант. Вместо того чтобы размещать rate limiter прямо на API-серверах, можно создать middleware для rate limiting, которое будет ограничивать запросы к вашим API, как показано на рисунке 2.
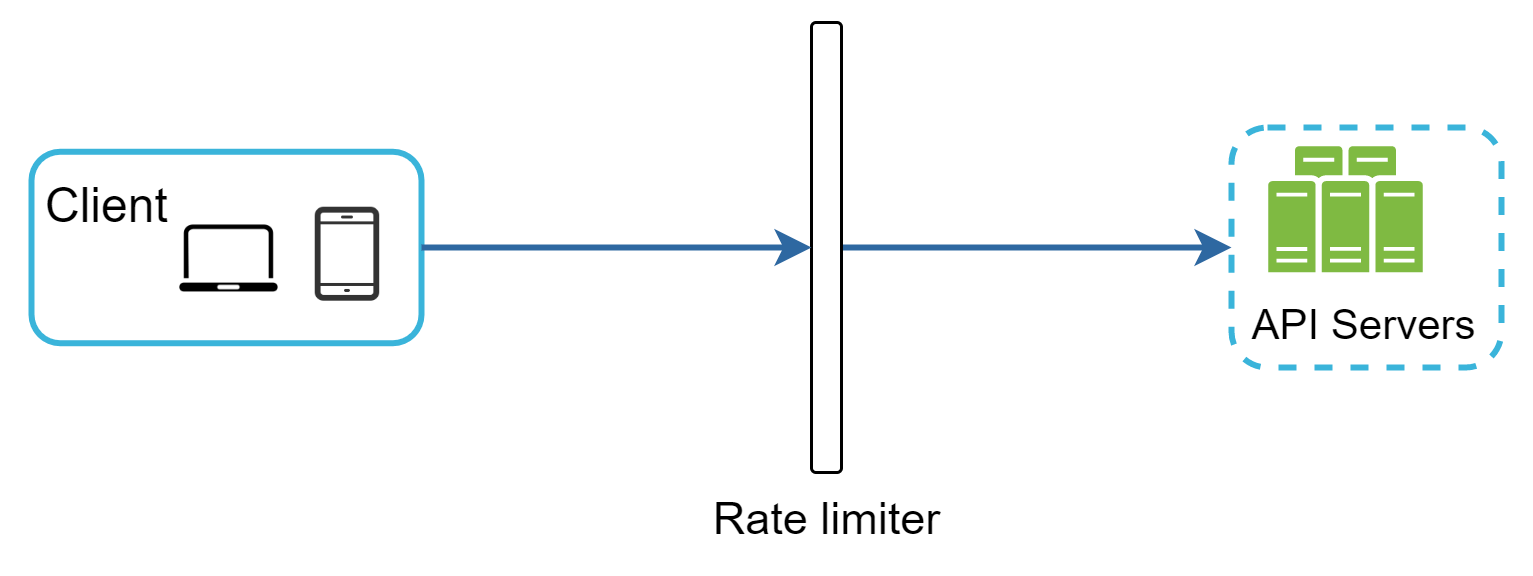
Рисунок 2
Давайте используем пример с рисунка 3, чтобы показать, как в этом дизайне работает rate limiting. Предположим, наше API разрешает 2 запроса в секунду, а клиент отправляет на сервер 3 запроса за одну секунду. Первые два запроса доходят до API-серверов. Однако middleware rate limiter ограничивает третий запрос и возвращает HTTP-статус 429. Код ответа HTTP 429 означает, что пользователь отправил слишком много запросов.
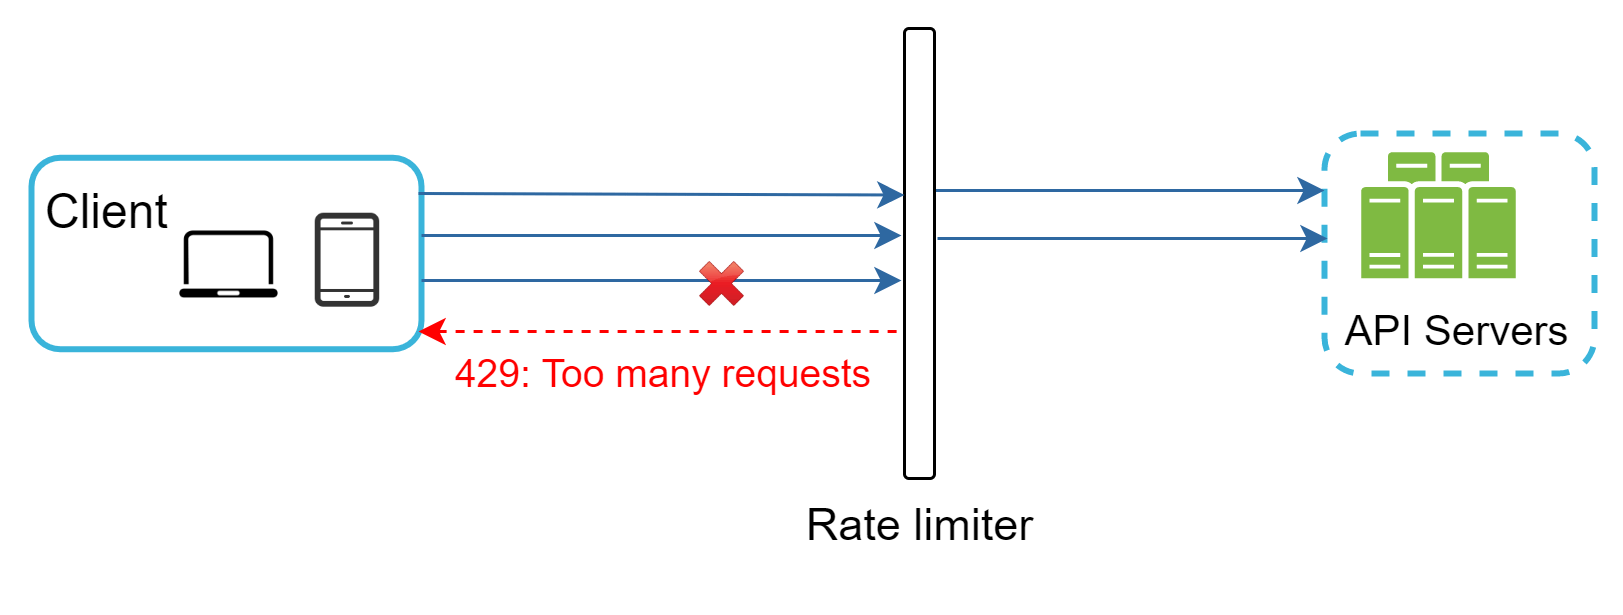
Рисунок 3
Облачные микросервисы [4] стали очень популярными, и rate limiting обычно реализуется в компоненте, который называется API gateway. API gateway — это полностью управляемый сервис, поддерживающий rate limiting, SSL termination, аутентификацию, белые списки IP, обслуживание статического контента и т. д. Пока нам достаточно понимать, что API gateway — это middleware, поддерживающее rate limiting.
При проектировании rate limiter важно задать себе вопрос: где он должен быть реализован — на стороне сервера или в API gateway? Абсолютно правильного ответа нет. Это зависит от текущего технологического стека компании, инженерных ресурсов, приоритетов, целей и т. д. Вот несколько общих рекомендаций:
-
Оцените ваш текущий технологический стек: язык программирования, сервис кэширования и т. д. Убедитесь, что выбранный язык достаточно эффективен для реализации rate limiting на стороне сервера.
-
Определите алгоритм rate limiting, который соответствует потребностям бизнеса. Если вы реализуете все на стороне сервера, у вас есть полный контроль над алгоритмом. Однако если вы используете сторонний API gateway, ваш выбор может быть ограничен.
-
Если у вас уже используется микросервисная архитектура и в дизайне уже есть API gateway для аутентификации, белых списков IP и т. д., можно добавить rate limiter прямо в API gateway.
-
Создание собственного сервиса rate limiting требует времени. Если у вас недостаточно инженерных ресурсов для реализации rate limiter, коммерческий API gateway — лучший вариант.
Алгоритмы rate limiting
Rate limiting можно реализовать разными алгоритмами, и у каждого из них свои плюсы и минусы. Хотя эта глава не сосредоточена исключительно на алгоритмах, понимание их на высоком уровне помогает выбрать правильный алгоритм или комбинацию алгоритмов под наши сценарии использования. Вот список популярных алгоритмов:
-
Token bucket
-
Leaking bucket
-
Fixed window counter
-
Sliding window log
-
Sliding window counter
Алгоритм token bucket
Алгоритм token bucket широко используется для rate limiting. Он простой, хорошо изученный и часто применяется интернет-компаниями. И Amazon [5], и Stripe [6] используют этот алгоритм для ограничения своих API-запросов.
Алгоритм token bucket работает следующим образом:
- Token bucket — это контейнер с заранее определенной емкостью. Ведро периодически пополняется токенами с заданной скоростью. Как только bucket заполняется, новые токены перестают добавляться. На рисунке 4 емкость token bucket равна 4. Пополняющий процесс добавляет в bucket 2 токена каждую секунду. Как только bucket заполнен, лишние токены переливаются через край.

Рисунок 4
-
Каждый запрос расходует один токен. Когда приходит запрос, мы проверяем, достаточно ли токенов в bucket. На рисунке 5 показано, как это работает.
-
Если токенов достаточно, мы забираем по одному токену на каждый запрос, и запрос проходит.
-
Если токенов недостаточно, запрос отбрасывается.

Рисунок 5
На рисунке 6 показано, как работают логика расходования токенов, пополнения и ограничения запросов. В этом примере размер token bucket равен 4, а скорость пополнения — 4 токена в минуту.

Рисунок 6
Алгоритм token bucket принимает два параметра:
-
Размер bucket: максимальное число токенов, разрешенное в bucket
-
Скорость пополнения: количество токенов, добавляемых в bucket каждую секунду
Сколько buckets нам нужно? Это зависит от правил rate limiting. Вот несколько примеров.
-
Обычно требуется иметь разные buckets для разных конечных точек API. Например, если пользователю разрешено делать 1 пост в секунду, добавлять 150 друзей в день и ставить 5 лайков в секунду, то для каждого пользователя нужны 3 отдельных bucket.
-
Если нам нужно ограничивать запросы по IP-адресам, каждому IP-адресу потребуется свой bucket.
-
Если система разрешает максимум 10 000 запросов в секунду, имеет смысл иметь один глобальный bucket, общий для всех запросов.
Плюсы:
-
Алгоритм легко реализовать.
-
Он эффективно использует память.
-
Token bucket допускает кратковременные всплески трафика. Запрос может пройти, пока в bucket остаются токены.
Минусы:
- У алгоритма есть два параметра: размер bucket и скорость пополнения токенов. Однако корректно подобрать их значения бывает непросто.
Алгоритм leaking bucket
Алгоритм leaking bucket похож на token bucket, за исключением того, что запросы обрабатываются с фиксированной скоростью. Обычно он реализуется с помощью очереди first-in-first-out (FIFO). Алгоритм работает следующим образом:
-
Когда приходит запрос, система проверяет, заполнена ли очередь. Если очередь не заполнена, запрос добавляется в нее.
-
Иначе запрос отбрасывается.
-
Запросы извлекаются из очереди и обрабатываются через равные промежутки времени.
На рисунке 7 показано, как работает алгоритм.

Рисунок 7
Алгоритм leaking bucket принимает следующие два параметра:
-
Размер bucket: он равен размеру очереди. Очередь хранит запросы, которые должны обрабатываться с фиксированной скоростью.
-
Скорость вытекания: определяет, сколько запросов может обрабатываться с фиксированной скоростью, обычно в секунду.
Компания Shopify, работающая в сфере электронной коммерции, использует leaky buckets для rate limiting [7].
Плюсы:
-
Эффективно использует память благодаря ограниченному размеру очереди.
-
Запросы обрабатываются с фиксированной скоростью, поэтому алгоритм подходит для сценариев, где нужен стабильный выходной поток.
Минусы:
-
Всплеск трафика заполняет очередь старыми запросами, и если их не обработать вовремя, более свежие запросы будут ограничиваться.
-
У алгоритма есть два параметра, и подобрать их правильно не всегда просто.
Алгоритм fixed window counter
Алгоритм fixed window counter работает следующим образом:
-
Он делит временную шкалу на окна фиксированного размера и назначает отдельный счетчик для каждого окна.
-
Каждый запрос увеличивает счетчик на единицу.
-
Как только счетчик достигает заранее заданного порога, новые запросы отбрасываются до тех пор, пока не начнется новое временное окно.
Рассмотрим конкретный пример. На рисунке 8 единица времени — 1 секунда, и система допускает максимум 3 запроса в секунду. В каждом секундном окне, если приходит больше 3 запросов, лишние запросы отбрасываются, как показано на рисунке 8.

Рисунок 8
Существенная проблема этого алгоритма в том, что всплеск трафика на границах временных окон может пропустить больше запросов, чем разрешено квотой. Рассмотрим следующий случай:

Рисунок 9
На рисунке 9 система допускает максимум 5 запросов в минуту, а доступная квота сбрасывается на удобной для человека круглой минутной отметке. Как видно, между 2:00:00 и 2:01:00 проходит 5 запросов, и еще 5 запросов — между 2:01:00 и 2:02:00. Но в минутном окне от 2:00:30 до 2:01:30 успевают пройти 10 запросов. Это вдвое больше допустимого.
Плюсы:
-
Эффективно использует память.
-
Легко понимается.
-
Сброс доступной квоты в конце временного окна подходит для некоторых сценариев использования.
Минусы:
- Всплеск трафика на границах окна может пропустить больше запросов, чем разрешает квота.
Алгоритм sliding window log
Как мы уже обсуждали, алгоритм fixed window counter имеет серьезную проблему: он позволяет пропускать больше запросов на границах окна. Алгоритм sliding window log решает эту проблему. Он работает так:
-
Алгоритм отслеживает временные метки запросов. Обычно такие метки хранятся в кэше, например, в sorted sets Redis [8].
-
Когда приходит новый запрос, удаляются все устаревшие временные метки. Устаревшими считаются те, которые старше начала текущего временного окна.
-
В лог добавляется временная метка нового запроса.
-
Если размер лога равен или меньше допустимого количества, запрос принимается. Иначе он отклоняется.
Поясним алгоритм на примере, показанном на рисунке 10.

Рисунок 10
В этом примере rate limiter разрешает 2 запроса в минуту. Обычно в лог записываются временные метки Linux. Однако в нашем примере используется удобочитаемое представление времени для большей наглядности.
-
Лог пуст, когда новый запрос приходит в 1:00:01. Поэтому запрос разрешается.
-
Новый запрос приходит в 1:00:30, и временная метка 1:00:30 вставляется в лог. После вставки размер лога равен 2, что не превышает допустимое количество. Поэтому запрос разрешается.
-
Новый запрос приходит в 1:00:50, и временная метка вставляется в лог. После вставки размер лога становится равным 3, что больше допустимого размера 2. Поэтому этот запрос отклоняется, хотя временная метка все равно остается в логе.
-
Новый запрос приходит в 1:01:40. Запросы в диапазоне [1:00:40,1:01:40) попадают в последнее временное окно, а запросы, отправленные до 1:00:40, считаются устаревшими. Две устаревшие метки, 1:00:01 и 1:00:30, удаляются из лога. После удаления размер лога становится равен 2, поэтому запрос принимается.
Плюсы:
- Ограничение, реализованное этим алгоритмом, очень точное. В любом скользящем окне число запросов не превысит лимит.
Минусы:
- Алгоритм потребляет много памяти, потому что даже отклоненные запросы могут оставлять свои временные метки в памяти.
Алгоритм sliding window counter
Алгоритм sliding window counter — это гибридный подход, объединяющий fixed window counter и sliding window log. Его можно реализовать двумя способами. В этом разделе мы разберем один из вариантов реализации, а ссылку на второй подход дадим в конце раздела. На рисунке 11 показано, как работает этот алгоритм.

Рисунок 11
Предположим, что rate limiter допускает максимум 7 запросов в минуту, и в предыдущей минуте было 5 запросов, а в текущей — 3. Для нового запроса, который приходит в точке, соответствующей 30% текущей минуты, число запросов в скользящем окне вычисляется по следующей формуле:
-
Запросы в текущем окне + запросы в предыдущем окне * процент перекрытия между скользящим окном и предыдущим окном
-
По этой формуле получаем
3 + 5 * 0.7 = 6.5запроса. В зависимости от сценария использования результат можно округлять вверх или вниз. В нашем примере он округляется вниз до 6.
Поскольку rate limiter допускает максимум 7 запросов в минуту, текущий запрос может пройти. Однако после еще одного запроса лимит будет достигнут.
Из-за ограничений по месту мы не будем обсуждать здесь другой вариант реализации. Заинтересованным читателям стоит обратиться к материалу [9]. Этот алгоритм неидеален. У него есть плюсы и минусы.
Плюсы
-
Он сглаживает всплески трафика, потому что ограничение рассчитывается на основе среднего темпа в предыдущем окне.
-
Эффективно использует память.
Минусы
- Он работает только для не слишком строгого окна ретроспективного анализа. Это приближенная оценка реального темпа, потому что алгоритм предполагает равномерное распределение запросов в предыдущем окне. Однако на практике проблема может быть не такой серьезной, как кажется. Согласно экспериментам Cloudflare [10], среди 400 миллионов запросов лишь 0.003% были ошибочно разрешены или ограничены.
Высокоуровневая архитектура
Базовая идея алгоритмов rate limiting проста. На высоком уровне нам нужен счетчик, который отслеживает, сколько запросов отправляет один и тот же пользователь, IP-адрес и т. д. Если значение счетчика больше лимита, запрос запрещается.
Где хранить счетчики? Использовать базу данных — плохая идея из-за медленного дискового доступа.
Поэтому выбираем кэш в памяти: он быстрый и поддерживает стратегию истечения по времени.
Например, Redis [11] — популярный вариант для реализации rate limiting. Это хранилище в памяти,
которое предоставляет две команды: INCR и EXPIRE.
-
INCR: увеличивает сохраненный счетчик на 1. -
EXPIRE: задает срок жизни для счетчика. Когда срок истекает, счетчик автоматически удаляется.
На рисунке 12 показана высокоуровневая архитектура rate limiting, которая работает следующим образом:
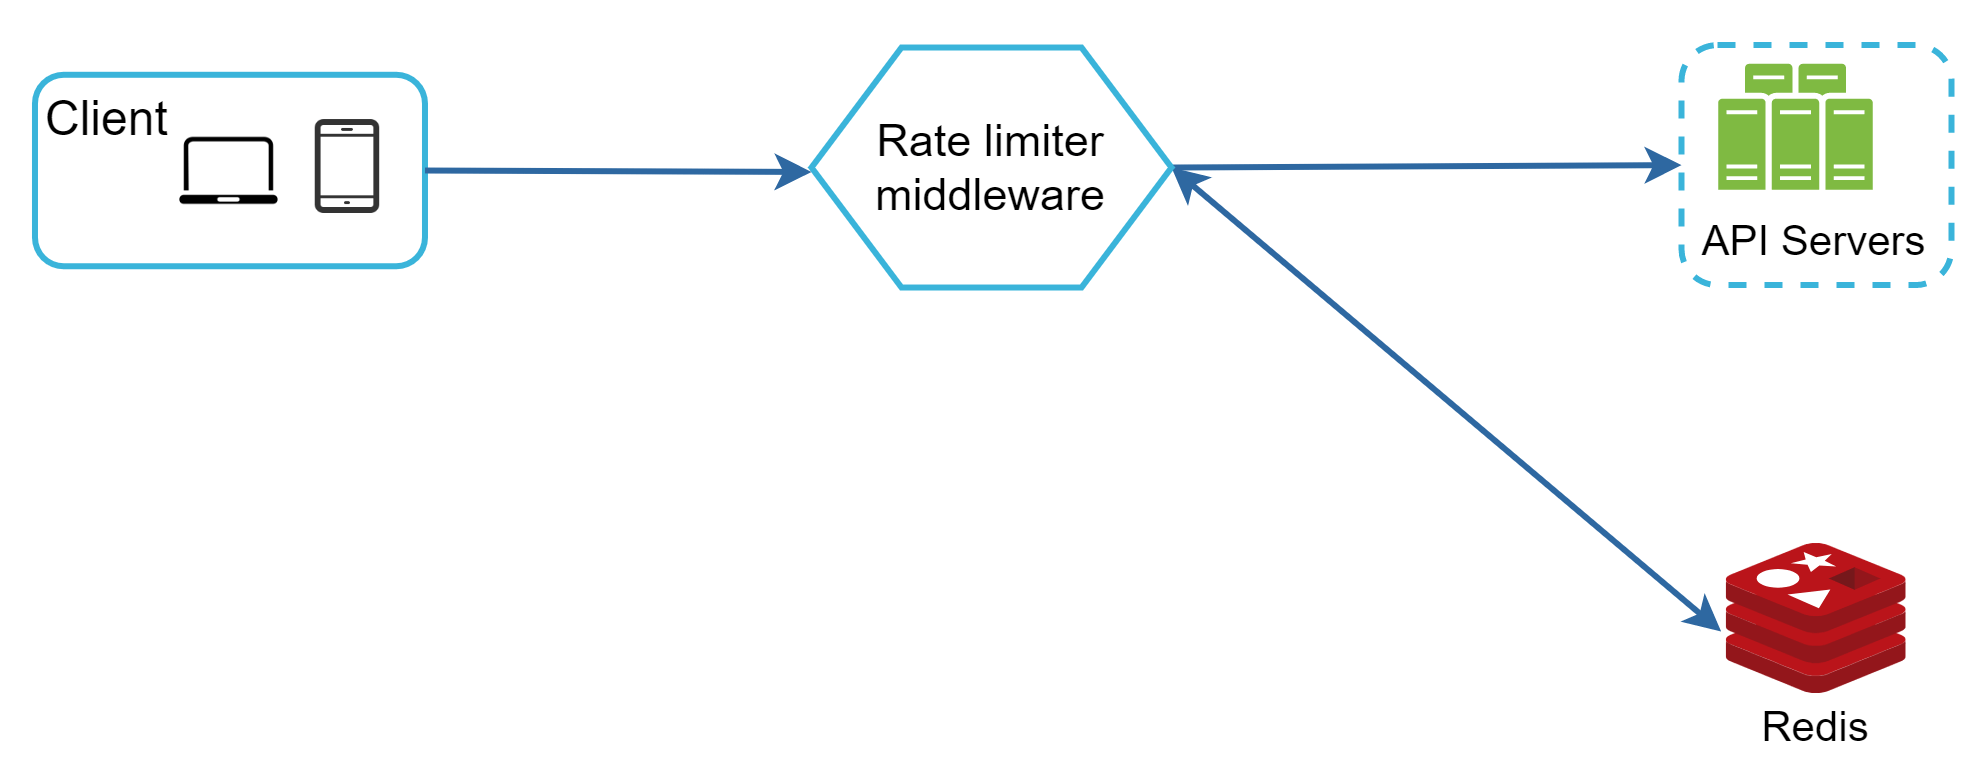
Рисунок 12
-
Клиент отправляет запрос в middleware rate limiting.
-
Middleware rate limiting получает значение счетчика из соответствующего bucket в Redis и проверяет, достигнут лимит или нет.
-
Если лимит достигнут, запрос отклоняется.
-
Если лимит не достигнут, запрос отправляется на API-серверы. Одновременно система увеличивает счетчик и сохраняет его обратно в Redis.
Шаг 3 — Глубокое погружение в дизайн
Высокоуровневый дизайн на рисунке 12 не отвечает на следующие вопросы:
-
Как создаются правила rate limiting? Где они хранятся?
-
Как обрабатывать запросы, которые были ограничены?
В этом разделе мы сначала ответим на вопросы о правилах rate limiting, затем рассмотрим стратегии обработки ограниченных запросов. После этого обсудим rate limiting в распределенной среде, детальный дизайн, оптимизацию производительности и мониторинг.
Правила rate limiting
Lyft открыл исходный код своего компонента для rate limiting [12]. Давайте немного заглянем внутрь и посмотрим на примеры правил:
domain: messaging
descriptors:
  - key: message_type
    value: marketing
    rate_limit:
      unit: day
      requests_per_unit: 5
В приведенном выше примере система настроена так, чтобы разрешать максимум 5 маркетинговых сообщений в день. Вот еще один пример:
domain: auth
descriptors:
  - key: auth_type
    value: login
    rate_limit:
      unit: minute
      requests_per_unit: 5
Это правило показывает, что клиенты не могут логиниться более 5 раз в минуту. Обычно такие правила записываются в конфигурационные файлы и сохраняются на диске.
Превышение лимита
Если запрос ограничивается rate limiter, API возвращает клиенту HTTP-код 429 (too many requests).
В зависимости от сценария использования мы можем помещать ограниченные запросы в очередь для обработки позже.
Например, если часть заказов была ограничена из-за перегрузки системы, мы можем сохранить их для
последующей обработки.
Как клиент узнает, что его запросы ограничиваются? И как клиент понимает, сколько разрешенных запросов у него осталось до начала ограничений? Ответ заключается в HTTP-заголовках ответа. Rate limiter возвращает клиентам следующие HTTP-заголовки:
X-Ratelimit-Remaining: The remaining number of allowed requests within the window.

X-Ratelimit-Limit: It indicates how many calls the client can make per time window.

X-Ratelimit-Retry-After: The number of seconds to wait until you can make a request again without being throttled.
Когда пользователь отправил слишком много запросов, клиенту возвращаются ошибка 429 too many requests и заголовок X-Ratelimit-Retry-After.
Детальный дизайн
На рисунке 13 показан детальный дизайн системы.
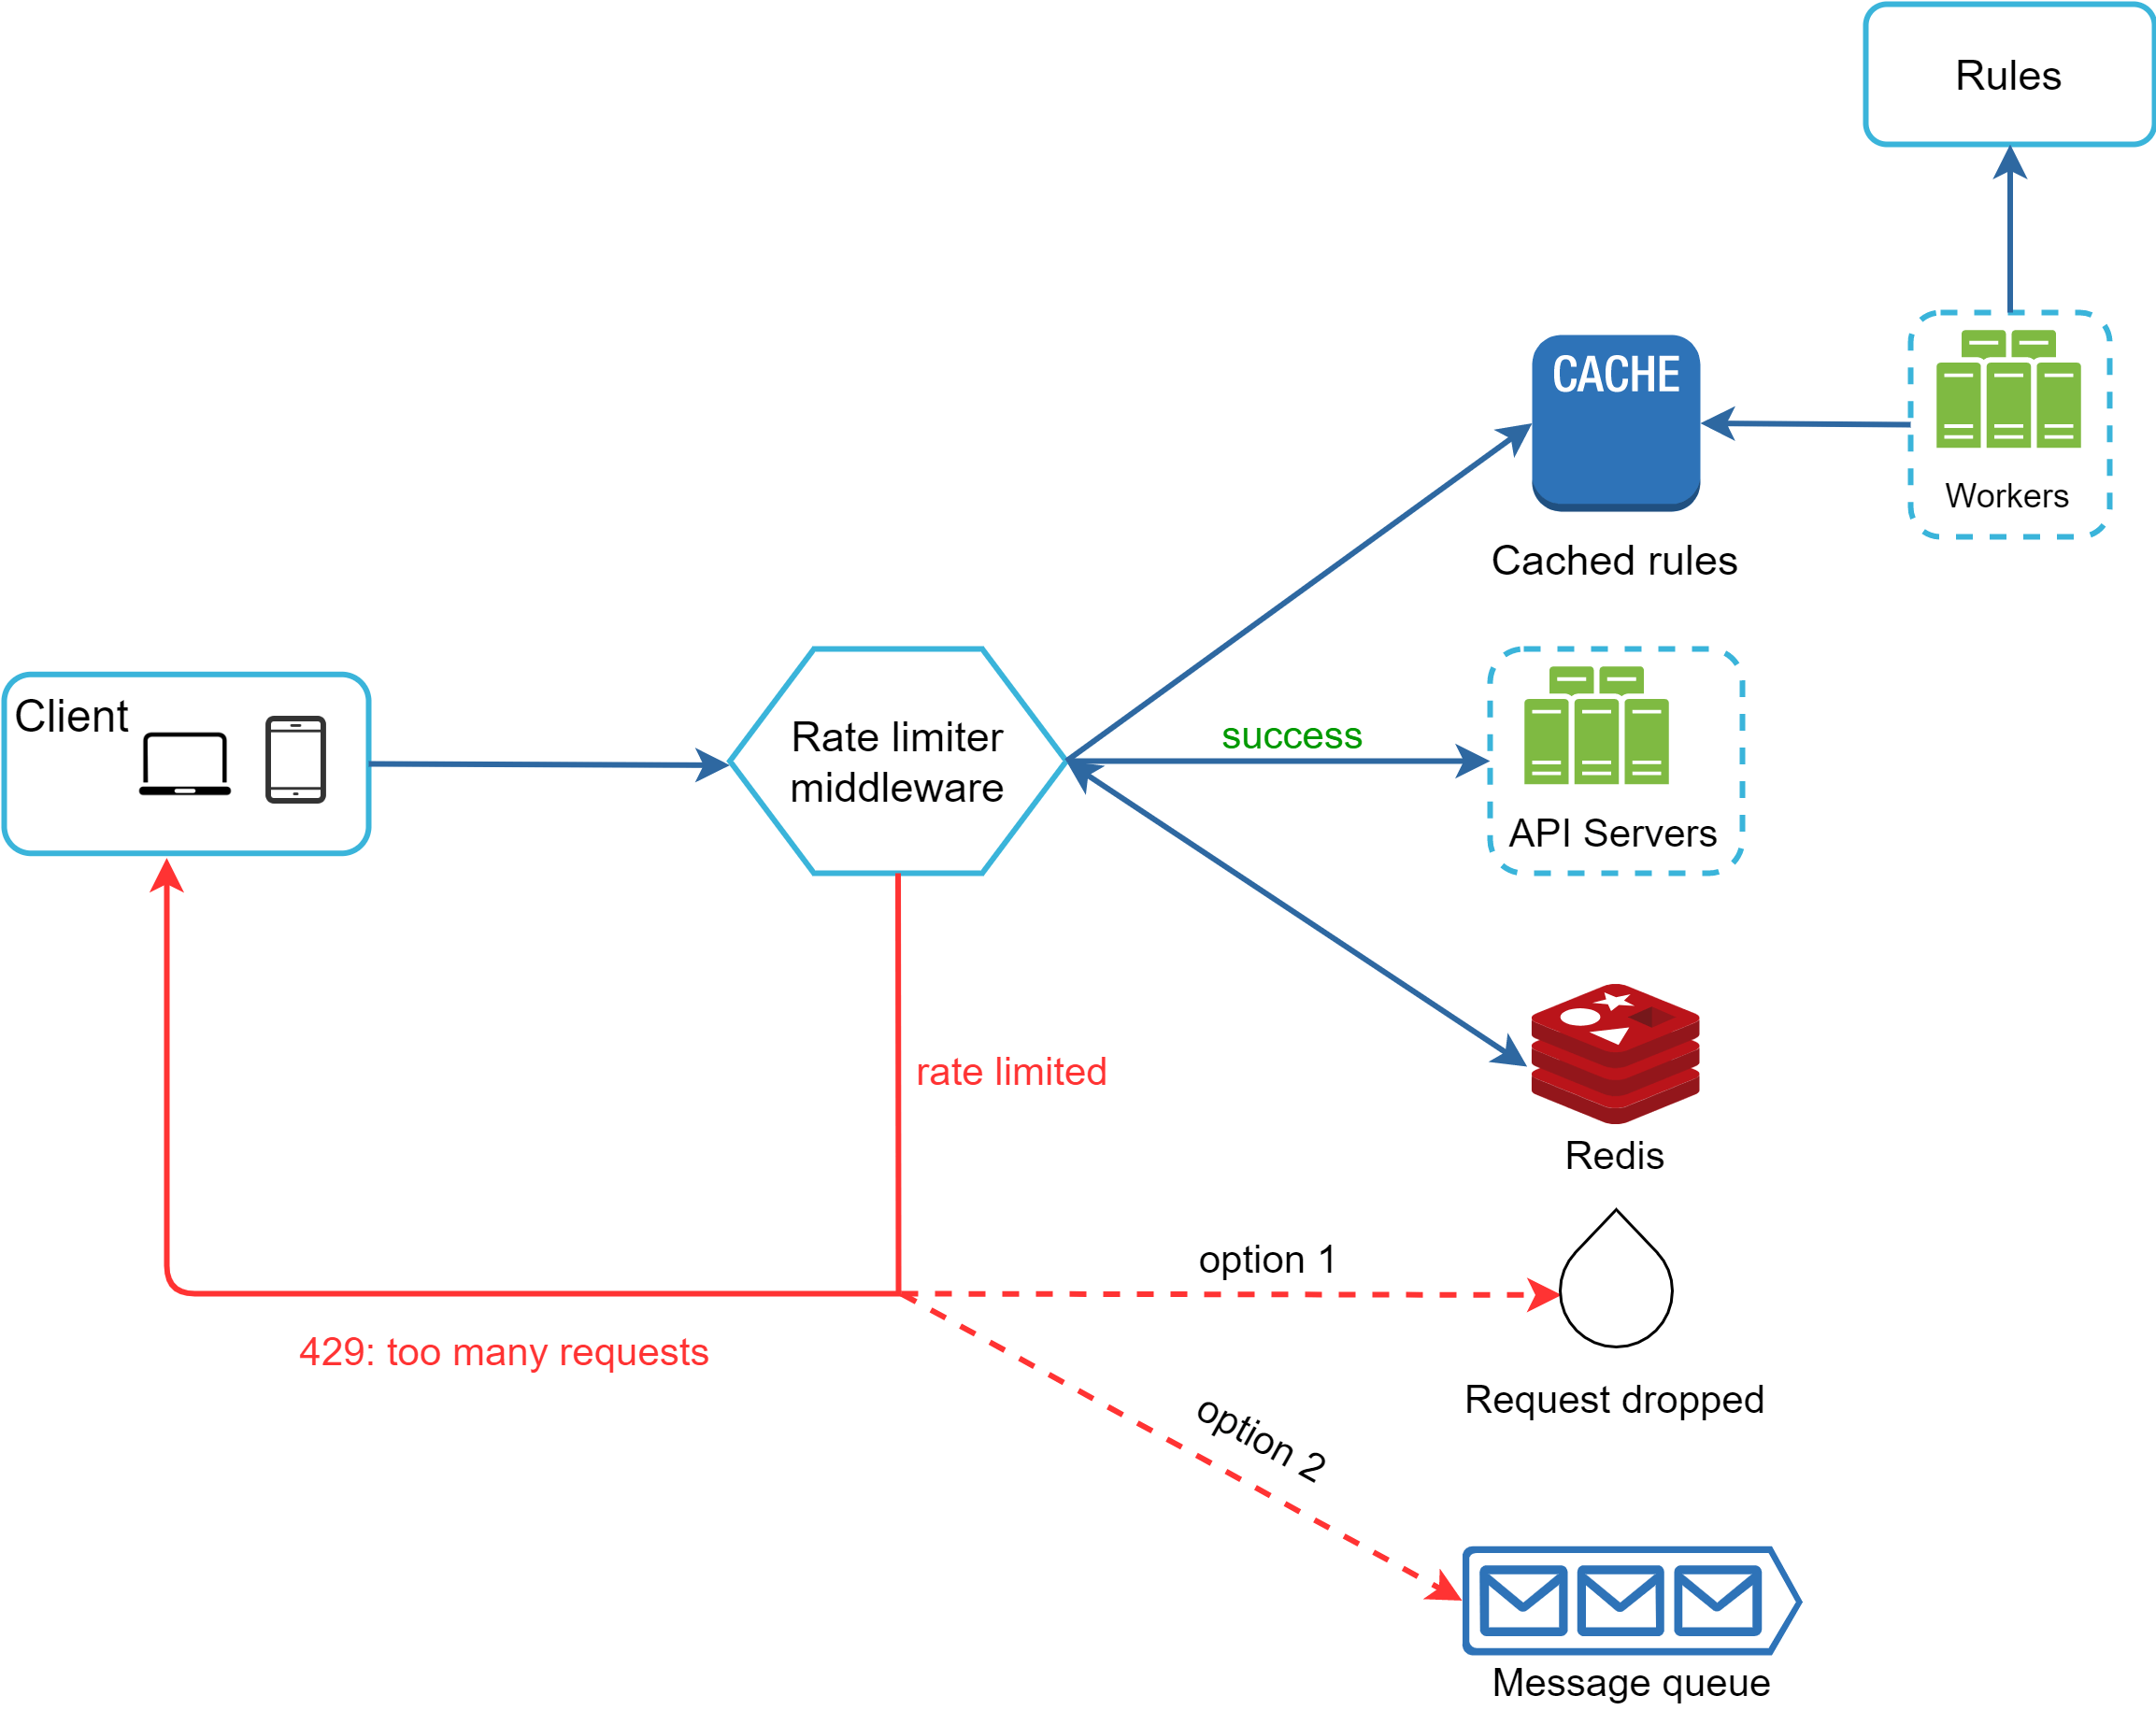
Рисунок 13
-
Правила хранятся на диске. Workers регулярно считывают их с диска и помещают в кэш.
-
Когда клиент отправляет запрос на сервер, запрос сначала попадает в middleware rate limiter.
-
Middleware rate limiter загружает правила из кэша. Также он получает из кэша Redis счетчики и временную метку последнего запроса. На основе ответа rate limiter принимает решение:
-
если запрос не ограничен, он пересылается на API-серверы.
-
если запрос ограничен, rate limiter возвращает клиенту ошибку
429 too many requests. При этом запрос либо отбрасывается, либо отправляется в очередь.
Rate limiter в распределенной среде
Построить rate limiter, работающий на одном сервере, несложно. Однако масштабировать систему так, чтобы она поддерживала несколько серверов и конкурентные потоки, — уже совсем другая задача. Здесь есть две проблемы:
-
Race condition
-
Проблема синхронизации
Race condition
Как обсуждалось ранее, на высоком уровне rate limiter работает так:
-
Считать значение counter из Redis.
-
Проверить, не превышает ли (counter + 1) порог.
-
Если не превышает, увеличить значение counter в Redis на 1.
Race conditions могут возникать в сильно конкурентной среде, как показано на рисунке 14.

Рисунок 14
Предположим, значение counter в Redis равно 3. Если два запроса одновременно прочитают значение counter до того, как кто-либо из них успеет записать новое значение обратно, каждый из них увеличит counter на единицу и запишет результат, не учитывая другой поток. Оба запроса (потока) будут считать, что правильное значение counter равно 4. Однако на самом деле правильное значение должно быть 5.
Самое очевидное решение для race condition — блокировки. Однако блокировки значительно замедляют систему. Поэтому обычно используют две другие стратегии: Lua scripts [13] и структуру данных sorted sets в Redis [8]. Если вам интересны эти стратегии, обратитесь к соответствующим материалам [8] [13].
Проблема синхронизации
Синхронизация — еще один важный фактор в распределенной среде. Чтобы поддерживать миллионы пользователей, одного сервера rate limiting может быть недостаточно. Когда используются несколько серверов rate limiter, требуется синхронизация. Например, в левой части рисунка 15 клиент 1 отправляет запросы в rate limiter 1, а клиент 2 — в rate limiter 2. Поскольку веб-уровень не хранит состояние, клиенты могут начать отправлять запросы в другой rate limiter, как показано в правой части рисунка 15. Если синхронизации нет, rate limiter 1 не содержит данных о клиенте 2. Следовательно, rate limiter не сможет работать корректно.
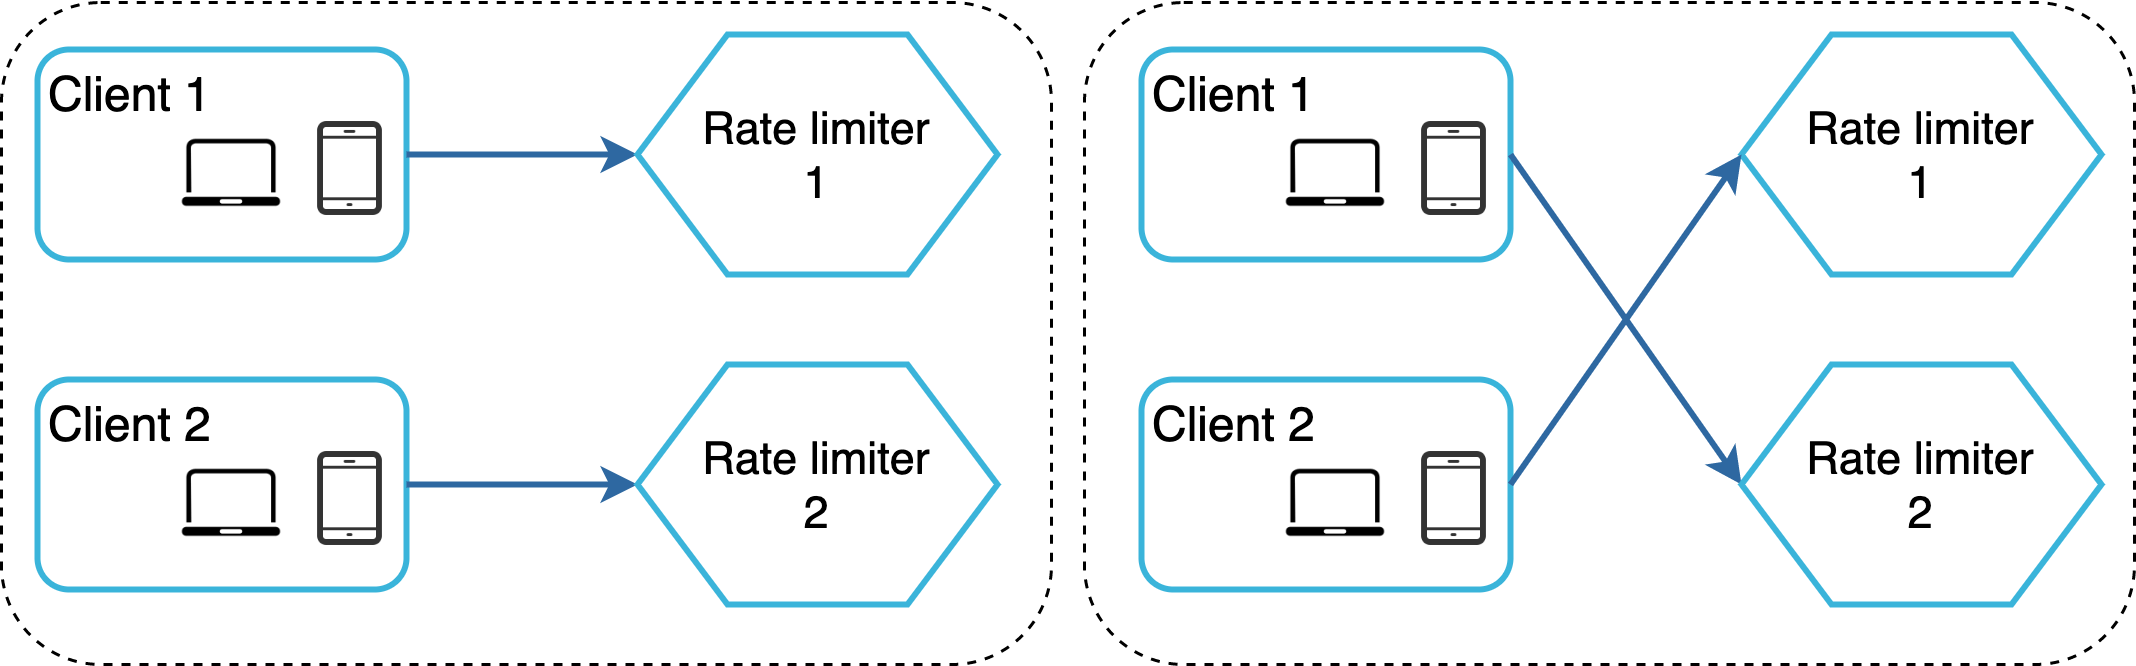
Рисунок 15
Одно из возможных решений — использовать sticky sessions, чтобы клиент всегда отправлял трафик в один и тот же rate limiter. Этот вариант не рекомендуется, поскольку он плохо масштабируется и недостаточно гибок. Более удачный подход — использовать централизованные хранилища данных, такие как Redis. Дизайн показан на рисунке 16.
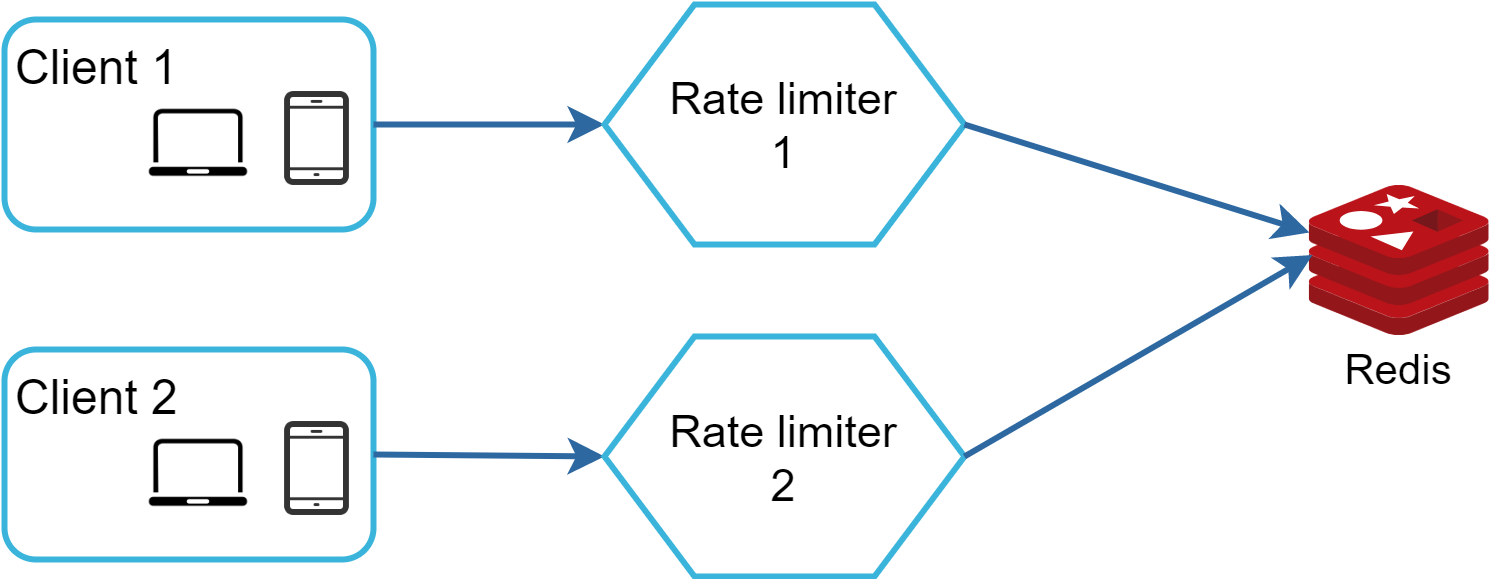
Рисунок 16
Оптимизация производительности
Оптимизация производительности — частая тема на собеседованиях по проектированию систем. Здесь мы рассмотрим два направления улучшения.
Во-первых, конфигурация с несколькими дата-центрами критически важна для rate limiter, потому что для пользователей, находящихся далеко от дата-центра, задержка будет высокой. Большинство облачных провайдеров строят по всему миру множество edge-серверов. Например, по состоянию на 20.05.2020 у Cloudflare было 194 географически распределенных edge-сервера [14]. Трафик автоматически направляется к ближайшему edge-серверу, чтобы уменьшить задержку.
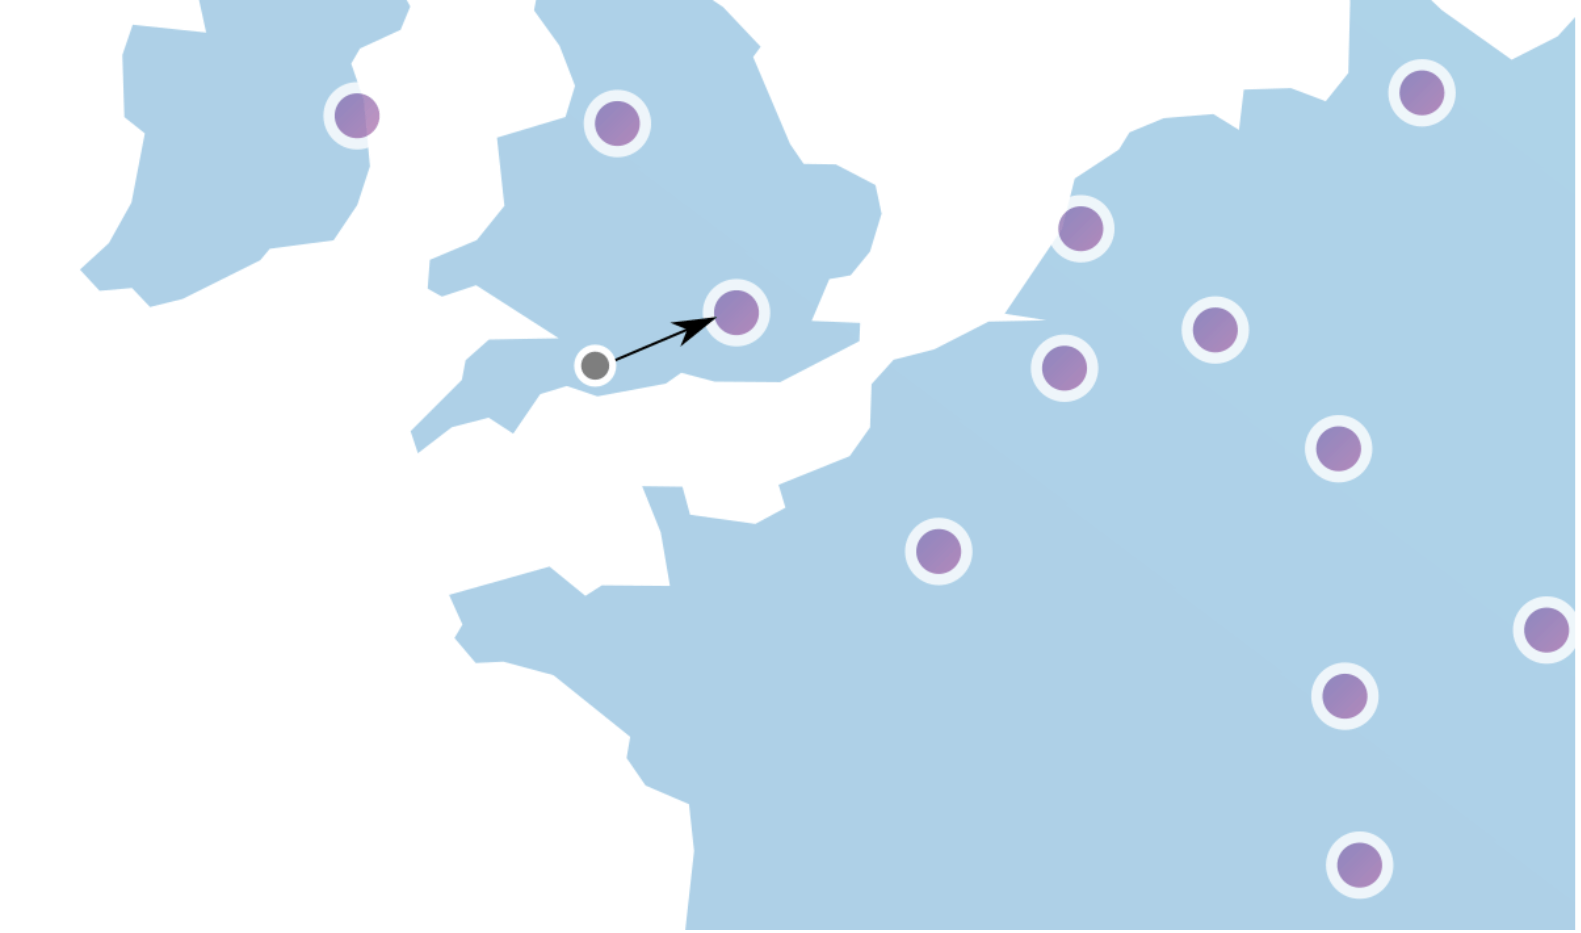
Рисунок 17 (Источник: [10])
Во-вторых, нужно синхронизировать данные с использованием модели eventual consistency. Если вы не до конца понимаете, что такое eventual consistency, обратитесь к разделу “Consistency” в главе “Design a Key-value Store”.
Мониторинг
После того как rate limiter введен в работу, важно собирать аналитические данные, чтобы понимать, насколько он эффективен. Прежде всего мы хотим убедиться в двух вещах:
-
Алгоритм rate limiting действительно эффективен.
-
Правила rate limiting действительно эффективны.
Например, если правила слишком строгие, будет отбрасываться слишком много валидных запросов. В таком случае мы захотим немного ослабить правила. В другом примере мы замечаем, что при резком росте трафика, например во время флеш-распродаж, наш rate limiter становится неэффективным. В такой ситуации можно заменить алгоритм на тот, который лучше поддерживает всплески трафика. Хорошим вариантом здесь является token bucket.
Шаг 4 — Завершение
В этой главе мы обсудили разные алгоритмы rate limiting и их плюсы/минусы. Рассмотренные алгоритмы включали:
-
Token bucket
-
Leaking bucket
-
Fixed window
-
Sliding window log
-
Sliding window counter
Затем мы обсудили архитектуру системы, rate limiter в распределенной среде, оптимизацию производительности и мониторинг. Как и в случае с любыми вопросами по проектированию систем, если остается время, можно упомянуть и дополнительные темы:
-
Жесткое и мягкое ограничение скорости.
-
Жесткое: число запросов не может превышать порог.
-
Мягкое: запросы могут кратковременно превышать порог.
-
Rate limiting на разных уровнях. В этой главе мы говорили только об ограничении на уровне приложения (HTTP: уровень 7). Но rate limiting можно применять и на других уровнях. Например, можно ограничивать запросы по IP-адресам с помощью Iptables [15] (IP: уровень 3). Примечание: модель Open Systems Interconnection (OSI model) имеет 7 уровней [16]: уровень 1 — физический, уровень 2 — канальный, уровень 3 — сетевой, уровень 4 — транспортный, уровень 5 — сеансовый, уровень 6 — представления, уровень 7 — прикладной.
-
Как избежать rate limiting. Проектируйте клиента с учетом лучших практик:
-
Используйте клиентский кэш, чтобы не делать слишком частые вызовы API.
-
Понимайте лимиты и не отправляйте слишком много запросов за короткий промежуток времени.
-
Добавьте код, который перехватывает исключения и ошибки, чтобы клиент мог корректно восстанавливаться после сбоев.
-
Добавьте достаточное время ожидания в логику повторных попыток.
Поздравляем, вы добрались до этого места! Теперь можете похлопать себя по плечу. Отличная работа!
Список литературы
[1] Rate-limiting strategies and techniques:
https://cloud.google.com/solutions/rate-limiting-strategies-techniques
[2] Twitter rate limits: https://developer.twitter.com/en/docs/basics/rate-limits
[3] Google docs usage limits: https://developers.google.com/docs/api/limits
[4] IBM microservices: https://www.ibm.com/cloud/learn/microservices
[5] Throttle API requests for better throughput:
https://docs.aws.amazon.com/apigateway/latest/developerguide/api-gateway-request-throttling.html
[6] Stripe rate limiters: https://stripe.com/blog/rate-limiters
[7] Shopify REST Admin API rate limits:
https://help.shopify.com/en/api/reference/rest-admin-api-rate-limits
[8] Better Rate Limiting With Redis Sorted Sets:
https://engineering.classdojo.com/blog/2015/02/06/rolling-rate-limiter/
[9] System Design — Rate limiter and Data modelling:
https://medium.com/@saisandeepmopuri/system-design-rate-limiter-and-data-modelling-9304b0d18250
[10] How we built rate limiting capable of scaling to millions of domains:
https://blog.cloudflare.com/counting-things-a-lot-of-different-things/
[11] Redis website: https://redis.io/
[12] Lyft rate limiting: https://github.com/lyft/ratelimit
[13] Scaling your API with rate limiters:
https://gist.github.com/ptarjan/e38f45f2dfe601419ca3af937fff574d#request-rate-limiter
[14] What is edge computing:
https://www.cloudflare.com/learning/serverless/glossary/what-is-edge-computing/
[15] Rate Limit Requests with Iptables: https://blog.programster.org/rate-limit-requests-with-iptables
[16] OSI model:
https://en.wikipedia.org/wiki/OSI_model#Layer_architecture