Лист Топов в онлайн игре
В этой главе мы разберем задачу проектирования leaderboard для online mobile game.
Что такое leaderboard? Leaderboards часто встречаются в gaming и не только, чтобы показывать, кто лидирует в конкретном tournament или competition. Users получают points за выполнение задач или challenges, и тот, у кого больше всего points, находится наверху leaderboard. На рисунке 1 показан пример leaderboard в mobile game. Она показывает ranking лидирующих competitors, а также позицию самого user.
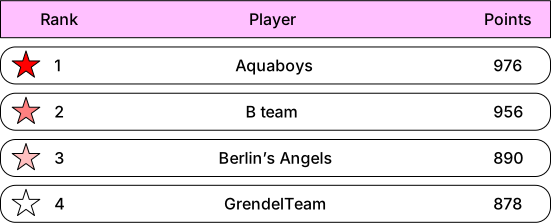
Рисунок 1 Leaderboard
Шаг 1 — Понять задачу и определить рамки дизайна
Leaderboards могут быть довольно простыми, но есть ряд деталей, которые быстро добавляют сложность. Поэтому сначала нужно уточнить requirements.
Кандидат: Как считается score для leaderboard?
Интервьюер: User получает point, когда выигрывает match. Возьмем простую point system: у
каждого user есть score, и каждый выигранный match добавляет 1 point к total score.
Кандидат: Все players входят в leaderboard?
Интервьюер: Да.
Кандидат: Есть ли time segment, связанный с leaderboard?
Интервьюер: Каждый месяц стартует новый tournament, а вместе с ним — новая leaderboard.
Кандидат: Можем ли мы считать, что нас интересуют только top 10 users?
Интервьюер: Мы хотим показывать top 10 users, а также position конкретного user в leaderboard.
Если останется время, давай еще обсудим, как возвращать users, которые на четыре позиции выше и
ниже выбранного user.
Кандидат: Сколько users участвует в tournament?
Интервьюер: В среднем 5 миллионов daily active users (DAU) и 25 миллионов monthly active users
(MAU).
Кандидат: Сколько matches в среднем играется за tournament?
Интервьюер: Каждый player в среднем играет 10 matches в день.
Кандидат: Как определяется rank, если два players имеют одинаковый score?
Интервьюер: В этом случае rank одинаковый. Если будет время, можем обсудить способы
breaking ties.
Кандидат: Должна ли leaderboard быть real-time?
Интервьюер: Да, мы хотим real-time results, или максимально близко к этому. Батчевую историю
результатов показывать нельзя.
Теперь, когда requirements собраны, перечислим functional requirements:
-
Показать top 10 players на leaderboard.
-
Показать конкретный rank user.
-
Показать players, которые находятся на четыре позиции выше и ниже нужного user (bonus).
Кроме functional requirements важно понимать и non-functional requirements.
Нефункциональные требования
-
Real-time update scores.
-
Любое изменение score должно отражаться в leaderboard практически сразу.
-
Общие требования по scalability, availability и reliability.
Back-of-the-envelope estimation
Посчитаем несколько чисел, чтобы оценить potential scale и challenges.
При 5 миллионах DAU, если бы нагрузка была равномерно размазана по 24 часам, мы получили бы
среднее примерно 50 users per second (5,000,000 / 10^5 ≈ 50). Но usage почти наверняка
неравномерный, и возможны peaks вечером в разных time zones. Чтобы это учесть, предположим, что
peak load в 5 раз выше среднего. Тогда нужно закладываться примерно на 250 users per second.
QPS для начисления points: если user играет 10 games per day в среднем, то QPS scoring будет
50 * 10 = ~500. Peak QPS в 5 раз выше среднего: 500 * 5 = 2,500.
QPS для fetching top 10 leaderboard: предположим, user открывает game один раз в день и top 10 leaderboard загружается только при первом открытии. Тогда QPS здесь около 50.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
В этом разделе обсудим API design, high-level architecture и data models.
API design
На high level нам нужны следующие три APIs:
POST /v1/scores
Обновляет позицию user в leaderboard, когда user выигрывает game. Request parameters перечислены ниже. Это должен быть internal API, который вызывается только game servers. Client не должен иметь возможности обновлять leaderboard score напрямую.
| Field | Description |
|---|---|
| user_id | User, который выиграл game |
| points | Число points, которое user получил за победу |
Таблица 1
Response:
| Name | Description |
|---|---|
| 200 OK | User score успешно обновлен |
| 400 Bad Request | Не удалось обновить score |
Таблица 2
GET /v1/scores
Получает top 10 players из leaderboard.
Пример response:
{
  "data": [
    {
      "user_id": "user_id1",
      "user_name": "alice",
      "rank": 1,
      "score": 12543
    },
    {
      "user_id": "user_id2",
      "user_name": "bob",
      "rank": 2,
      "score": 11500
    }
  ],
  "...": "...",
  "total": 10
}
GET /v1/scores/{:user_id}
Получает rank конкретного user.
| Field | Description |
|---|---|
| user_id | ID user, чей rank нужно получить |
Таблица 3
Пример response:
{
  "user_info": {
    "user_id": "user5",
    "score": 1000,
    "rank": 6
  }
}
High-level architecture
High-level design показан на рисунке 2. В этой системе есть два services. Game service дает users возможность играть, а leaderboard service создает и отдает leaderboard.

Рисунок 2 High-level design
-
Когда player выигрывает game, client отправляет request в game service.
-
Game service проверяет, что победа валидна, и вызывает leaderboard service для обновления score.
-
Leaderboard service обновляет score user в leaderboard store.
-
Player делает прямой вызов в leaderboard service, чтобы получить leaderboard data:
a. top 10 leaderboard.
b. rank игрока в leaderboard.
Прежде чем остановиться на этом design, мы рассмотрели несколько альтернатив и отказались от них. Полезно пройти через этот thought process.
Нужно ли client обращаться к leaderboard service напрямую для обновления score?
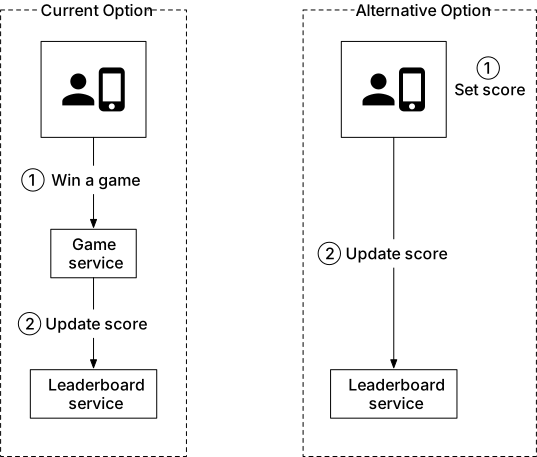
Рисунок 3 Кто выставляет leaderboard score
В alternative design score выставляется client. Этот вариант небезопасен, потому что подвержен man-in-the-middle attack, где игроки могут подставить proxy и менять score как захотят. Поэтому score должен выставляться только server-side.
Заметим, что для server-authoritative games, например online poker, client может вообще не вызывать game server отдельно для выставления scores. Game server сам знает, когда game закончилась, и может выставить score без client intervention.
Нужна ли message queue между game service и leaderboard service?
Ответ сильно зависит от того, как game scores используются дальше. Если те же данные идут и в другие services, message queue, например Kafka, может быть полезна, как на рисунке 4. Тогда одни и те же данные смогут читать leaderboard service, analytics service, push notification service и т. д. Это особенно актуально для turn-based или multi-player games, где нужно уведомлять других players про score update. Но так как это не было явным requirement, в нашем design queue не используем.

Рисунок 4 Game scores используются несколькими services
Data models
Один из ключевых components системы — leaderboard store. Мы обсудим три возможных решения: relational database, Redis и NoSQL (NoSQL рассмотрим в deep dive).
Relational database solution
Для начала сделаем шаг назад и посмотрим на самый простой вариант. Что, если scale не играет роли и users мало?
Скорее всего, мы бы выбрали простой leaderboard на relational database system (RDS). Каждую
monthly leaderboard можно представить как database table с колонками user_id и score. Когда
user выигрывает match, мы либо начисляем 1 point новому user, либо увеличиваем существующий score
на 1. Чтобы определить ranking, сортируем table по score в descending order.
Leaderboard DB table:
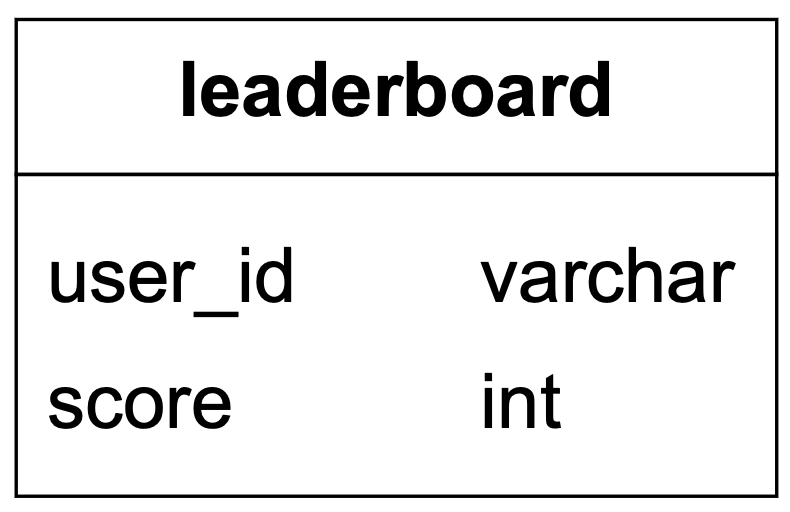
Рисунок 5 Leaderboard table
В реальности там будут и дополнительные поля — game_id, timestamp и т. д. Но логика update и
query остается той же. Для простоты считаем, что в table хранится только leaderboard текущего
месяца.
User получает point:

Рисунок 6 User получает point
Предположим, каждый score update — это increment на 1. Если у user еще нет entry в leaderboard за месяц, первый insert выглядит так:
INSERT INTO leaderboard (user_id, score) VALUES ('mary1934', 1);
Обновление score выглядит так:
UPDATE leaderboard set score=score + 1 where user_id='mary1934';
Найти позицию user в leaderboard:

Рисунок 7 Найти позицию user в leaderboard
Чтобы получить rank user, нужно отсортировать leaderboard table по score:
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
ORDER BY score DESC;
Результат SQL query будет выглядеть так:
| rank | user_id | score |
|---|---|---|
| 1 | happy_tomato | 987 |
| 2 | mallow | 902 |
| 3 | smith | 870 |
| 4 | mary1934 | 850 |
Таблица 4 Result sorted by score
Это работает, пока dataset небольшой, но при миллионах rows query становится очень медленным.
Чтобы узнать rank user, нужно по сути рассортировать всех players в leaderboard и поставить каждого на правильное место. А еще возможны duplicate scores, поэтому rank — это не просто позиция user в списке.
SQL databases плохо справляются с большим объемом continuously changing data. Операция rank по миллионам rows может занимать десятки секунд, а это неприемлемо для real-time approach. Так как data постоянно меняется, cache здесь тоже не слишком спасает.
Relational database не рассчитана на такой read load. RDS мог бы подойти для batch operation, но это не соответствует требованию real-time leaderboard.
Одна optimization — добавить index и ограничить сканируемые pages через LIMIT:
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
ORDER BY score DESC
LIMIT 10
Но и это плохо масштабируется. Во-первых, finding user rank все равно essentially требует table scan. Во-вторых, это не дает прямого решения для rank user, который не в top leaderboard.
Redis solution
Нам нужно решение с predictable performance даже при миллионах users и с простыми leaderboard operations, без сложных DB queries.
Redis дает такой вариант. Redis — это in-memory data store с поддержкой key-value pairs. Так как она работает в memory, и reads, и writes очень быстрые. У Redis есть special data type — sorted sets, которые отлично подходят для leaderboard problems.
Что такое sorted sets?
Sorted set — это data type, похожий на set. У каждого member есть associated score. Members должны быть уникальными, а вот scores могут повторяться. Score используется для rank sorted set в ascending order.
Наш leaderboard use case идеально ложится на sorted sets. Внутри sorted set реализована двумя data
structures: hash table и skip list [1]. Hash table отображает users в scores, а skip list —
scores в users. В sorted sets users отсортированы по scores. Удобно представлять sorted set как
table со столбцами score и member, как на рисунке 8. Визуально таблица показана в descending
order.
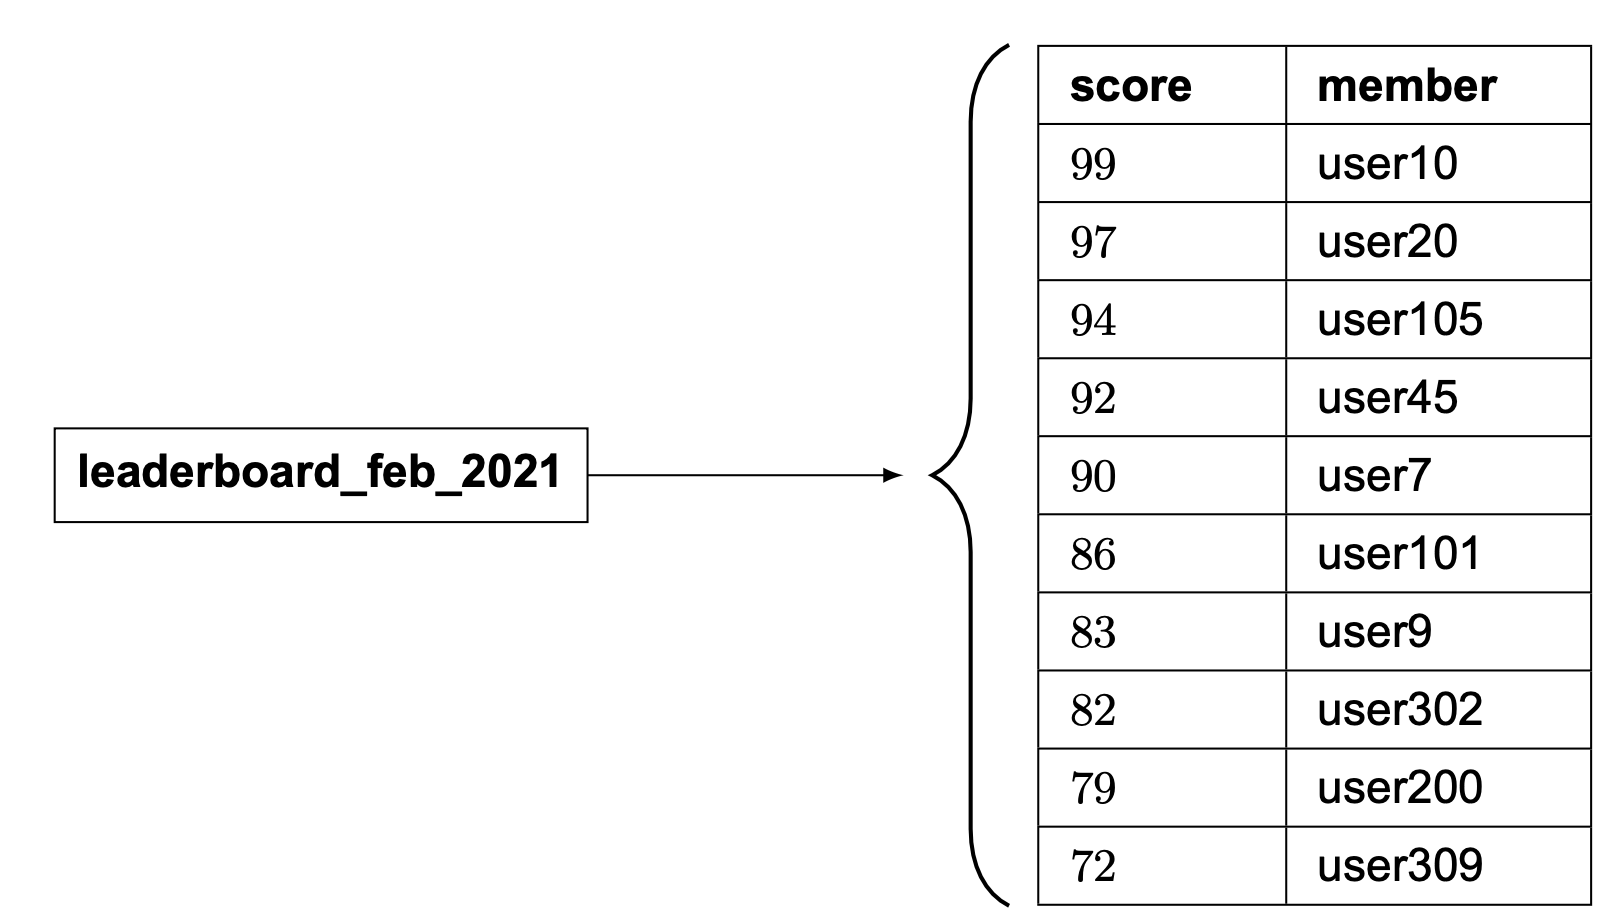
Рисунок 8 February leaderboard представлена как sorted set
Полную реализацию sorted set мы разбирать не будем, но high-level idea важна.
Skip list — это list structure для быстрого search. Она состоит из base sorted linked list и
multi-level indexes. На рисунке 9 base list — это sorted singly-linked list. У insertion, removal
и search там time complexity O(n).
Как ускорить эти operations? Идея та же, что и у binary search: быстро добираться до середины.
Для этого добавляем level 1 index, который пропускает каждый второй node, затем level 2 index,
который пропускает каждый второй node уровня 1, и так далее. Уровни добавляются, пока расстояние
между nodes не станет n/2 - 1, где n — общее число nodes. Как видно на рисунке 9, search for
45 работает заметно быстрее при наличии multi-level indexes.
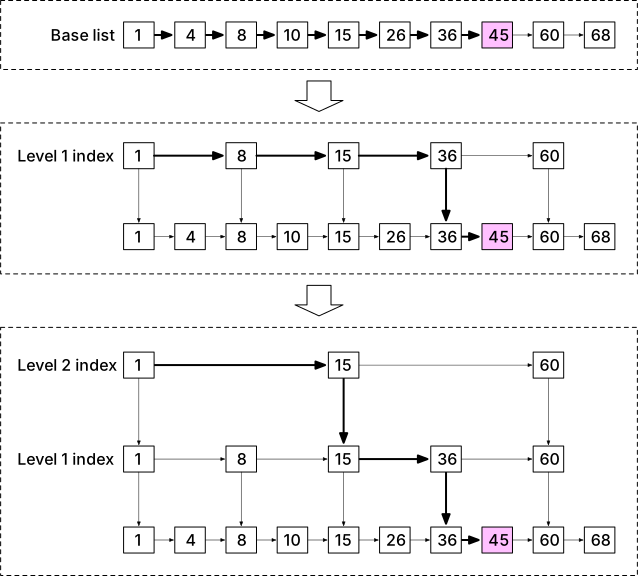
Рисунок 9 Skip list
Когда dataset маленький, выигрыш не так заметен. Но на рисунке 10 пример skip list с 5 levels of indexes: в base linked list нужно пройти 62 nodes, а в skip list — только 11 [2].
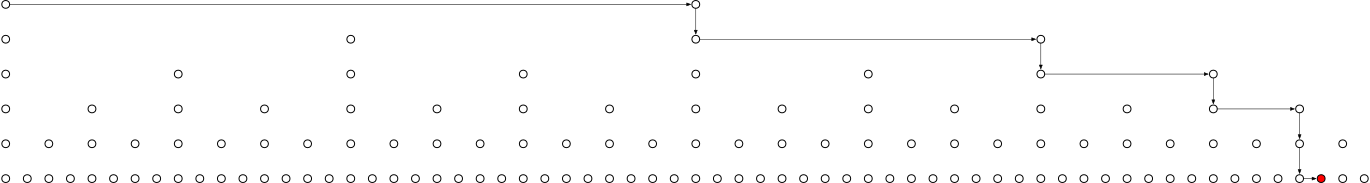
Рисунок 10 Skip list с 5 levels of indexes
Sorted sets производительнее relational database, потому что каждый element при insert/update
сразу встает на правильное место, а complexity add/find operations логарифмическая: O(log n).
Для сравнения, чтобы посчитать rank конкретного user в relational database, пришлось бы запускать nested queries:
SELECT *,(SELECT COUNT(*) FROM leaderboard lb2
WHERE lb2.score >= lb1.score) RANK
FROM leaderboard lb1
WHERE lb1.user_id = {:user_id};
Реализация через Redis sorted sets
Теперь, когда ясно, что sorted sets быстрые, посмотрим на Redis operations, которые нам нужны для leaderboard [3] [4] [5] [6]:
-
ZADD: вставляет user в set, если его еще нет. Иначе обновляет score. Выполняется заO(log n). -
ZINCRBY: увеличивает score user на заданный increment. Если user еще нет в set, считается, что стартовый score равен 0. Выполняется заO(log n). -
ZRANGE/ZREVRANGE: получает range users, отсортированных по score. Можно выбрать порядок, стартовую позицию и число entries. ComplexityO(log(n) + m), гдеm— число entries в ответе, обычно небольшое. -
ZRANK/ZREVRANK: получает position любого user в ascending/descending order за logarithmic time.
Workflow со sorted sets
- User получает point
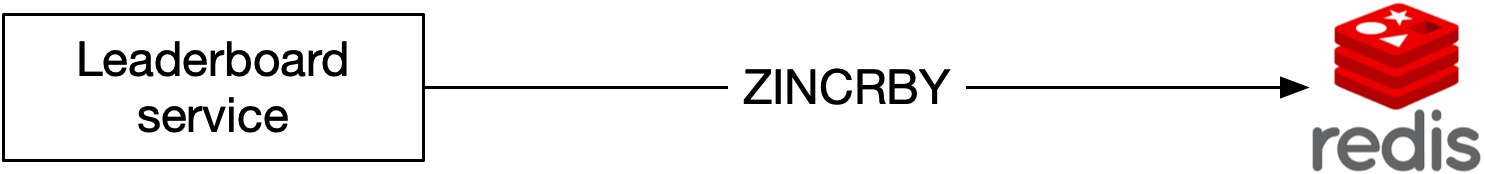
Рисунок 11 User получает point
Каждый месяц мы создаем новый leaderboard sorted set, а предыдущие переносим в historical data
storage. Когда user выигрывает match, он получает 1 point, поэтому мы вызываем ZINCRBY, чтобы
увеличить score user на 1 в leaderboard текущего месяца, либо добавить user в set, если его там
еще не было.
Синтаксис ZINCRBY:
ZINCRBY <key> <increment> <user>
Например, так мы добавим point user mary1934 после победы:
ZINCRBY leaderboard_feb_2021 1 'mary1934'
- User получает top 10 global leaderboard
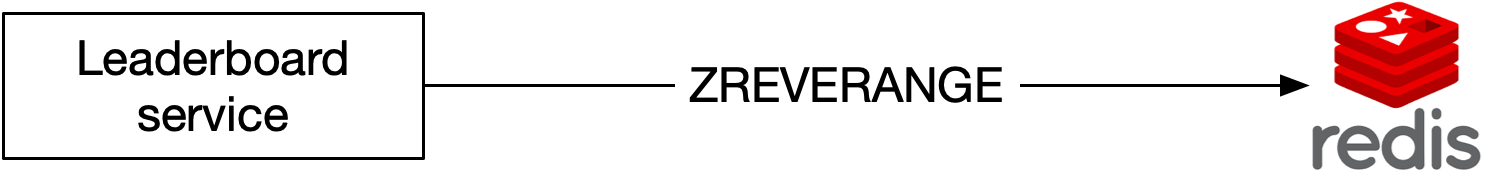
Рисунок 12 Получение top 10 global leaderboard
Мы вызываем ZREVRANGE, потому что хотим highest scores, и добавляем WITHSCORES, чтобы сразу
получить и total score user, и список users с highest scores. Команда для top 10 в
Feb-2021 leaderboard выглядит так:
ZREVRANGE leaderboard_feb_2021 0 9 WITHSCORES
Она вернет список вроде:
[(user2,score2),(user1,score1),(user5,score5)...]
- User хочет узнать свою позицию в leaderboard
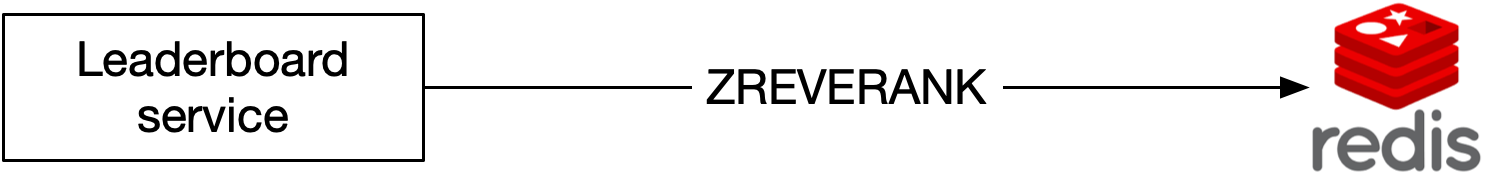
Рисунок 13 Получение позиции user в leaderboard
Чтобы получить position user, вызываем ZREVRANK, потому что ranking нужен от high score к low:
ZREVRANK leaderboard_feb_2021 'mary1934'
- Получение relative position user в leaderboard. Пример показан на рисунке 14.
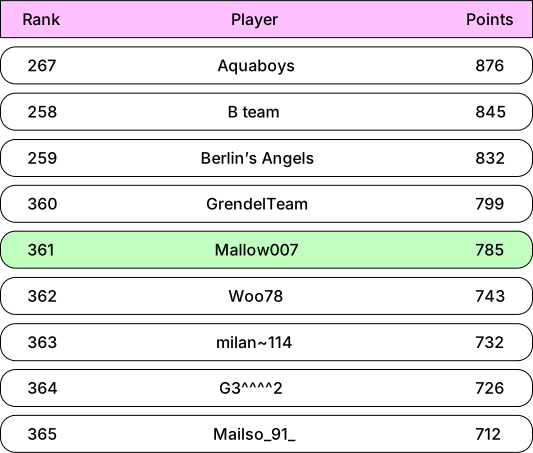
Рисунок 14 Получить 4 players above and below
Хотя это не был обязательный requirement, relative position легко получить через ZREVRANGE,
используя число results above и below нужного player. Например, если rank user Mallow007 равен
361 и мы хотим получить 4 players above и below, можно выполнить:
ZREVRANGE leaderboard_feb_2021 357 365
Storage requirement
Как минимум нам нужно хранить user_id и score. Worst-case scenario — все 25 миллионов MAU
выиграли хотя бы одну game, и у всех есть entry в leaderboard за месяц. Если id — это string из
24 characters, а score — 16-bit integer (2 bytes), то на entry нужно 26 bytes. При одном entry
на каждого MAU понадобится:
26 bytes * 25 million = 650 million bytes, то есть примерно 650 MB leaderboard data в Redis.
Даже если удвоить memory usage, чтобы учесть overhead skip list и hash table sorted set, одного современного Redis server более чем достаточно.
Нужно учитывать еще CPU и I/O. Peak QPS из оценки выше — 2,500 updates/sec. Это тоже comfortably укладывается в performance envelope одного Redis server.
Одна проблема с Redis — persistence, потому что Redis node может fail-иться. К счастью, Redis поддерживает persistence, но restart large Redis instance from disk медленный. Обычно Redis настраивают с read replica: если main instance падает, replica повышается до primary, а новая replica подключается следом.
Кроме того, нам нужны две supporting tables (user и point) в relational database вроде MySQL.
Таблица user хранит user_id и display name user (в реальном приложении там было бы больше
данных). Таблица point хранит user_id, score и timestamp, когда user выиграл game. Это
полезно и для play history, и для восстановления Redis leaderboard после infrastructure failure.
Как небольшая optimization, можно добавить еще один cache для user details, например для top 10 players, так как именно они запрашиваются чаще всего. Объем данных там маленький.
Шаг 3 — Погружение в детали дизайна
Теперь, когда high-level design обсужден, углубимся в следующее:
-
Использовать ли cloud provider
-
Managed собственных services
-
Использование cloud service providers вроде AWS
-
-
Scaling Redis
-
Alternative solution: NoSQL
-
Другие considerations
Использовать cloud provider или нет
В зависимости от существующей infrastructure у нас обычно есть два варианта deploy.
Управлять своими services
В этом подходе мы создаем новый leaderboard sorted set каждый месяц для данных этого периода.
Sorted set хранит member и score. Остальные details user, например name и profile image,
хранятся в MySQL. При fetch leaderboard API servers помимо leaderboard data также получают из DB
user names и profile images. Если это станет inefficient, можно завести user profile cache хотя бы
для top 10 players. Design показан на рисунке 15.
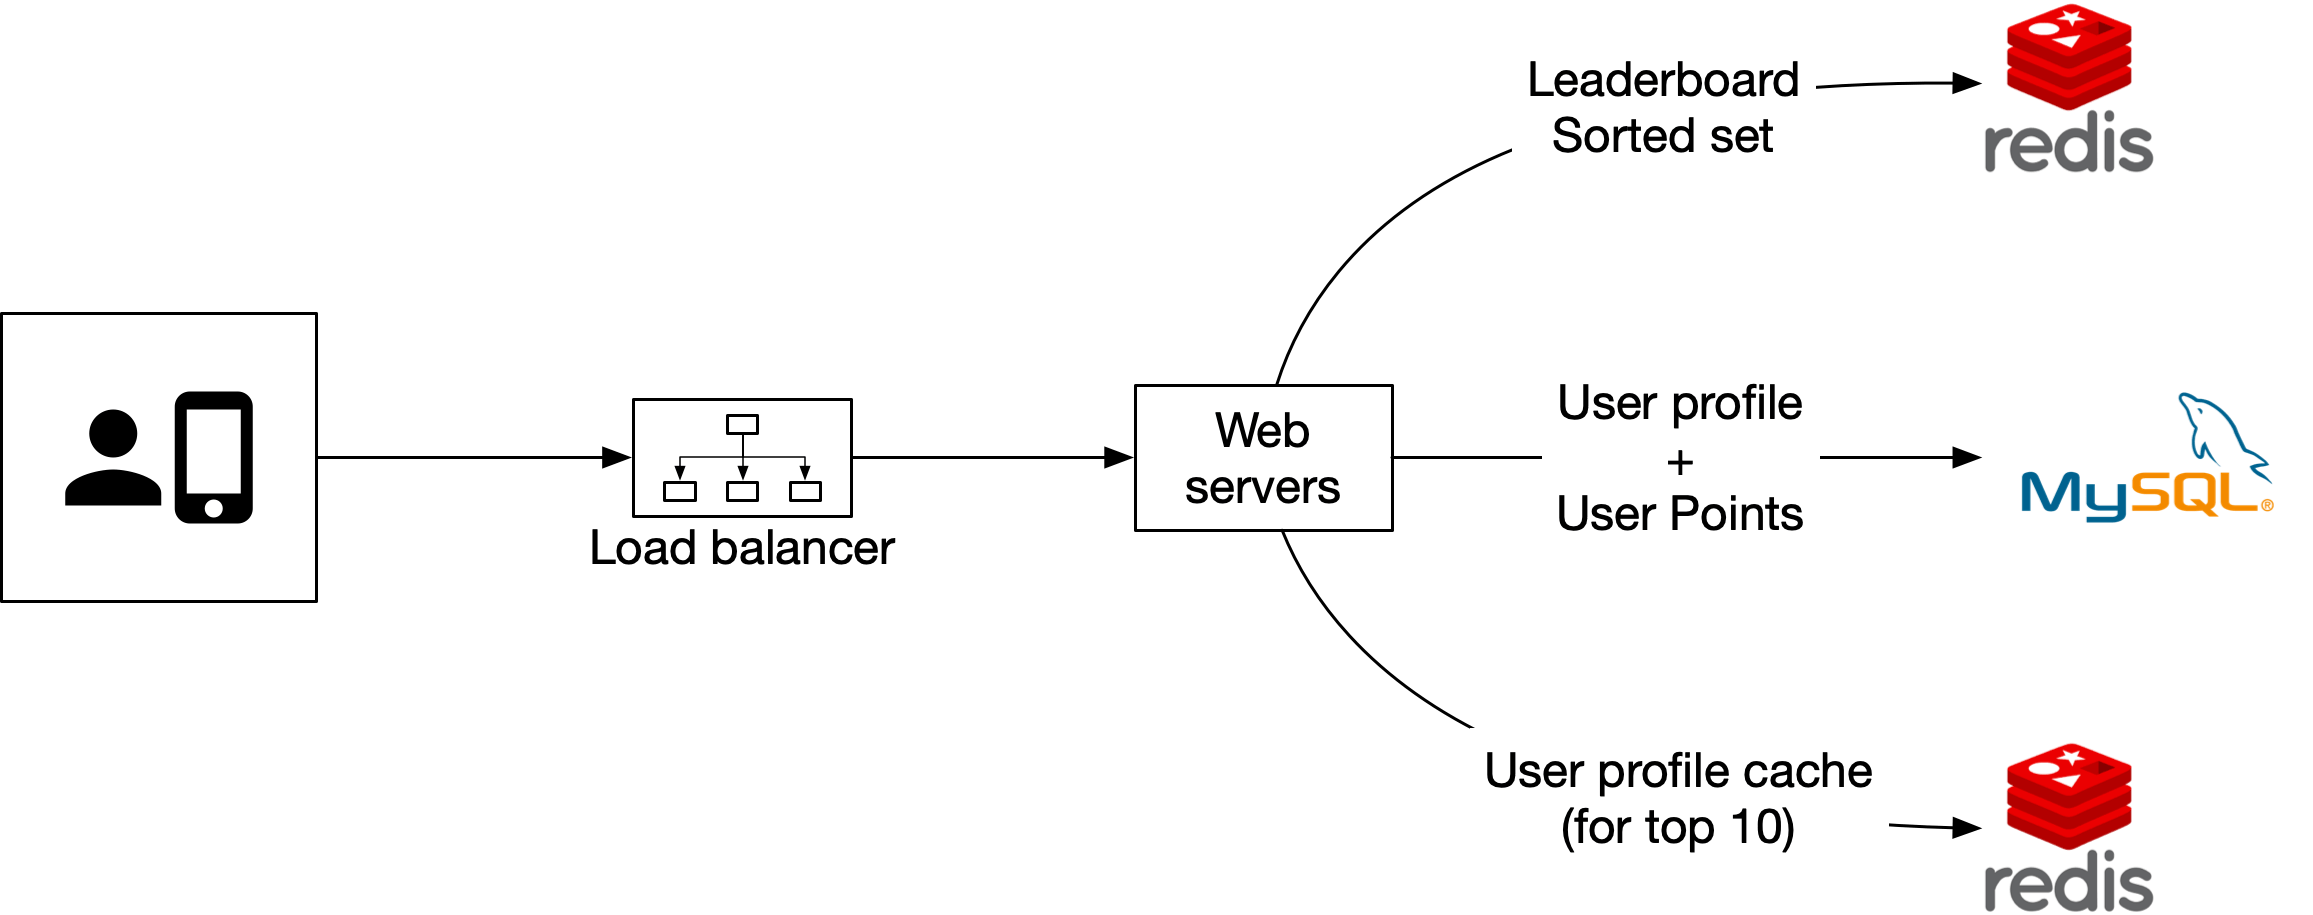
Рисунок 15 Manage our own services
Построить на cloud
Второй подход — leverage cloud infrastructure. Предположим, existing infrastructure уже на AWS, и leaderboard тоже логично строить там. В design используем две major AWS technologies: Amazon API Gateway и AWS Lambda [7]. Amazon API Gateway позволяет определить HTTP endpoints RESTful API и привязать их к backend services. Мы используем его для вызова Lambda functions. Mapping между RESTful APIs и Lambda functions показан в таблице 5.
| APIs | Lambda function |
|---|---|
| GET /v1/scores | LeaderboardFetchTop10 |
GET /v1/scores/{:user_id} | LeaderboardFetchPlayerRank |
| POST /v1/scores | LeaderboardUpdateScore |
Таблица 5 Lambda functions
AWS Lambda — одна из самых популярных serverless computing platforms. Она позволяет запускать code без ручного provisioning и server management. Код выполняется только когда нужен и автоматически scale-ится под traffic. Serverless — одна из самых горячих тем в cloud services: у Google есть Cloud Functions [8], у Microsoft — Azure Functions [9].
На high level game вызывает Amazon API Gateway, а тот — appropriate Lambda functions. Мы используем Lambda functions для вызова нужных commands на storage layer (Redis и MySQL), получения results и возврата их обратно в API Gateway, а затем в application.
Lambda functions позволяют выполнять все нужные queries без отдельного server instance. AWS предоставляет Redis clients, вызываемые прямо из Lambda. Это также дает auto-scaling при росте DAU. Ниже показаны design diagrams для scoring point и retrieving leaderboard.
Use case 1: scoring a point
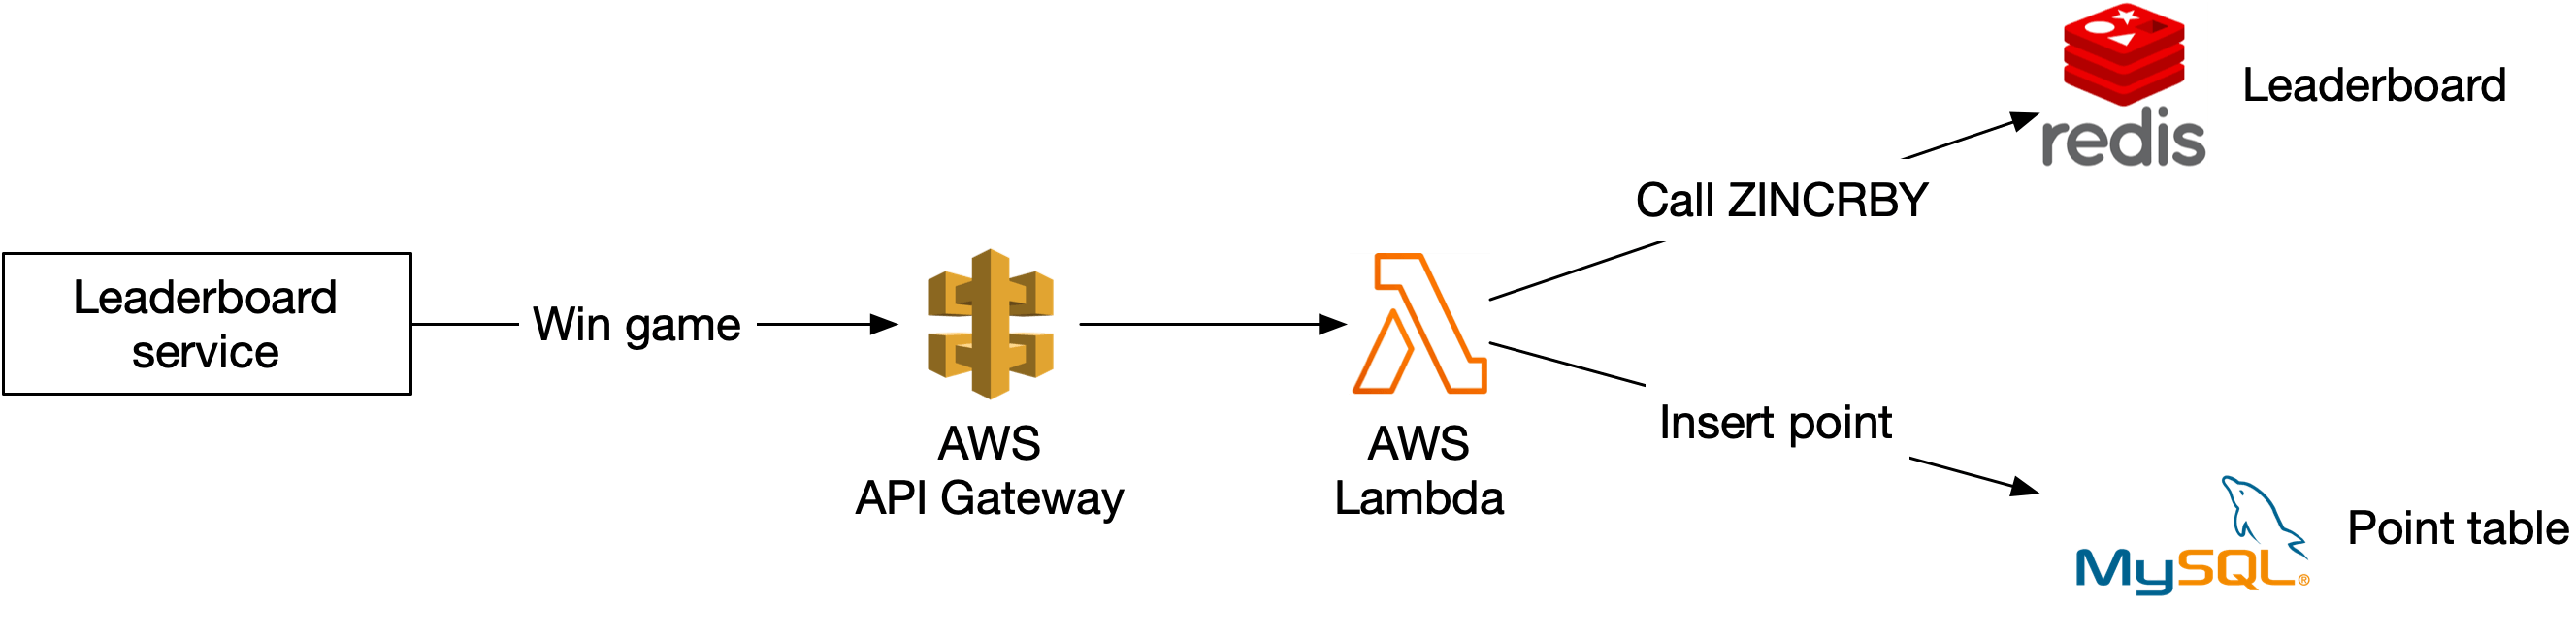
Рисунок 16 Score a point
Use case 2: retrieving leaderboard
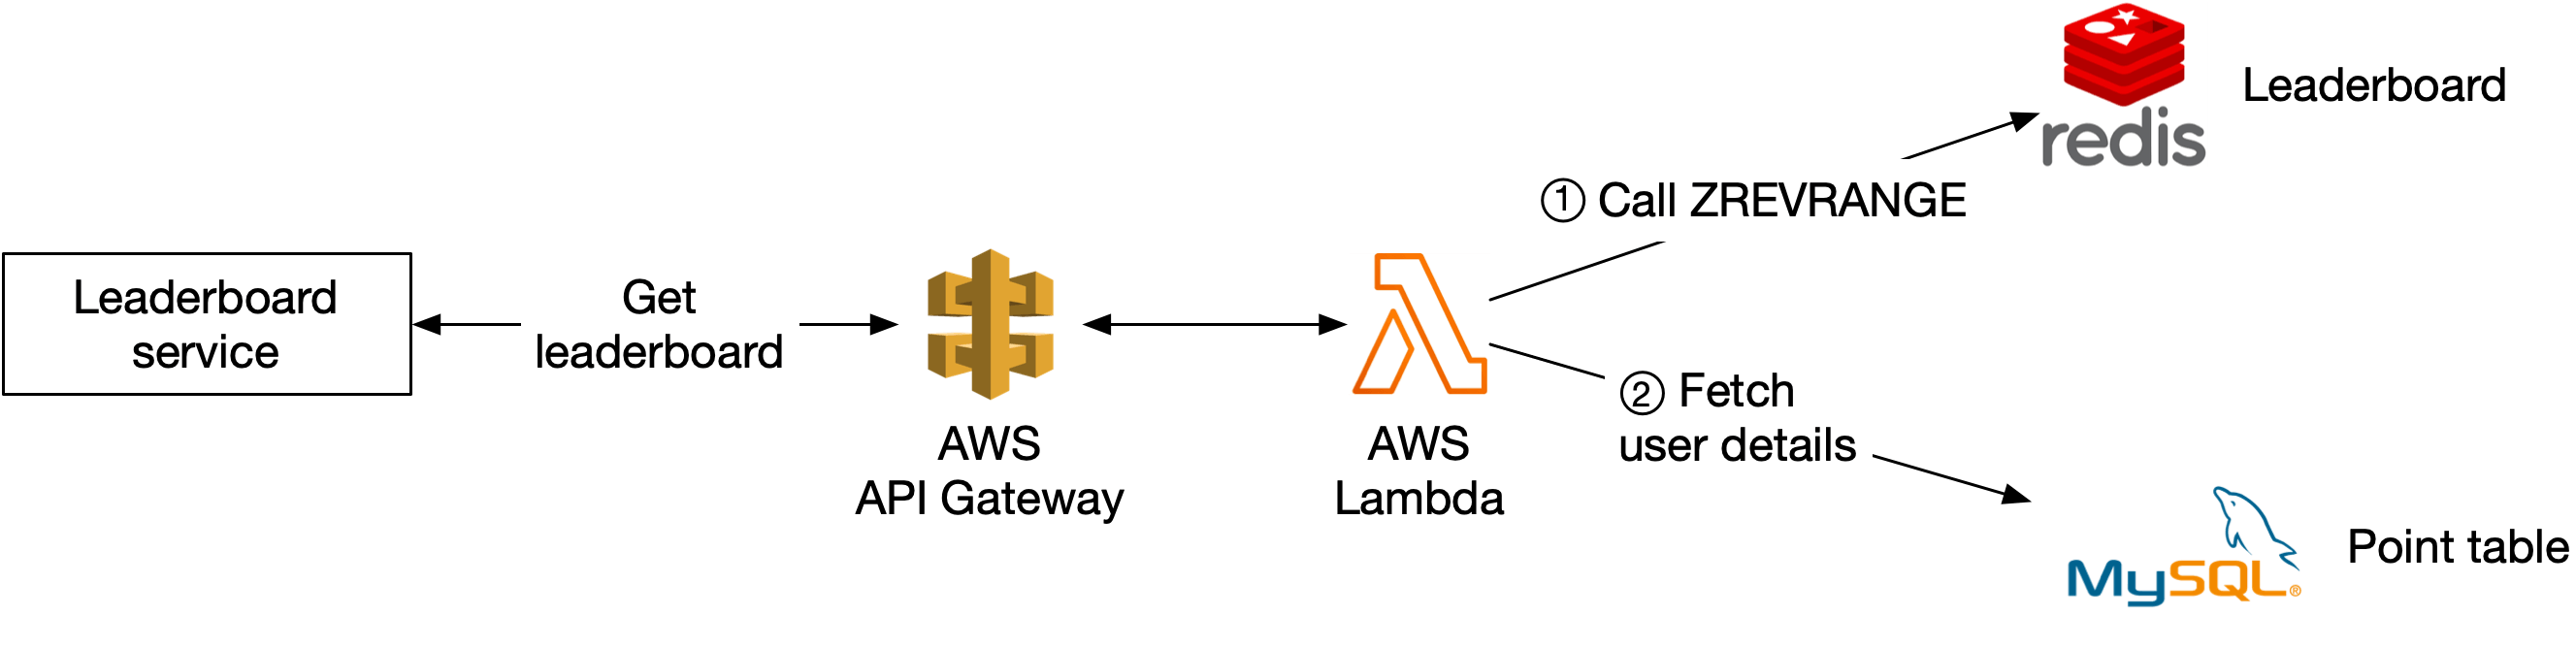
Рисунок 17 Retrieve leaderboard
Lambdas хороши тем, что дают serverless approach, а infrastructure сама берет на себя auto-scaling function по мере необходимости. Значит, нам не нужно заниматься scaling, environment setup и maintenance. Если мы строим game с нуля, serverless approach выглядит предпочтительно.
Scaling Redis
При 5 миллионах DAU одного Redis cache достаточно и по storage, и по QPS. Но представим, что у
нас 500 миллионов DAU, то есть scale в 100 раз выше. Тогда worst-case size leaderboard вырастает
до 65 GB (650 MB * 100), а QPS — до 250,000 (2,500 * 100) queries per second. Тут уже нужна
sharding solution.
Data sharding
Рассмотрим два варианта sharding: fixed partitions и hash partitions.
Fixed partition
У fixed partitions удобно мыслить через общий range scores на leaderboard. Допустим, число points
за месяц варьируется от 1 до 1000, и мы режем data по ranges. Например, берем 10 shards, и
каждый shard отвечает за 100 scores (1-100, 101-200, 201-300, ...), как на рисунке 18.

Рисунок 18 Fixed partition
Чтобы это работало, score distribution по leaderboard должна быть более-менее равномерной. Иначе придется подстраивать score ranges в shards вручную. В этом approach data shard-ится на стороне application code.
Когда мы insert/update score user, нужно знать, в каком shard он находится. Это можно сделать,
получив current score из MySQL, но быстрее иметь secondary cache с mapping user_id -> score.
Нужно внимательно следить за переходом user между shards: если score увеличился и user пересек
границу range, его надо удалить из old shard и перенести в new shard.
Чтобы fetch top 10 players, мы просто берем top 10 из shard-а с highest scores. На рисунке 18 это
последний shard с range [901, 1000].
Чтобы fetch rank user, надо посчитать:
-
local rank внутри его текущего shard
-
total number of players с higher scores во всех более старших shards
Заметим, что общее число players в shard можно получить через команду info keyspace за O(1)
[10].
Hash partition
Второй approach — использовать Redis cluster, особенно если scores сильно clustered. Redis cluster
умеет автоматически shard-ить data across multiple Redis nodes. Она не использует consistent
hashing, а строится на hash slots. Всего есть 16384 hash slots [11], и hash slot key
вычисляется так: CRC16(key) % 16384 [12]. Это позволяет добавлять и удалять nodes без полного
redistribution всех keys. На рисунке 19 три nodes:
-
первый node держит slots
[0, 5500] -
второй —
[5501, 11000] -
третий —
[11001, 16383]
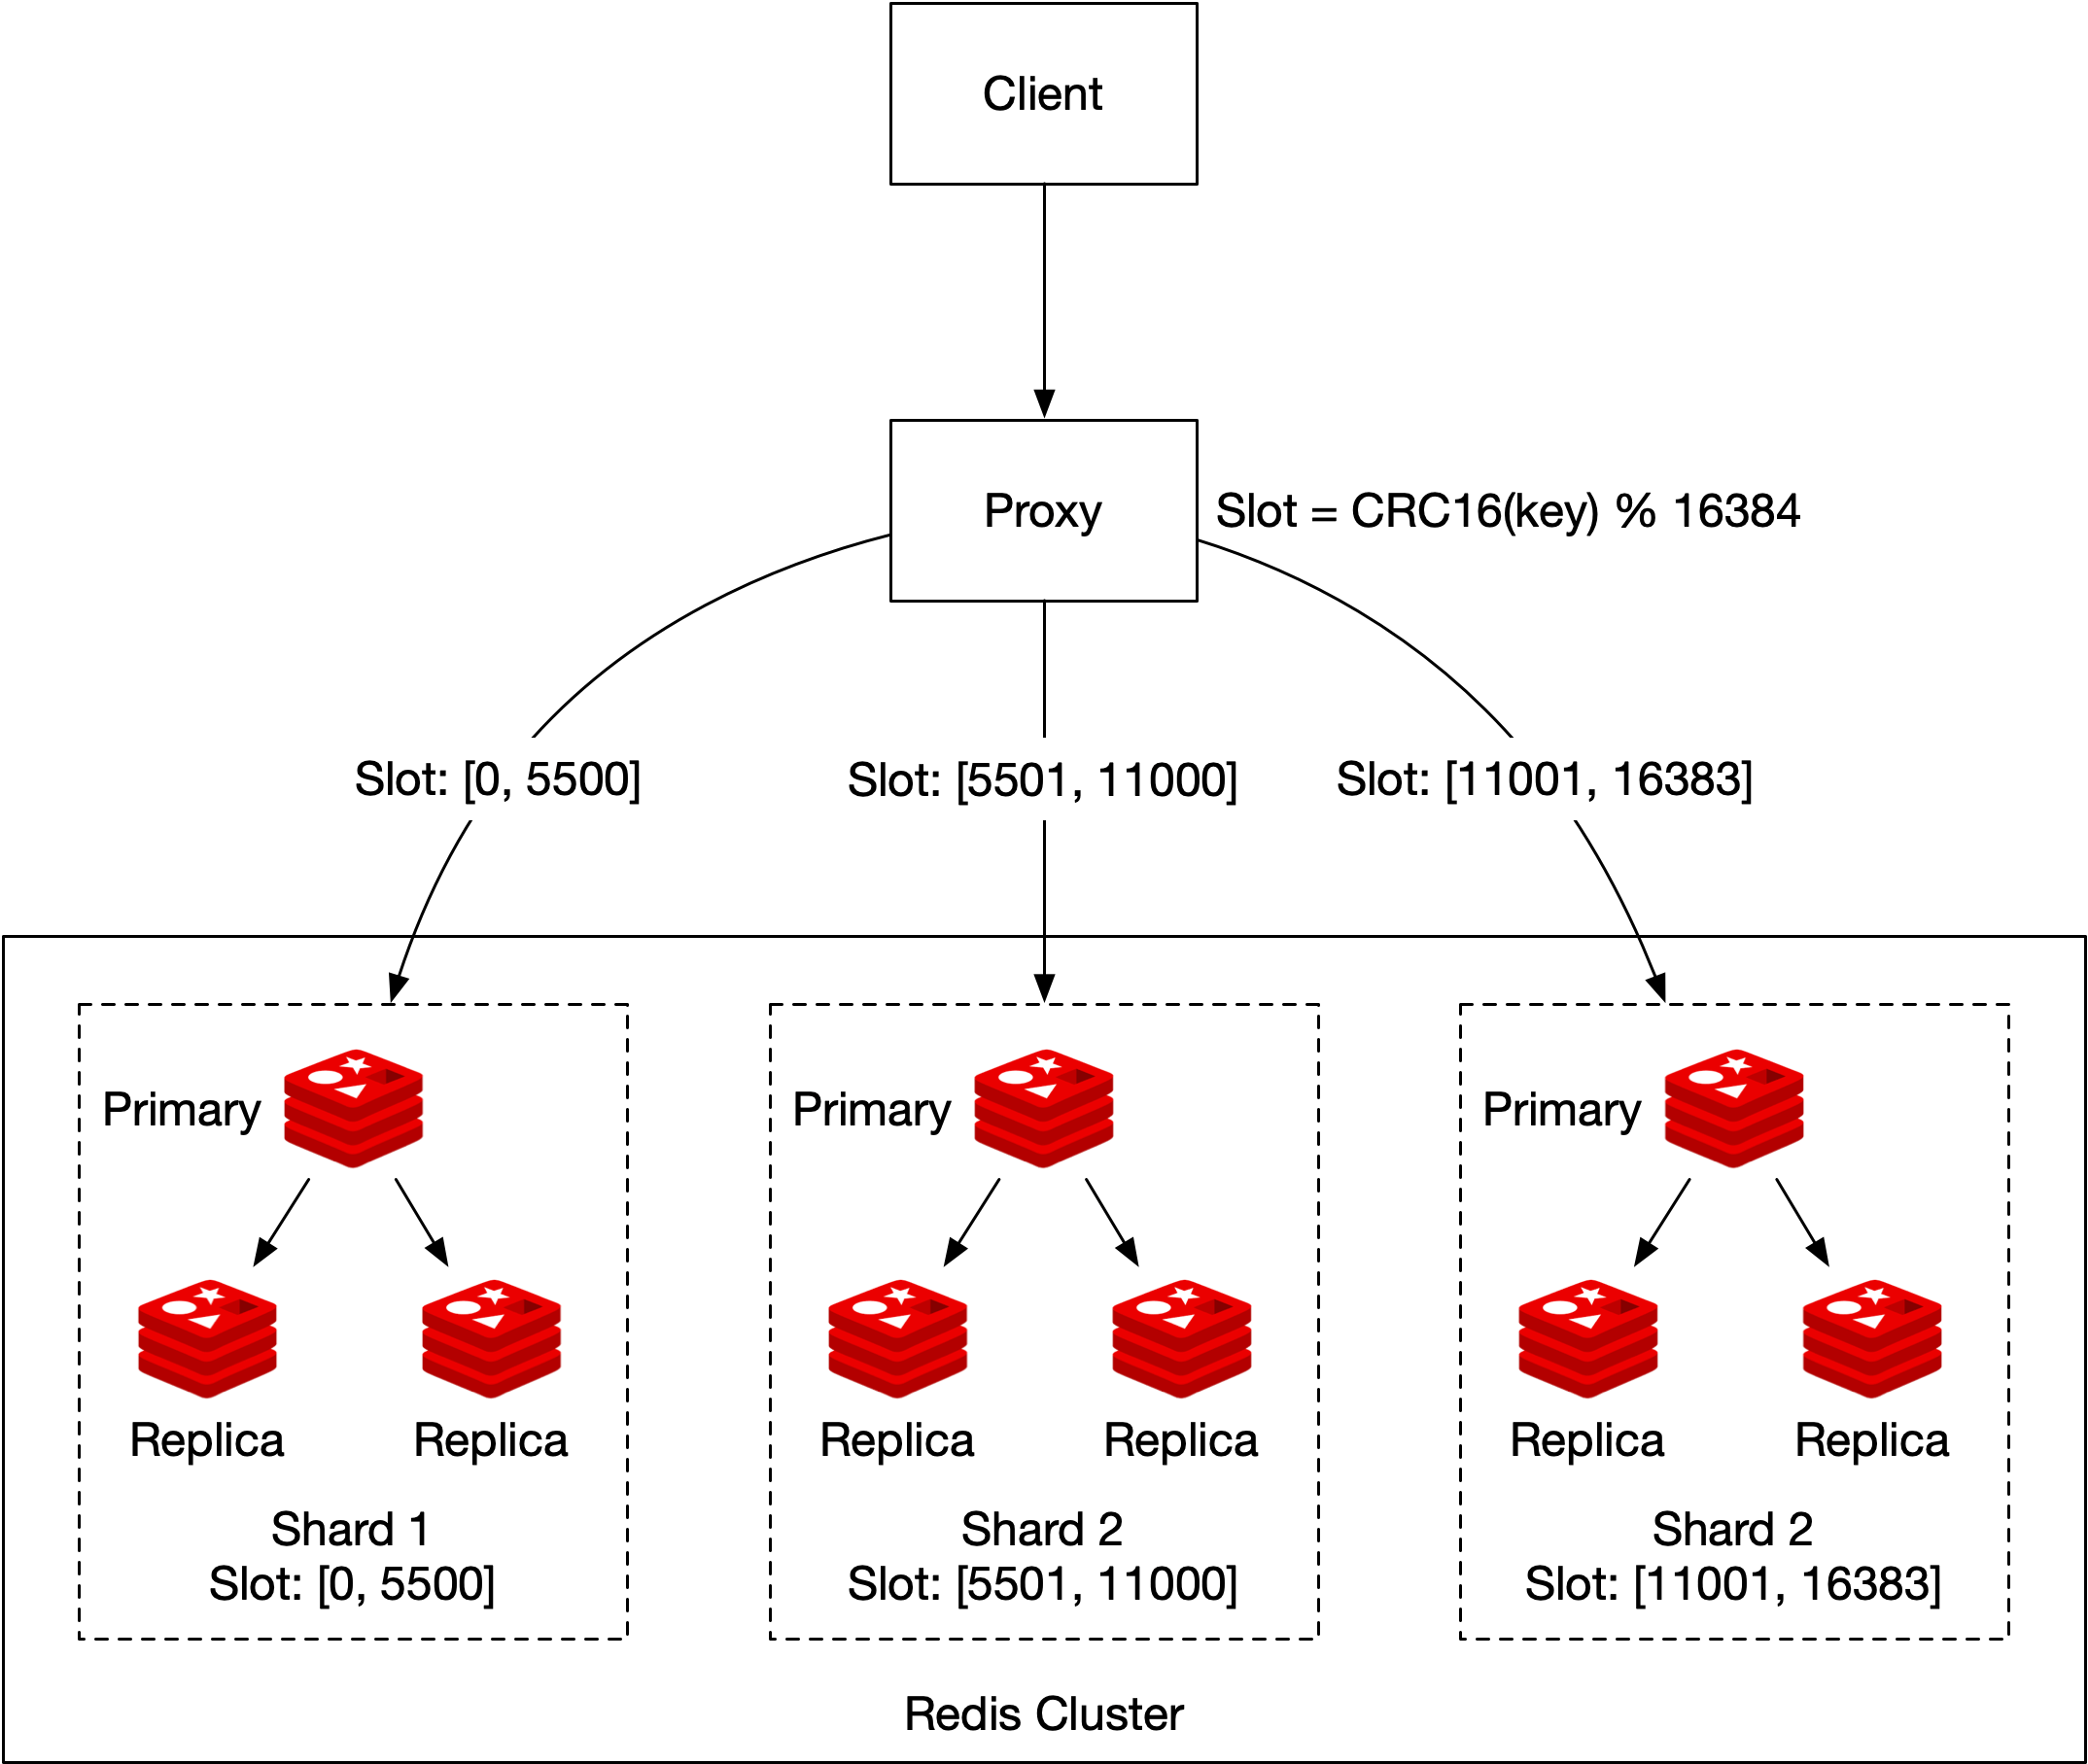
Рисунок 19 Hash partition
Update здесь просто меняет score user в соответствующем shard, определенном как
CRC16(key) % 16384. А вот top 10 leaderboard получить сложнее. Нужно собрать top 10 players из
каждого shard и потом отсортировать в application. Пример показан на рисунке 20. Такие queries
можно parallelize, чтобы уменьшить latency.
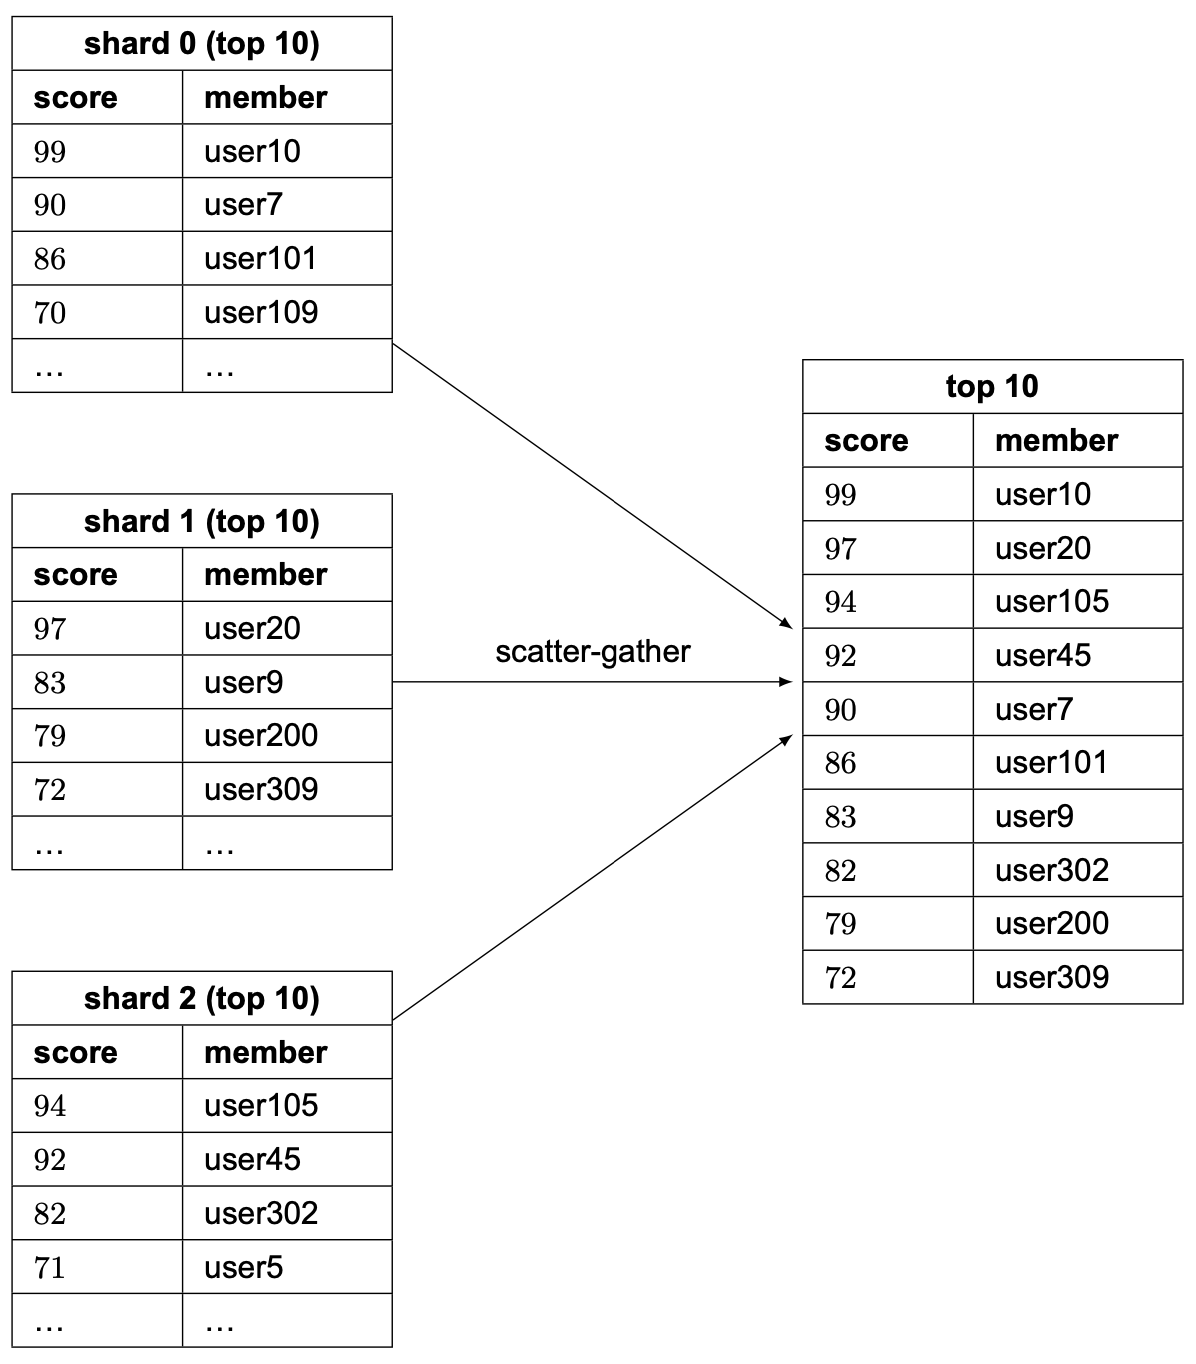
Рисунок 20 Scatter-gather
У этого approach есть ограничения:
-
Если нужно вернуть top K, где K большой, latency будет высокой, потому что с каждого shard придется возвращать много entries и потом сортировать.
-
Latency растет, если partitions много, потому что query ждет самый медленный partition.
-
У этого approach нет прямого и простого решения для exact rank конкретного user.
Поэтому мы склоняемся к первому предложению: fixed partition.
Sizing a Redis node
При sizing Redis nodes нужно учитывать несколько факторов [13]. Write-heavy applications требуют существенно больше available memory, потому что нужно уметь вместить все writes для snapshot в случае failure. Безопасный practical rule — закладывать вдвое больше memory для write-heavy applications.
Redis дает tool redis-benchmark, который позволяет измерить performance setup, симулируя много
clients и queries и возвращая requests per second для данного hardware. Подробнее — в [14].
Alternative solution: NoSQL
Еще один вариант — NoSQL databases. Какая NoSQL нам нужна? В идеале — такая, которая:
-
Optimized for writes
-
Умеет эффективно sort items внутри одной partition по score
Хорошим fit могут быть DynamoDB [15], Cassandra или MongoDB. В этой главе возьмем DynamoDB как пример. DynamoDB — fully managed NoSQL database с хорошей performance и scalability. Чтобы эффективно читать data по attributes, отличным от primary key, можно использовать global secondary indexes [16]. Такой index содержит часть attributes из parent table, но организованных уже по другому primary key.
Обновленная system diagram показана на рисунке 21. Redis и MySQL заменены на DynamoDB.
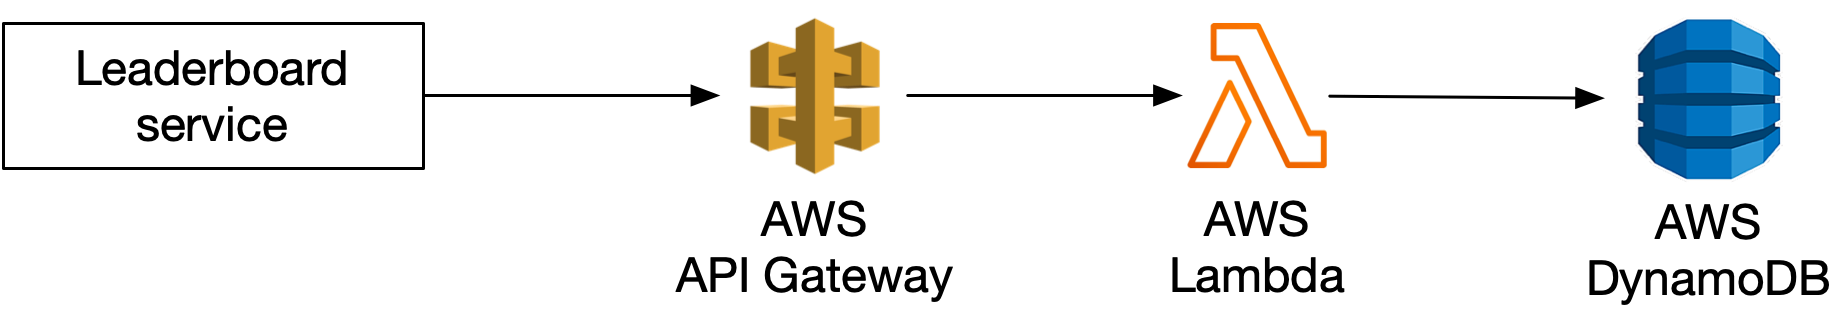
Рисунок 21 DynamoDB solution
Предположим, мы проектируем leaderboard для chess game, и наша initial table выглядит как на рисунке 22. Это denormalized view leaderboard table и user table, в котором уже есть все, что нужно для rendering leaderboard.
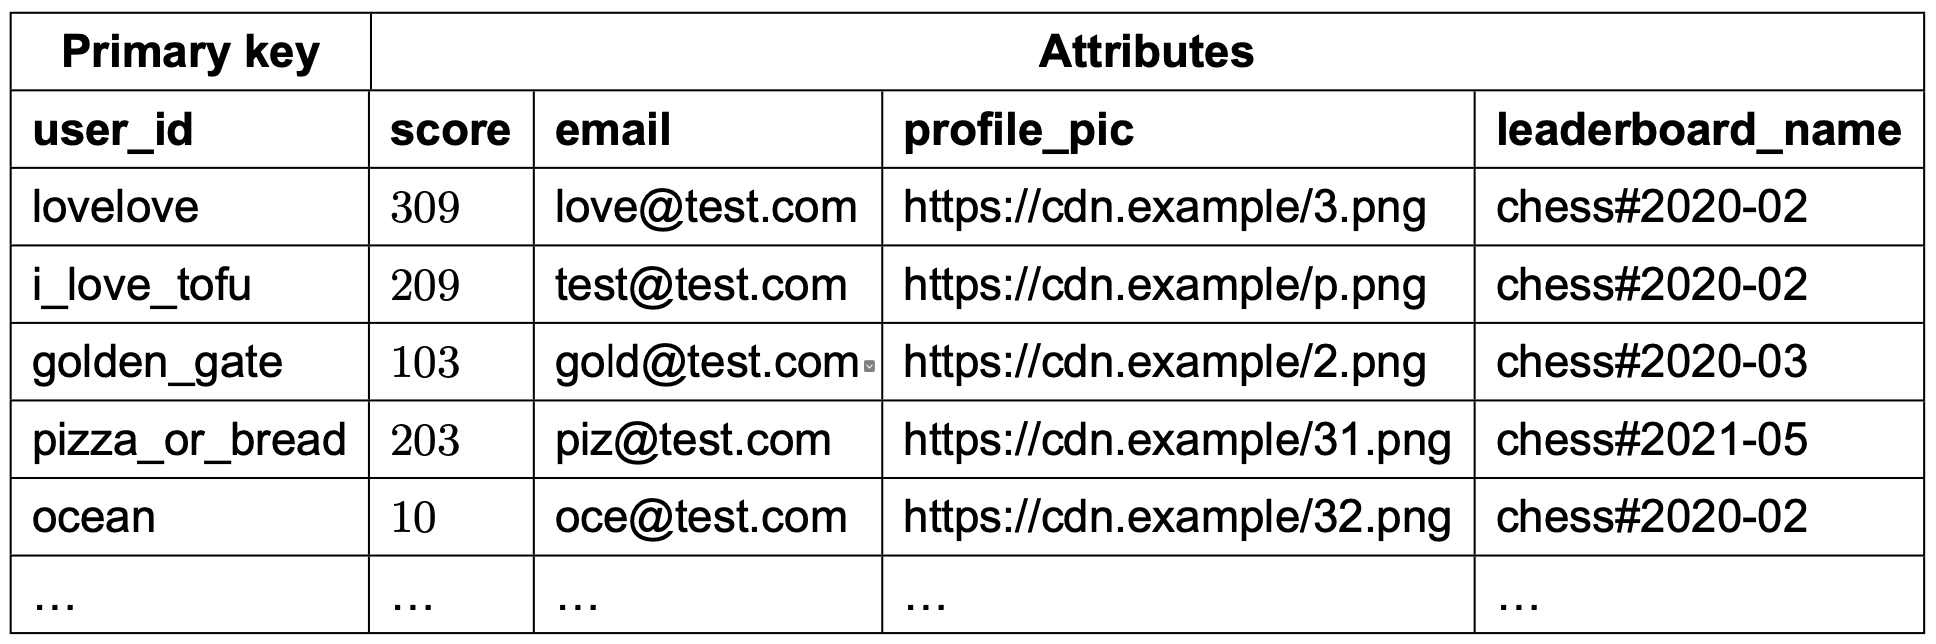
Рисунок 22 Denormalized view leaderboard и user tables
Такая scheme работает, но масштабируется плохо. По мере добавления rows приходится сканировать всю table, чтобы найти top scores.
Чтобы избежать linear scan, нужны indexes. Первая попытка — использовать
game_name#{year-month} как partition key, а score как sort key, как на рисунке 23.
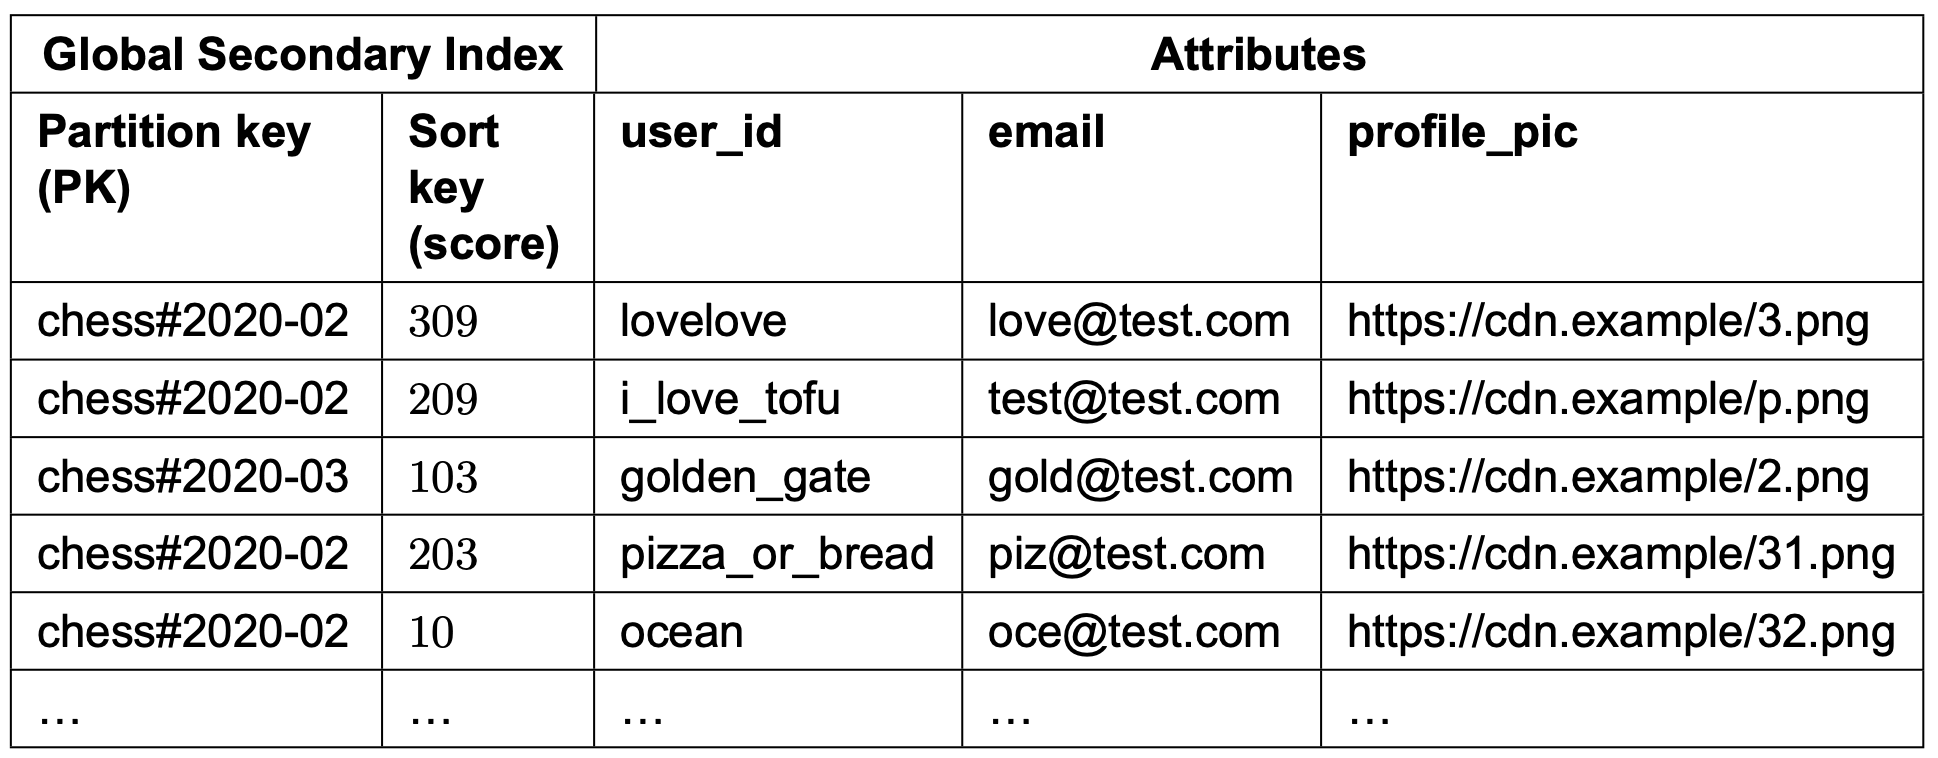
Рисунок 23 Partition key и sort key
Это работает, но при high load появляется проблема. DynamoDB распределяет data по multiple nodes через consistent hashing. Каждый item попадает на node по своему partition key. Нам хочется равномерного распределения data across partitions. Но в design на рисунке 23 все data за текущий месяц попадают в одну partition, и она превращается в hot partition. Как это исправить?
Можно split data на N partitions и дописать partition number (user_id % number_of_partitions)
в partition key. Этот pattern называется write sharding. Он добавляет complexity и в reads, и в
writes, поэтому trade-offs надо оценивать аккуратно.
Второй вопрос — как выбрать число partitions. Оно может зависеть от write volume или DAU. Главное помнить trade-off между load на partition и read complexity. Чем больше partitions, тем легче нагрузка на каждую из них, но тем сложнее читать leaderboard за месяц, потому что придется опрашивать все partitions и merge-ить results.
Partition key в итоге выглядит примерно так:
game_name#{year-month}#p{partition_number}. Обновленная schema показана на рисунке 24.
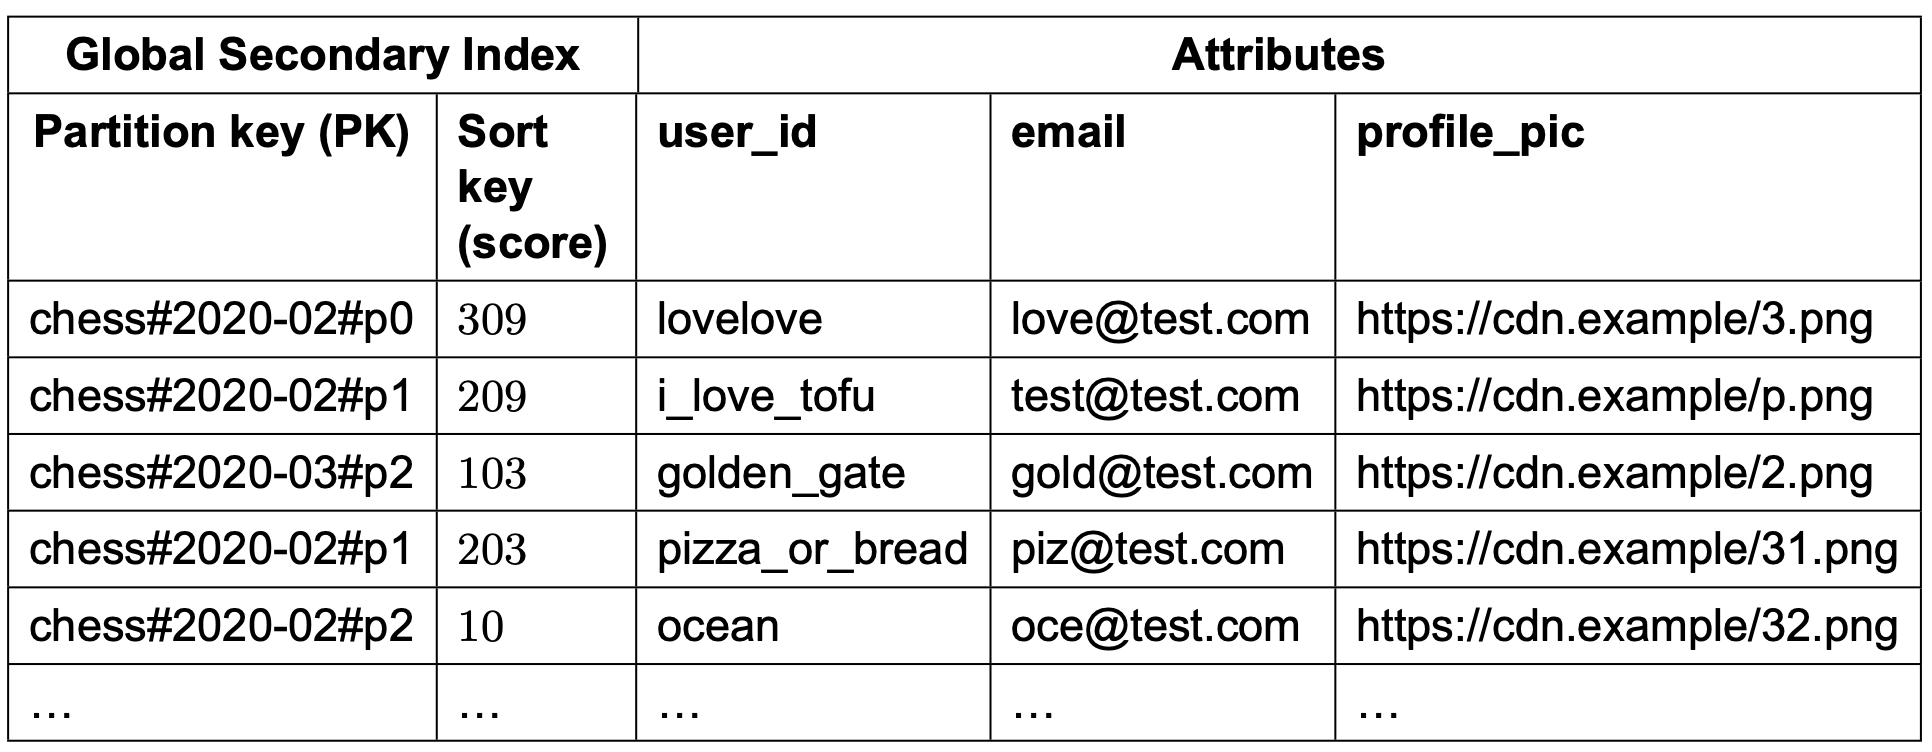
Рисунок 24 Updated partition key
Global secondary index использует game_name#{year-month}#p{partition_number} как partition key,
а score — как sort key. В итоге получаем N partitions, каждая из которых locally sorted.
Предположим, partitions три. Чтобы получить top 10 leaderboard, используем scatter-gather,
упомянутый выше: берем top 10 из каждой partition (scatter), затем application сортирует результаты
между partitions (gather). Пример — на рисунке 25.
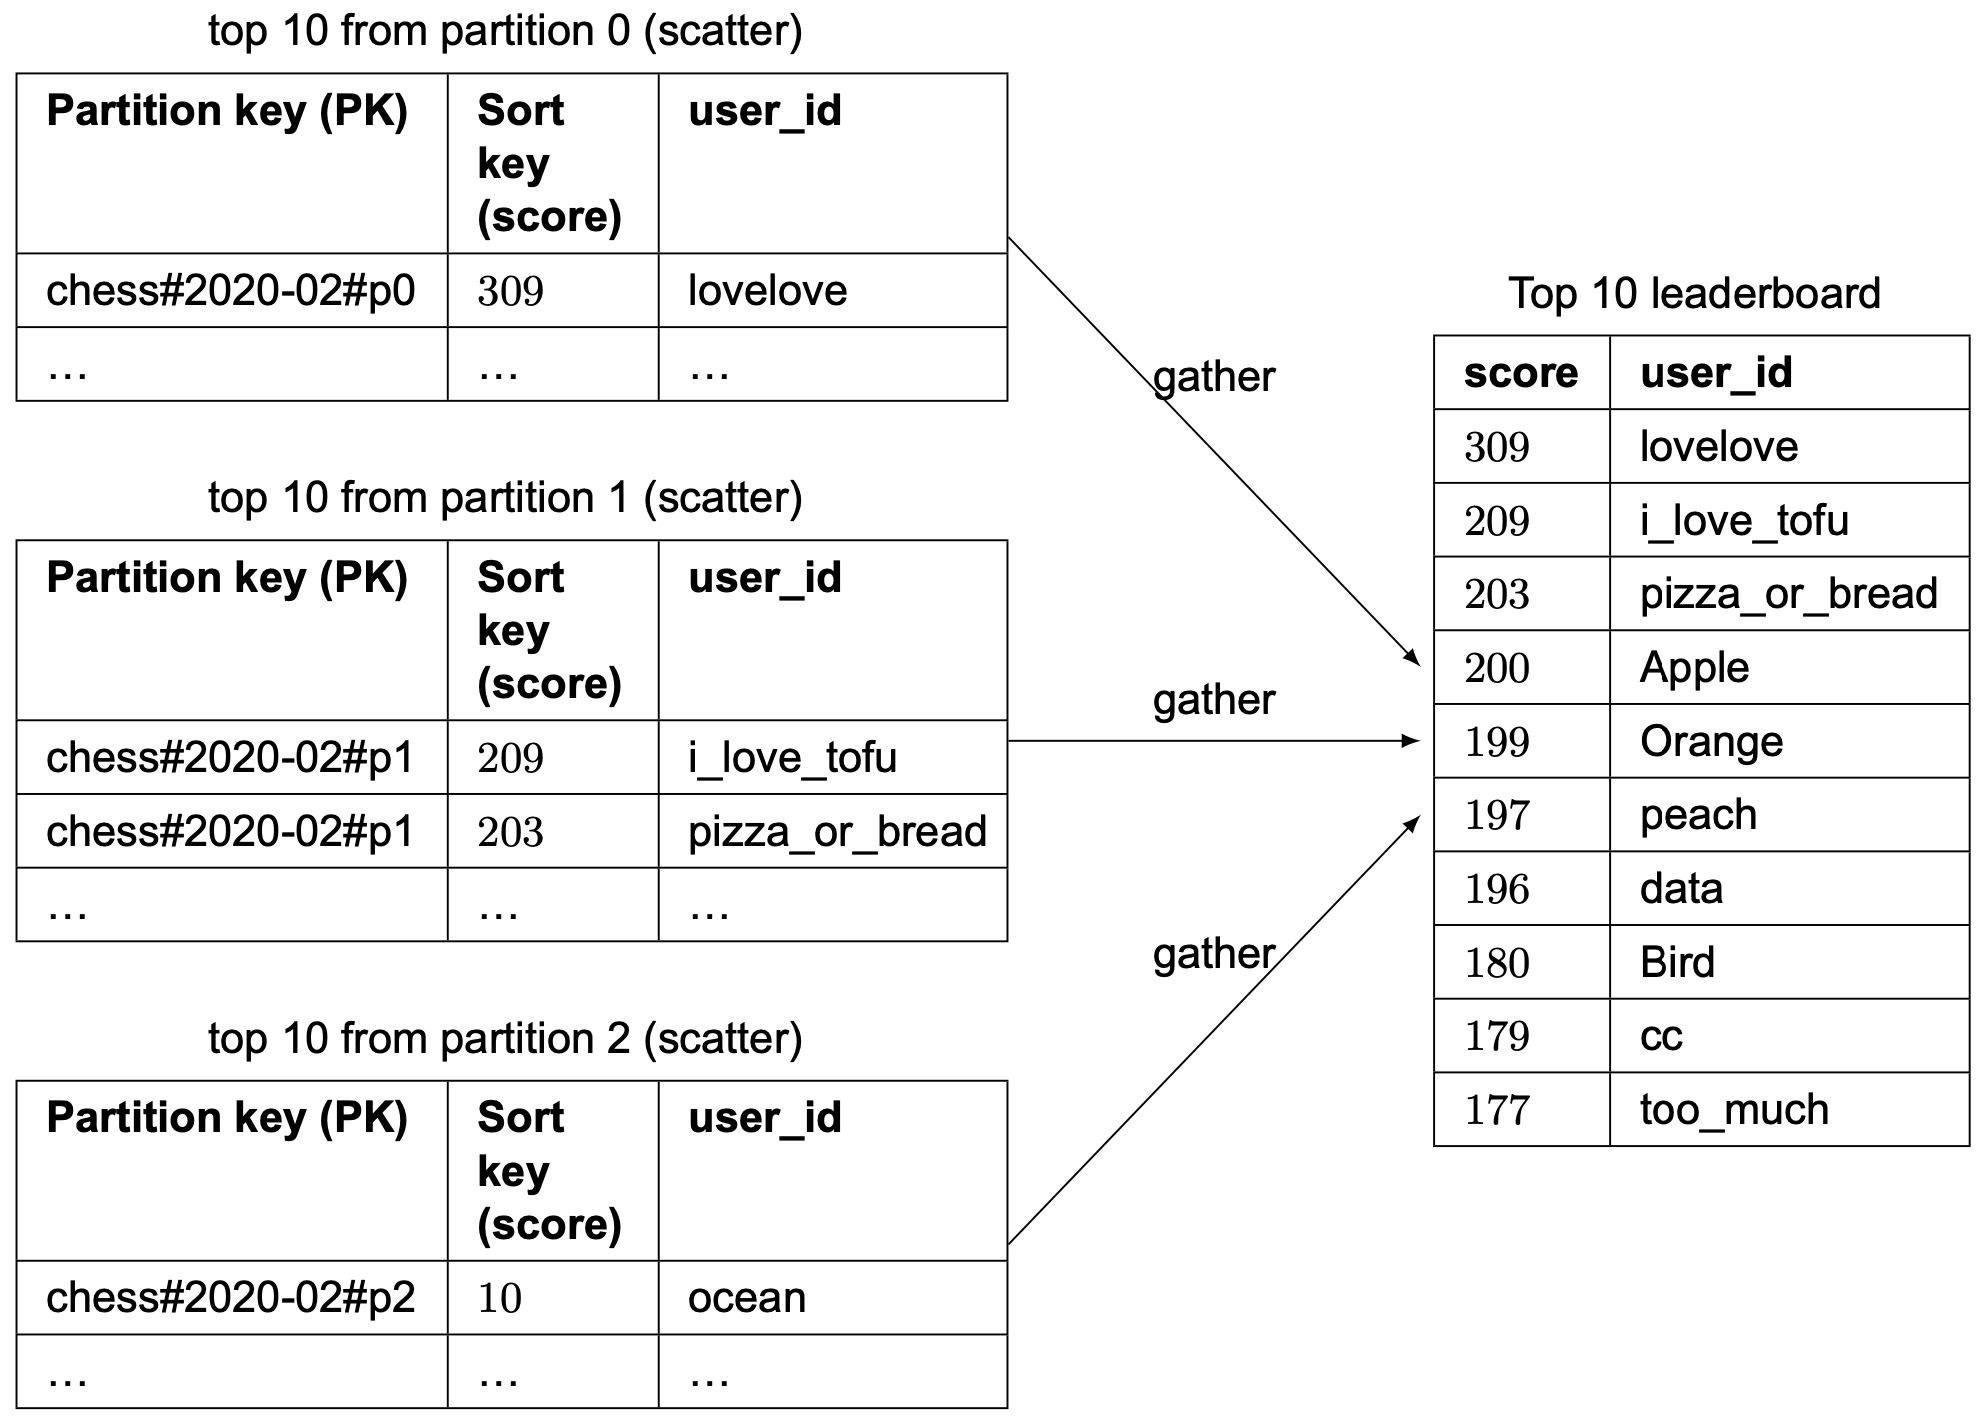
Рисунок 25 Scatter-gather
Как выбрать число partitions? Скорее всего, через benchmarking. Большее число partitions снижает load на каждую, но усложняет reads. Benchmarking помогает увидеть этот trade-off явно.
Как и Redis-partition solution, этот approach не дает straightforward solution для exact rank
конкретного user. Но он позволяет вернуть percentile user position, и этого может быть достаточно.
В реальной жизни сказать player, что он в top 10-20%, иногда полезнее, чем показывать точный rank,
например 1,200,001. Если scale настолько велик, что требуется sharding, можно предположить, что
score distributions across shards примерно одинаковы. Тогда cron job может периодически анализировать
distribution scores в каждом shard и кэшировать результат.
Результат может выглядеть так:
10th percentile = score < 100
20th percentile = score < 500
...
90th percentile = score < 6500
Тогда relative ranking user можно возвращать быстро, например “90th percentile”.
Шаг 4 — Итоги
В этой главе мы построили решение для real-time game leaderboard на масштабе миллионов DAU. Сначала рассмотрели straightforward solution на MySQL и отвергли ее, потому что она не масштабируется до миллионов users. Затем спроектировали leaderboard через Redis sorted sets. После этого посмотрели, как масштабировать решение до 500 миллионов DAU через sharding по нескольким Redis caches. Также предложили alternative NoSQL solution.
Если в конце interview остается extra time, можно обсудить еще несколько тем.
Быстрое retrieval и breaking tie
Redis Hash дает map между string fields и values. Его можно использовать для двух use cases:
-
Хранить map
user_id -> user object, который показывается в leaderboard. Это быстрее, чем каждый раз ходить в database за user object. -
Если два players имеют одинаковый score, можно break ties по тому, кто получил этот score раньше. При increment score можно параллельно хранить map
user_id -> timestampпоследней выигранной game. В случае tie выше ранжируется user с более старым timestamp.
System failure recovery
Redis cluster потенциально может пережить large-scale failure. В таком случае можно написать
script, использующий факт, что MySQL database хранит entry с timestamp каждый раз, когда user
выигрывает game. Дальше можно пройти по всем entries для каждого user и вызвать ZINCRBY один раз
на каждую запись. Это позволит rebuild leaderboard offline после крупного outage.
Поздравляю, вы дошли до конца. Можно похлопать себе по плечу — хорошая работа.
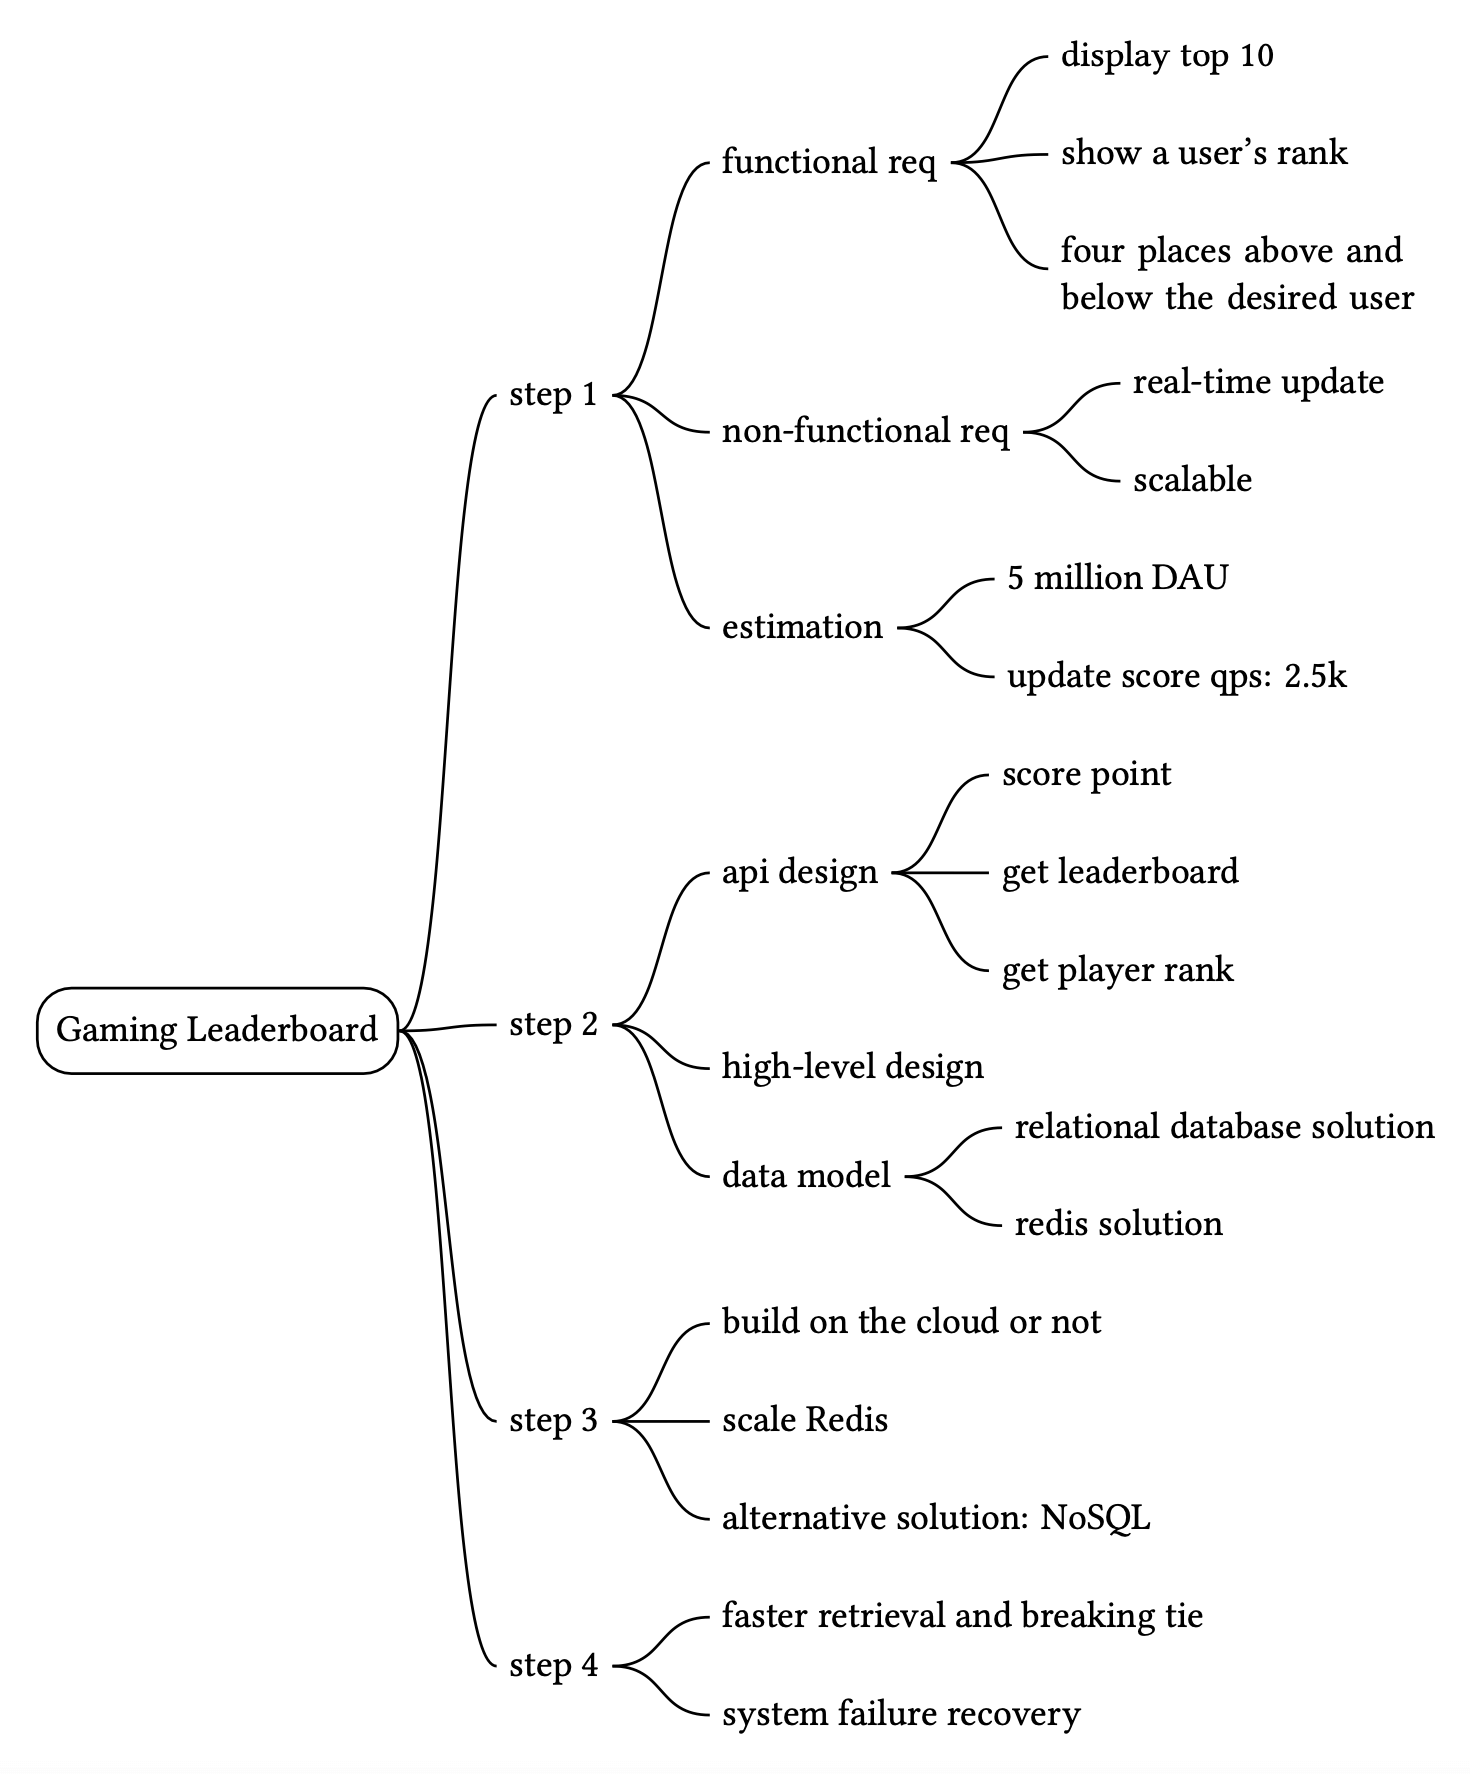
Краткое содержание главы
Reference Material
[1] Redis Sorted Set source code:
https://github.com/redis/redis/blob/unstable/src/t_zset.c
[2] Geekbang:
https://static001.geekbang.org/resource/image/46/a9/46d283cd82c987153b3fe0c76dfba8a9.jpg
[3] Building real-time Leaderboard with Redis:
https://medium.com/@sandeep4.verma/building-real-time-leaderboard-with-redis-82c98aa47b9f
[4] Build a real-time gaming leaderboard with Amazon ElastiCache for Redis:
https://aws.amazon.com/blogs/database/building-a-real-time-gaming-leaderboard-with-amazon-elasticache-for-redis
[5] How we created a real-time Leaderboard for a million Users:
https://levelup.gitconnected.com/how-we-created-a-real-time-leaderboard-for-a-million-users-555aaa3ccf7b
[6] Leaderboards: https://redislabs.com/solutions/use-cases/leaderboards/
[7] Lambda: https://aws.amazon.com/lambda/
[8] Google Cloud Functions: https://cloud.google.com/functions
[9] Azure Functions: https://azure.microsoft.com/en-us/services/functions/
[10] Info command: https://redis.io/commands/INFO
[11] Why Redis cluster only have 16384 slots:
https://stackoverflow.com/questions/36203532/why-redis-cluster-only-have-16384-slots
[12] Cyclic redundancy check: https://en.wikipedia.org/wiki/Cyclic_redundancy_check
[13] Choosing your node size:
https://docs.aws.amazon.com/AmazonElastiCache/latest/red-ug/nodes-select-size.html
[14] How fast is Redis?: https://redis.io/topics/benchmarks
[15] Using Global Secondary Indexes in DynamoDB:
https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/GSI.html
[16] Leaderboard & Write Sharding: https://www.dynamodbguide.com/leaderboard-write-sharding/