Автодополнения поиска
Когда вы ищете что-то в Google или покупаете товары на Amazon, по мере ввода текста в search box
вам показываются один или несколько подходящих вариантов. Эту функцию называют autocomplete,
typeahead, search-as-you-type или incremental search. На рисунке 1 показан пример Google search,
где при вводе dinner появляется список автодополнений. Search autocomplete — важная функция
многих продуктов. Отсюда и возникает вопрос на интервью: спроектировать систему search
autocomplete, которую также часто называют design top k или design top k most searched queries.
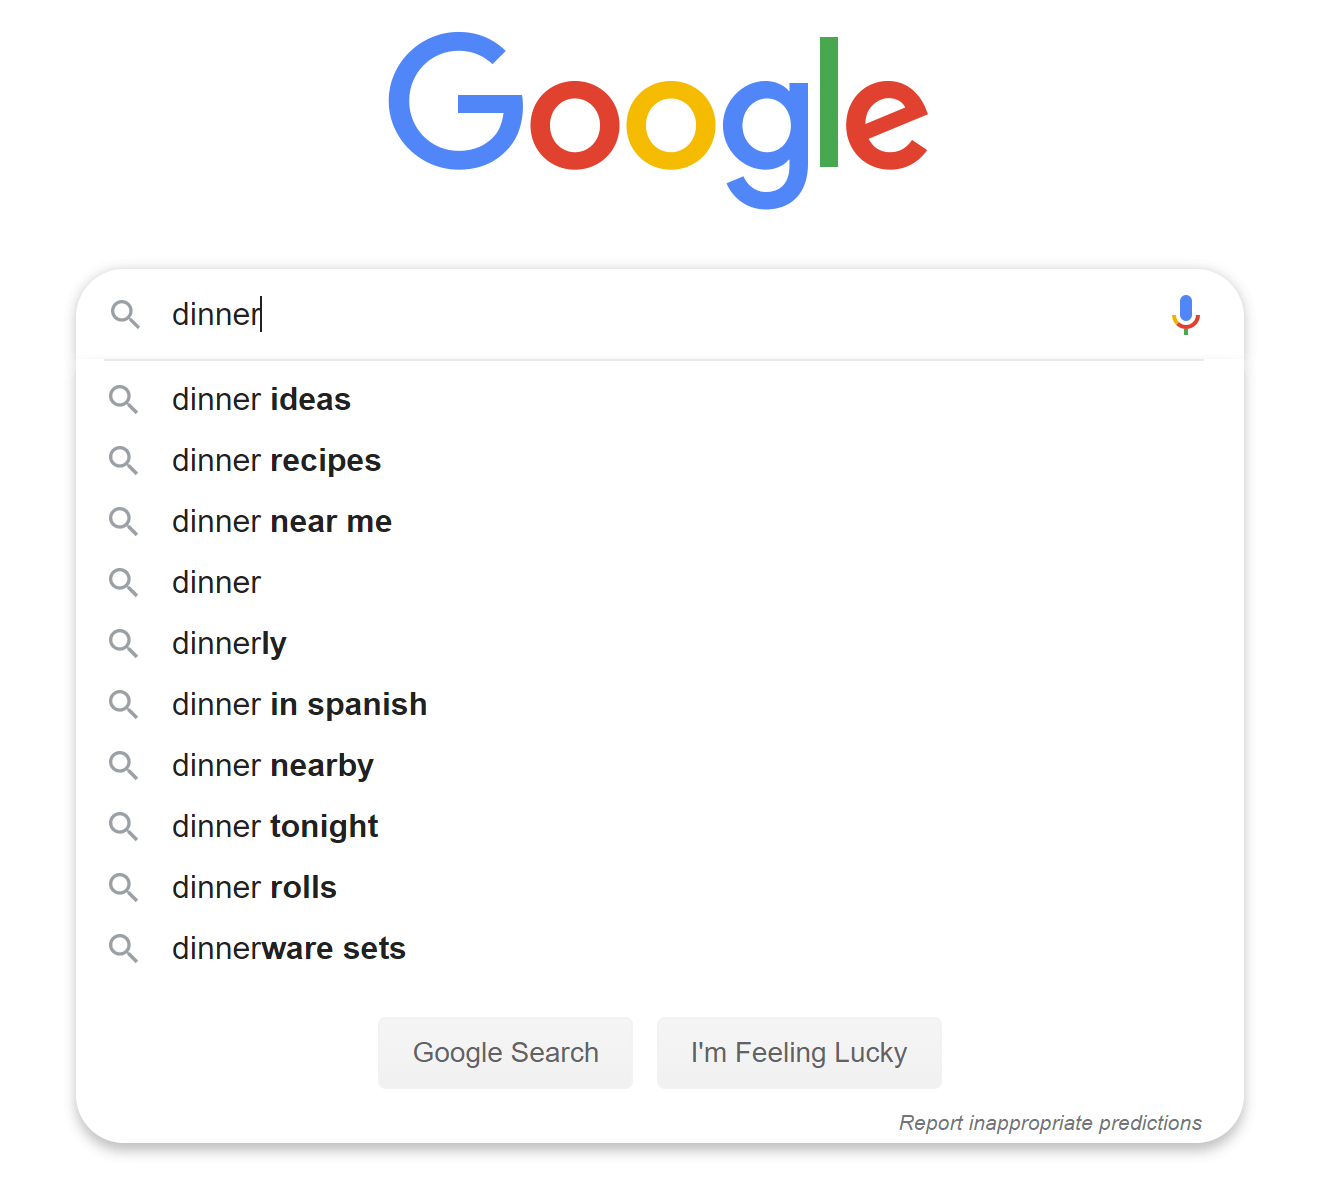
Рисунок 1
Шаг 1 — Понять задачу и определить рамки дизайна
Первый шаг в любом вопросе по системному дизайну — задать достаточно вопросов, чтобы уточнить требования. Ниже приведен пример диалога кандидата и интервьюера:
Кандидат: Совпадение поддерживается только в начале запроса или также в середине?
Интервьюер: Только в начале search query.
Кандидат: Сколько autocomplete suggestions система должна возвращать?
Интервьюер: 5.
Кандидат: Как система определяет, какие именно 5 suggestions вернуть?
Интервьюер: Это определяется популярностью, то есть исторической частотой запросов.
Кандидат: Поддерживается ли spell check?
Интервьюер: Нет, spell check и autocorrect не поддерживаются.
Кандидат: Search queries только на английском?
Интервьюер: Да. Если останется время, можно обсудить мультиязычную поддержку.
Кандидат: Разрешены ли заглавные буквы и специальные символы?
Интервьюер: Нет, предположим, что все запросы состоят только из строчных букв английского
алфавита.
Кандидат: Сколько пользователей использует продукт?
Интервьюер: 10 миллионов DAU.
Требования
Сводка требований:
-
Быстрое время ответа: по мере ввода запроса autocomplete suggestions должны появляться очень быстро. В статье о Facebook autocomplete [1] говорится, что система должна возвращать результат менее чем за 100 миллисекунд, иначе пользователь заметит торможение.
-
Релевантность: autocomplete suggestions должны соответствовать введенному search term.
-
Сортировка: результаты должны быть отсортированы по популярности или другой ranking model.
-
Масштабируемость: система должна выдерживать высокий трафик.
-
Высокая доступность: система должна оставаться доступной, даже если часть ее компонентов отключена, замедлилась или столкнулась с неожиданными сетевыми ошибками.
Оценка на салфетке
-
Предположим, у нас 10 миллионов daily active users.
-
В среднем один человек выполняет 10 поисков в день.
-
Один query string занимает 20 байт:
-
Предполагаем ASCII encoding: 1 символ = 1 байт.
-
Предположим, в запросе 4 слова, а средняя длина слова — 5 символов.
-
Тогда
4 * 5 = 20 bytesна query. -
Для каждого символа, введенного в search box, клиент посылает запрос в backend за autocomplete suggestions. В среднем на один search query уходит 20 запросов. Например, пока пользователь набирает
dinner, backend получит такие запросы:
search?q=d
search?q=di
search?q=din
search?q=dinn
search?q=dinne
search?q=dinner
-
~24,000 QPS = 10,000,000 users * 10 queries/day * 20 characters / 24 hours / 3600 seconds -
Peak QPS =
QPS * 2 = ~48,000 -
Предположим, что 20% ежедневных запросов — новые. Тогда
10 million * 10 queries/day * 20 bytes/query * 20% = 0.4 GB. Это значит, что ежедневно в storage добавляется 0.4 ГБ новых данных.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
На high-level систему можно разбить на две части:
-
Data gathering service: собирает пользовательские search queries и агрегирует их в реальном времени. Real-time processing не очень практичен для больших объемов данных, но как стартовая точка он полезен. Более реалистичный вариант мы обсудим в deep dive.
-
Query service: по заданному search query или prefix возвращает 5 самых частых запросов.
Data gathering service
Используем упрощенный пример, чтобы понять, как работает data gathering service. Предположим, у нас
есть frequency table, которая хранит query string и его frequency, как на рисунке 2. Вначале
таблица пуста. Затем пользователи последовательно вводят twitch, twitter, twitter и
twillo. На рисунке 2 показано, как обновляется frequency table.

Рисунок 2
Query service
Предположим, у нас есть frequency table, как в таблице 1. В ней два поля:
-
Query: хранит query string.
-
Frequency: показывает, сколько раз этот query выполнялся.
| Query | Frequency |
|---|---|
| 35 | |
| twitch | 29 |
| twilight | 25 |
| twin peak | 21 |
| twitch prime | 18 |
| twitter search | 14 |
| twillo | 10 |
| twin peak sf | 8 |
Таблица 1
Когда пользователь вводит tw, система показывает следующие top 5 searched queries, как на
рисунке 3, если опираться на Table 1.

Рисунок 3
Чтобы получить top 5 most frequently searched queries, можно выполнить такой SQL-запрос:
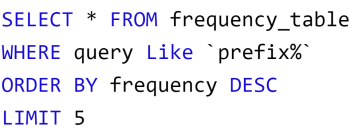
Рисунок 4
Это приемлемое решение, когда data set маленький. Но на больших объемах база данных становится узким местом. В deep dive мы обсудим оптимизации.
Шаг 3 — Детальный разбор дизайна
На high-level мы обсудили data gathering service и query service. Этот дизайн не оптимален, но служит хорошей отправной точкой. Теперь подробнее рассмотрим:
-
Trie data structure
-
Data gathering service
-
Query service
-
Масштабирование storage
-
Операции над trie
Trie data structure
В high-level design в качестве storage использовалась relational database. Но извлекать top 5 search queries из relational database неэффективно. Чтобы решить проблему, используют trie (prefix tree). Поскольку trie крайне важна для этой системы, мы потратим значительное время на разработку специализированного варианта trie. Некоторые идеи взяты из материалов [2] и [3].
Понимать базовую trie data structure для этого вопроса обязательно. Но сама структура — это скорее тема по алгоритмам, чем по системному дизайну. Кроме того, про trie много хороших материалов онлайн. Поэтому здесь мы ограничимся обзором и сосредоточимся на том, как оптимизировать базовую trie для уменьшения времени ответа.
Trie (произносится как try) — это древовидная структура данных, компактно хранящая строки.
Название происходит от слова retrieval, что подчеркивает ее назначение для операций поиска
строк. Основные идеи trie:
-
Trie — это tree-like data structure.
-
Root представляет пустую строку.
-
Каждый node хранит один символ и имеет 26 children, по одному на каждый возможный символ. Чтобы экономить место, пустые ссылки не рисуются.
-
Каждый tree node представляет либо полное слово, либо prefix string.
На рисунке 5 показана trie с search queries tree, try, true, toy, wish, win. Полные
queries выделены более толстой рамкой.

Рисунок 5
Базовая trie хранит в nodes символы. Чтобы поддерживать сортировку по frequency, в nodes нужно добавить frequency information. Предположим, у нас есть такая таблица частот:
| Query | Frequency |
|---|---|
| tree | 10 |
| try | 29 |
| true | 35 |
| toy | 14 |
| wish | 25 |
| win | 50 |
Таблица 2
После добавления frequency info в nodes обновленная trie выглядит как на рисунке 6.

Рисунок 6
Как autocomplete работает с trie? Прежде чем обсуждать алгоритм, введем обозначения:
-
p: длина prefix
-
n: общее число nodes в trie
-
c: число children у данного node
Шаги получения top k most searched queries:
-
Найти prefix. Сложность: O(p).
-
Обойти subtree начиная от prefix node и получить все valid children. Child считается valid, если из него можно получить корректный query string. Сложность: O(c).
-
Отсортировать children и взять top k. Сложность: O(c log c).
Рассмотрим пример на рисунке 7. Пусть k = 2, и пользователь вводит tr. Алгоритм работает так:
-
Шаг 1: найти prefix node
tr. -
Шаг 2: обойти subtree и получить всех valid children. В данном случае это
[tree:10],[true:35],[try:29]. -
Шаг 3: отсортировать children и взять top 2. Это будут
[true:35]и[try:29].

Рисунок 7
Итоговая сложность алгоритма — сумма затрат на все шаги: O(p) + O(c) + O(c log c).
Алгоритм простой, но он слишком медленный, потому что в худшем случае приходится обходить существенную часть trie. Ниже две оптимизации:
-
Ограничить максимальную длину prefix
-
Кэшировать top search queries в каждом node
Рассмотрим их по очереди.
Ограничение максимальной длины prefix
Пользователи редко вводят очень длинные search queries в search box. Поэтому можно безопасно
считать, что p — небольшое целое число, скажем 50. Если ограничить длину prefix, то сложность
шага Find the prefix можно снизить с O(p) до O(1).
Кэширование top search queries в каждом node
Чтобы не обходить всю trie, мы храним top k most frequently used queries в каждом node. Поскольку пользователю обычно достаточно 5–10 suggestions, k — небольшое число. В нашем случае кэшируются только top 5 search queries.
За счет кэширования top queries в каждом node мы резко сокращаем время получения top 5 queries. Да, такой дизайн требует много памяти, потому что top queries хранятся в каждом node. Но здесь обмен памяти на скорость полностью оправдан, так как fast response time чрезвычайно важен.
На рисунке 8 показана обновленная trie. В каждом node хранятся top 5 queries. Например, node с
prefix be содержит:
[best:35, bet:29, bee:20, be:15, beer:10].

Рисунок 8
Пересмотрим временную сложность алгоритма после этих двух оптимизаций:
-
Найти prefix node. Сложность: O(1).
-
Вернуть top k. Поскольку top k queries уже лежат в кэше, сложность этого шага тоже O(1).
Так как оба шага занимают O(1), общий алгоритм теперь тоже работает за O(1).
Data gathering service
В предыдущем дизайне мы обновляли данные в реальном времени при каждом вводе query. На практике это плохо по двум причинам:
-
Пользователи могут вводить миллиарды queries в день. Обновление trie на каждый запрос сильно замедлит query service.
-
После того как trie построена, top suggestions обычно меняются не так уж часто, поэтому нет смысла обновлять trie слишком часто.
Чтобы спроектировать масштабируемый data gathering service, нужно понять, откуда приходят данные и как они используются. Для real-time приложений вроде Twitter действительно важны самые свежие autocomplete suggestions. Но для многих Google queries они могут практически не меняться в течение дня.
Несмотря на различия в use case, базовая схема data gathering service остается похожей, потому что данные для построения trie обычно поступают из analytics или logging service.
На рисунке 9 показан переработанный data gathering service. Разберем его компоненты по очереди.

Рисунок 9
Analytics Logs. Здесь хранится сырые данные о search queries. Логи append-only и не индексируются. В таблице 3 показан пример log file.
| query | time |
|---|---|
| tree | 2019-10-01 22:01:01 |
| try | 2019-10-01 22:01:05 |
| tree | 2019-10-01 22:01:30 |
| toy | 2019-10-01 22:02:22 |
| tree | 2019-10-02 22:02:42 |
| try | 2019-10-03 22:03:03 |
Таблица 3
Aggregators. Размер analytics logs обычно очень большой, и данные в них не в том формате, который удобно использовать системе. Поэтому данные нужно агрегировать.
В зависимости от use case агрегирование может быть разным. Для real-time приложений вроде Twitter данные агрегируют на коротких интервалах, потому что real-time results важны. Для многих других случаев достаточно, например, weekly aggregation. Во время интервью стоит уточнить, насколько важны real-time results. Мы будем считать, что trie перестраивается раз в неделю.
Aggregated Data
В таблице 4 показан пример weekly aggregated data. Поле time — это начало недели. Поле
frequency — сумма occurrences соответствующего query за эту неделю.
| query | time | frequency |
|---|---|---|
| tree | 2019-10-01 | 12000 |
| tree | 2019-10-08 | 15000 |
| tree | 2019-10-15 | 9000 |
| toy | 2019-10-01 | 8500 |
| toy | 2019-10-08 | 6256 |
| toy | 2019-10-15 | 8866 |
Таблица 4
Workers. Workers — это набор серверов, выполняющих асинхронные jobs по расписанию. Они строят trie data structure и сохраняют ее в Trie DB.
Trie Cache. Trie Cache — это distributed cache system, которая держит trie в памяти для быстрого чтения. Она получает weekly snapshot из DB.
Trie DB. Trie DB — это persistent storage. Есть два варианта хранения:
-
Document store: поскольку новая trie строится раз в неделю, мы можем периодически снимать с нее snapshot, сериализовать его и сохранять в базе данных. Document stores вроде MongoDB [4] хорошо подходят для сериализованных данных.
-
Key-value store: trie можно представить в виде hash table [4], если использовать такую логику:
-
Каждый prefix в trie отображается в key в hash table.
-
Данные каждого trie node отображаются в value в hash table.
На рисунке 10 показано соответствие между trie и hash table.

Рисунок 10
На рисунке 10 каждый trie node слева отображается в пару <key, value> справа. Если не очень ясно, как работают key-value stores, можно освежить главу про проектирование key-value store.
Query service
В high-level design query service ходил прямо в database за top 5 results. На рисунке 11 показан улучшенный вариант, потому что прежний был неэффективен.
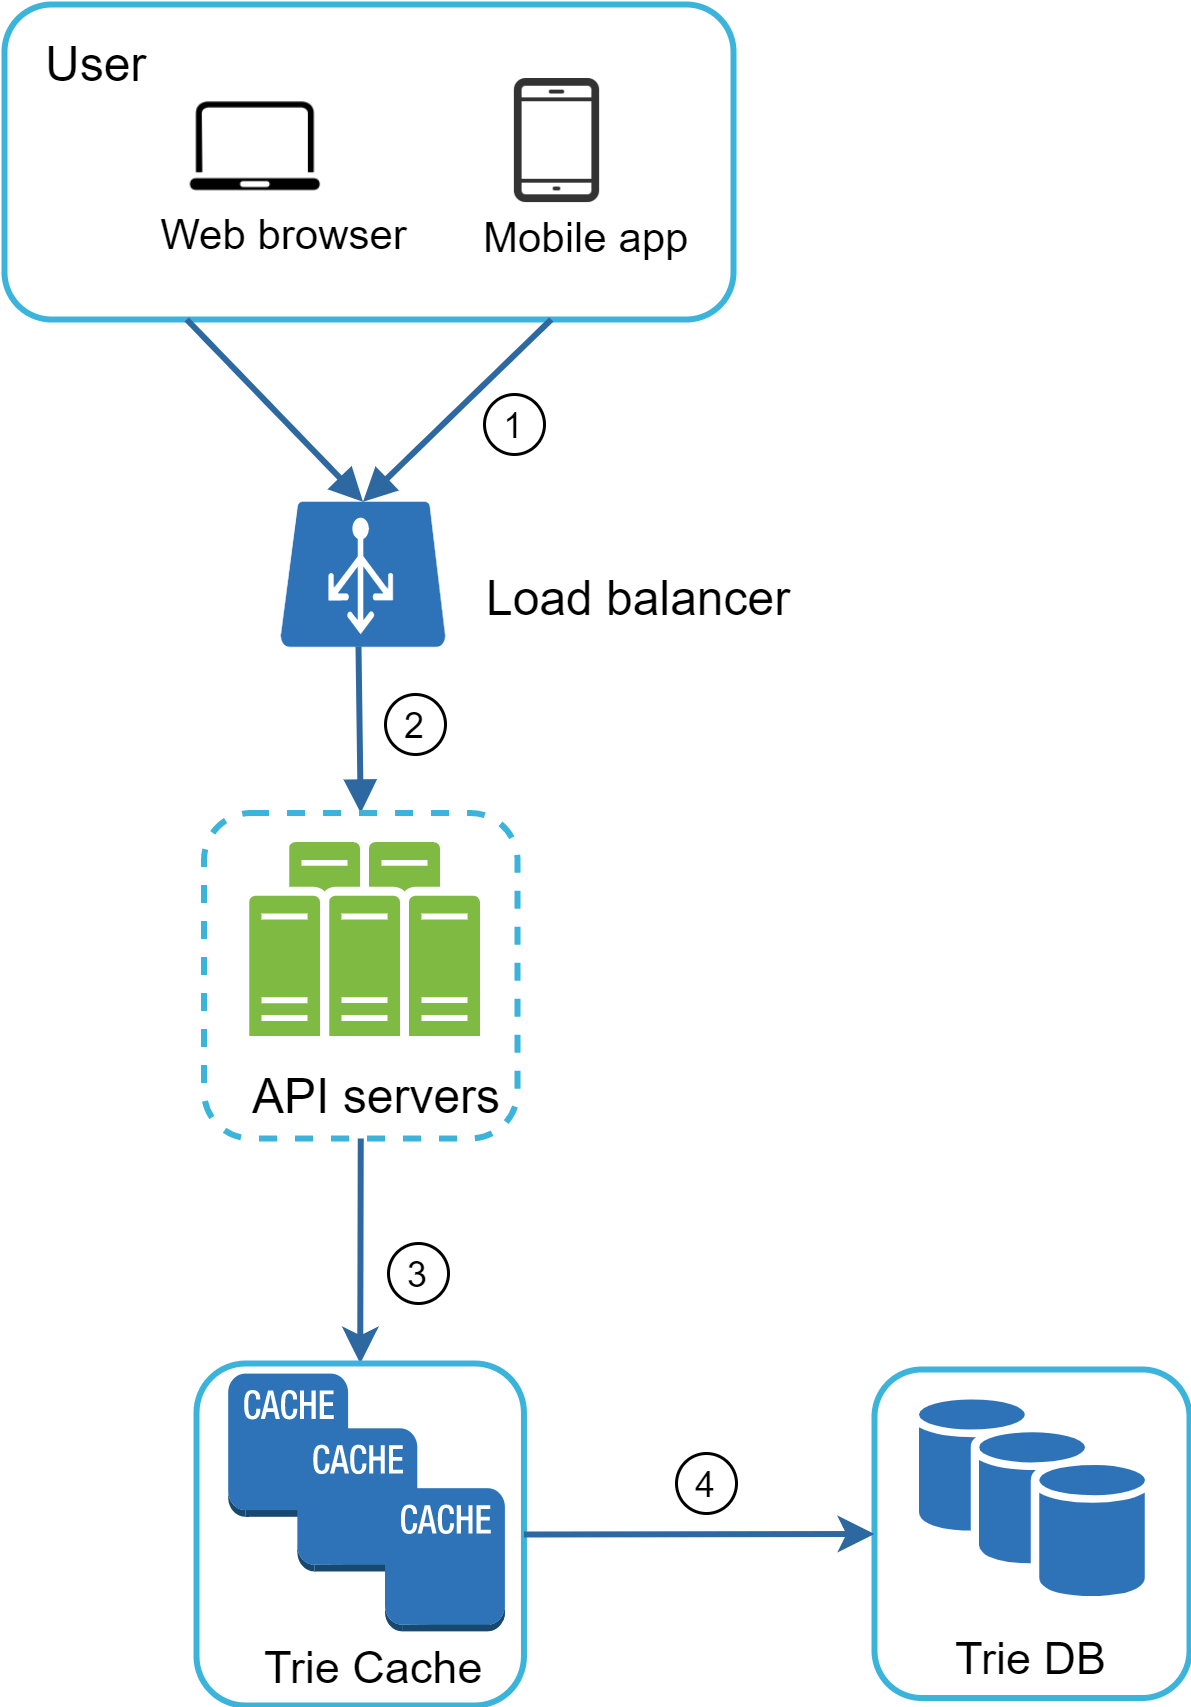
Рисунок 11
-
Search query приходит на load balancer.
-
Load balancer маршрутизирует запрос на API servers.
-
API servers получают trie data из Trie Cache и строят autocomplete suggestions для клиента.
-
Если данных нет в Trie Cache, они дочитываются из DB и возвращаются обратно в cache, чтобы последующие запросы по тому же prefix обслуживались уже оттуда. Cache miss возможен, если cache server вышел из памяти или отключился.
Query service должна работать молниеносно. Поэтому мы предлагаем такие оптимизации:
-
AJAX request. Для web applications браузеры обычно посылают AJAX-запросы за autocomplete results. Главное преимущество AJAX в том, что отправка и получение request/response не требует перезагружать всю web page.
-
Browser caching. Во многих приложениях autocomplete suggestions в течение короткого времени почти не меняются. Поэтому их можно кэшировать прямо в браузере и обслуживать повторные запросы непосредственно из browser cache. Google search использует такой же механизм. На рисунке 12 показан response header, который виден, если набрать
system design interviewв Google. Как видно, Google кэширует результат в браузере на 1 час. Отметкаprivateвcache-controlозначает, что результат предназначен для одного пользователя и не должен кэшироваться shared cache.max-age=3600означает, что кэш действителен 3600 секунд, то есть 1 час.
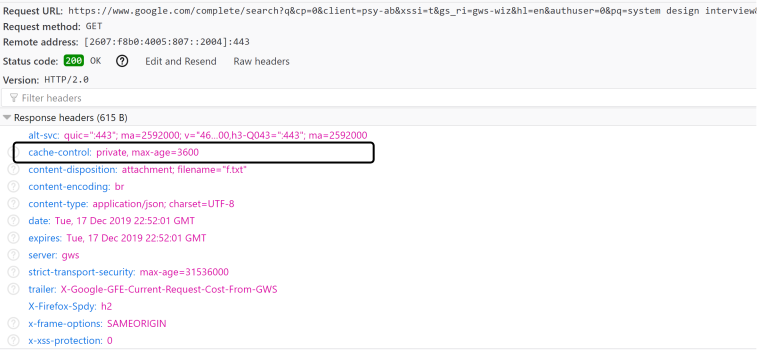
Рисунок 12
- Data sampling. В large-scale system логирование каждого search query требует много CPU и storage. Поэтому data sampling важен. Например, система может логировать только 1 из каждых N запросов.
Операции над trie
Trie — центральный компонент autocomplete system. Посмотрим, как работают операции create,
update и delete.
Create
Trie создается workers на основе aggregated data. Источником данных служат Analytics Log/DB.
Update
Есть два способа обновления trie.
Вариант 1: перестраивать trie еженедельно. Как только новая trie готова, она заменяет старую.
Вариант 2: обновлять отдельные trie nodes напрямую. Мы стараемся избегать этой операции, потому
что она медленная. Однако если trie небольшая, это приемлемый подход. Когда обновляется один trie
node, нужно обновить и всех его ancestors вплоть до root, потому что в ancestors хранятся top
queries их children. На рисунке 13 показан пример такого update. Слева у search query beer
исходное значение 10, справа оно обновлено до 30. Как видно, и сам node, и его ancestors получают
обновленное значение beer:30.

Рисунок 13
Delete
Из autocomplete нужно удалять hateful, violent, sexually explicit и other dangerous suggestions. Для этого перед Trie Cache добавляется filter layer, показанный на рисунке 14. Filter layer дает гибкость: можно убирать результаты по различным правилам фильтрации. Нежелательные suggestions асинхронно удаляются из database, чтобы в следующем цикле построения trie использовался уже очищенный data set.
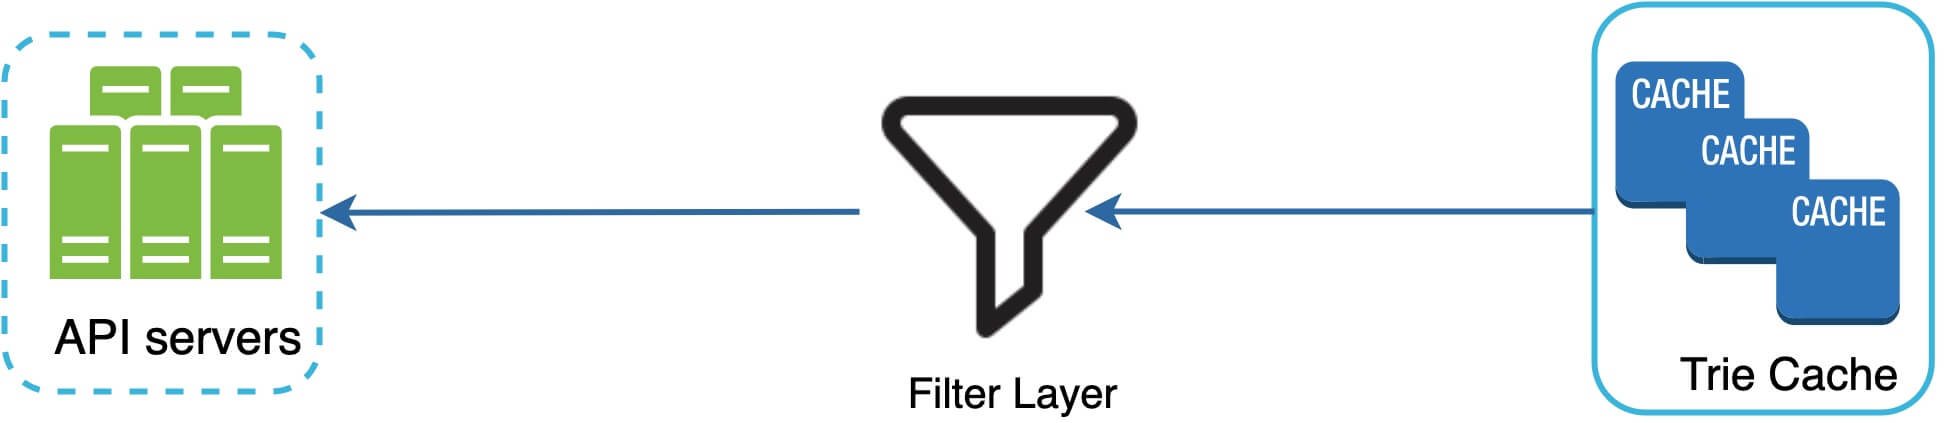
Рисунок 14
Масштабирование storage
Теперь, когда у нас есть working autocomplete system, нужно решить проблему масштабирования, когда trie становится слишком большой для одного сервера.
Поскольку поддерживается только английский язык, наивный способ sharding — делить данные по первой букве. Например:
-
Если нужны два сервера, можно хранить queries с
aпоmна первом сервере, а сnпоz— на втором. -
Если нужны три сервера, можно разбить диапазоны как
a-i,j-rиs-z.
Такой логикой можно дойти максимум до 26 серверов, потому что в английском алфавите 26 букв.
Назовем такое разбиение first-level sharding. Чтобы использовать больше 26 серверов, можно
шардировать по второй или даже третьей букве. Например, запросы, начинающиеся с a, можно
разбить на 4 сервера: aa-ag, ah-an, ao-au, av-az.
На первый взгляд это разумно, пока не выясняется, что слов на c гораздо больше, чем на x.
Из-за этого возникает перекос распределения.
Чтобы смягчить data imbalance, можно анализировать историческое распределение данных и применять
более умную sharding logic, как показано на рисунке 15. Shard map manager поддерживает lookup
database и знает, где должна лежать каждая строка. Например, если исторически запросов на s
примерно столько же, сколько на u, v, w, x, y, z вместе, можно завести два shard:
один под s, второй под u-z.

Рисунок 15
Шаг 4 — Подведем итоги
После deep dive интервьюер может задать несколько follow-up вопросов.
Интервьюер: Как расширить дизайн для поддержки нескольких языков?
Чтобы поддерживать неанглийские queries, можно хранить в trie nodes Unicode-символы. Если напоминание нужно: Unicode — это стандарт кодирования, покрывающий символы почти всех письменных систем мира [5].
Интервьюер: Что если top search queries в одной стране отличаются от другой?
В этом случае можно строить отдельные tries для разных стран. Чтобы улучшить response time, такие tries можно хранить в CDN.
Интервьюер: Как поддержать trending real-time search queries?
Если внезапно происходит важное news event и какой-то search query резко становится популярным, наш исходный дизайн уже не подходит, потому что:
-
Offline workers еще не запустили обновление trie, так как оно идет по weekly schedule.
-
Даже если запустить их внепланово, перестройка trie занимает слишком много времени.
Построение real-time autocomplete — сложная тема и выходит за рамки этой книги, поэтому здесь приведем только несколько идей:
-
Уменьшать working data set за счет sharding.
-
Изменить ranking model и сильнее взвешивать недавние search queries.
-
Данные могут приходить как streams, и тогда у нас нет доступа ко всему data set сразу. Stream processing требует другого класса систем: Apache Hadoop MapReduce [6], Apache Spark Streaming [7], Apache Storm [8], Apache Kafka [9] и т. д. Эти темы требуют отдельной предметной подготовки, поэтому здесь в детали не углубляемся.
Поздравляем, вы дошли до этого места! Можно похлопать себя по плечу. Отличная работа!
Справочные материалы
[1] The Life of a Typeahead Query:
https://www.facebook.com/notes/facebook-engineering/the-life-of-a-typeahead-query/389105248919/
[2] How We Built Prefixy: A Scalable Prefix Search Service for Powering Autocomplete:
https://medium.com/@prefixyteam/how-we-built-prefixy-a-scalable-prefix-search-service-for-powering-autocomplete-c20f98e2eff1
[3] Prefix Hash Tree An Indexing Data Structure over Distributed Hash Tables:
https://people.eecs.berkeley.edu/~sylvia/papers/pht.pdf
[4] MongoDB wikipedia:
https://en.wikipedia.org/wiki/MongoDB
[5] Unicode frequently asked questions:
https://www.unicode.org/faq/basic_q.html
[6] Apache hadoop: https://hadoop.apache.org/
[7] Spark streaming: https://spark.apache.org/streaming/
[8] Apache storm: https://storm.apache.org/
[9] Apache kafka: https://kafka.apache.org/documentation/