Google Maps
В этой главе мы проектируем упрощенную версию Google Maps. Прежде чем переходить к system design, полезно немного вспомнить, что такое Google Maps. Google запустила Project Google Maps в 2005 году и разработала web mapping service. Он предоставляет множество возможностей: спутниковые снимки, street maps, информацию о трафике в real time и планирование маршрутов [1].
Google Maps помогает пользователям строить маршрут и добираться до места назначения. По состоянию на март 2021 года у Google Maps был 1 миллиард daily active users, покрытие 99% поверхности мира и 25 миллионов ежедневных обновлений точной location information в real time [2]. Из-за огромной сложности Google Maps важно заранее определить, какие именно функции будет поддерживать наша версия. Обратите внимание: map tiles в этой главе взяты у Stamen Design [3], а данные — из OpenStreetMap [4].
Шаг 1 — Понять задачу и определить рамки дизайна
Диалог между интервьюером и кандидатом может выглядеть так:
Кандидат: Какое количество daily active users мы ожидаем?
Интервьюер: 1 миллиард DAU.
Кандидат: На каких функциях нужно сфокусироваться? Направления, навигация и estimated time of
arrival (ETA)?
Интервьюер: Давайте сосредоточимся на location update, navigation, ETA и map rendering.
Кандидат: Насколько велики road data? Можем ли мы предположить, что у нас уже есть к ним
доступ?
Интервьюер: Отличные вопросы. Да, предположим, что мы получили road data из разных источников.
Это терабайты (TBs) сырых данных.
Кандидат: Должна ли система учитывать traffic conditions?
Интервьюер: Да, traffic conditions очень важны для точной оценки времени.
Кандидат: А как насчет разных travel modes — driving, walking, bus и т. д.?
Интервьюер: Мы должны уметь поддерживать разные способы перемещения.
Кандидат: Нужна ли поддержка multi-stop directions?
Интервьюер: Хорошо бы дать пользователю возможность задавать несколько остановок, но не будем
на этом фокусироваться.
Кандидат: А как насчет business places и фотографий? Какого масштаба мы ожидаем по фото?
Интервьюер: Рад, что вы об этом подумали. Это проектировать не нужно.
В остальной части главы мы фокусируемся на трех ключевых возможностях. Основные устройства, которые нужно поддерживать, — мобильные телефоны.
-
Обновление местоположения пользователя.
-
Навигационный сервис, включая ETA service.
-
Отрисовка карты.
Нефункциональные требования и ограничения
-
Точность: пользователю нельзя давать неверные указания.
-
Плавная навигация: на клиенте пользователь должен видеть очень плавную отрисовку карты.
-
Расход данных и батареи: клиент должен использовать как можно меньше трафика и заряда. Для мобильных устройств это очень важно.
-
Общие требования по availability и scalability.
Прежде чем переходить к дизайну, коротко введем несколько базовых понятий и терминов, полезных для проектирования Google Maps.
Map 101
Positioning system
Мир — это сфера, вращающаяся вокруг своей оси. В самой верхней точке находится north pole, в самой нижней — south pole.
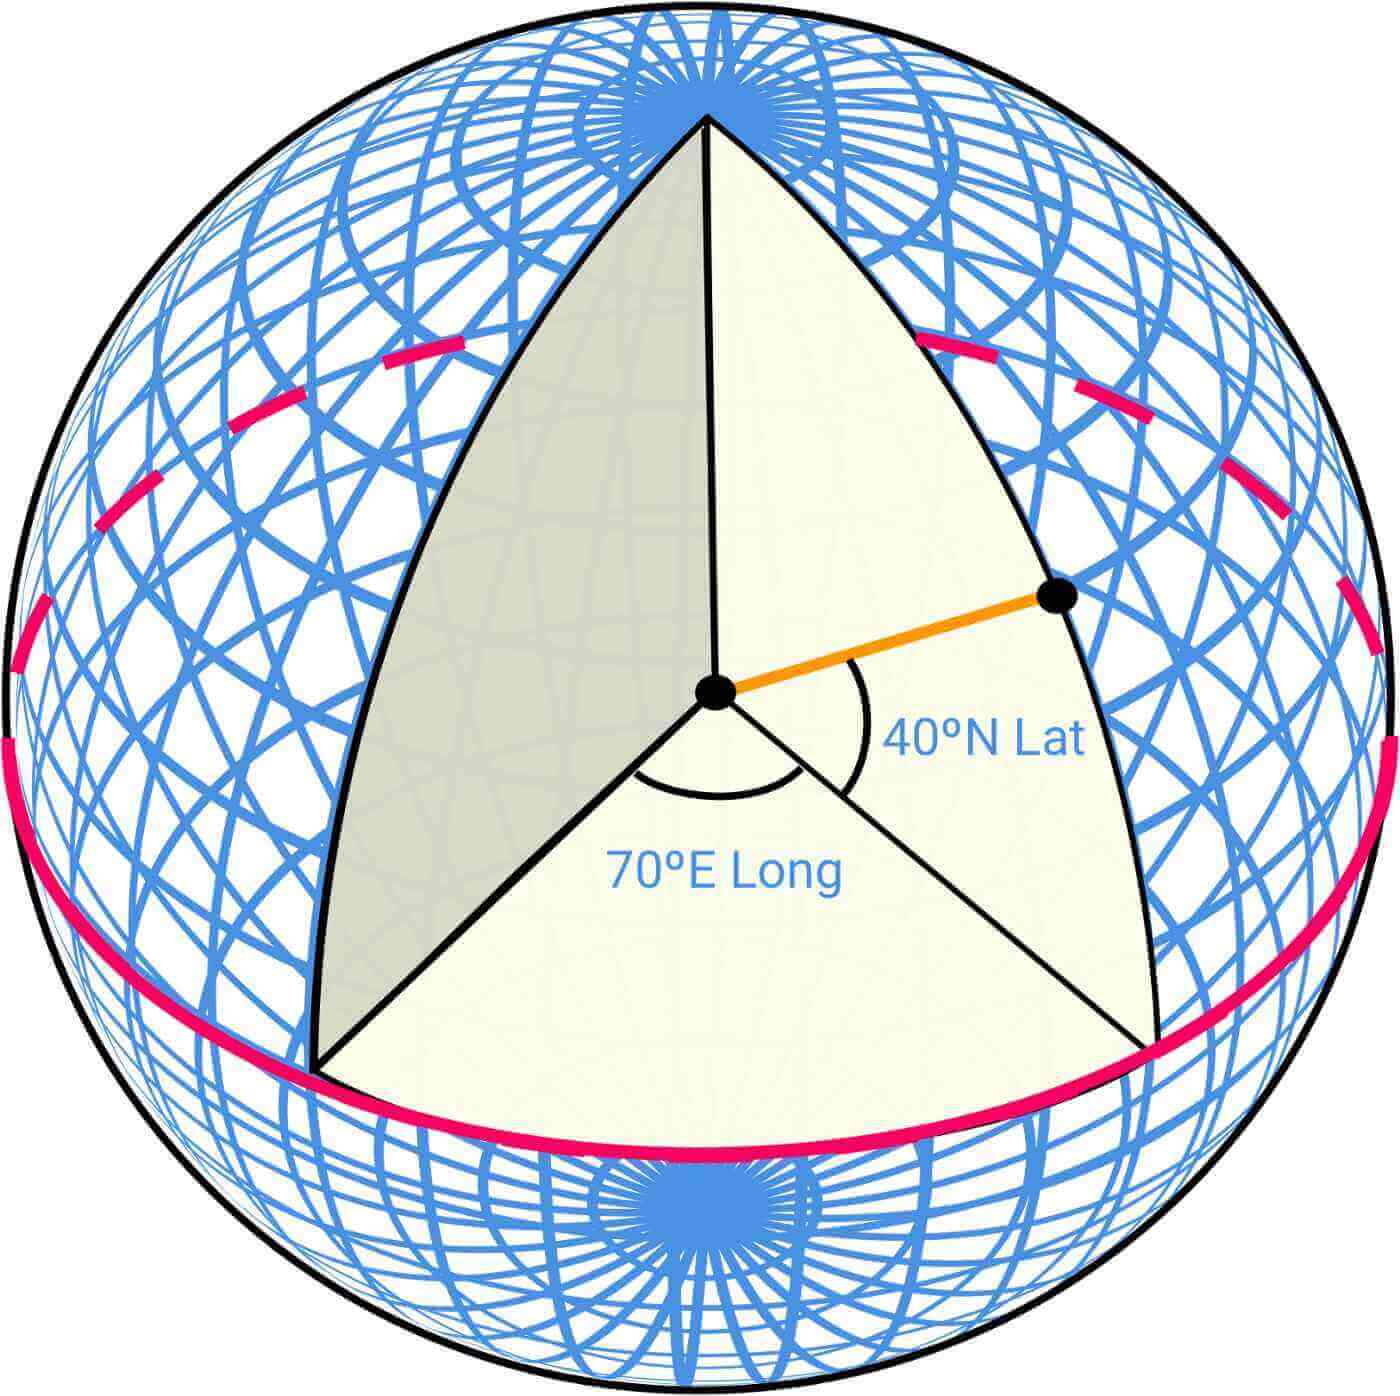
Рисунок 1 Latitude и Longitude (источник: [5])
Lat (Latitude): показывает, насколько мы находимся севернее или южнее.
Long (Longitude): показывает, насколько мы находимся восточнее или западнее.
Переход от 3D к 2D
Процесс переноса точек с трехмерного глобуса на двумерную плоскость называется Map Projection.
Существует несколько способов map projection, и у каждого есть свои сильные стороны и ограничения. Почти все они искажают реальную геометрию. Ниже показаны несколько примеров.
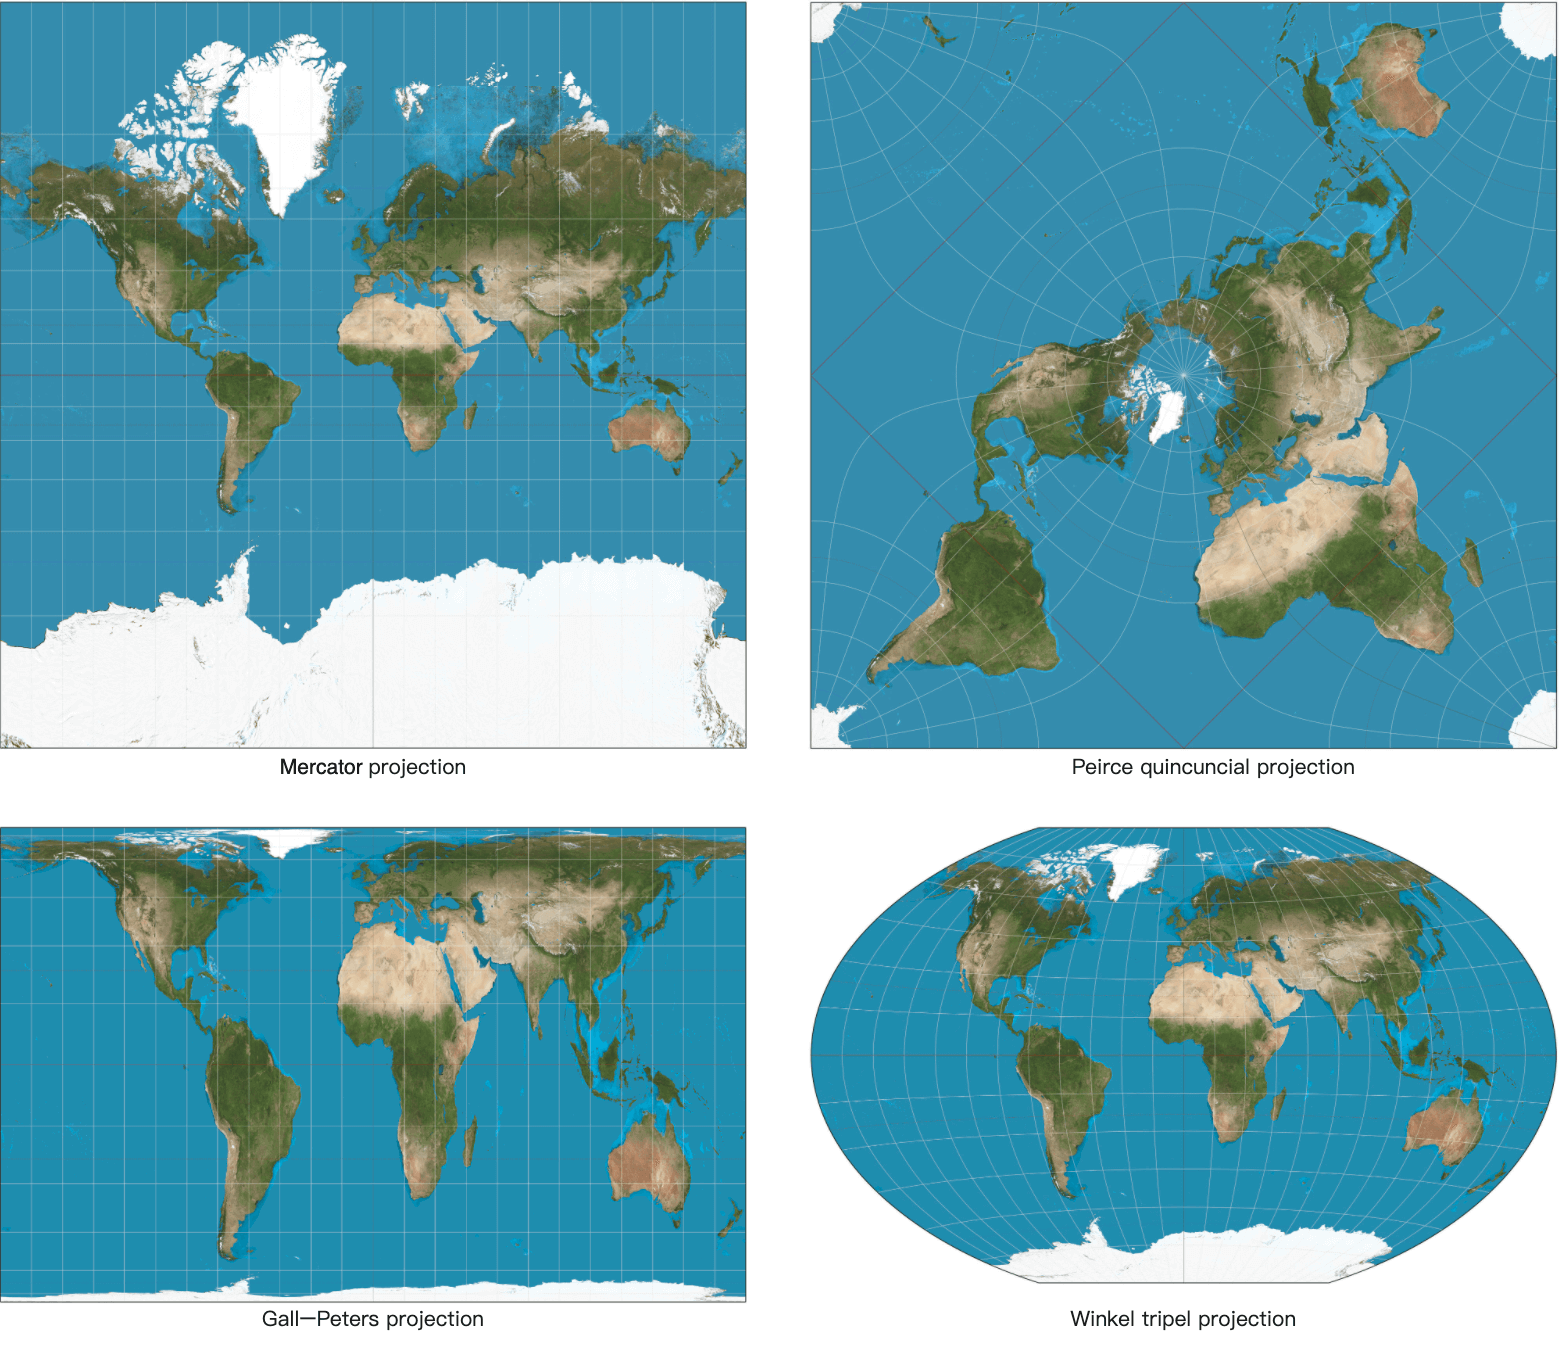
Рисунок 2 Map projections (источник: Wikipedia [6] [7] [8] [9])
Google Maps выбрал модифицированную версию Mercator projection под названием Web Mercator. Подробнее о positioning systems и projections можно почитать в [5].
Geocoding
Geocoding — это процесс преобразования адресов в географические координаты. Например,
1600 Amphitheatre Parkway, Mountain View, CA преобразуется в пару latitude/longitude
(latitude 37.423021, longitude -122.083739).
Обратное преобразование — от latitude/longitude к читаемому человеком адресу — называется reverse geocoding.
Один из способов geocode — interpolation [10]. Этот метод использует данные из разных источников, например geographic information systems (GIS), где street network уже отображена в пространство географических координат.
Geohashing
Geohashing — это система кодирования, которая представляет географическую область короткой строкой из букв и цифр. В основе лежит представление Земли как развернутой поверхности, которая рекурсивно делится на sub-grid, квадратные или прямоугольные. Каждую grid мы представляем строкой из чисел от 0 до 3, формируемой рекурсивно.
Предположим, что начальная развернутая поверхность имеет размер 20,000 km * 10,000 km. После
первого деления получим 4 grid размером 10,000 km * 5,000 km. Мы обозначим их как 00, 01,
10 и 11, как показано на рисунке 3. Затем делим каждую grid еще на 4 и используем ту же
стратегию именования. Теперь каждая sub-grid имеет размер 5,000 km * 2,500 km. Мы продолжаем
рекурсивно делить grids, пока каждая grid не достигнет заданного порога размера.
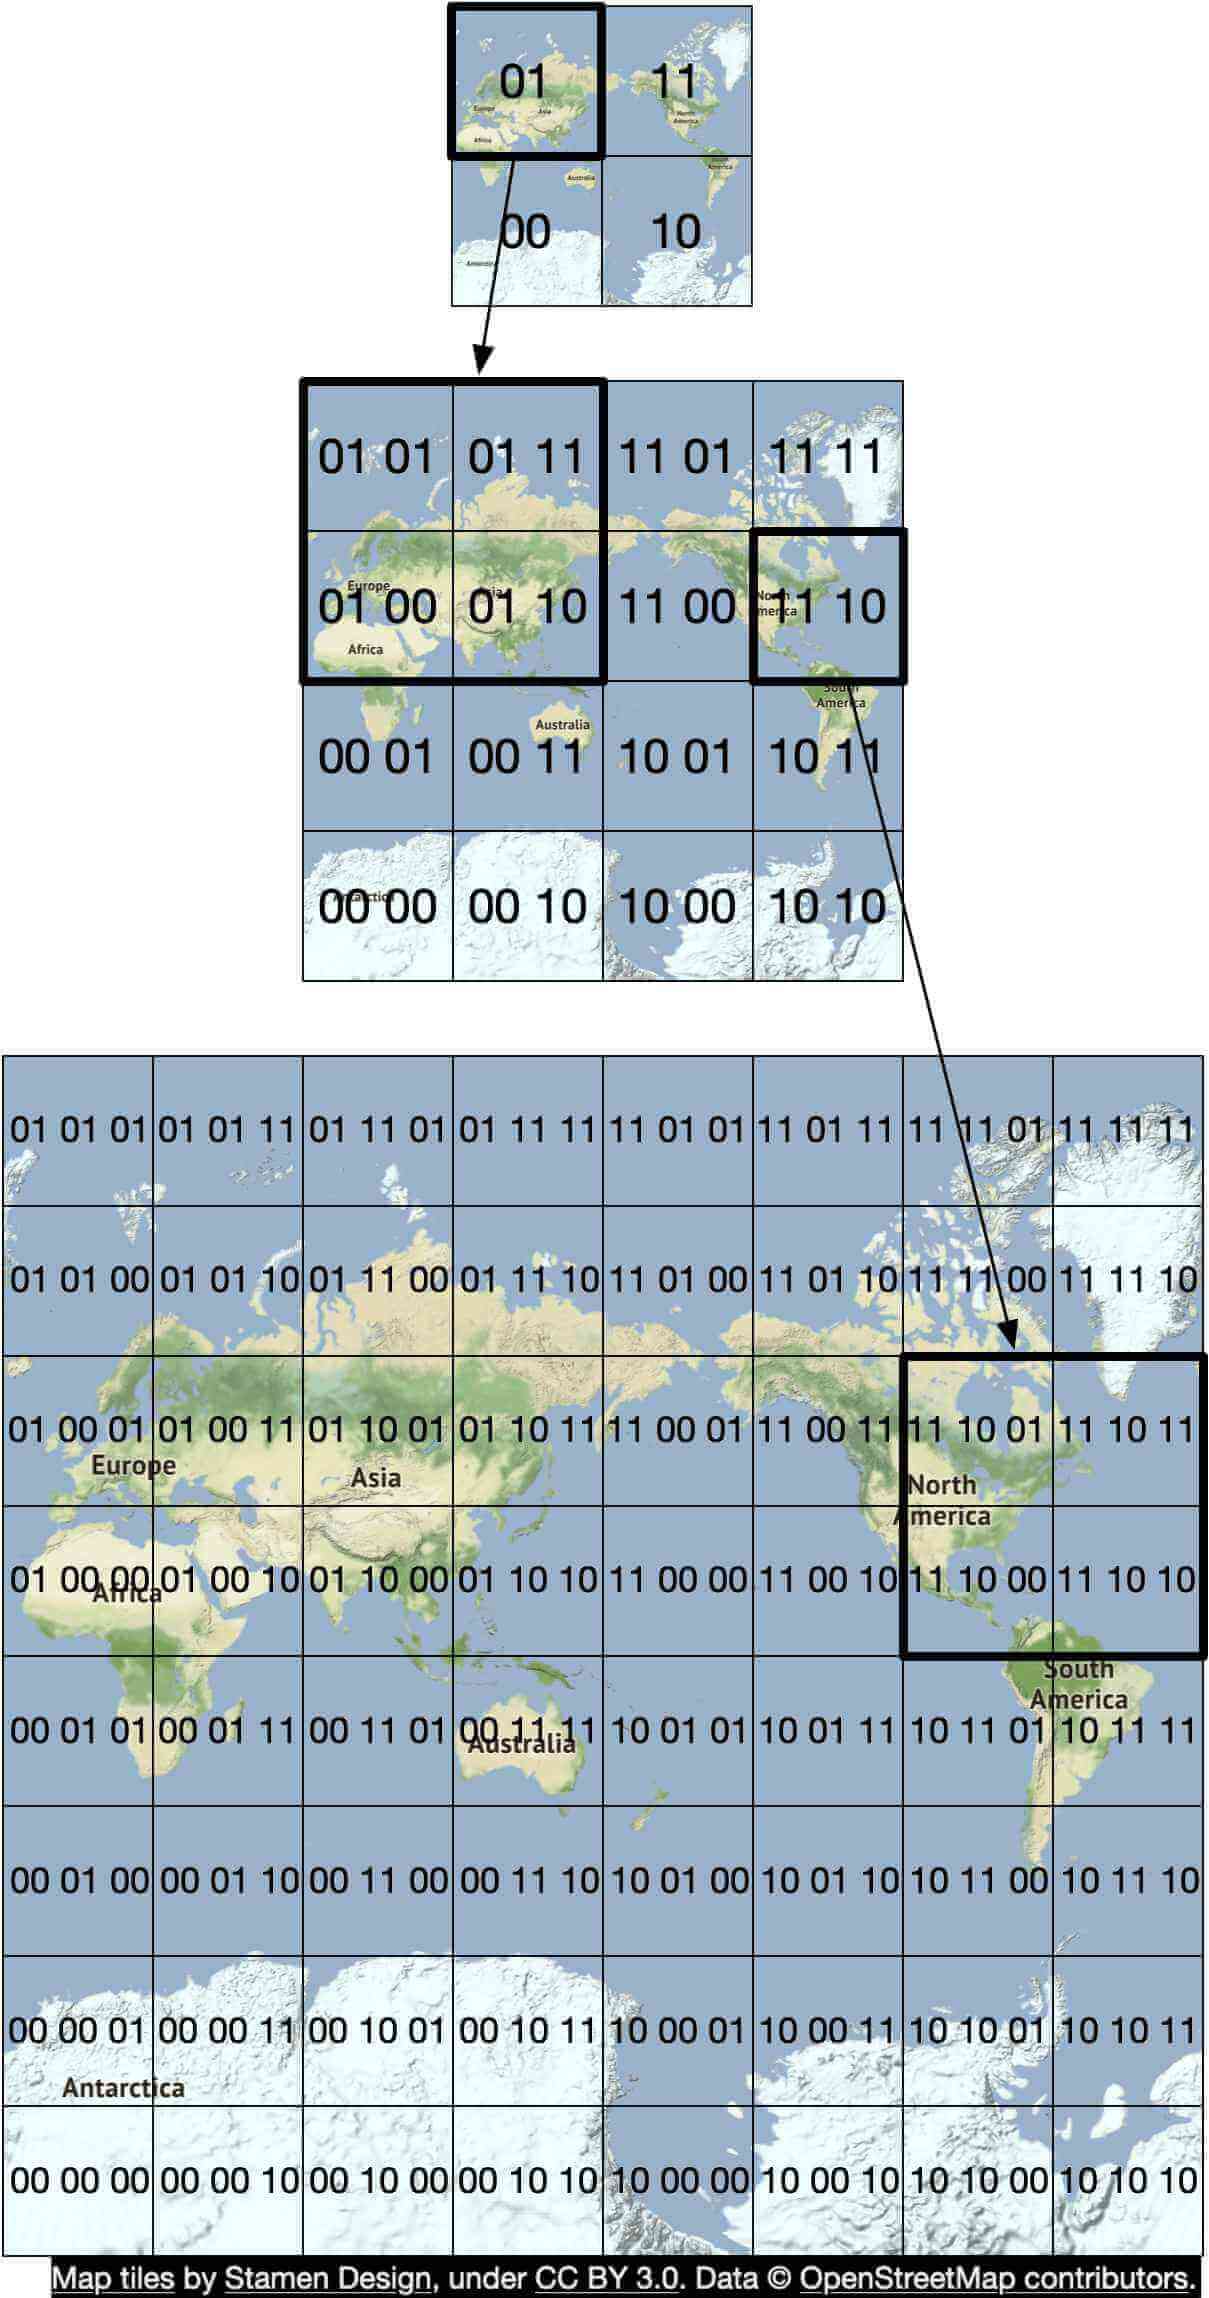
Рисунок 3 Geohashing
У geohashing много применений. В нашем дизайне мы используем geohashing для map tiling. Подробнее о geohashing и его преимуществах см. [11].
Map rendering
Мы не будем глубоко погружаться в map rendering, но базовые идеи стоит упомянуть. Один из фундаментальных концептов — tiling. Вместо того чтобы рендерить всю карту как одно большое кастомное изображение, мир разбивается на более мелкие tiles. Клиент загружает только нужные tile для области, где находится пользователь, и сшивает их как мозаики.
Для каждого zoom level существует свой набор tiles. Клиент выбирает тот набор, который подходит
к zoom level текущего viewport. Это дает нужную детализацию без лишнего расхода bandwidth.
Чтобы привести крайний пример: если клиент максимально отдалил карту и показывает весь мир, нам
не хотелось бы загружать сотни тысяч tiles для очень высокого zoom level — вся эта детализация
пропадет зря. Вместо этого клиент загрузит один tile на самом низком zoom level, который
представляет весь мир одной картинкой 256x256 пикселей.
Обработка road data для navigation algorithms
Большинство routing algorithms — это вариации алгоритмов поиска пути Дейкстры или A*. Точный выбор алгоритма — отдельная сложная тема, и мы не будем подробно останавливаться на ней в этой главе. Важно другое: все эти алгоритмы работают на graph data structure, где intersections — это nodes, а roads — edges графа. Пример показан на рисунке 4.
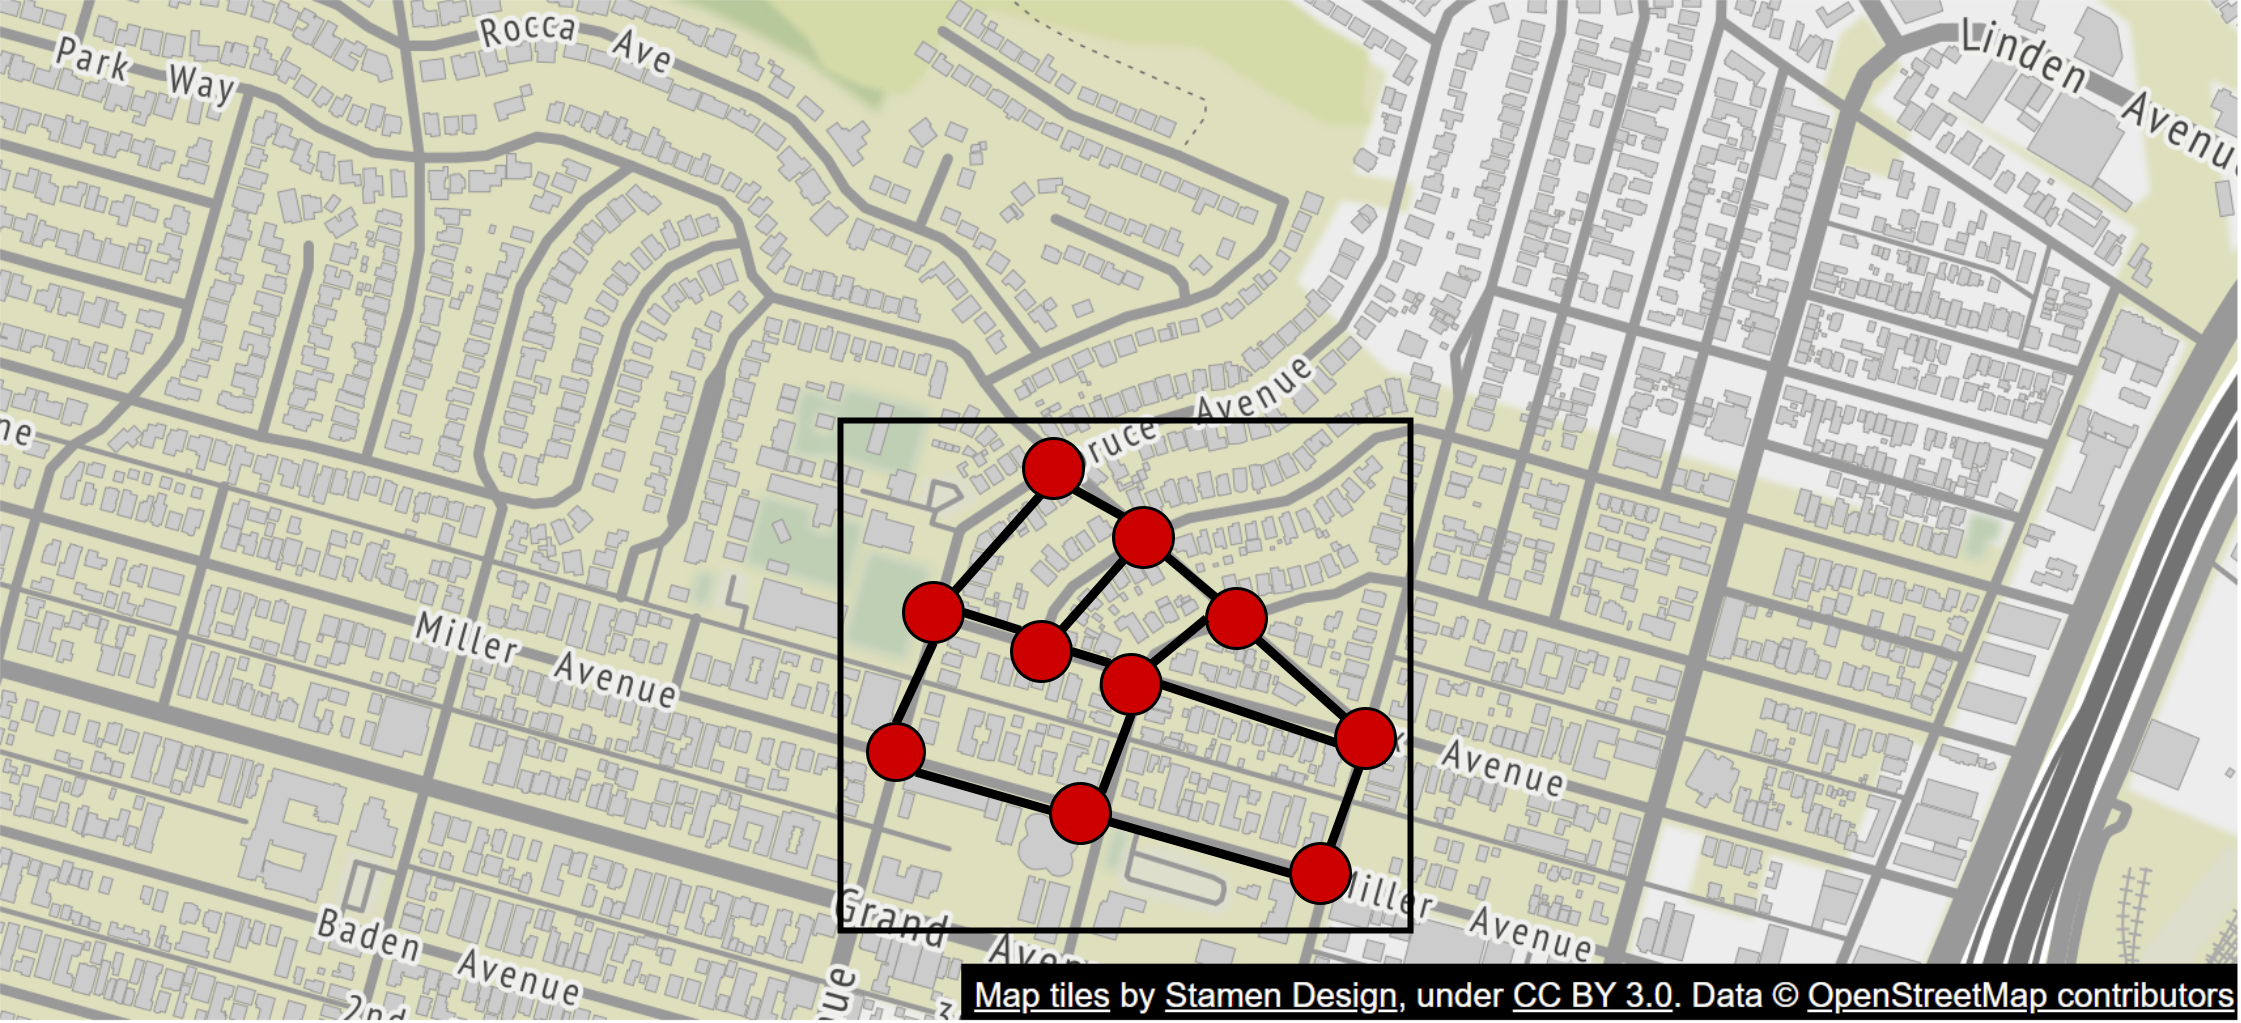
Рисунок 4 Карта как graph
Производительность pathfinding у большинства таких алгоритмов очень чувствительна к размеру графа. Если представить все road networks мира как один граф, он займет слишком много памяти, и ни один из этих алгоритмов, скорее всего, не будет работать эффективно. Graph нужно разбивать на управляемые части.
Один из способов разбить глобальную road network очень похож на tiling из map rendering. Используя
похожую subdivision technique, как и в geohashing, мы делим мир на маленькие grids. Для каждой
grid преобразуем дороги внутри нее в небольшой graph data structure, состоящий из nodes
(intersections) и edges (roads) внутри географической области, покрываемой grid. Мы называем
такие grids routing tiles. Каждый routing tile содержит ссылки на все другие tiles, с которыми
он соединен. Так routing algorithms могут собирать более крупный road graph по мере обхода этих
взаимосвязанных routing tiles.
Разбив road networks на routing tiles, которые можно загружать по требованию, routing algorithms могут существенно снизить расход памяти и улучшить pathfinding performance, потому что в каждый момент времени им нужен только небольшой поднабор routing tiles, а дополнительные tiles загружаются только при необходимости.

Рисунок 5 Routing tiles
| Напоминание |
|---|
| В рисунке 5 мы называем эти grids routing tiles. Routing tiles похожи на map tiles тем, что и те и другие покрывают определенные географические области. Разница в том, что map tiles — это PNG-изображения, а routing tiles — бинарные файлы с road data для соответствующей области. |
Иерархические routing tiles
Для эффективной навигации нужны road data с правильной детализацией. Например, для маршрута через
всю страну было бы слишком медленно запускать routing algorithm на очень подробном наборе
street-level routing tiles. Граф, собранный из таких детальных routing tiles, оказался бы слишком
большим и затратным по памяти.
Обычно есть три набора routing tiles с разным уровнем детализации. На самом детальном уровне tiles маленькие и содержат только local roads. На следующем уровне tiles крупнее и содержат только arterial roads, соединяющие районы. На самом грубом уровне tiles покрывают большие области и содержат только major highways, соединяющие города и штаты. На каждом уровне могут существовать edges, ведущие к tiles другого zoom level. Например, для съезда с local street A на freeway F будет ссылка от node (street A) в маленьком tile к node (freeway F) в большом tile. Пример routing tiles разного размера показан на рисунке 6.
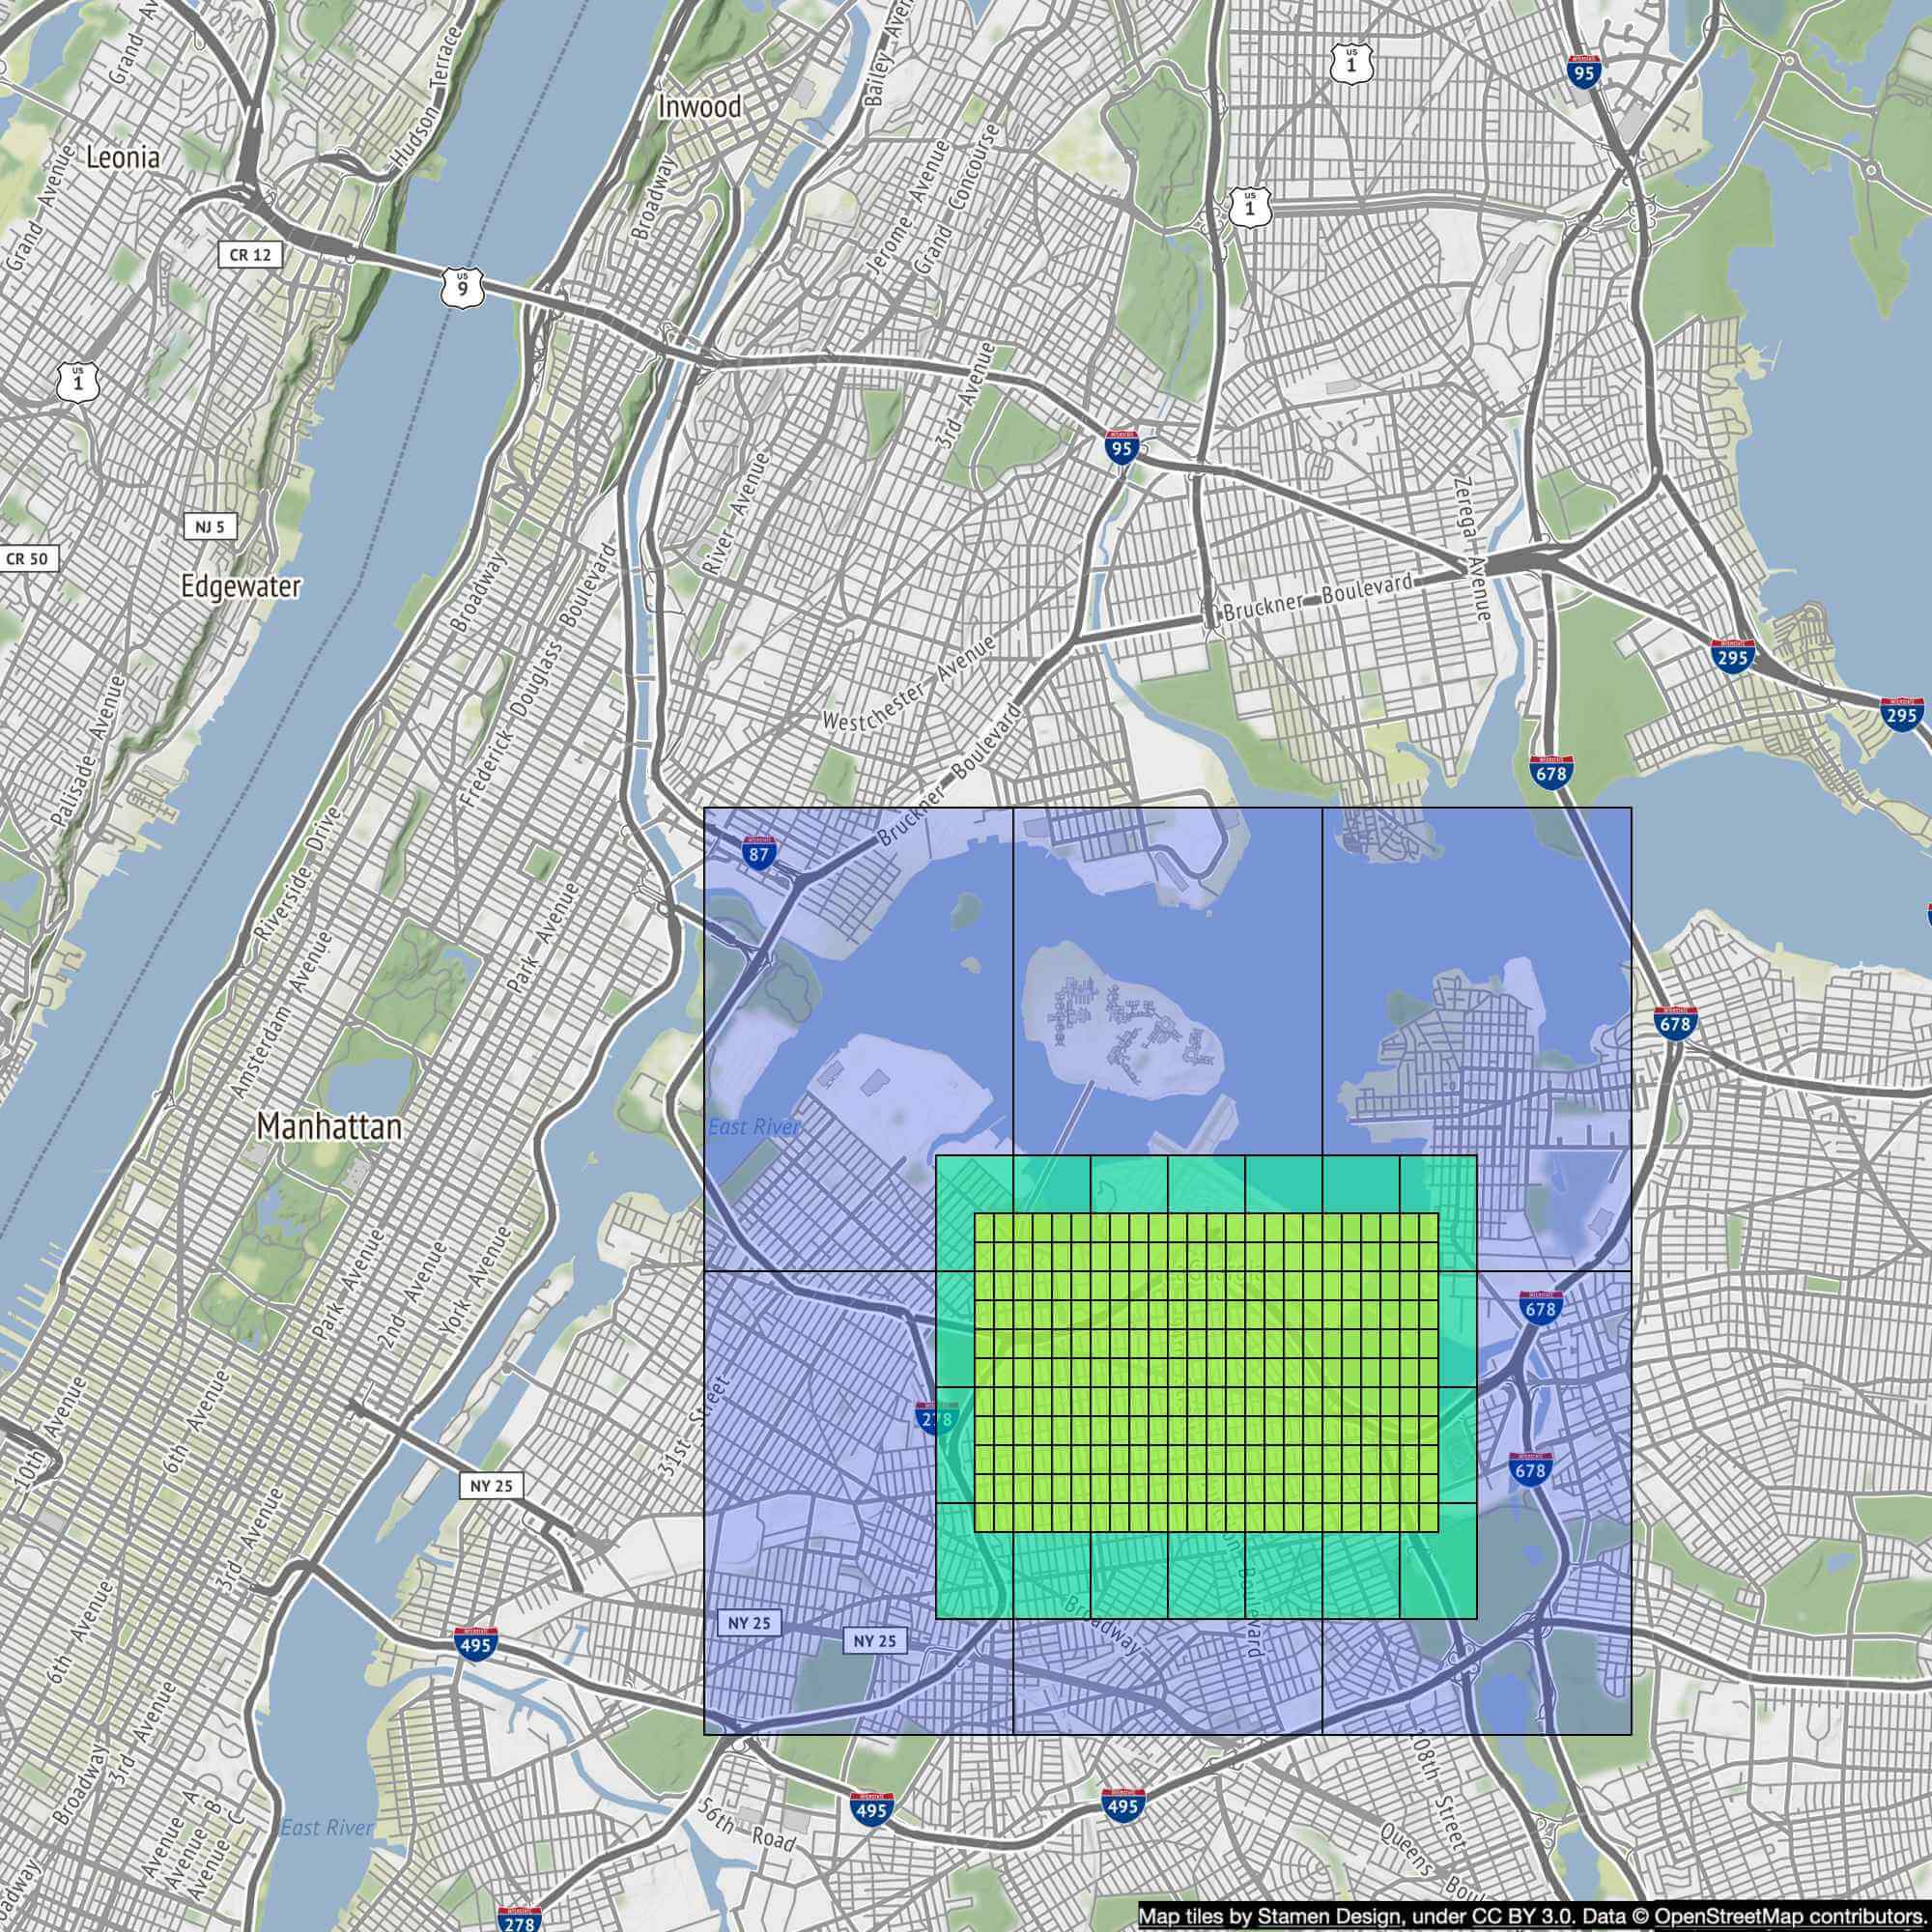
Рисунок 6 Routing tiles разных размеров
Оценка на салфетке
Теперь, когда мы понимаем базовые идеи, сделаем rough estimation. Поскольку фокус дизайна — mobile, использование данных и батареи особенно важно.
Прежде чем считать, вот несколько преобразований метрических и имперских единиц:
-
1 foot = 0.3048 meters
-
1 kilometer (km) = 0.6214 miles
-
1 km = 1,000 meters
Storage usage
Нам нужно хранить три типа данных.
-
Карту мира: ниже приведен более подробный расчет.
-
Metadata: поскольку metadata для каждого map tile может быть пренебрежимо мала, мы ее не учитываем.
-
Road info: интервьюер сказал, что есть терабайты road data из внешних источников. Мы преобразуем этот dataset в routing tiles, которые тоже, скорее всего, будут занимать терабайты.
Карта мира
В разделе Map 101 мы уже обсуждали map tiling. Для каждого zoom level существует свой набор map
tiles. Чтобы понять требования к хранению всей коллекции map tile images, полезно сначала оценить
размер самого большого набора — на максимальном zoom level. На zoom level 21 существует около
4.3 триллиона tiles (таблица 1). Предположим, что каждый tile — это сжатое PNG-изображение
256 * 256 пикселей размером примерно 100 KB. Тогда весь набор на максимальном zoom level
потребует около 4.4 триллиона * 100 KB = 440 PB.
В таблице 1 показан рост числа tiles на каждом zoom level.
| Zoom | Число tiles |
|---|---|
| 0 | 1 |
| 1 | 4 |
| 2 | 16 |
| 3 | 64 |
| 4 | 256 |
| 5 | 1 024 |
| 6 | 4 096 |
| 7 | 16 384 |
| 8 | 65 536 |
| 9 | 262 144 |
| 10 | 1 048 576 |
| 11 | 4 194 304 |
| 12 | 16 777 216 |
| 13 | 67 108 864 |
| 14 | 268 435 456 |
| 15 | 1 073 741 824 |
| 16 | 4 294 967 296 |
| 17 | 17 179 869 184 |
| 18 | 68 719 476 736 |
| 19 | 274 877 906 944 |
| 20 | 1 099 511 627 776 |
| 21 | 4 398 046 511 104 |
Таблица 1. Zoom levels
Однако важно помнить, что около 90% поверхности мира — это природа и в основном необитаемые зоны
вроде океанов, пустынь, озер и гор. Такие области очень хорошо сжимаются как изображения, поэтому
мы можем консервативно уменьшить оценку хранения на 80–90%. Тогда размер хранения снизится до
диапазона 44–88 PB. Возьмем круглое число 50 PB.
Теперь оценим, сколько займут последующие, более низкие zoom levels. На каждом более низком zoom
level число tiles в направлениях north-south и east-west уменьшается вдвое. Это дает общее
уменьшение числа tiles в 4 раза, а значит, и объема хранения тоже в 4 раза. Тогда общий размер —
это ряд: 50 + 50/4 + 50/16 + 50/64 + ... = ~67 PB. Это грубая оценка. Нам достаточно понимать,
что на хранение всех map tiles разных уровней детализации потребуется порядка 100 PB.
Пропускная способность серверов
Чтобы оценить throughput серверов, посмотрим на типы запросов, которые нужно поддерживать. Есть два основных типа. Первый — navigation requests, которые клиент отправляет при старте navigation session. Второй — location update requests, которые клиент отправляет по мере перемещения во время navigation session. Location data далее используются разными downstream services. Например, location data — один из входов для live traffic data. Сценарии использования location data мы разберем в deep dive.
Теперь оценим server throughput для navigation use case. Предположим, у нас 1 миллиард DAU, и каждый пользователь использует navigation в сумме 35 минут в неделю. Это соответствует 35 миллиардам минут в неделю или 5 миллиардам минут в день.
Один простой подход — отправлять GPS coordinates каждую секунду. Тогда получим 300 миллиардов
запросов в день (5 миллиардов минут * 60) или 3 миллиона QPS
(300 миллиардов запросов / 10^5 = 3 миллиона). Однако клиенту не обязательно отправлять GPS
обновление каждую секунду. Их можно batch-ить на клиенте и отправлять реже
(например, каждые 15 или 30 секунд), чтобы снизить write QPS. Частота может зависеть и от
скорости движения. Если пользователь застрял в пробке, клиент может замедлить отправку GPS
updates. В нашем дизайне считаем, что GPS updates batch-ятся и отправляются на сервер каждые
15 секунд. Тогда QPS снижается до 200,000 (3 миллиона / 15).
Предположим, что peak QPS в 5 раз выше среднего. Тогда peak QPS для location updates составит
200,000 * 5 = 1 миллион.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
Теперь, когда мы лучше понимаем Google Maps, можно предложить high-level design (рисунок 7).
High-level design
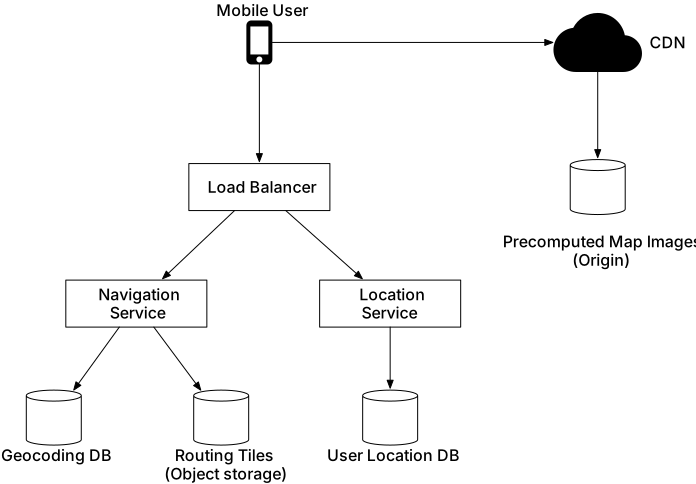
Рисунок 7 High-level design
Высокоуровневый дизайн поддерживает три возможности. Рассмотрим их по очереди.
-
Location service
-
Navigation service
-
Map rendering
Location service
Location service отвечает за запись location update пользователя. Архитектура показана на рисунке 8.

Рисунок 8 Location service
Базовый дизайн предполагает, что клиенты отправляют location updates каждые t секунд, где t
— конфигурируемый интервал. Периодические updates дают несколько преимуществ. Во-первых, мы можем
использовать потоки location data для постепенного улучшения системы. Например, по этим данным
можно отслеживать traffic, обнаруживать новые или закрытые roads и анализировать поведение
пользователей для personalization. Во-вторых, location data можно использовать почти в real time
для более точной оценки ETA и rerouting вокруг пробок, если это нужно.
Но действительно ли нужно отправлять каждое location update на сервер сразу? Скорее всего, нет. Location history можно буферизовать на клиенте и отправлять batch-ами с гораздо меньшей частотой. Например, как на рисунке 9: локация записывается каждую секунду, но отправляется на сервер batch-ем только раз в 15 секунд. Это резко снижает общий объем update traffic от всех клиентов.
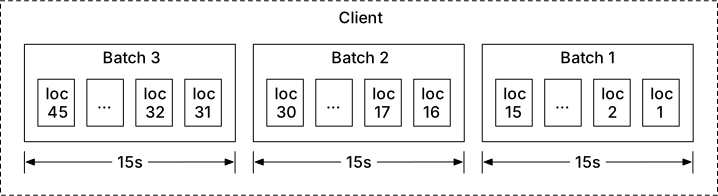
Рисунок 9 Batch requests
Даже при batch-обновлениях write volume для системы масштаба Google Maps остается очень высоким. Нам нужна база данных, оптимизированная под высокую запись и хорошо масштабируемая, например Cassandra. Дополнительно нам, возможно, потребуется логировать location data через stream processing engine, например Kafka, для дальнейшей обработки. Подробно разберем это в deep dive.
Какой communication protocol здесь подойдет? Хороший вариант — HTTP с keep-alive [12], потому
что он довольно эффективен. HTTP request может выглядеть так:
POST /v1/locations
Parameters
  locs: JSON encoded array of (latitude, longitude, timestamp) tuples.
Navigation service
Этот компонент отвечает за поиск достаточно быстрого маршрута из точки A в точку B. Мы можем допустить небольшую latency. Вычисленный маршрут не обязательно должен быть абсолютно самым быстрым, но точность критична.
Как показано на рисунке 8, пользователь отправляет HTTP request в navigation service через load
balancer. В запросе есть origin и destination. API может выглядеть так:
GET /v1/nav?origin=1355+market+street,SF&destination=Disneyland
Вот пример того, как может выглядеть navigation result:
{
  "distance": {"text":"0.2 mi", "value": 259},
  "duration": {"text": "1 min", "value": 83},
  "end_location": {"lat": 37.4038943, "Ing": -121.9410454},
  "html_instructions": "Head <b>northeast</b> on <b>Brandon St</b> toward <b>Lumin Way</b><div style=\"font-size:0.9em\">Restricted usage road</div>",
  "polyline": {"points": "_fhcFjbhgVuAwDsCal"},
  "start_location": {"lat": 37.4027165, "lng": -121.9435809},
  "geocoded_waypoints": [
    {
      "geocoder_status": "OK",
      "partial_match": true,
      "place_id": "ChIJwZNMti1fawwRO2aVVVX2yKg",
      "types": ["locality", "political"]
    },
    {
      "geocoder_status": "OK",
      "partial_match": true,
      "place_id": "ChIJ3aPgQGtXawwRLYeiBMUi7bM",
      "types": ["locality", "political"]
    }
  ],
  "travel_mode": "DRIVING"
}
Подробнее об официальных API Google Maps см. [13].
Пока что мы не учитывали reroute и изменения traffic conditions. Эти задачи мы разберем в разделе про Adaptive ETA service в deep dive.
Map rendering
Как мы уже оценили, вся коллекция map tiles на разных zoom levels занимает около сотни петабайт. Хранить весь dataset на клиенте нереалистично. Map tiles нужно получать по требованию с сервера, ориентируясь на location клиента и zoom level client viewport.
Когда клиент должен загружать новые map tiles?
-
Когда пользователь zoom-ит и pan-ит карту на клиенте, исследуя окрестности.
-
Во время navigation, когда пользователь выходит из текущего map tile и перемещается в соседний.
Мы имеем дело с очень большим объемом данных, поэтому давайте подумаем, как эффективно обслуживать эти map tiles с сервера.
Вариант 1
Сервер строит map tiles на лету, на основе location клиента и zoom level его viewport. Но число комбинаций location и zoom level фактически бесконечно, и динамическая генерация имеет несколько серьезных недостатков:
-
Огромная нагрузка на серверный кластер, которому придется генерировать каждый tile динамически.
-
Поскольку map tiles генерируются динамически, становится сложно эффективно использовать cache.
Вариант 2
Другой вариант — заранее сгенерировать набор map tiles на каждом zoom level. Эти tiles статичны, и каждый tile покрывает фиксированную прямоугольную grid, разбитую, например, по geohashing. Значит, каждый tile можно однозначно представить его geohash. Когда клиенту нужен map tile, он сначала определяет набор tiles по zoom level, а затем вычисляет URL map tile, преобразовав location в geohash нужного уровня.
Эти статические предгенерированные изображения обслуживаются через CDN, как показано на рисунке 10.

Рисунок 10 CDN
На диаграмме выше mobile user делает HTTP request за tile в CDN. Если CDN еще не обслуживал этот tile, он получает копию с origin server, кэширует ее локально и возвращает пользователю. В последующих запросах, даже если они идут от других пользователей, CDN уже возвращает кэшированную копию, не обращаясь к origin.
Этот подход лучше по scalability и performance, потому что map tiles обслуживаются из ближайшей point of presence (POP) к клиенту, как показано на рисунке 11. Статическая природа map tiles делает их очень cacheable.
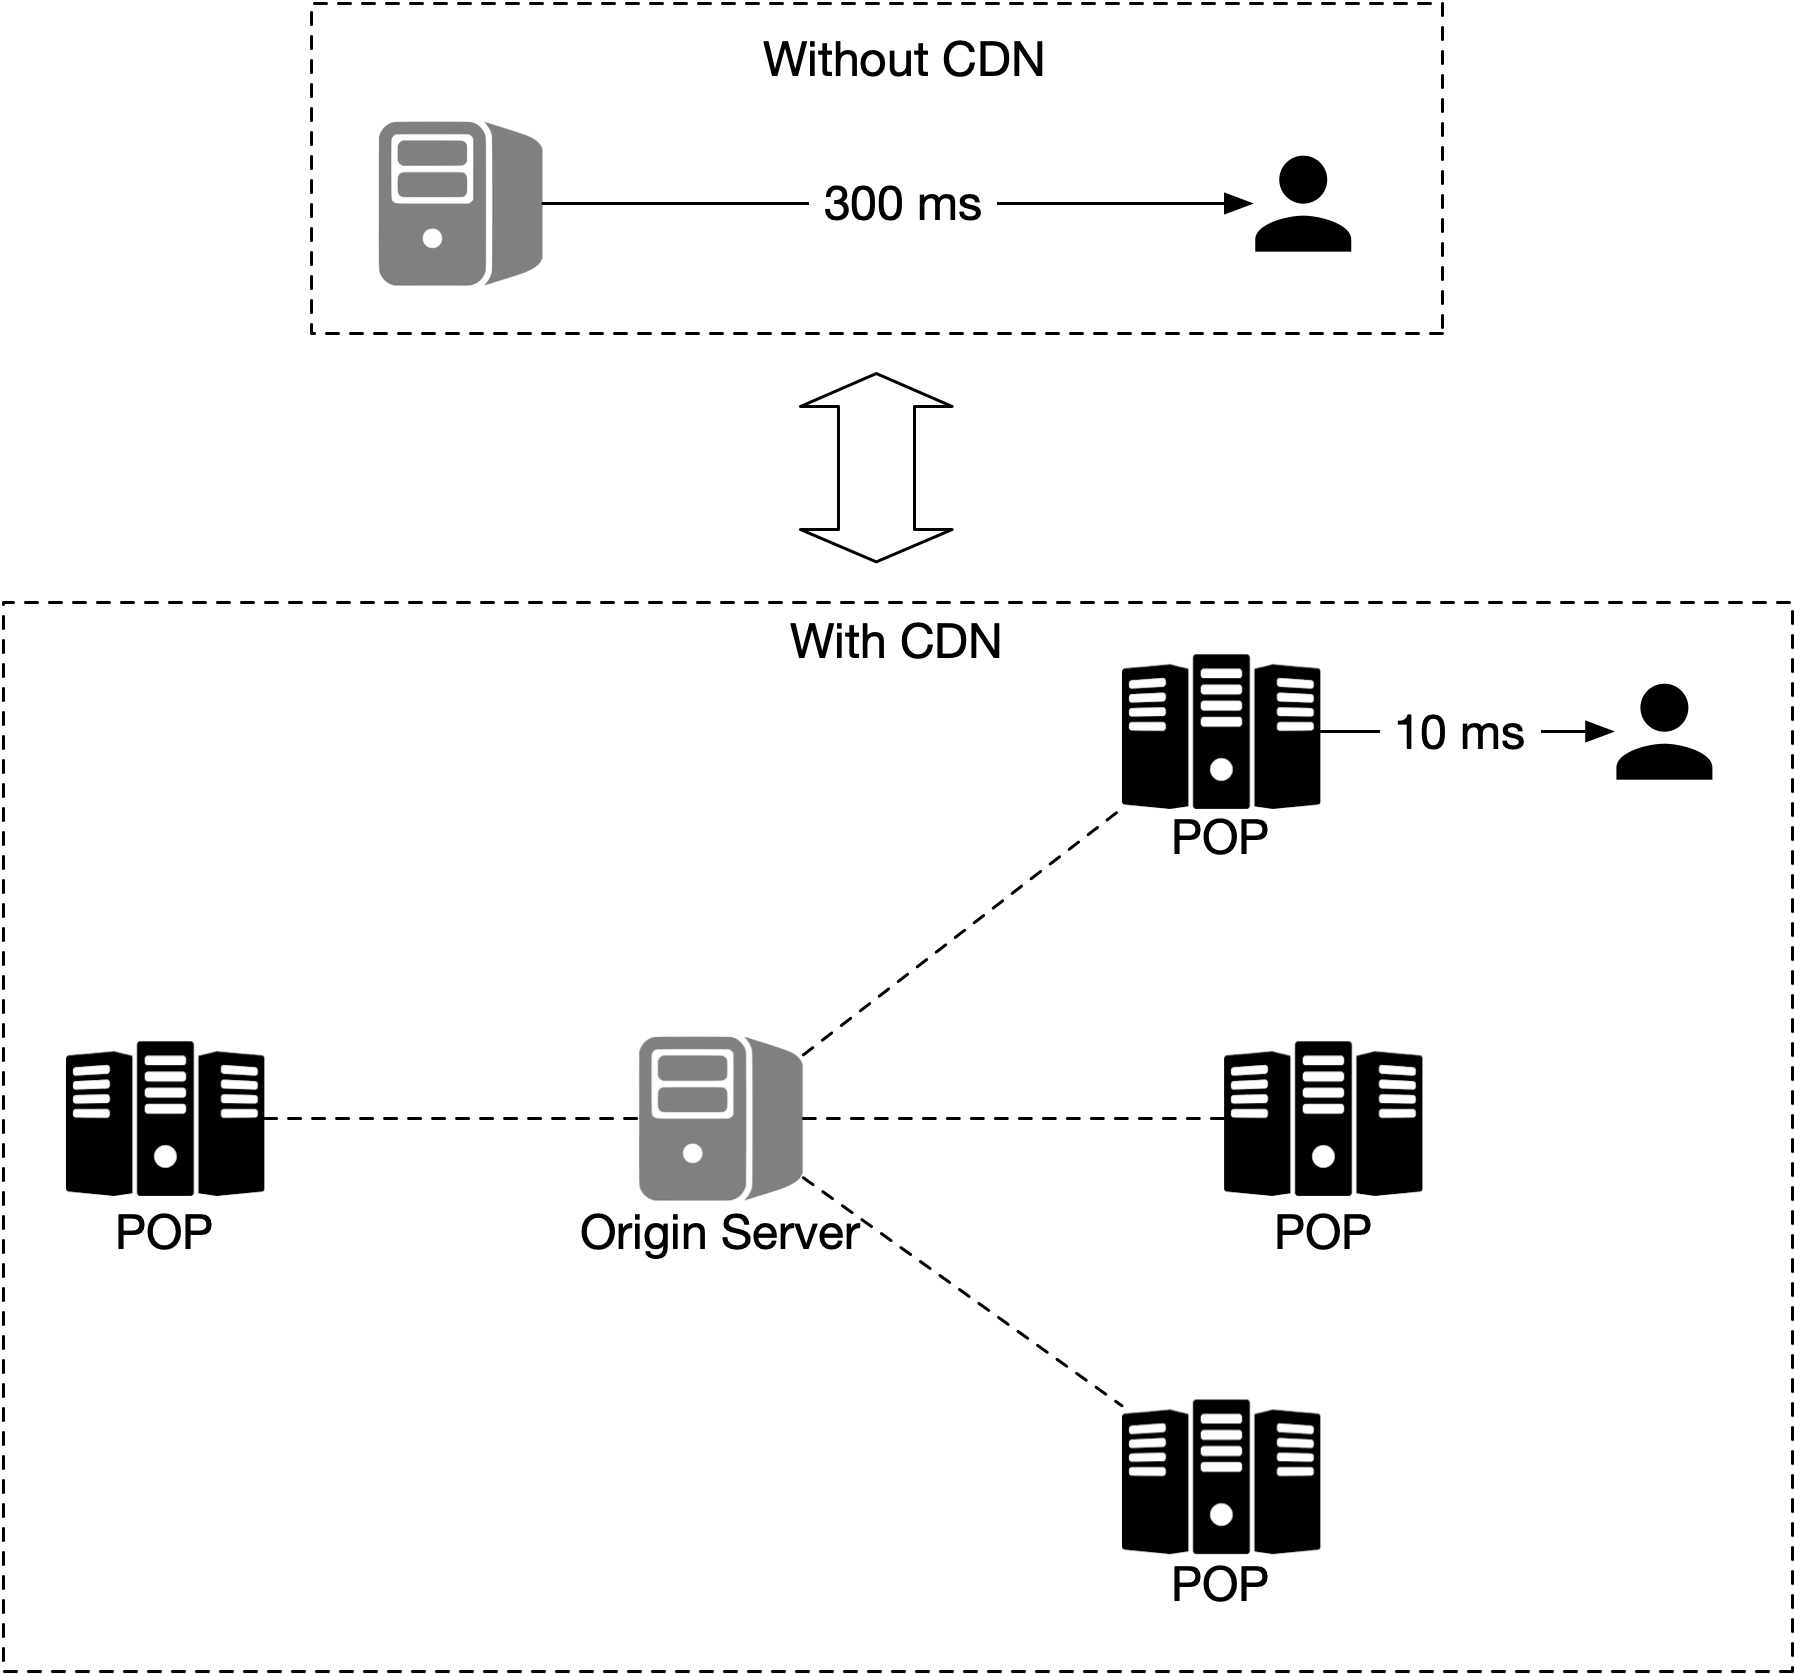
Рисунок 11 Без CDN и с CDN
Для mobile очень важно экономить трафик. Давайте оценим, сколько данных клиенту нужно загрузить во время типичной navigation session. Учтите, что в этих расчетах не учитывается client-side caching. Так как пользователь может ездить по похожим маршрутам каждый день, реальное использование трафика с client-side caching, вероятно, будет заметно ниже.
| Использование данных |
|---|
Предположим, пользователь движется со скоростью 30 км/ч, а zoom level выбран так, что каждое изображение покрывает блок 200m * 200m (один block можно представить изображением 256x256 пикселей, а средний размер изображения — 100 KB). Для области 1km * 1km нам нужно 25 изображений, то есть 2.5 MB (25 * 100KB) данных. Значит, при скорости 30 км/ч нужно 75 MB (30 * 2.5MB) данных в час или 1.25 MB в минуту. |
Таблица 2. Использование данных
Теперь оценим объем данных через CDN. На нашем масштабе стоимость — важный фактор.
| Трафик через CDN |
|---|
Как мы уже говорили, мы обслуживаем 5 миллиардов минут navigation в день. Это соответствует
5 миллиардов * 1.25 MB = 6.25 миллиарда MB в день. Следовательно, каждую секунду мы отдаем
62,500 MB (6.25 миллиарда / 10^5 секунд в сутках) map data. С CDN эти map images будут
обслуживаться POP-ами по всему миру. Предположим, есть 200 POP-ов. Тогда каждому POP придется
обслуживать всего несколько сотен MB (62,500 / 200) в секунду.
|
Таблица 3. Трафик через CDN
Есть еще одна важная деталь в дизайне map rendering, которую мы пока затронули лишь слегка: как клиент узнает, по каким URL получать map tiles из CDN? Напомним, что мы используем вариант 2. В нем map tiles статичны и заранее сгенерированы по фиксированным наборам grid, каждый набор соответствует отдельному zoom level.
Поскольку мы кодируем grid через geohash и у каждой grid есть свой уникальный geohash, вычислительно
очень дешево перейти от location клиента (latitude/longitude) и zoom level к geohash tile. Это
можно делать прямо на клиенте, после чего запрашивать любой static image tile из CDN. Например,
URL image tile для Google headquarters может выглядеть так:
https://cdn.map-provider.com/tiles/9q9hvu.png
Более подробное обсуждение geohash encoding есть в главе Proximity Service.
Вычисление geohash на клиенте выглядит хорошим вариантом. Но надо помнить: этот алгоритм будет зашит в клиенты на всех платформах. Поставка изменений в mobile apps — долгий и рискованный процесс. Нужно быть уверенным, что geohashing — это долгосрочный способ кодирования map tile collection и он вряд ли поменяется. Если потом по какой-то причине придется перейти на другой encoding method, это будет дорого и рискованно.
Есть и другой вариант. Вместо захардкоженного клиентского алгоритма, который преобразует latitude/longitude pair и zoom level в tile URL, можно ввести промежуточный сервис, чья задача — строить tile URLs по тем же входам. Это очень простой сервис. Возможная added operational flexibility может стоить этого. Это хороший trade-off для обсуждения с интервьюером. Альтернативный поток map rendering показан на рисунке 12.
Когда пользователь перемещается в новую точку или меняет zoom level, map tile service определяет, какие tiles нужны, и преобразует это в набор tile URLs для загрузки.

Рисунок 12 Map rendering
-
Mobile user вызывает map tile service, чтобы получить tile URLs. Запрос идет через load balancer.
-
Load balancer пересылает запрос в map tile service.
-
Map tile service берет location клиента и zoom level как входные данные и возвращает клиенту 9 URL-ов tiles. Это tile для текущего экрана и восемь соседних tiles.
-
Mobile client скачивает tiles из CDN.
К precomputed map tiles мы еще вернемся в deep dive.
Шаг 3 — Deep Dive дизайна
В этом разделе сначала обсудим data model. Затем подробнее разберем location service, navigation service и map rendering.
Data model
Мы имеем дело с четырьмя типами данных: routing tiles, user location data, geocoding data и precomputed map tiles мира.
Routing tiles
Как уже говорилось, исходный road dataset мы получаем из разных источников и ведомств. Он содержит терабайты данных. Со временем этот dataset улучшается с помощью location data, которые приложение постоянно собирает от пользователей.
Этот dataset содержит большое количество roads и связанной metadata: names, county, longitude и
latitude. Такие данные еще не организованы как graph data structures и напрямую непригодны для
большинства routing algorithms. Поэтому мы периодически запускаем offline processing pipeline,
называемый routing tile processing service, чтобы преобразовать этот dataset в routing tiles.
Сервис выполняется периодически, чтобы учитывать новые изменения road data.
Выход routing tile processing service — это routing tiles. Есть три набора таких tiles с разной
resolution, как было описано в разделе Map 101. Каждый tile содержит список graph nodes и edges,
представляющих intersections и roads в соответствующей области. Он также содержит ссылки на другие
tiles, с которыми соединяются его roads. Вместе эти tiles образуют взаимосвязанную road network,
которую routing algorithms могут постепенно подгружать.
Где хранить output routing tile processing service? Большинство graph data в памяти представляются в виде adjacency lists [14]. Tiles слишком много, чтобы держать весь набор adjacency lists в памяти. Можно было бы хранить nodes и edges как строки в database, но тогда database использовалась бы только как storage, что выглядит дорогим способом хранить просто набор битов. К тому же нам не нужны специфические database features для routing tiles.
Гораздо эффективнее хранить такие tiles в object storage вроде S3 и агрессивно кэшировать их в routing service, который эти tiles использует. Существует много высокопроизводительных пакетов для сериализации adjacency lists в binary file. В object storage можно организовать tiles по их geohash. Это даст быстрый lookup tile по lat/lng pair.
Чуть ниже мы обсудим, как shortest path service использует routing tiles.
User location data
User location data очень ценны. Мы используем их для обновления road data и routing tiles. Также они нужны для базы live и historical traffic data. Эти же данные читают различные stream processing services для обновления map data.
Для user location data нам нужна база данных, которая хорошо справляется с write-heavy workload и умеет горизонтально масштабироваться. Cassandra — хороший кандидат.
Вот как может выглядеть одна строка:
| user_id | timestamp | user_mode | driving_mode | location |
|---|---|---|---|---|
| 101 | 1635740977 | active | driving | (20.0, 30.5) |
Таблица 4. Таблица location
Geocoding database
Эта база хранит places и соответствующие им lat/lng pairs. Для быстрых чтений можно использовать
key-value database вроде Redis, потому что чтений у нас много, а записей мало. Мы используем ее
для преобразования origin и destination в lat/lng pairs перед передачей данных route planner
service.
Предвычисленные изображения карты мира
Когда устройство просит карту определенной области, нам нужно получить nearby roads и вычислить изображение, которое представляет эту область со всеми дорогами и связанными деталями. Такие вычисления тяжелые и повторяющиеся, поэтому выгодно посчитать их один раз и затем кэшировать изображения. Мы предвычисляем изображения на разных zoom levels и храним их в CDN, за которым стоит cloud storage вроде Amazon S3. Пример такого изображения показан ниже.
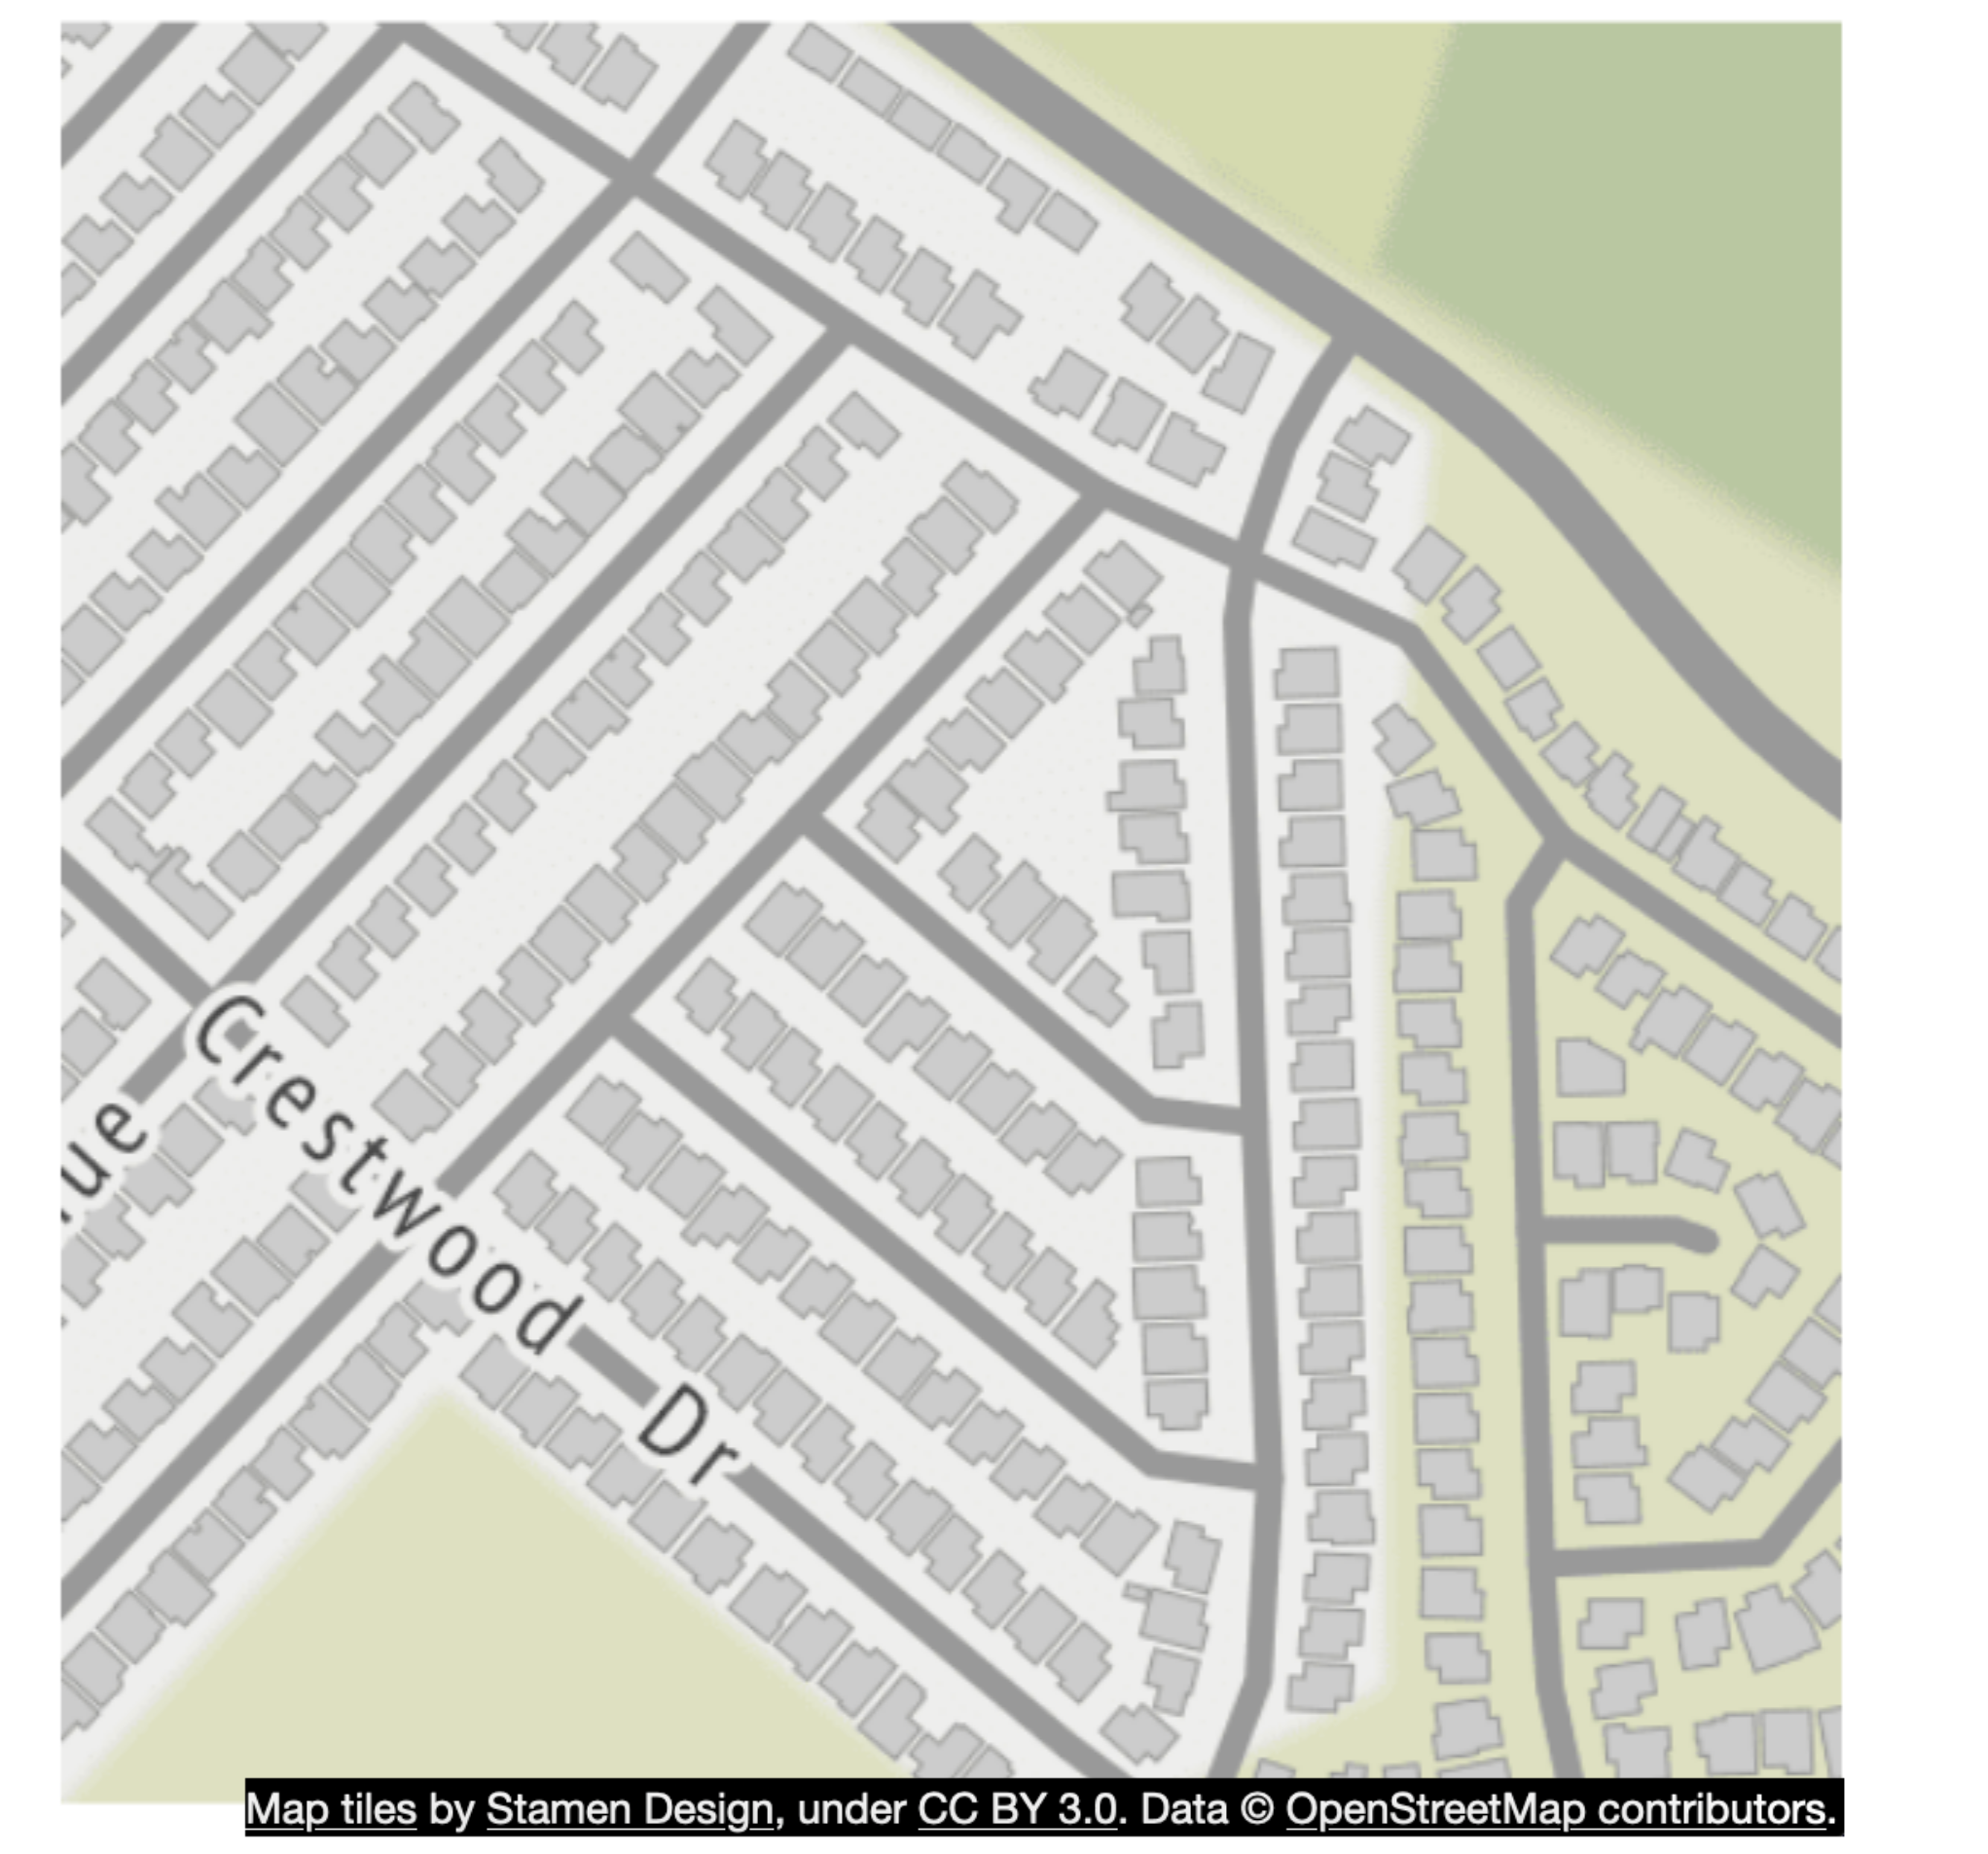
Рисунок 13 Precomputed tiles
Services
Теперь, когда мы обсудили data model, рассмотрим ключевые services: location service, map rendering service и navigation service.
Location service
В high-level design мы уже обсуждали, как работает location service. Здесь сосредоточимся на database design для этого сервиса и на том, как именно используется user location.
На рисунке 14 key-value store используется для хранения user location data. Посмотрим внимательнее.
Рисунок 14 User location database
Учитывая, что у нас 1 миллион location updates в секунду, нам нужна база данных, поддерживающая очень быстрые записи. Здесь хорошо подойдет NoSQL key-value database или column-oriented database. Кроме того, location пользователя постоянно меняется и устаревает сразу после прихода нового update. Поэтому мы можем предпочесть availability, а не consistency. CAP theorem [15] говорит, что можно выбрать два свойства из consistency, availability и partition tolerance. С учетом наших ограничений мы выбираем availability и partition tolerance. Одной из хороших БД здесь является Cassandra. Она выдерживает наш масштаб и дает сильную гарантию availability.
Ключ — это комбинация (user_id, timestamp), а значение — lat/lng pair. В такой схеме
user_id — partition key, а timestamp — clustering key. Преимущество выбора user_id в
качестве partition key в том, что можно быстро читать последнюю позицию конкретного пользователя.
Все данные с одинаковым partition key хранятся рядом и отсортированы по timestamp. Благодаря
этому очень эффективно получать location data конкретного пользователя за заданный диапазон
времени.
Ниже пример того, как может выглядеть таблица.
| key (user_id) | timestamp | lat | long | user_mode | navigation_mode |
|---|---|---|---|---|---|
| 51 | 132053000 | 21.9 | 89.8 | active | driving |
Таблица 5. Location data
Как мы используем user location data?
User location data критически важны. Они поддерживают множество use cases. Мы используем их для обнаружения новых и недавно закрытых roads. С их помощью мы повышаем точность нашей карты со временем. Они также являются одним из входов для live traffic data.
Чтобы поддерживать эти use cases, помимо записи текущих user locations в нашу database, мы логируем эту информацию в message queue вроде Kafka. Kafka — это unified low-latency, high-throughput data streaming platform для real-time data feeds. На рисунке 15 показано, как Kafka используется в улучшенном дизайне.
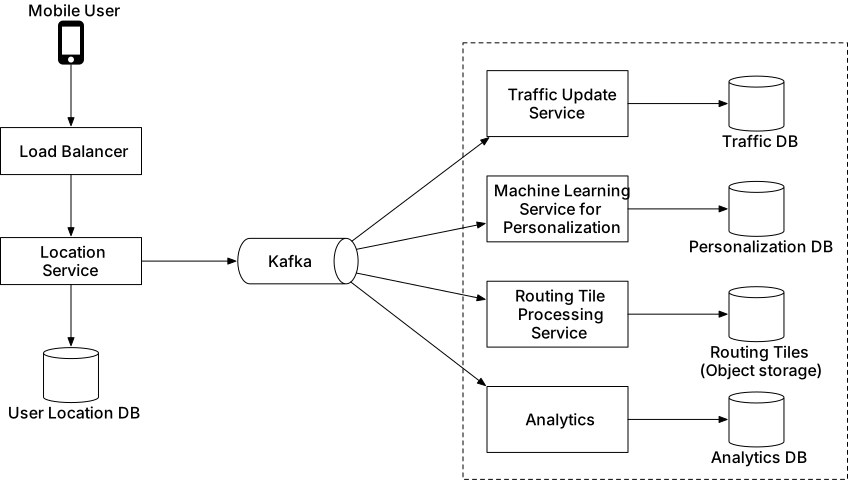
Рисунок 15 Location data используются другими services
Другие services читают поток location data из Kafka для разных use cases. Например, live traffic service потребляет выходной поток и обновляет live traffic database. Routing tile processing service улучшает карту мира, обнаруживая новые или закрытые roads и обновляя соответствующие routing tiles в object storage. Другие services также могут подключаться к потоку для своих задач.
Rendering map
В этом разделе подробно разберем precomputed map tiles и оптимизации map rendering. Они в основном вдохновлены работой Google Design [5].
Precomputed tiles
Как уже говорилось, существуют разные наборы precomputed map tiles для разных zoom levels, чтобы пользователь получал ровно тот уровень детализации, который соответствует размеру client viewport и уровню zoom. Google Maps использует 21 zoom level (таблица 1). Мы используем то же число.
Level 0 — самый отдаленный. Вся карта представлена одним tile размером 256 * 256 пикселей.
С каждым увеличением zoom level количество map tiles удваивается и по north-south, и по east-west,
при этом размер каждого tile остается 256 * 256 пикселей. Как показано на рисунке 16, на zoom
level 1 у нас 2 x 2 tiles, что дает суммарное разрешение 512 * 512 пикселей. На zoom level 2 —
уже 4 x 4 tiles и суммарное разрешение 1024 * 1024 пикселей. На каждом новом уровне весь
набор tiles содержит в 4 раза больше пикселей, чем на предыдущем. Этот рост pixel count дает
больше деталей. Благодаря этому клиент может рендерить карту с подходящей granularities на своем
zoom level, не тратя лишнюю bandwidth на tiles с чрезмерной детализацией.
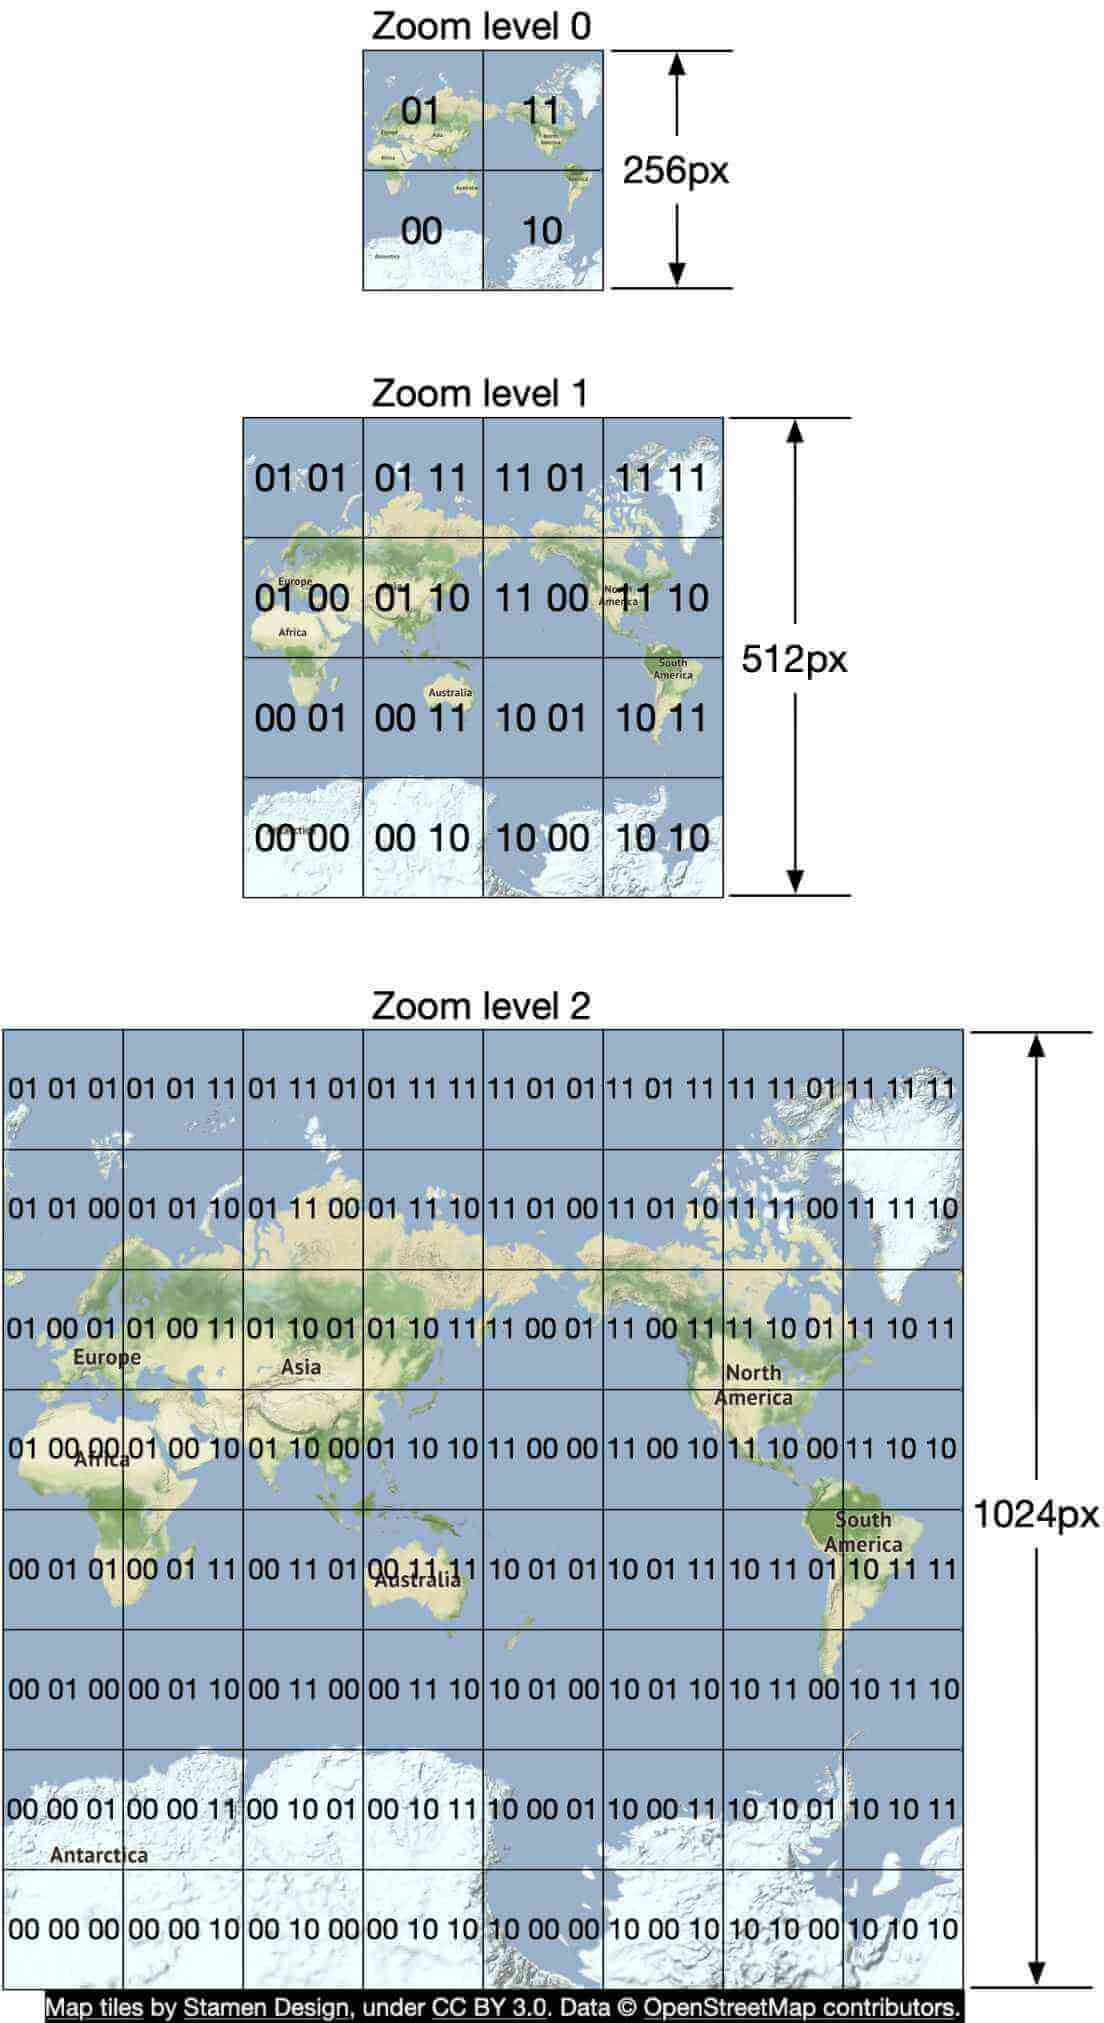
Рисунок 16 Zoom levels
Оптимизация: использовать vectors
С развитием и внедрением WebGL одним из потенциальных улучшений является переход от передачи изображений по сети к передаче vector information (paths и polygons). Тогда клиент сам рисует пути и полигоны на основе vector data.
Очевидное преимущество vector tiles — vector data сжимаются намного лучше, чем изображения. Экономия bandwidth получается существенной.
Менее очевидное преимущество — заметно лучший zooming experience. При rasterized images, когда клиент приближает карту с одного уровня на другой, картинка растягивается и выглядит pixelated. Визуально это очень дергано. С vectorized images клиент может корректно масштабировать каждый элемент, и zooming получается намного плавнее.
Navigation service
Теперь подробнее разберем navigation service. Этот сервис отвечает за поиск самых быстрых маршрутов. Диаграмма показана на рисунке 17.
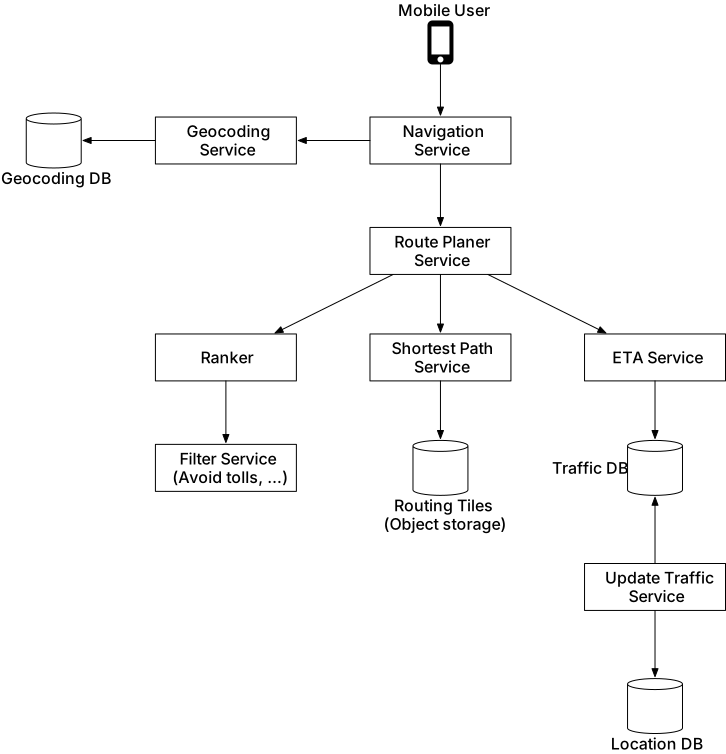
Рисунок 17 Navigation service
Разберем каждый компонент системы.
Geocoding service
Сначала нам нужен service, который преобразует адрес в пару latitude/longitude. Адрес может быть в разных форматах: например, это может быть имя места или обычный текстовый адрес.
Вот пример request и response из geocoding API Google.
Request:
https://maps.googleapis.com/maps/api/geocode/json?address=1600+Amphitheatre+Parkway,+Mountain+View,+CA
JSON response:
{
  "results": [
    {
      "formatted_address": "1600 Amphitheatre Parkway, Mountain View, CA 94043, USA",
      "geometry": {
        "location": {
          "lat": 37.4224764,
          "lng": -122.0842499
        },
        "location_type": "ROOFTOP",
        "viewport": {
          "northeast": {
            "lat": 37.4238253802915,
            "lng": -122.0829009197085
          },
          "southwest": {
            "lat": 37.4211274197085,
            "lng": -122.0855988802915
          }
        }
      },
      "place_id": "ChIJ2eUgeAK6j4ARbn5u_wAGqWA",
      "plus_code": {
        "compound_code": "CWC8+W5 Mountain View, California, United States",
        "global_code": "849VCWC8+W5"
      },
      "types": ["street_address"]
    }
  ],
  "status": "OK"
}
Navigation service вызывает этот service, чтобы geocode-ить origin и destination, прежде чем
передавать lat/lng pairs дальше для построения route.
Route planner service
Этот service вычисляет рекомендуемый маршрут, оптимизированный по времени поездки с учетом текущего traffic и состояния дорог. Он взаимодействует с несколькими другими services, которые мы разберем дальше.
Shortest-path service
Shortest-path service получает origin и destination в виде lat/lng pairs и возвращает top-k
кратчайших путей без учета traffic и текущих условий. Это вычисление зависит только от структуры
дорог. Здесь может быть полезен cache маршрутов, потому что сам graph редко меняется.
Shortest-path service запускает вариацию A* pathfinding algorithm поверх routing tiles, лежащих в object storage. На высоком уровне это выглядит так:
-
Алгоритм получает
originиdestinationкак lat/lng pairs. Эти пары переводятся в geohashes, по которым загружаются start и end points routing tiles. -
Алгоритм начинает с origin routing tile, проходит graph data structure и по мере расширения search area подгружает дополнительные neighboring tiles из object store (или из локального cache, если tile уже загружался). Важно, что существуют связи между tiles разных уровней детализации, покрывающих одну и ту же область. Благодаря этому алгоритм может, например,
войтив более крупные tiles, содержащие только highways. Поиск продолжается, пока алгоритм не найдет набор лучших маршрутов, подгружая дополнительные neighboring tiles (или tiles другой resolution) по мере необходимости.
Рисунок 18 дает концептуальное представление о том, как tiles используются в graph traversal.
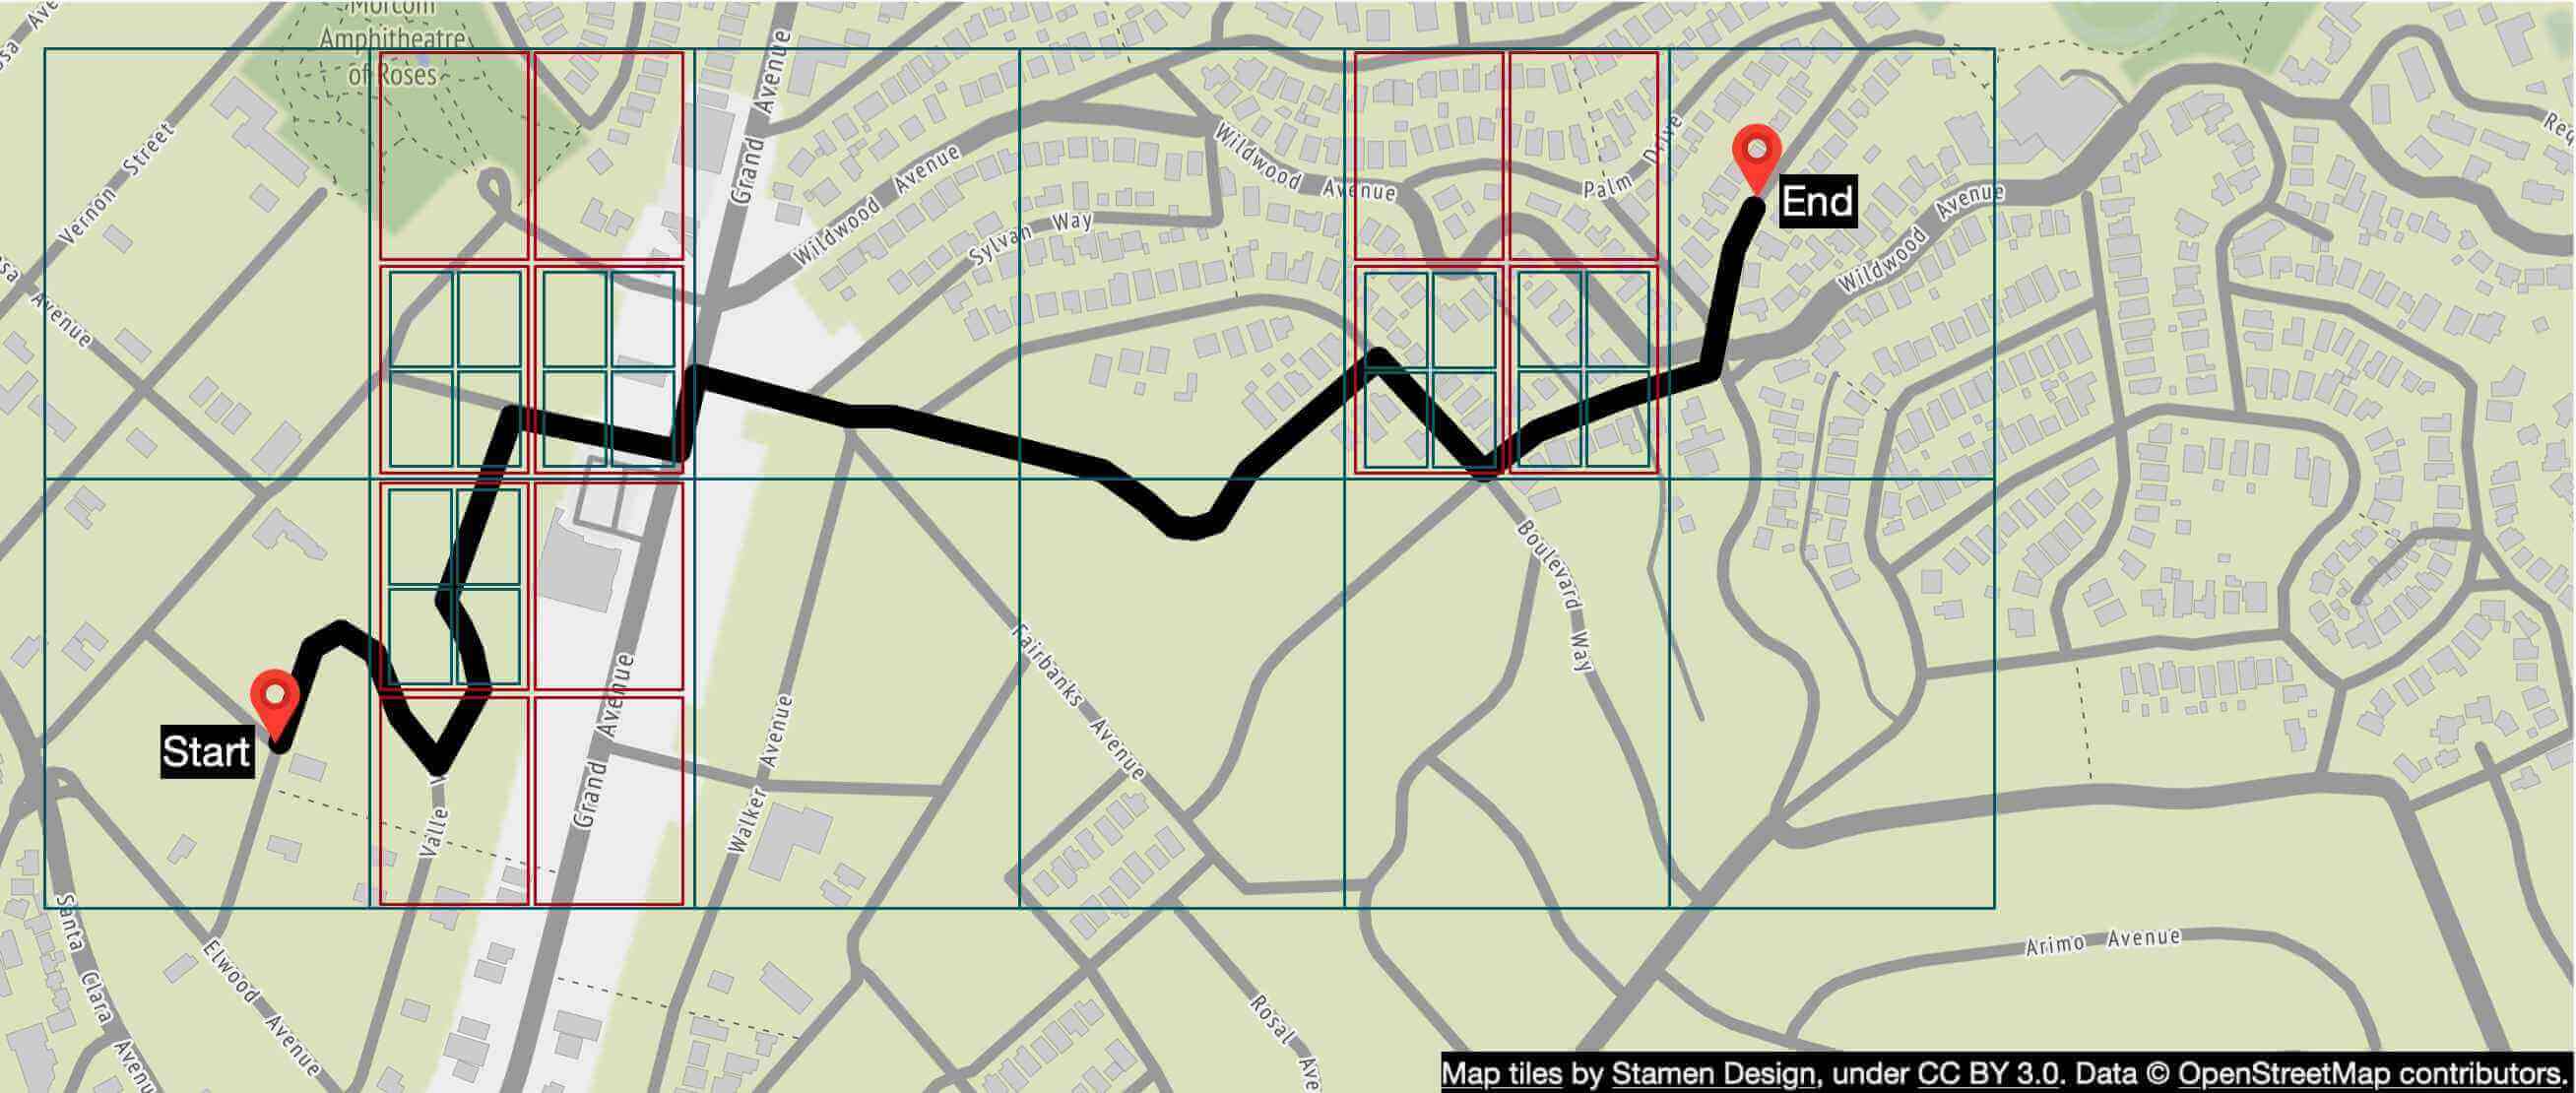
Рисунок 18 Graph traversal
ETA service
Когда route planner получает список возможных shortest paths, он вызывает ETA service для каждого маршрута и получает оценку времени. Для этого ETA service использует machine learning, чтобы предсказывать ETA на основе текущего traffic и historical data.
Одна из сложностей здесь в том, что нужно не только иметь real-time traffic data, но и уметь предсказывать, каким будет traffic через 10 или 20 минут. Это задачи алгоритмического уровня, и в этой секции мы их подробно разбирать не будем. Если интересно, см. [16] и [17].
Ranker service
После того как route planner получает ETA predictions, он передает информацию ranker-у, чтобы тот учел возможные user-defined filters. Например, пользователь может захотеть избегать toll roads или freeways. Ranker service затем ранжирует возможные маршруты от самого быстрого к самому медленному и возвращает top-k результатов navigation service.
Updater services
Эти services подписываются на Kafka location update stream и асинхронно обновляют важные базы данных, поддерживая их в актуальном состоянии. Примеры — traffic database и routing tiles.
Routing tile processing service отвечает за преобразование road dataset с новыми дорогами и закрытиями дорог в постоянно обновляемый набор routing tiles. Это помогает shortest path service работать точнее.
Traffic update service извлекает information о traffic conditions из потока location updates, которые отправляют активные пользователи. Эта информация попадает в live traffic database. Благодаря этому ETA service может давать более точные оценки.
Улучшение: adaptive ETA и rerouting
Текущий дизайн не поддерживает adaptive ETA и rerouting. Чтобы добавить это, серверу нужно уметь отслеживать всех активных пользователей, которые сейчас едут по маршруту, и непрерывно обновлять им ETA, когда traffic conditions меняются. Здесь надо ответить на несколько важных вопросов:
-
Как отслеживать actively navigating users?
-
Как хранить данные так, чтобы среди миллионов navigation routes быстро находить пользователей, затронутых изменением traffic?
Начнем с наивного решения. На рисунке 19 navigation route пользователя user_1 представлена
routing tiles r_1, r_2, r_3, ..., r_7.

Рисунок 19 Navigation route
База данных хранит информацию об actively navigating users и маршрутах примерно так:
user_1: r_1, r_2, r_3, …, r_k
user_2: r_4, r_6, r_9, …, r_n
user_3: r_2, r_8, r_9, …, r_m
...
user_n: r_2, r_10, r_21, ..., r_l
Предположим, что в routing tile 2 (r_2) происходит traffic incident. Чтобы понять, какие
пользователи затронуты, мы сканируем каждую строку и проверяем, есть ли r_2 в списке routing
tiles.
user_1: r_1, r_2, r_3, …, r_k
user_2: r_4, r_6, r_9, …, r_n
user_3: r_2, r_8, r_9, …, r_m
...
user_n: r_2, r_10, r_21, ..., r_l
Если количество строк — n, а средняя длина navigation route — m, тогда временная сложность
поиска всех затронутых пользователей равна O(n * m).
Можно ли сделать быстрее? Давайте посмотрим на другой подход. Для каждого actively navigating user мы храним текущий routing tile, routing tile следующего уровня resolution, который его содержит, и рекурсивно продолжаем подниматься по уровням, пока не найдем tile, который содержит и текущую позицию, и destination пользователя (рисунок 20). Тогда строка в базе будет выглядеть так:
user_1, r_1, super(r_1), super(super(r_1)), ...
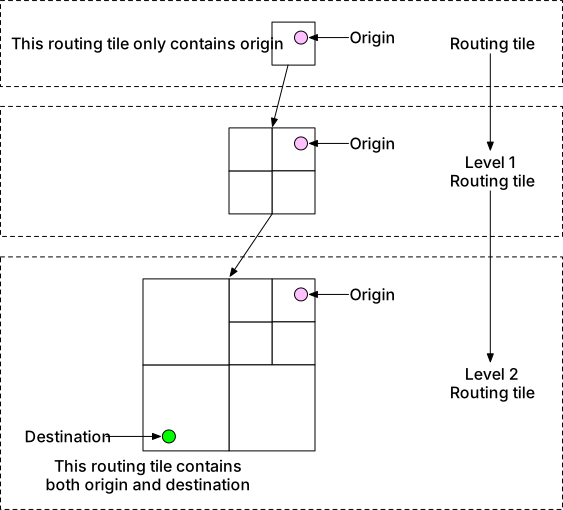
Рисунок 20 Построение routing tiles
Чтобы понять, затронут ли пользователь traffic change, нам нужно лишь проверить, находится ли изменившийся routing tile внутри последнего routing tile строки в базе. Если нет, пользователь не затронут. Если да — затронут. Так мы можем очень быстро отфильтровать многих пользователей.
Этот подход не объясняет, что делать, когда traffic рассасывается. Например, если routing tile 2 снова освобождается и пользователи могут вернуться на старый route, как они узнают, что rerouting снова доступен? Один из вариантов — отслеживать все возможные маршруты пользователя, регулярно пересчитывать ETA и уведомлять пользователя, если найден новый route с меньшим ETA.
Delivery protocols
Во время navigation условия маршрута действительно могут меняться, поэтому серверу нужен надежный способ push-ить данные в mobile clients. Среди вариантов доставки от сервера к клиенту есть mobile push notification, long polling, WebSocket и Server-Sent Events (SSE).
-
Mobile push notification — не лучший выбор, потому что payload сильно ограничен (4,096 bytes на iOS), и этот вариант не поддерживает web applications.
-
WebSocket обычно считается лучше long polling, потому что дает очень маленький server footprint.
-
Раз мы исключили mobile push notification и long polling, выбор в основном между WebSocket и SSE. Хотя оба варианта работоспособны, мы склоняемся к WebSocket, потому что он поддерживает bi-directional communication, а такие функции, как last-mile delivery, могут требовать именно двустороннего real-time обмена.
Подробнее про ETA и rerouting см. [16].
Теперь у нас есть все части дизайна. Обновленная схема показана на рисунке 21.
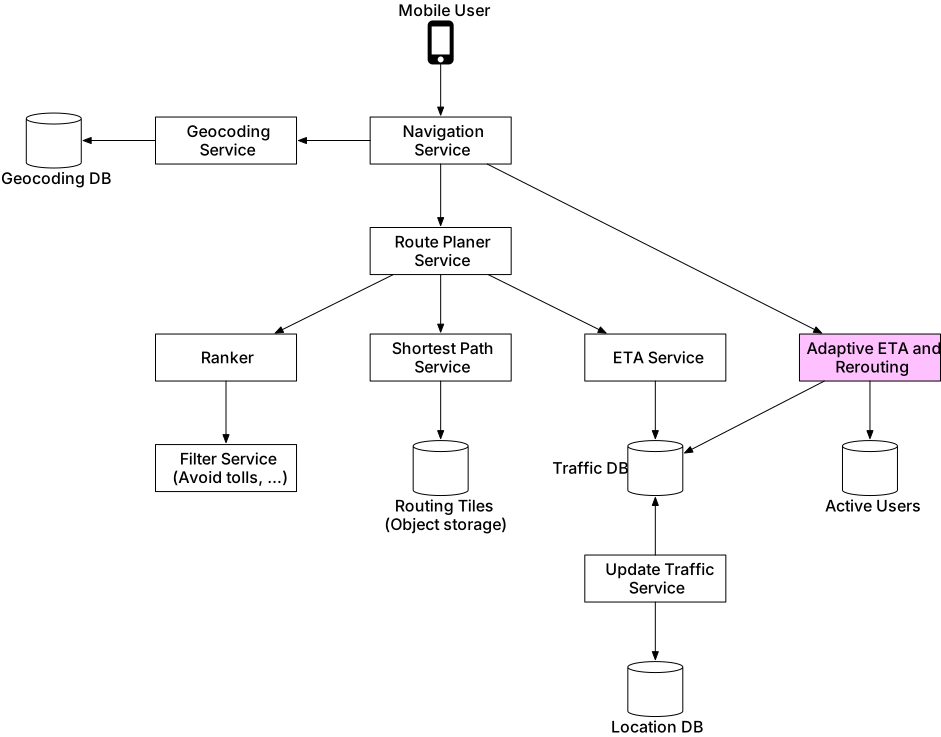
Рисунок 21 Финальный дизайн
Шаг 4 — Wrap-up
В этой главе мы спроектировали упрощенное приложение уровня Google Maps с ключевыми возможностями: location update, ETAs, route planning и map rendering. Если расширять систему дальше, одним из интересных улучшений могла бы стать multi-stop navigation для enterprise customers. Например, для заданного набора destinations нужно было бы находить оптимальный порядок посещения всех точек и строить корректную навигацию с учетом live traffic conditions. Это было бы полезно для delivery services вроде DoorDash, Uber, Lyft и т. д.
Поздравляю, вы дошли до конца этой главы. Можно похлопать себе по плечу — отличная работа!
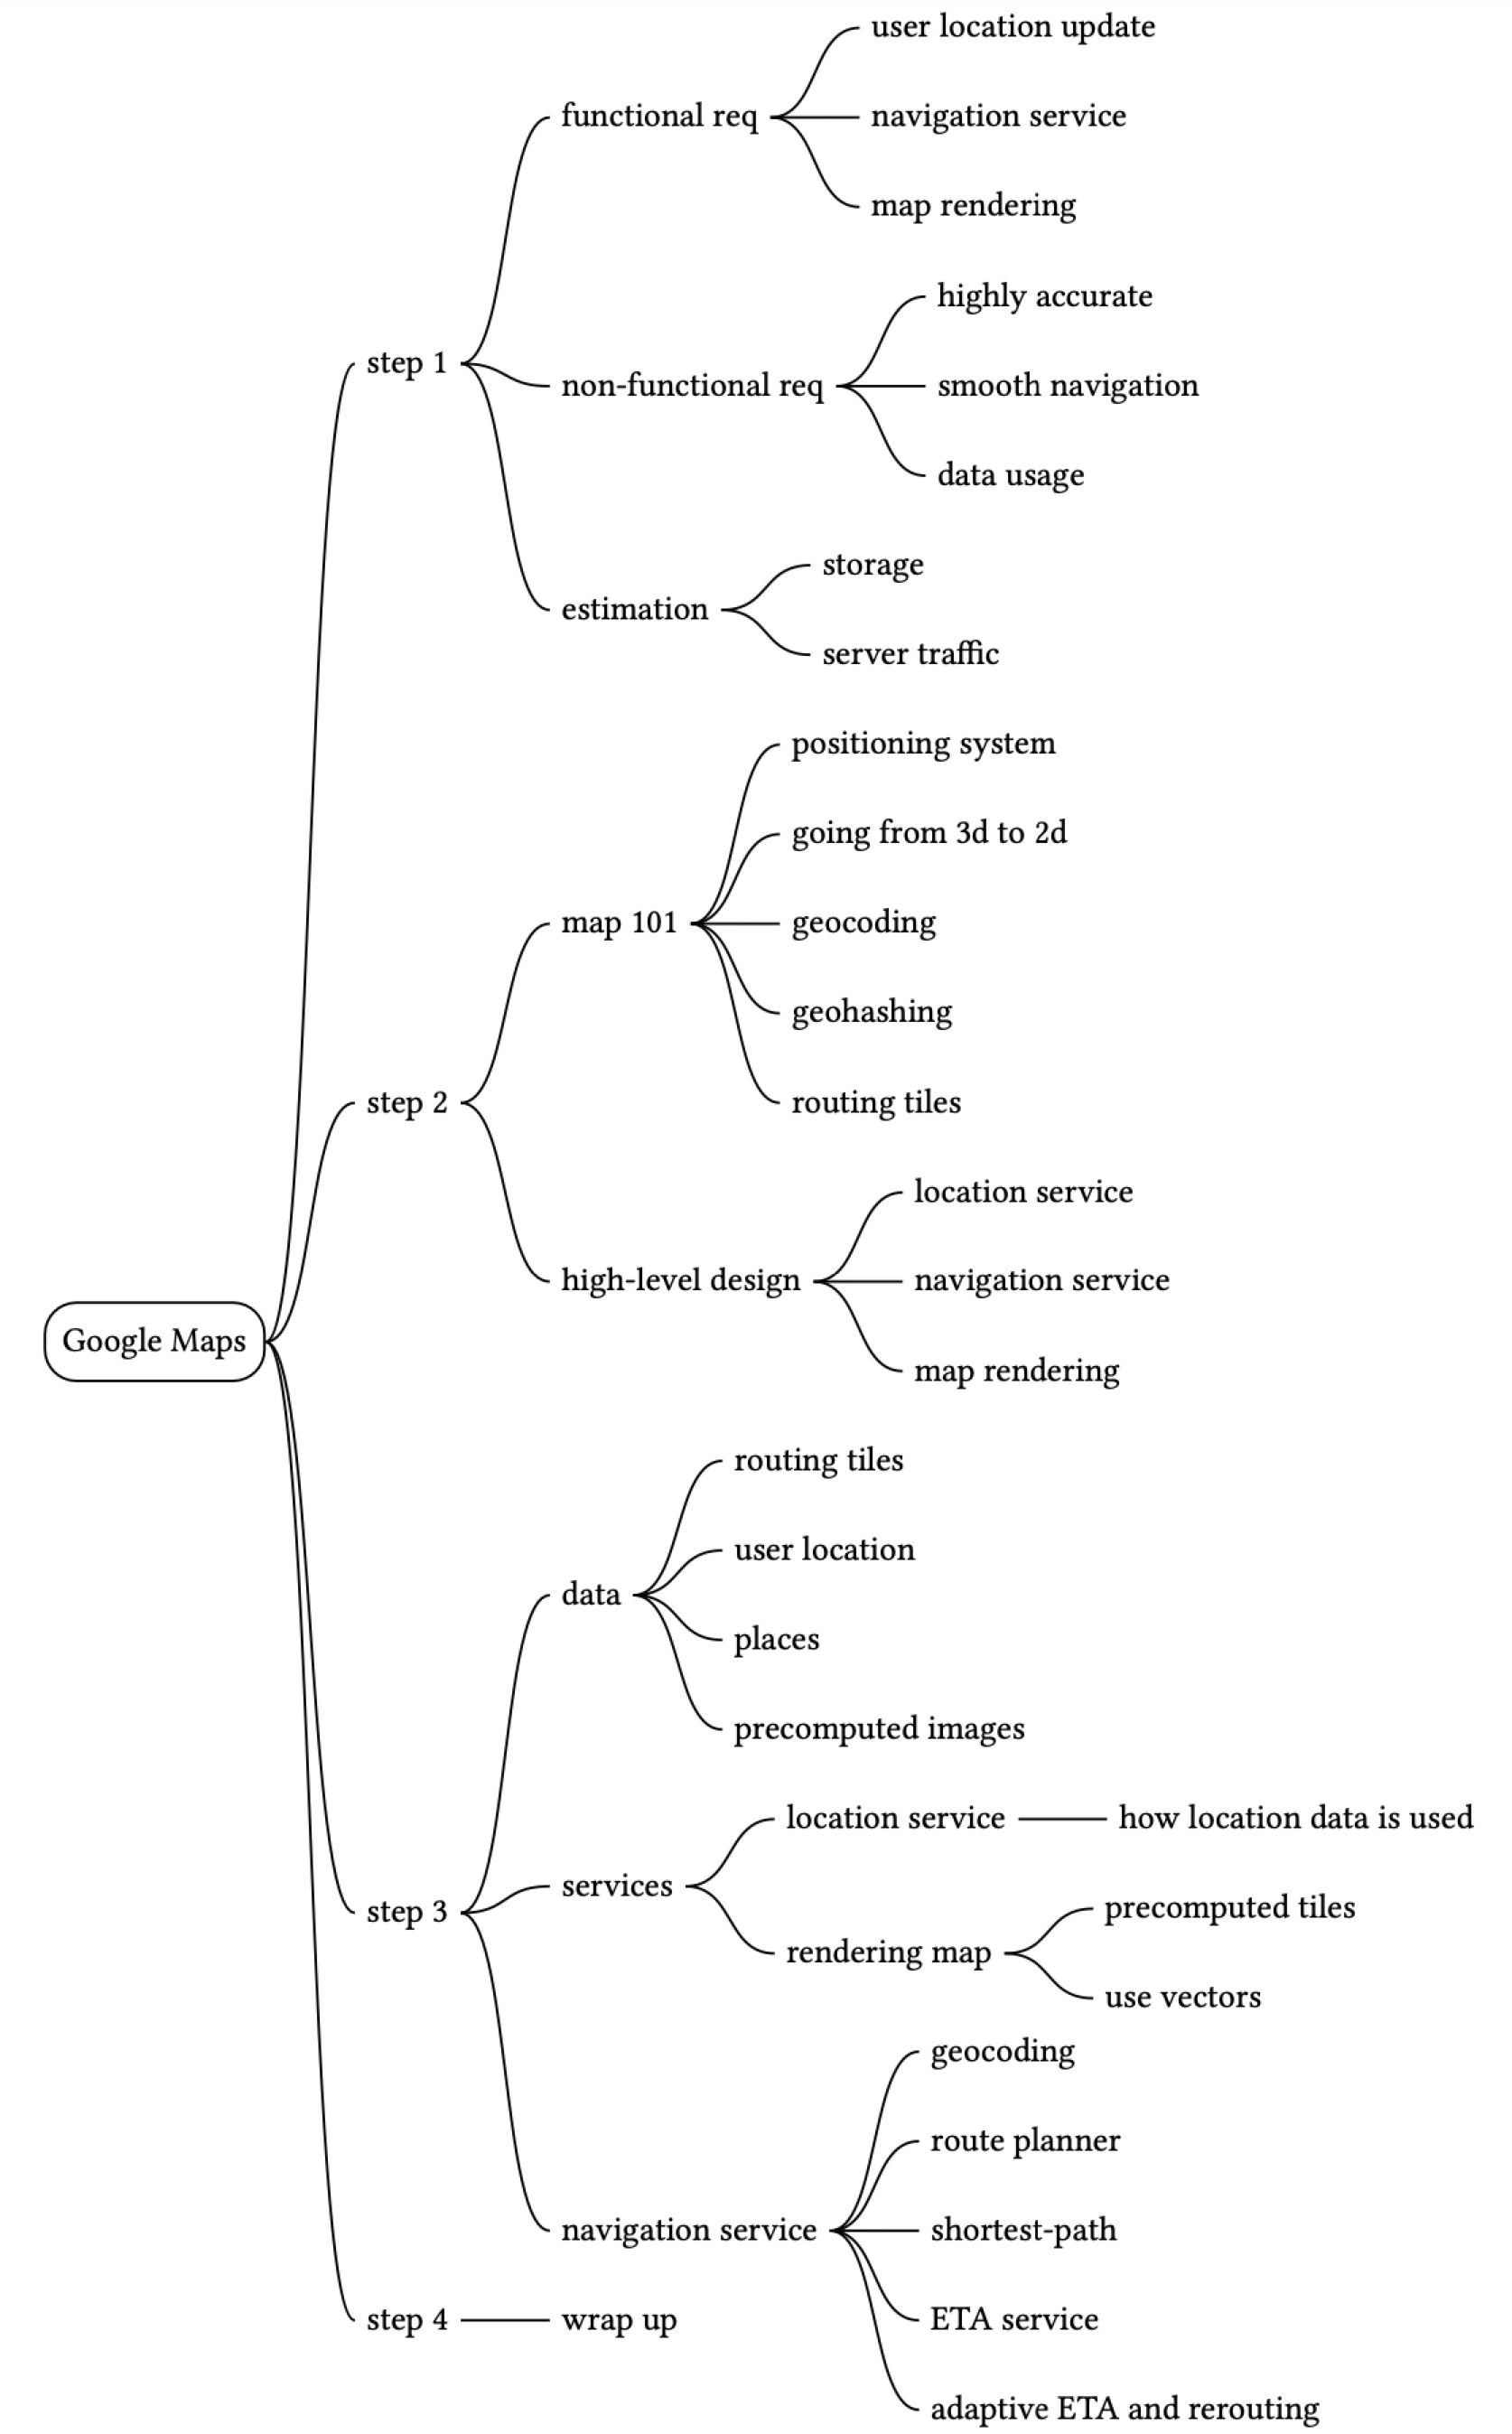
Краткое содержание главы
Справочные материалы
[1] Google Maps: https://developers.google.com/maps?hl=en_US
[2] Google Maps Platform: https://cloud.google.com/maps-platform/
[3] Stamen Design: http://maps.stamen.com
[4] OpenStreetMap: https://www.openstreetmap.org
[5] Prototyping a Smoother Map:
https://medium.com/google-design/google-maps-cb0326d165f5
[6] Mercator projection: https://en.wikipedia.org/wiki/Mercator_projection
[7] Peirce quincuncial projection:
https://en.wikipedia.org/wiki/Peirce_quincuncial_projection
[8] Gall–Peters projection: https://en.wikipedia.org/wiki/Gall–Peters_projection
[9] Winkel tripel projection: https://en.wikipedia.org/wiki/Winkel_tripel_projection
[10] Address geocoding: https://en.wikipedia.org/wiki/Address_geocoding
[11] Geohashing:
https://kousiknath.medium.com/system-design-design-a-geo-spatial-index-for-real-time-location-search-10968fe62b9c
[12] HTTP keep-alive: https://en.wikipedia.org/wiki/HTTP_persistent_connection
[13] Directions API: https://developers.google.com/maps/documentation/directions/start?hl=en_US
[14] Adjacency list: https://en.wikipedia.org/wiki/Adjacency_list
[15] CAP theorem: https://en.wikipedia.org/wiki/CAP_theorem
[16] ETAs with GNNs:
https://deepmind.com/blog/article/traffic-prediction-with-advanced-graph-neural-networks
[17] Google Maps 101: How AI helps predict traffic and determine routes:
https://blog.google/products/maps/google-maps-101-how-ai-helps-predict-traffic-and-determine-routes/