Google Drive
В последние годы cloud storage services, такие как Google Drive, Dropbox, Microsoft OneDrive и Apple iCloud, стали очень популярны. В этой главе нужно спроектировать Google Drive.
Прежде чем переходить к дизайну, полезно кратко понять, что такое Google Drive. Это сервис хранения и синхронизации файлов, который позволяет хранить документы, фотографии, видео и другие файлы в облаке. Вы можете получать доступ к своим файлам с компьютера, смартфона и планшета, а также легко делиться ими с друзьями, семьей и коллегами [1]. На рисунках 1 и 2 показано, как Google Drive выглядит в браузере и в мобильном приложении.
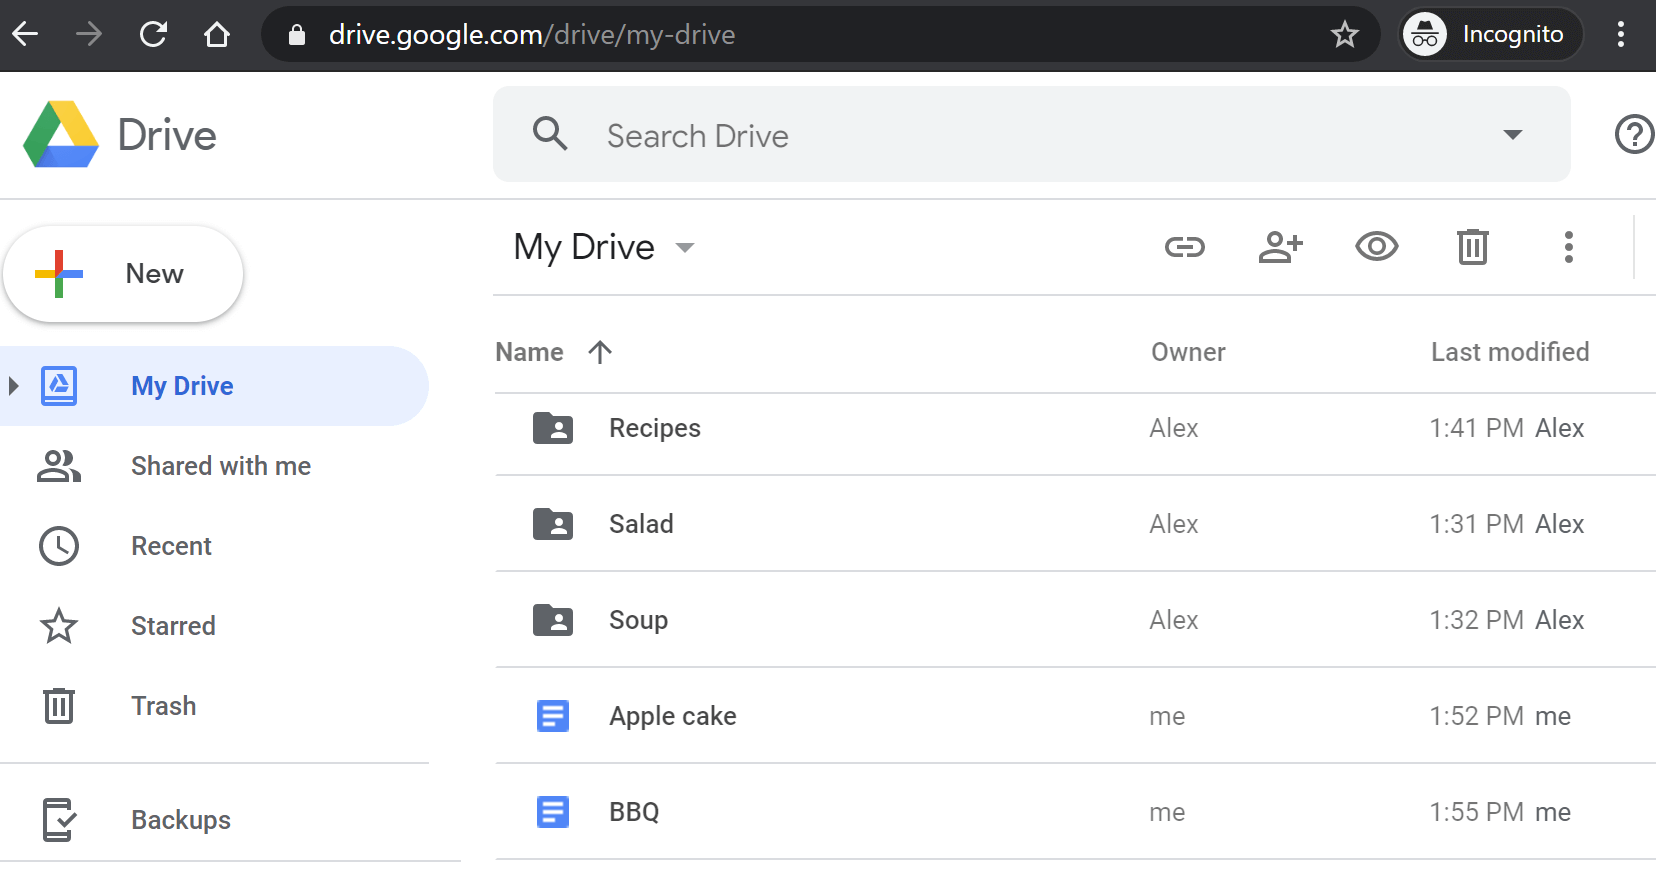
Рисунок 1
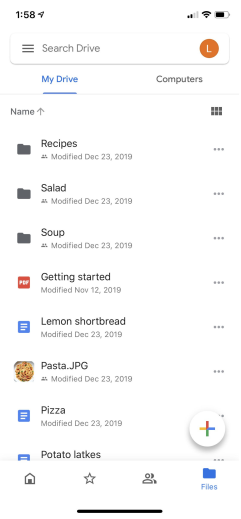
Рисунок 2
Шаг 1 — Понять задачу и определить рамки дизайна
Проектирование Google Drive — большая задача, поэтому важно задавать вопросы, чтобы сузить scope.
Кандидат: Какие функции самые важные?
Интервьюер: Upload и download файлов, file sync и notifications.
Кандидат: Это mobile app, web app или и то и другое?
Интервьюер: И то и другое.
Кандидат: Какие file formats поддерживаются?
Интервьюер: Любой тип файла.
Кандидат: Нужно ли шифровать файлы?
Интервьюер: Да, файлы в storage должны быть encrypted.
Кандидат: Есть ли лимит на размер файла?
Интервьюер: Да, файл должен быть не больше 10 ГБ.
Кандидат: Сколько у продукта пользователей?
Интервьюер: 10 миллионов DAU.
В этой главе мы фокусируемся на следующих возможностях:
-
Добавление файлов. Самый простой способ — drag and drop в Google Drive.
-
Скачивание файлов.
-
Синхронизация файлов между несколькими устройствами. Если файл добавлен на одном устройстве, он автоматически синхронизируется на других.
-
Просмотр file revisions.
-
Шаринг файлов с друзьями, семьей и коллегами.
-
Уведомления, когда файл отредактирован, удален или им поделились с вами.
Вне scope этой главы:
- Редактирование и совместная работа в Google Docs. Это отдельная большая тема.
Кроме функциональных требований, важно понимать и нефункциональные:
-
Reliability. Для storage system надежность критична. Потеря данных недопустима.
-
Fast sync speed. Если sync идет слишком долго, пользователи теряют терпение и уходят.
-
Bandwidth usage. Если продукт тратит слишком много сетевого трафика впустую, пользователи будут недовольны, особенно на мобильных тарифах.
-
Scalability. Система должна выдерживать большие объемы трафика.
-
High availability. Пользователи должны продолжать пользоваться системой, даже если часть серверов недоступна, замедлена или столкнулась с сетевыми ошибками.
Оценка на салфетке
-
Предположим, в приложении 50 миллионов зарегистрированных пользователей и 10 миллионов DAU.
-
Пользователи получают 10 ГБ бесплатного пространства.
-
Предположим, что пользователь загружает 2 файла в день. Средний размер файла — 500 КБ.
-
Соотношение чтений и записей — 1:1.
-
Общий выделенный объем:
50 million * 10 GB = 500 petabyte -
QPS для upload API:
10 million * 2 uploads / 24 hours / 3600 seconds ≈ 240 -
Peak QPS =
QPS * 2 = 480
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
Вместо того чтобы сразу рисовать большой high-level diagram, начнем с простого варианта: соберем все на одном сервере, а потом постепенно масштабируем до миллионов пользователей. Это полезное упражнение, потому что оно освежает ряд важных тем из курса.
Начнем с single server setup:
-
Web server для upload и download файлов.
-
Database для metadata: user data, login info, file info и т. д.
-
Storage system для самих файлов. Предположим, у нас есть 1 ТБ пространства.
Мы быстро поднимаем Apache web server, MySQL database и каталог _drive/ как root directory для
хранения uploaded files. Внутри _drive/ есть набор директорий, которые называются namespaces.
Каждый namespace содержит все загруженные файлы конкретного пользователя. Имя файла на сервере
сохраняется тем же, что у оригинала. Каждый файл или каталог можно уникально идентифицировать,
объединив namespace и relative path.
На рисунке 3 показан пример структуры каталога /drive: слева компактный вид, справа — expanded.

Рисунок 3
API
Как выглядят API? Нам в первую очередь нужны 3 API: upload file, download file и get file revisions.
1. Upload файла в Google Drive
Поддерживаются два типа upload:
-
Simple upload. Используется, когда файл маленький.
-
Resumable upload. Используется, когда файл большой и велика вероятность сетевого прерывания.
Пример resumable upload API:
https://api.example.com/files/upload?uploadType=resumable
Параметры:
-
uploadType=resumable -
data: локальный файл, который нужно загрузить.
Resumable upload реализуется в три шага [2]:
-
Отправить initial request, чтобы получить resumable URL.
-
Загружать данные и отслеживать upload state.
-
Если upload прервался, продолжить его.
2. Download файла из Google Drive
Пример API: https://api.example.com/files/download
Параметры:
path: путь до скачиваемого файла.
Пример параметров:
{
  "path": "/recipes/soup/best_soup.txt"
}
3. Получить file revisions
Пример API: https://api.example.com/files/list_revisions
Параметры:
-
path: путь к файлу, для которого нужна история revisions. -
limit: максимальное количество revisions в ответе.
Пример:
{
  "path": "/recipes/soup/best_soup.txt",
  "limit": 20
}
Все API требуют user authentication и используют HTTPS. SSL защищает передачу данных между клиентом и backend servers.
Уход от single server
По мере роста числа uploaded files рано или поздно появится предупреждение о нехватке места, как на рисунке 4.
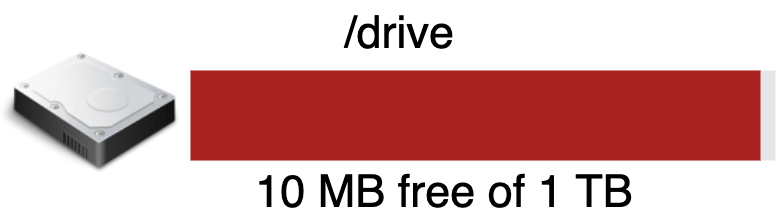
Рисунок 4
Осталось всего 10 МБ! Пользователи уже не могут загружать новые файлы. Первая мысль — шардировать данные и хранить их на нескольких storage servers. На рисунке 5 показан пример sharding по user_id.

Рисунок 5
После срочной настройки database sharding все снова начинает работать. Но остается тревога о возможной потере данных при сбое storage server. Коллега подсказывает, что многие крупные компании используют Amazon S3. Это object storage service с высокой scalability, availability, security и performance [3]. После изучения темы становится понятно, что S3 подходит.
Amazon S3 поддерживает same-region и cross-region replication. Region — это географическая зона, в которой AWS держит data centers. Как показано на рисунке 6, данные можно реплицировать в том же region или между разными regions. Такая избыточность защищает от потери данных и повышает availability. Bucket здесь аналогичен папке в файловой системе.

Рисунок 6
После переноса файлов в S3 можно уже спокойно спать, не переживая о потере данных. Но чтобы такие проблемы не возникали снова, имеет смысл улучшить еще несколько зон:
-
Load balancer: добавить load balancer для распределения сетевого трафика. Он помогает балансировать нагрузку и перераспределять трафик при падении web server.
-
Web servers: после добавления load balancer web servers можно легко добавлять и удалять в зависимости от трафика.
-
Metadata database: вынести database из сервера, чтобы убрать single point of failure. Заодно настроить replication и sharding.
-
File storage: использовать Amazon S3 для хранения файлов. Чтобы обеспечить availability и durability, файлы реплицируются в двух отдельных географических регионах.
После этих улучшений web servers, metadata database и file storage уже decoupled от single server. Обновленный дизайн показан на рисунке 7.
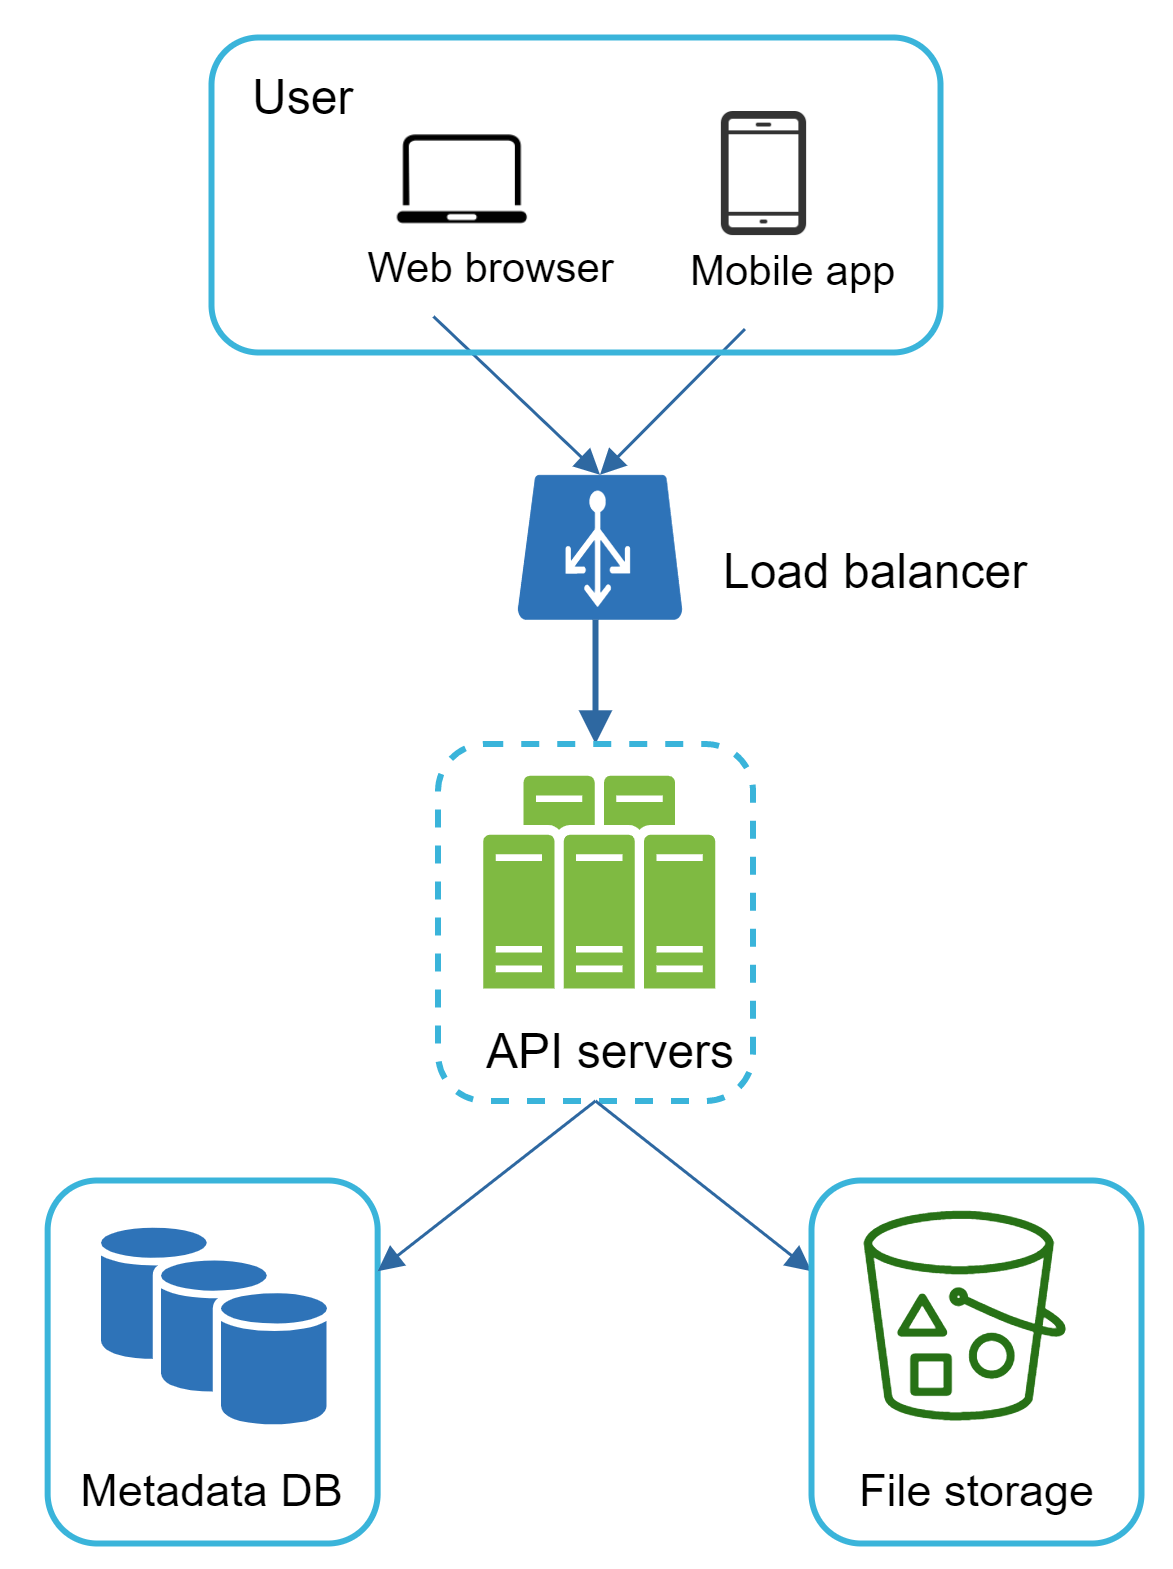
Рисунок 7
Sync conflicts
Для большой storage system вроде Google Drive sync conflicts неизбежны. Если два пользователя одновременно изменяют один и тот же файл или каталог, возникает конфликт. Наша стратегия такая: выигрывает версия, которая первой была обработана системой; та версия, что пришла позже, получает conflict. На рисунке 8 показан пример.

Рисунок 8
На рисунке 8 user 1 и user 2 одновременно обновляют один и тот же файл. Но файл пользователя 1 обрабатывается системой первым. Обновление user 1 проходит, а user 2 получает sync conflict. Как его разрулить? Система показывает обе копии файла: локальную версию user 2 и последнюю версию с сервера, как на рисунке 9. После этого user 2 может либо объединить их, либо перезаписать одну версией другой.
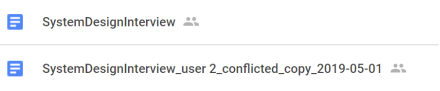
Рисунок 9
Если несколько пользователей одновременно редактируют один и тот же документ, поддерживать синхронизацию гораздо сложнее. Заинтересованным читателям стоит посмотреть материалы [4] [5].
Высокоуровневый дизайн
На рисунке 10 показан предлагаемый high-level design. Разберем каждый компонент.
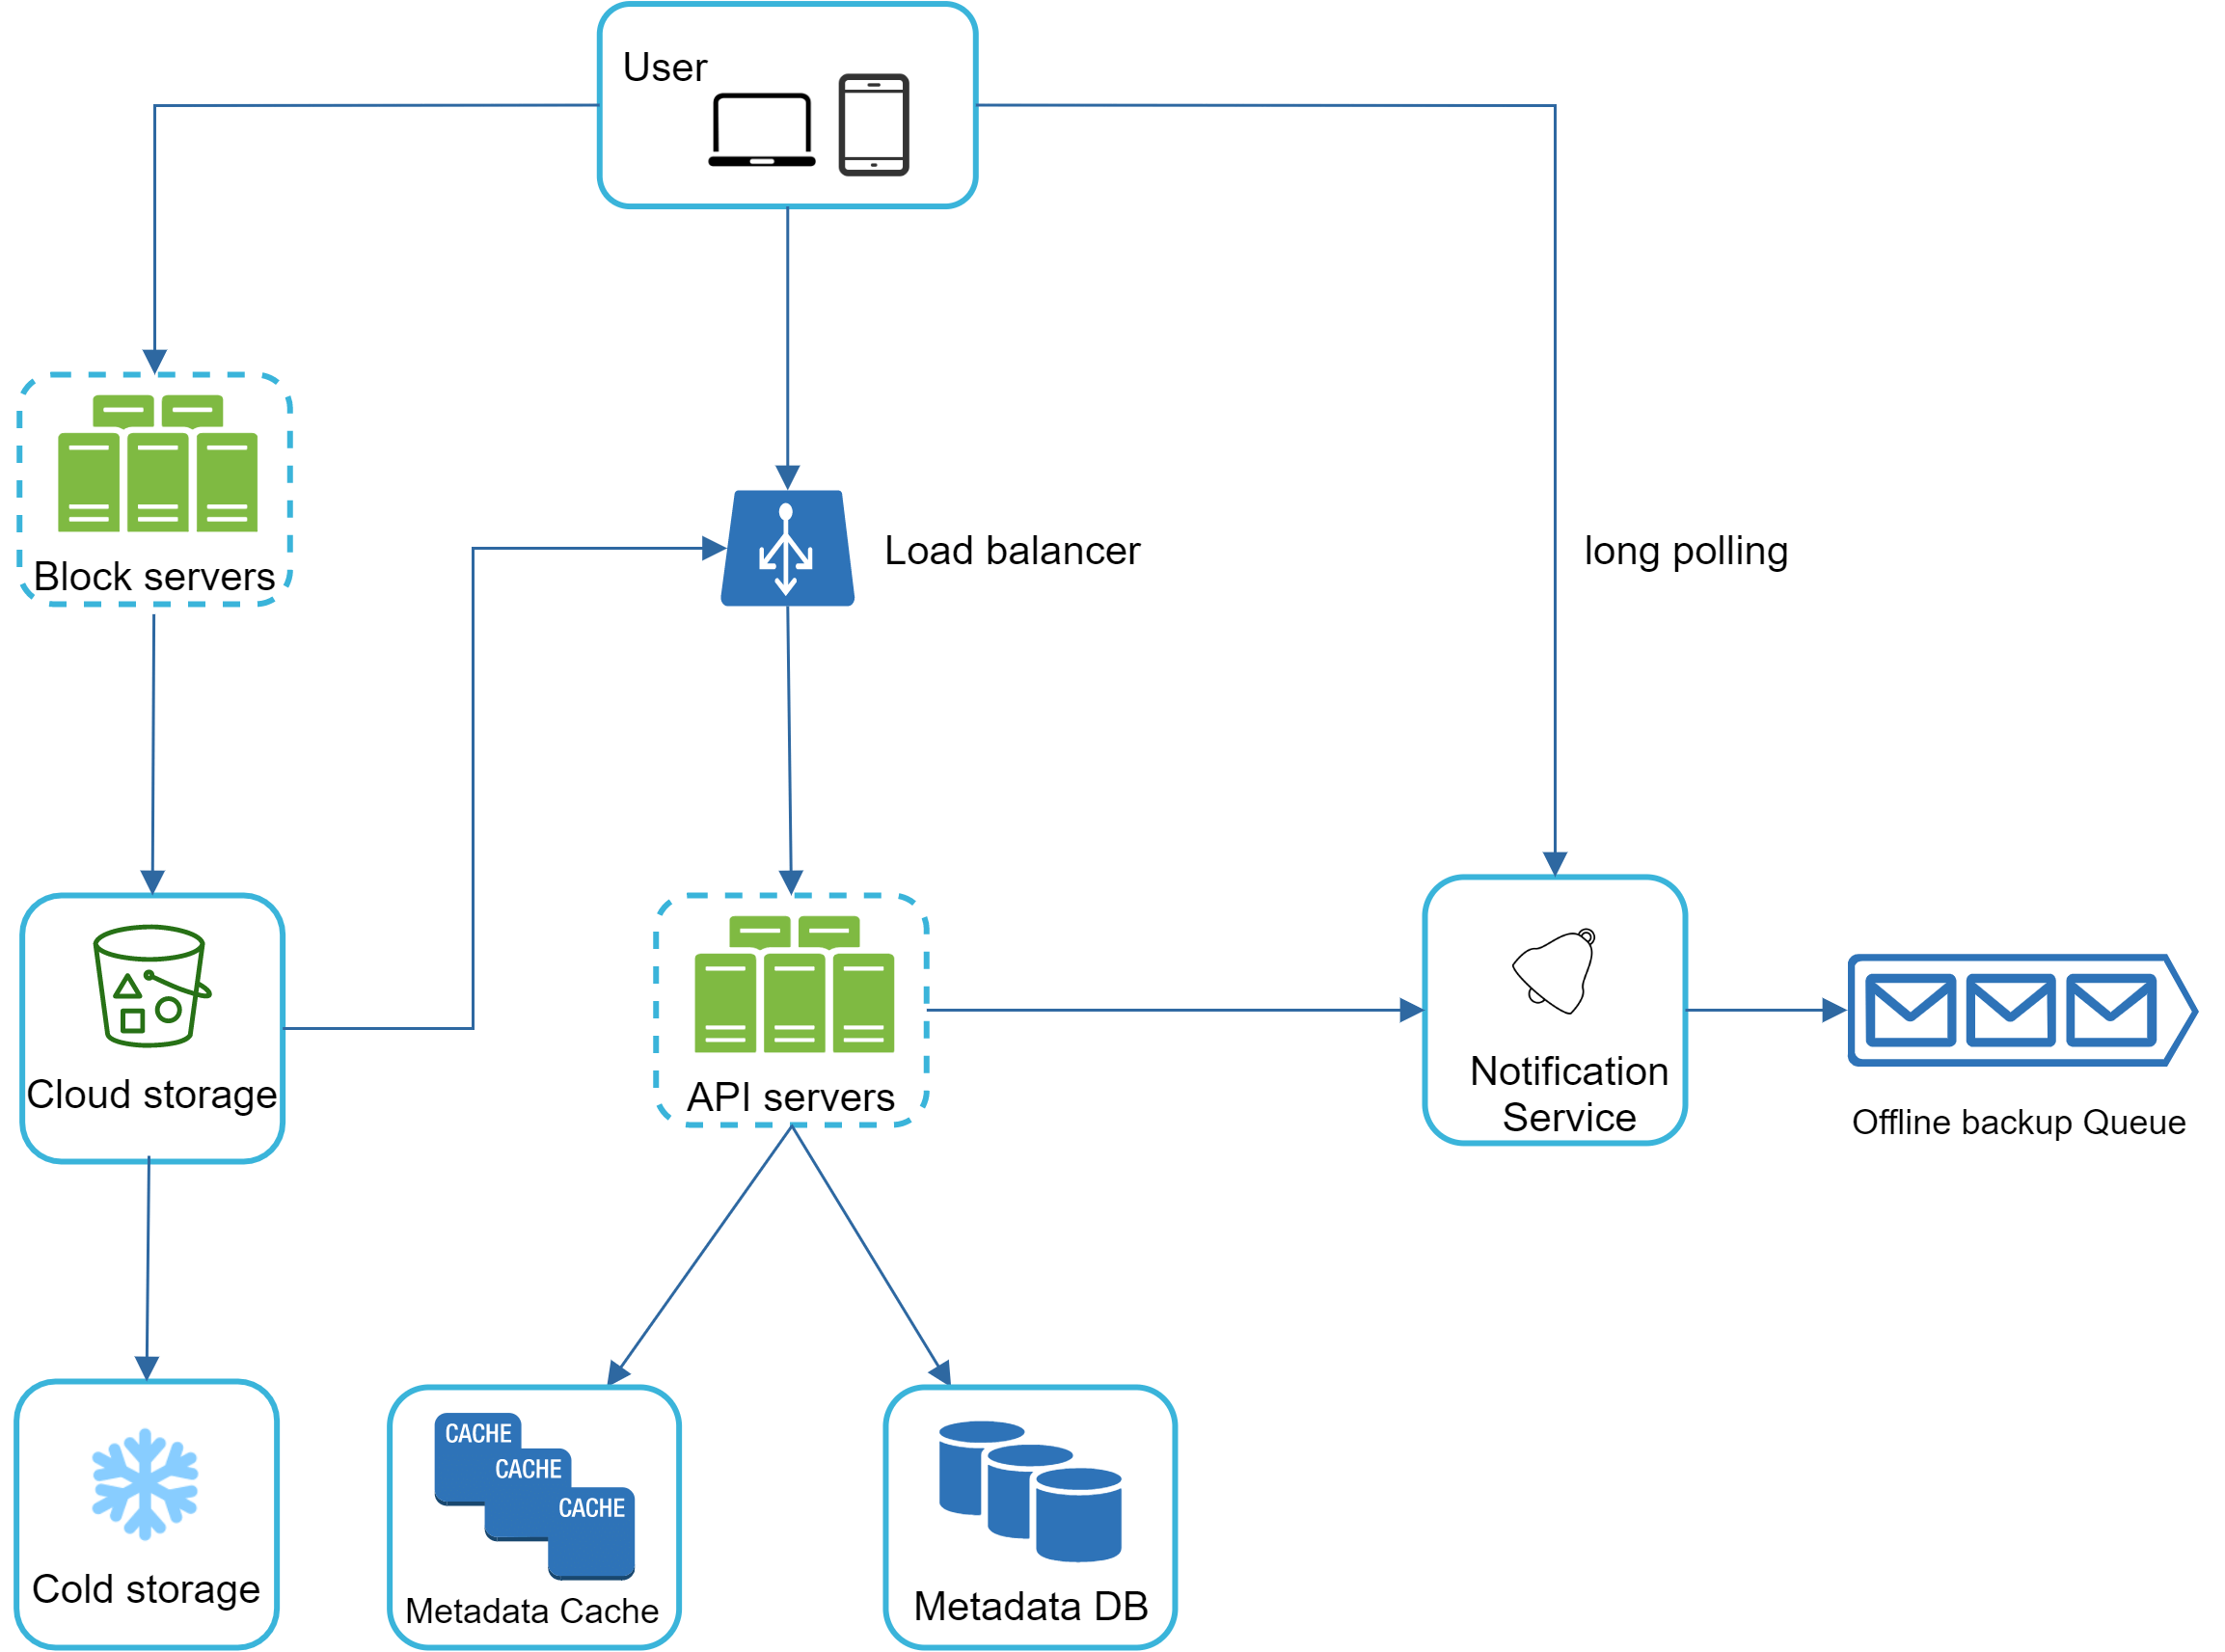
Рисунок 10
User: пользователь работает через browser или mobile app.
Block servers: block servers загружают blocks в cloud storage. Block-level storage — это способ хранить файлы по блокам в cloud environment. Файл делится на несколько blocks, каждому из которых назначается уникальный hash. Эти hashes сохраняются в metadata database. Каждый block хранится как независимый объект в storage system (S3). Чтобы восстановить файл, blocks соединяются в правильном порядке. В качестве block size можно ориентироваться на Dropbox: у него максимальный размер блока 4 МБ [6].
Cloud storage: файл разбивается на smaller blocks и хранится в облачном storage.
Cold storage: storage system для inactive data, то есть файлов, к которым долго не обращались.
Load balancer: равномерно распределяет запросы между API servers.
API servers: отвечают почти за все, кроме самого upload flow. Они занимаются user authentication, user profile, обновлением file metadata и т. д.
Metadata database: хранит metadata о users, files, blocks, versions и т. д. Сами файлы лежат в облаке, а в database — только metadata.
Metadata cache: часть metadata кэшируется для быстрого доступа.
Notification service: publisher/subscriber system, которая доставляет клиентам события при изменениях. В нашем случае она уведомляет клиентов, когда файл где-то был добавлен, изменен или удален, чтобы они могли подтянуть актуальные изменения.
Offline backup queue: если клиент offline и не может сразу получить изменения, информация о них кладется в backup queue и синхронизируется, когда клиент снова онлайн.
На high-level дизайн готов. Теперь подробнее разберем сложные части: block servers, metadata database, upload flow, download flow, notification service, экономию storage space и failure handling.
Шаг 3 — Детальный разбор дизайна
Block servers
Для больших файлов, которые часто меняются, пересылать весь файл при каждом обновлении слишком дорого по bandwidth. Чтобы уменьшить сетевой трафик, предлагаются две оптимизации:
-
Delta sync. Когда файл изменяется, синхронизируются только измененные blocks, а не весь файл целиком [7] [8].
-
Compression. Сжатие blocks заметно уменьшает размер данных. Поэтому blocks сжимаются алгоритмами, подобранными под file type. Например,
gzipиbzip2подходят для текстовых файлов. Для изображений и видео нужны другие алгоритмы.
В нашей системе block servers выполняют основную тяжелую работу по upload. Они принимают файл от клиента, разбивают его на blocks, сжимают и encrypt каждый block. В storage system передаются только измененные blocks, а не весь файл.
На рисунке 11 показано, как block server работает при добавлении нового файла.
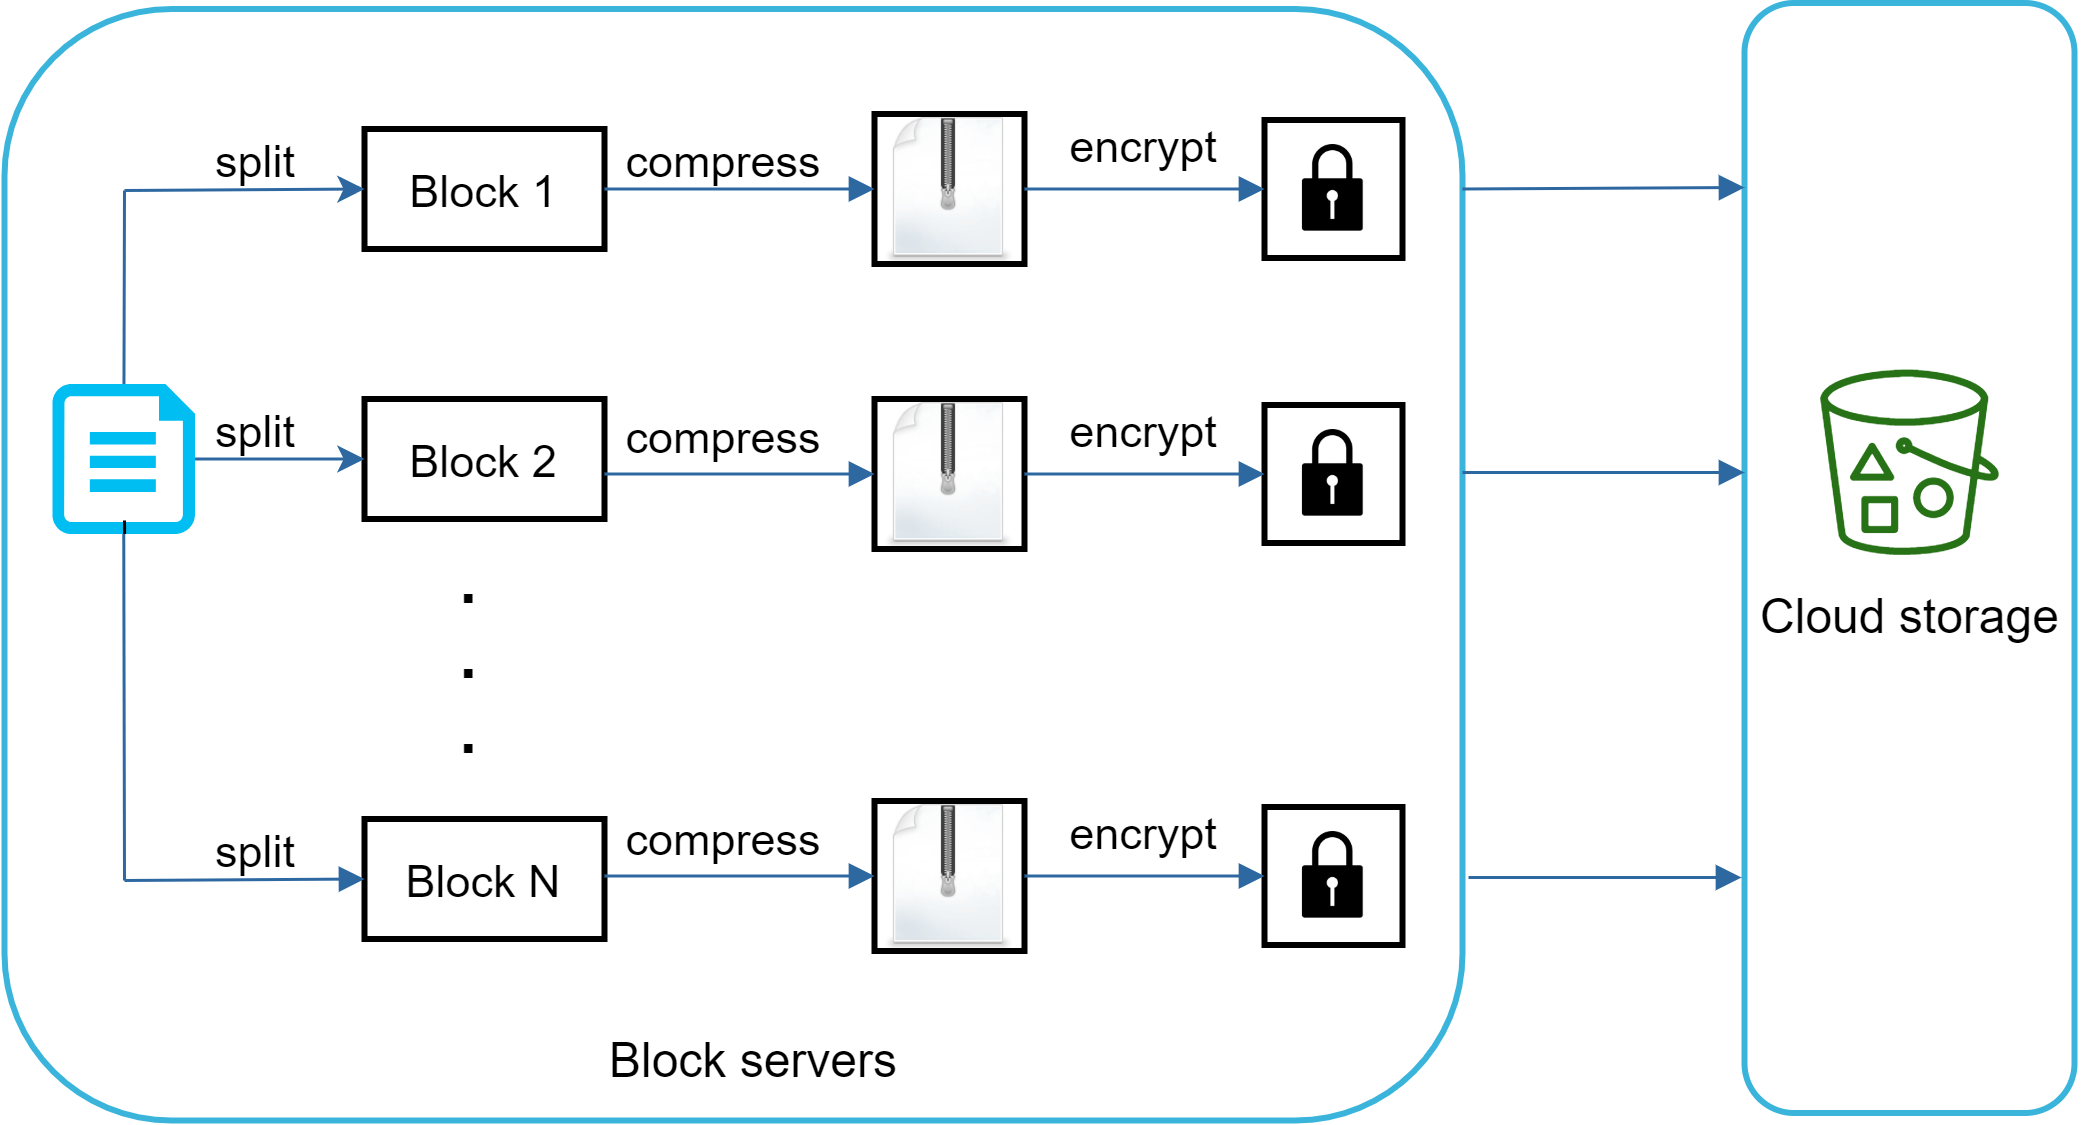
Рисунок 11
-
Файл делится на smaller blocks.
-
Каждый block сжимается.
-
Для безопасности каждый block шифруется перед отправкой в cloud storage.
-
Blocks загружаются в cloud storage.
На рисунке 12 показан delta sync: в cloud storage отправляются только измененные blocks. В примере
изменились block 2 и block 5, и только они загружаются заново.

Рисунок 12
Таким образом, block servers помогают экономить network traffic за счет delta sync и compression.
Высокие требования к consistency
Наша система по умолчанию требует strong consistency. Недопустимо, чтобы один и тот же файл одновременно отображался по-разному на разных клиентах. Поэтому strong consistency нужна и в metadata cache, и в database layer.
Memory caches по умолчанию обычно используют eventual consistency, а значит разные replicas могут временно иметь разные данные. Чтобы добиться strong consistency, нужно обеспечить:
-
Консистентность между cache replicas и master.
-
Invalidate caches при записи в database, чтобы cache и database всегда содержали одно и то же.
В relational database strong consistency получить проще, потому что она поддерживает ACID properties [9]. NoSQL databases по умолчанию ACID обычно не дают, и тогда синхронизацию приходится реализовывать программно. В нашем дизайне мы выбираем relational database, потому что поддержка ACID есть нативно.
Metadata database
На рисунке 13 показан дизайн schema. Это сильно упрощенная версия, включающая только самые важные таблицы и поля.
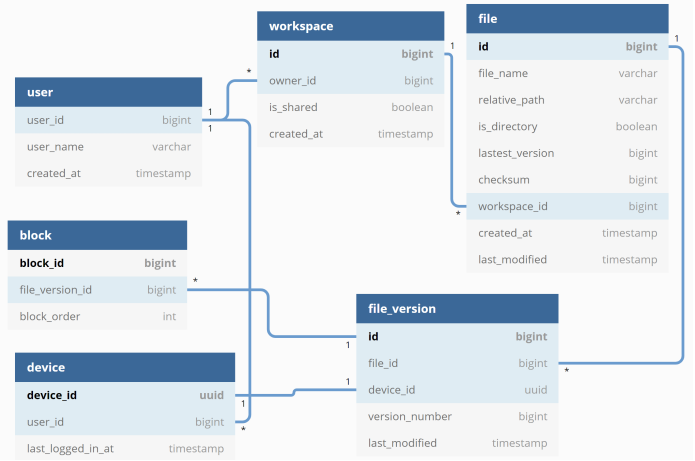
Рисунок 13
User: хранит базовую информацию о пользователе: username, email, profile photo и т. д.
Device: хранит информацию об устройстве. push_id используется для mobile push notifications.
У одного user может быть несколько devices.
Namespace: корневая директория пользователя.
File: хранит информацию о текущем состоянии файла.
File_version: хранит историю версий файла. Уже существующие строки read-only, чтобы сохранить целостность revision history.
Block: хранит все, что относится к file block. Любая версия файла может быть восстановлена путем соединения всех blocks в правильном порядке.
Upload flow
Теперь посмотрим, что происходит, когда клиент загружает файл. Для наглядности удобно использовать sequence diagram, как на рисунке 14.

Рисунок 14
На рисунке 14 параллельно отправляются два запроса: добавить file metadata и загрузить файл в cloud storage. Оба идут от client 1.
Добавление file metadata
-
Client 1 отправляет запрос на добавление metadata нового файла.
-
Новая file metadata сохраняется в metadata DB, а file upload status меняется на
pending. -
Notification service получает сообщение о том, что начинается добавление нового файла.
-
Notification service уведомляет relevant clients (например, client 2), что файл загружается.
Upload файла в cloud storage
2.1 Client 1 отправляет содержимое файла в block servers.
2.2 Block servers разбивают файл на blocks, сжимают их, encrypt и загружают в cloud storage.
2.3 После завершения upload cloud storage вызывает upload completion callback, и запрос идет на API servers.
2.4 Статус файла в metadata DB меняется на uploaded.
2.5 Notification service получает событие о смене file status на uploaded.
2.6 Notification service уведомляет relevant clients (например, client 2), что файл полностью загружен.
При редактировании файла flow похожий, поэтому отдельно его повторять не будем.
Download flow
Download flow срабатывает, когда файл где-то был добавлен или изменен. Как клиент узнает, что файл обновился на другом устройстве?
-
Если client A online в момент, когда файл изменяет другой клиент, notification service сообщает ему, что где-то произошли изменения и нужно подтянуть свежие данные.
-
Если client A offline в момент изменения, информация сохраняется в cache/queue. Когда клиент снова online, он вытягивает последние изменения.
После того как клиент узнал об изменении, он сначала запрашивает metadata через API servers, а затем скачивает blocks и реконструирует файл. Подробный flow показан на рисунке 15.

Рисунок 15
-
Notification service сообщает client 2, что файл изменился где-то еще.
-
Узнав об обновлениях, client 2 запрашивает metadata.
-
API servers идут в metadata DB за metadata изменений.
-
Metadata возвращается обратно в API servers.
-
Client 2 получает metadata.
-
Получив metadata, client 2 отправляет запросы на download blocks в block servers.
-
Block servers сначала скачивают blocks из cloud storage.
-
Cloud storage возвращает blocks в block servers.
-
Client 2 скачивает все новые blocks и восстанавливает файл.
Notification service
Чтобы сохранять consistency файлов, любое локальное изменение файла должно быть донесено до других клиентов, чтобы уменьшать число конфликтов. Для этого и нужна notification service. На high-level она доставляет изменения клиентам по мере возникновения событий. Здесь есть два варианта:
-
Long polling. Dropbox использует long polling [10].
-
WebSocket. WebSocket дает persistent connection между клиентом и сервером и поддерживает bi-directional communication.
Хотя оба варианта рабочие, мы выбираем long polling по двум причинам:
-
Коммуникация для notification service не двусторонняя. Сервер сообщает клиенту о file changes, а не наоборот.
-
WebSocket лучше подходит для real-time bi-directional communication, например для chat app. В Google Drive уведомления идут нечасто и без резких burst.
При long polling каждый клиент держит long-poll connection с notification service. Если файл изменяется, сервер закрывает connection. Закрытие connection означает, что клиент должен обратиться к metadata server и скачать последние изменения. После получения ответа или timeout клиент сразу открывает новый long-poll request.
Экономия storage space
Чтобы поддерживать file version history и надежность, система хранит несколько версий одного и того же файла, причем еще и в нескольких data centers. Из-за этого storage может быстро заполняться. Чтобы сократить затраты, предлагаются три техники:
-
Deduplicate blocks. Удаление дубликатов blocks хотя бы на уровне одного аккаунта уже дает экономию. Два blocks считаются одинаковыми, если у них одинаковый hash.
-
Использовать intelligent data backup strategy. Здесь возможны две оптимизации:
-
Set a limit: можно ограничить число хранимых versions. Если лимит достигнут, oldest version заменяется новой.
-
Keep valuable versions only: некоторые файлы редактируются очень часто. Например, heavily modified document может получить больше 1000 сохранений за короткое время. Чтобы избежать лишних копий, можно ограничивать число versions, отдавая больший вес недавним.
-
Перемещать редко используемые данные в cold storage. Cold data — это данные, к которым не обращались месяцами или годами. Cold storage вроде Amazon S3 Glacier [11] заметно дешевле.
Обработка сбоев
В большой системе failures неизбежны, поэтому нужно продумывать защиту от них. Интервьюеру может быть интересно, как система обрабатывает такие случаи:
-
Load balancer failure: если один load balancer падает, secondary становится active и принимает трафик. Load balancers обычно следят друг за другом с помощью heartbeat.
-
Block server failure: если один block server падает, остальные подбирают unfinished и pending jobs.
-
Cloud storage failure: S3 buckets реплицируются в нескольких regions. Если в одном регионе файл недоступен, его можно взять из другого.
-
API server failure: это stateless service, поэтому traffic просто перенаправляется на другие API servers через load balancer.
-
Metadata cache failure: metadata cache servers реплицируются. Если один node падает, данные можно получить с других, а затем поднять replacement server.
-
Metadata DB failure:
-
Master down: если master падает, одного из slaves повышают до нового master и поднимают новый slave.
-
Slave down: если slave упал, чтения идут с другого slave, а взамен запускается новый database server.
-
Notification service failure: каждый online user держит long-poll connection с notification server. Поэтому на каждом таком сервере может висеть очень много соединений. По данным Dropbox, на одной машине может быть более миллиона открытых connections. Если такой сервер падает, все long poll connections теряются, и clients должны переподключаться к другим серверам. Хотя один сервер может держать много connections, мгновенно переподключить всех потерянных клиентов он не сможет — это относительно медленный процесс.
-
Offline backup queue failure: queues реплицируются несколько раз. Если одна queue падает, consumers могут переподписаться на backup queue.
Шаг 4 — Подведем итоги
В этой главе мы предложили system design для поддержки Google Drive. Комбинация strong consistency, низкого потребления bandwidth и быстрой sync делает задачу особенно интересной. Наш дизайн содержит два основных flow: управление file metadata и file sync. Еще один важный компонент — notification service, использующая long polling, чтобы держать clients в курсе file changes.
Как и в любой system design interview задаче, идеального решения не существует. У каждой компании свои ограничения, и систему нужно подгонять под них. Важно понимать trade-offs выбранного дизайна и технологий. Если остается немного времени, можно обсудить альтернативные решения.
Например, файлы можно загружать напрямую из клиента в cloud storage, минуя block servers. Плюс этого подхода в том, что upload становится быстрее: файл передается в cloud storage только один раз. В нашем дизайне файл сначала идет на block servers, а потом уже в cloud storage. Но у прямой схемы есть и минусы:
-
Во-первых, одну и ту же логику chunking, compression и encryption пришлось бы реализовывать на разных платформах (iOS, Android, Web). Это error-prone и требует много engineering effort. В нашем дизайне вся эта логика централизована на block servers.
-
Во-вторых, клиентское приложение можно взломать или модифицировать, поэтому переносить encryption logic на client side неидеально.
Еще одно интересное развитие системы — вынести online/offline logic в отдельный service, назовем его presence service. Тогда функциональность presence можно будет легко переиспользовать и в других сервисах.
Поздравляем, вы дошли до этого места! Можно похлопать себя по плечу. Отличная работа!
Справочные материалы
[1] Google Drive: https://www.google.com/drive/
[2] Upload file data:
https://developers.google.com/drive/api/v2/manage-uploads
[3] Amazon S3: https://aws.amazon.com/s3
[4] Differential Synchronization:
https://neil.fraser.name/writing/sync/
[5] Differential Synchronization YouTube talk:
https://www.youtube.com/watch?v=S2Hp_1jqpY8
[6] How We’ve Scaled Dropbox: https://youtu.be/PE4gwstWhmc
[7] Tridgell, A., & Mackerras, P. (1996). The rsync algorithm.
[8] Librsync. (n.d.). Retrieved April 18, 2015, from
https://github.com/librsync/librsync
[9] ACID: https://en.wikipedia.org/wiki/ACID
[10] Dropbox security white paper:
https://assets.dropbox.com/www/en-us/business/solutions/solutions/dfb_security_whitepaper.pdf
[11] Amazon S3 Glacier: https://aws.amazon.com/glacier/faqs/