ID генератор в распределенных системах
В этой главе нужно спроектировать генератор уникальных идентификаторов для распределенных систем. Первой мыслью может быть использование первичного ключа с атрибутом auto_increment в традиционной базе данных. Однако auto_increment не работает в распределенной среде, потому что одного сервера БД недостаточно, а генерировать уникальные идентификаторы сразу в нескольких базах с минимальной задержкой сложно.
Ниже приведены примеры уникальных идентификаторов:
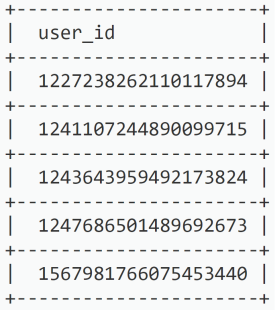
Рисунок 1
Шаг 1 — Понять задачу и определить рамки дизайна
Первый шаг в любой задаче по системному дизайну — задать уточняющие вопросы. Ниже пример диалога между кандидатом и интервьюером:
Кандидат: Какими свойствами должны обладать уникальные ID?
Интервьюер: ID должны быть уникальными и сортируемыми.
Кандидат: Для каждой новой записи ID увеличивается на 1?
Интервьюер: ID увеличивается со временем, но не обязательно строго на 1. ID, созданные
вечером, больше ID, созданных утром того же дня.
Кандидат: ID содержат только числовые значения?
Интервьюер: Да, верно.
Кандидат: Есть ли требования к длине ID?
Интервьюер: ID должен помещаться в 64 бита.
Кандидат: Каков масштаб системы?
Интервьюер: Система должна уметь генерировать 10 000 ID в секунду.
Это лишь часть вопросов, которые можно задать интервьюеру. Важно хорошо понять требования и устранить неясности. Для этой задачи требования таковы:
-
ID должны быть уникальными.
-
ID должны состоять только из чисел.
-
ID должны помещаться в 64 бита.
-
ID должны быть упорядочены по времени.
-
Система должна генерировать более 10 000 уникальных ID в секунду.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
Для генерации уникальных ID в распределенных системах можно использовать несколько подходов. Мы рассмотрим такие варианты:
-
Репликация multi-master
-
Универсально уникальный идентификатор (UUID)
-
Ticket server
-
Подход Twitter Snowflake
Давайте разберем каждый из них, принцип работы, а также плюсы и минусы.
Репликация multi-master
Как показано на рисунке 2, первый подход — multi-master replication.

Рисунок 2
Этот подход использует возможность auto_increment в базах данных. Вместо увеличения следующего ID на 1 мы увеличиваем его на k, где k — количество используемых серверов БД. Как показано на рисунке 2, следующий ID на каждом сервере равен предыдущему ID на этом же сервере плюс 2. Такой подход частично решает проблемы масштабирования, потому что диапазон ID масштабируется вместе с числом серверов БД. Однако у стратегии есть серьезные недостатки:
-
Сложно масштабировать на несколько дата-центров.
-
ID на разных серверах не возрастают глобально вместе со временем.
-
Подход плохо масштабируется при добавлении или удалении сервера.
UUID
UUID — еще один простой способ получить уникальные идентификаторы. UUID — это 128-битное число, используемое для идентификации информации в компьютерных системах. Вероятность коллизии у UUID крайне мала. Согласно Wikipedia, «если генерировать 1 миллиард UUID каждую секунду примерно 100 лет, вероятность получить хотя бы один дубликат достигнет лишь 50%» [1].
Пример UUID: 09c93e62-50b4-468d-bf8a-c07e1040bfb2. UUID можно генерировать независимо, без координации между серверами. На рисунке 3 показан такой дизайн.

Рисунок 3
В этом дизайне каждый web-сервер содержит собственный генератор ID и отвечает за генерацию идентификаторов самостоятельно.
Плюсы:
-
Генерировать UUID просто. Координация между серверами не нужна, поэтому нет проблем с синхронизацией.
-
Система легко масштабируется, потому что каждый web-сервер сам генерирует ID, которые потребляет. Генератор ID масштабируется вместе с web-серверами.
Минусы:
-
Длина ID — 128 бит, тогда как по требованиям нужно 64 бита.
-
ID не возрастают со временем.
-
ID могут быть нечисловыми.
Ticket server
Ticket server — еще один интересный способ генерировать уникальные ID. Компания Flicker разработала ticket servers для генерации распределенных первичных ключей [2]. Полезно понимать, как работает эта система.

Рисунок 4
Идея заключается в использовании централизованного auto_increment на одном сервере базы данных (Ticket Server). Подробнее этот подход описан в инженерном блоге Flicker [2].
Плюсы:
-
Числовые ID.
-
Реализуется просто и хорошо работает для приложений малого и среднего масштаба.
Минусы:
- Единая точка отказа. Если единственный ticket server выйдет из строя, проблемы возникнут у всех систем, которые от него зависят. Чтобы избежать этого, можно поднять несколько ticket server, но это приводит к новым сложностям, например синхронизации данных.
Подход Twitter Snowflake
Предыдущие подходы дают хорошее представление о том, как вообще работают системы генерации ID. Однако ни один из них полностью не удовлетворяет нашим требованиям, поэтому нужен другой вариант. Система генерации уникальных ID Twitter под названием “snowflake” [3] вдохновляет и хорошо подходит под наши требования.
Подход «разделяй и властвуй» здесь очень полезен. Вместо того чтобы генерировать ID как единое целое, мы делим его на несколько частей. На рисунке 5 показана структура 64-битного ID.

Рисунок 5
Каждая секция описана ниже.
-
Знаковый бит: 1 бит. Всегда равен 0. Зарезервирован для будущего использования. Потенциально может использоваться для различения signed и unsigned чисел.
-
Timestamp: 41 бит. Это миллисекунды с эпохи Unix или с некоторой собственной эпохи. Мы используем стандартную эпоху Twitter snowflake
1288834974657, что соответствуетNov 04, 2010, 01:42:54 UTC. -
Datacenter ID: 5 бит, что дает 2 ^ 5 = 32 дата-центра.
-
Machine ID: 5 бит, что дает 2 ^ 5 = 32 машины на дата-центр.
-
Sequence number: 12 бит. Для каждого нового ID, сгенерированного на данной машине или в данном процессе, sequence number увеличивается на 1. Каждый миллисекундный интервал значение сбрасывается в 0.
Шаг 3 — Детальный разбор дизайна
На высоком уровне мы обсудили несколько вариантов построения генератора уникальных ID в распределенной системе. Остановимся на подходе, основанном на Twitter snowflake. Давайте рассмотрим его подробнее. Для удобства снова приведем схему дизайна.

Рисунок 6
Идентификаторы дата-центра и машины выбираются при старте системы и обычно остаются неизменными после запуска. Любые изменения datacenter ID и machine ID требуют особой осторожности, потому что случайное изменение этих значений может привести к конфликтам ID. Timestamp и sequence number генерируются уже во время работы генератора ID.
Timestamp
Самые важные 41 бит составляют секцию timestamp. Поскольку timestamp растет со временем, ID можно сортировать по времени. На рисунке 7 показан пример того, как бинарное представление переводится в UTC. Аналогичным способом можно преобразовать UTC обратно в двоичное представление.

Рисунок 7
Максимальный timestamp, который можно представить в 41 бите, равен:
2 ^ 41 - 1 = 2199023255551 миллисекунд, что дает примерно 69 лет: 2199023255551 ms / 1000 / 365 days / 24 hours / 3600 seconds.
Это означает, что генератор ID будет работать 69 лет, а выбор собственной эпохи, близкой к текущей дате, отодвигает переполнение дальше в будущее. Через 69 лет потребуется новая эпоха либо другая техника миграции ID.
Sequence number
Sequence number занимает 12 бит, что дает 2 ^ 12 = 4096 комбинаций. Это поле равно 0, если на том же сервере за одну миллисекунду не генерируется больше одного ID. Теоретически одна машина может поддерживать максимум 4096 новых ID за миллисекунду.
Шаг 4 — Подведем итоги
В этой главе мы обсудили разные подходы к проектированию генератора уникальных ID: multi-master replication, UUID, ticket server и генератор, похожий на Twitter snowflake. Мы выбрали snowflake, потому что он покрывает все наши требования и хорошо масштабируется в распределенной среде.
Если в конце интервью останется время, можно обсудить еще несколько тем:
-
Синхронизация часов. В нашем дизайне мы предполагаем, что у серверов генерации ID одинаковое время. На практике это может быть неверно, например при работе сервера на нескольких ядрах. Та же проблема возникает и в многомашинной среде. Решения для clock synchronization выходят за рамки этой книги, но важно помнить, что такая проблема существует. Самое популярное решение — Network Time Protocol [4].
-
Настройка длины секций. Например, меньшее число sequence number и большее число timestamp-битов может быть выгодно для систем с низкой конкуренцией и длительным горизонтом жизни.
-
Высокая доступность. Генератор ID — критически важная система, поэтому он должен быть высокодоступным.
Поздравляем, вы дошли до этого места! Можно похлопать себя по плечу. Отличная работа!
Справочные материалы
[1] Universally unique identifier:
https://en.wikipedia.org/wiki/Universally_unique_identifier
[2] Ticket Servers: Distributed Unique Primary Keys on the Cheap:
https://code.flickr.net/2010/02/08/ticket-servers-distributed-unique-primary-keys-on-the-cheap/
[3] Announcing Snowflake:
https://blog.twitter.com/engineering/en_us/a/2010/announcing-snowflake.html
[4] Network time protocol:
https://en.wikipedia.org/wiki/Network_Time_Protocol