Про масштабирование решений
Проектирование системы, способной поддерживать миллионы пользователей, является непростой задачей. Это путь, который требует постоянной доработки и бесконечного улучшения. В этой главе мы построим систему, поддерживающую одного пользователя, а затем постепенно масштабируем ее так, чтобы она обслуживала миллионы пользователей. После прочтения этой главы вы освоите несколько техник, которые помогут вам успешно проходить собеседования по проектированию систем.
Конфигурация с одним сервером
Путешествие в тысячу миль начинается с одного шага, и построение сложной системы ничем не отличается. Начнем с чего-то простого: все работает на одном сервере. На рисунке 1 показана конфигурация с одним сервером, где на одной машине работают веб-приложение, база данных, кэш и т. д.
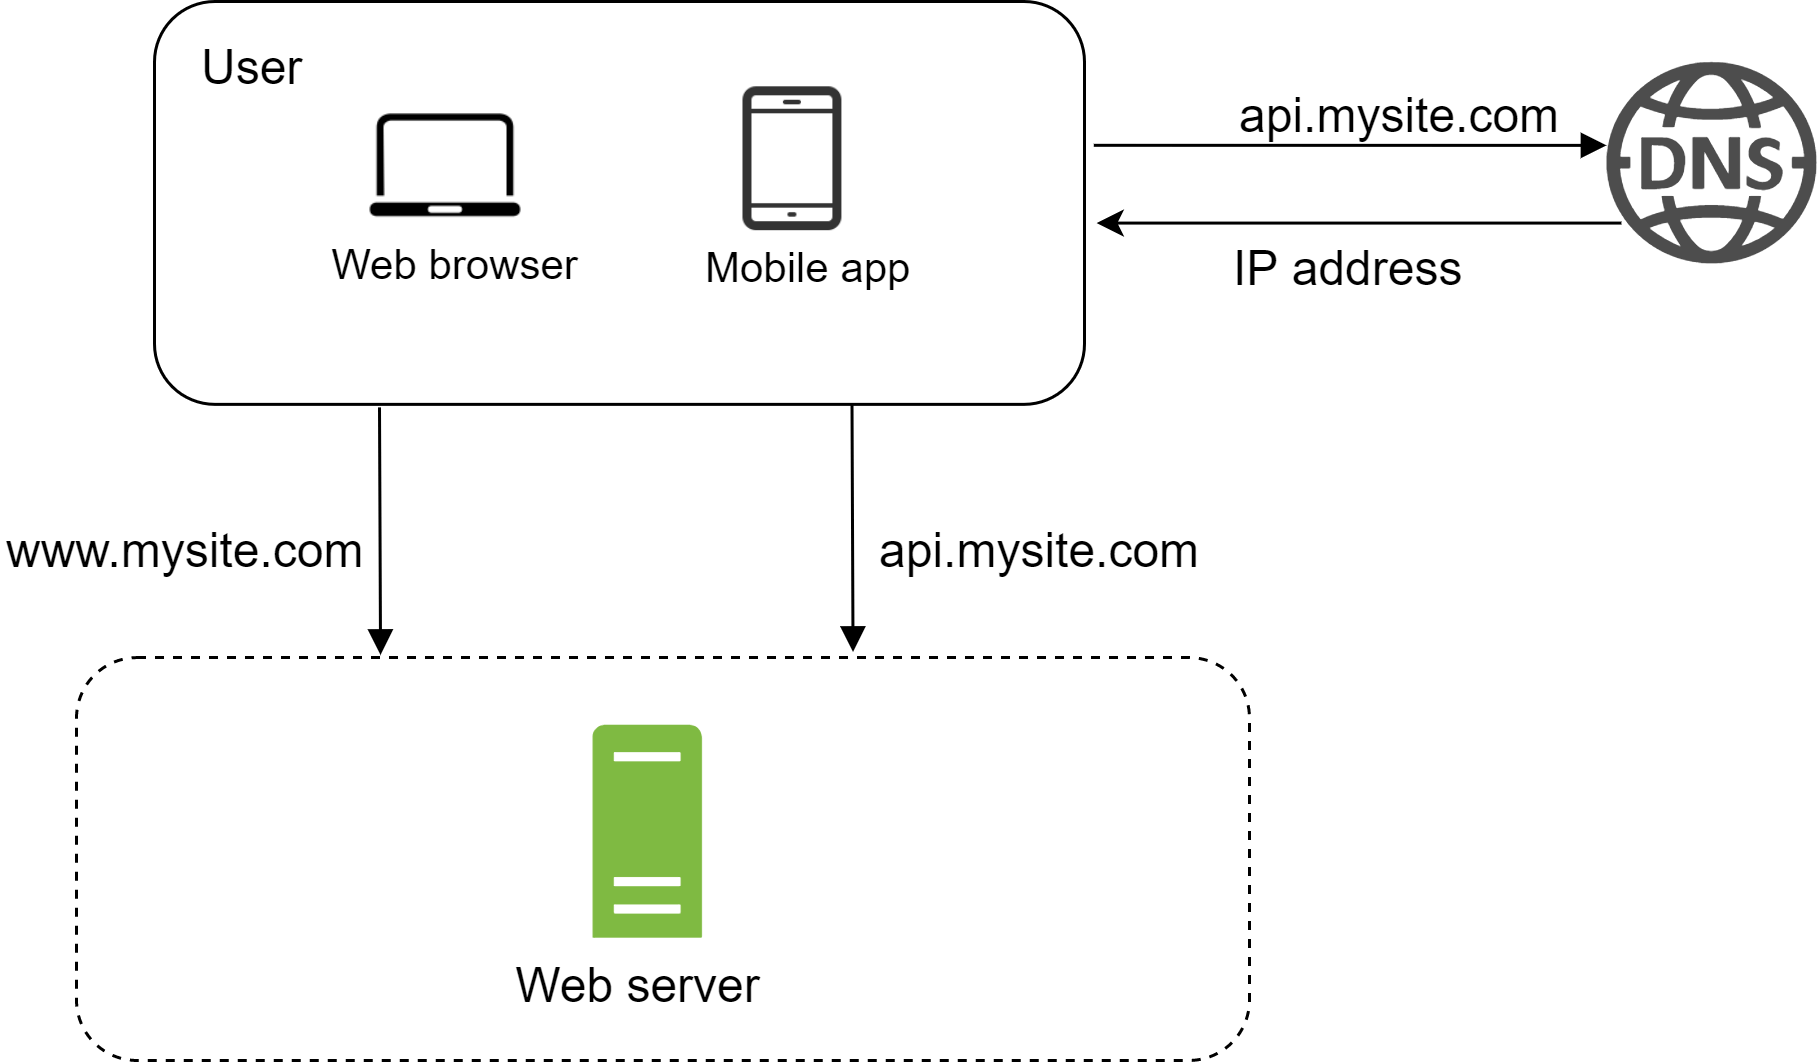
Рисунок 1
Чтобы понять эту конфигурацию, полезно разобрать поток запросов и источник трафика. Сначала посмотрим на поток запросов (рисунок 2).
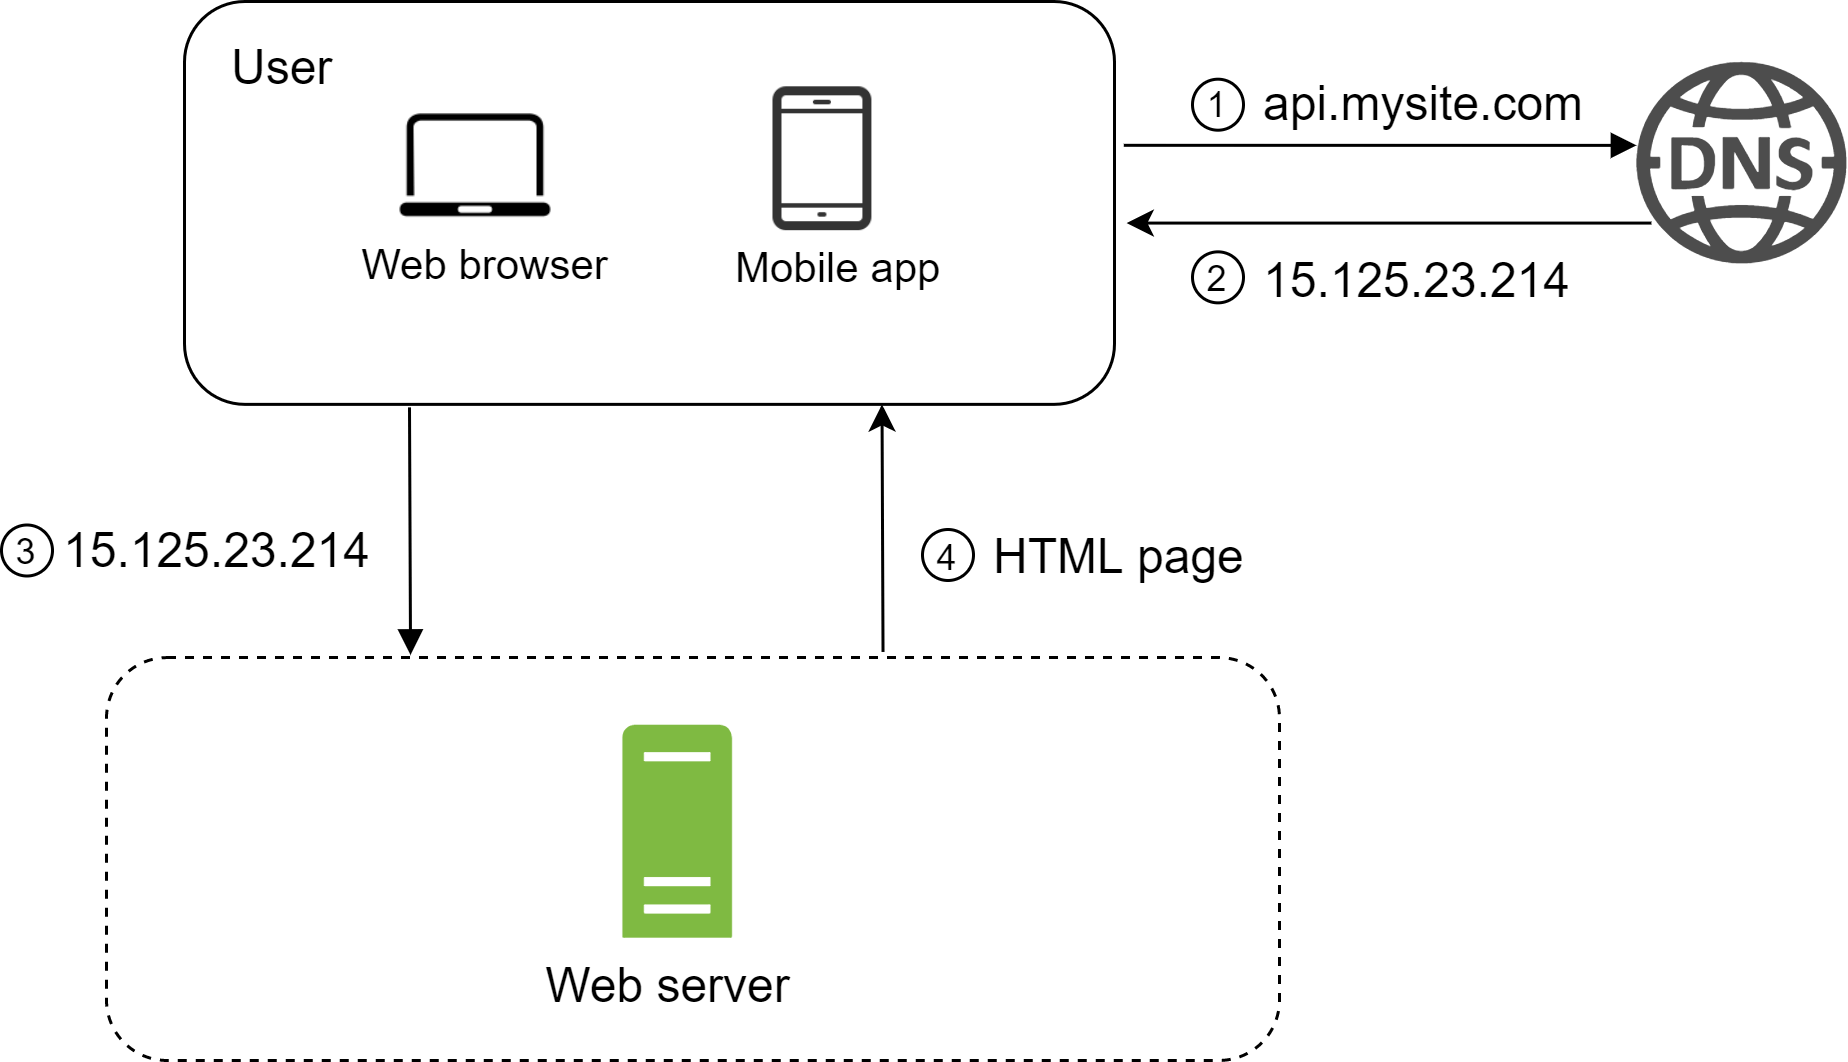
Рисунок 2
1. Пользователи заходят на сайты по доменным именам, например api.mysite.com. Обычно система
имен доменов (DNS) является платным сервисом, предоставляемым сторонними компаниями, а не
размещенным на наших серверах.
2. Браузеру или мобильному приложению возвращается IP-адрес. В этом примере возвращается IP-адрес
15.125.23.214.
3. После получения IP-адреса запросы по протоколу HTTP (Hypertext Transfer Protocol) [1] отправляются напрямую на ваш веб-сервер.
4. Веб-сервер возвращает HTML-страницы или JSON-ответы для отображения.
Теперь рассмотрим источник трафика. Трафик на ваш веб-сервер приходит из двух источников: веб-приложение и мобильное приложение.
-
Веб-приложение: использует сочетание серверных языков (Java, Python и т. д.) для обработки бизнес-логики, хранения данных и т. п., а также клиентских языков (HTML и JavaScript) для представления.
-
Мобильное приложение: HTTP является протоколом связи между мобильным приложением и веб-сервером. В качестве формата ответа API часто используется JSON (JavaScript Object Notation) благодаря его простоте. Ниже показан пример ответа API в формате JSON:
GET /users/12 – Получить объект пользователя для id = 12
{
   "id":12,
   "firstName":"John",
   "lastName":"Smith",
   "address":{
      "streetAddress":"21 2nd Street",
      "city":"New York",
      "state":"NY",
      "postalCode":10021
   },
   "phoneNumbers":[
      "212 555-1234",
      "646 555-4567"
   ]
}
База данных
По мере роста пользовательской базы одного сервера уже недостаточно, и нам требуется несколько серверов: один для веб- и мобильного трафика, другой для базы данных (рисунок 3). Разделение серверов веб-/мобильного трафика (веб-уровень) и базы данных (уровень данных) позволяет масштабировать их независимо.
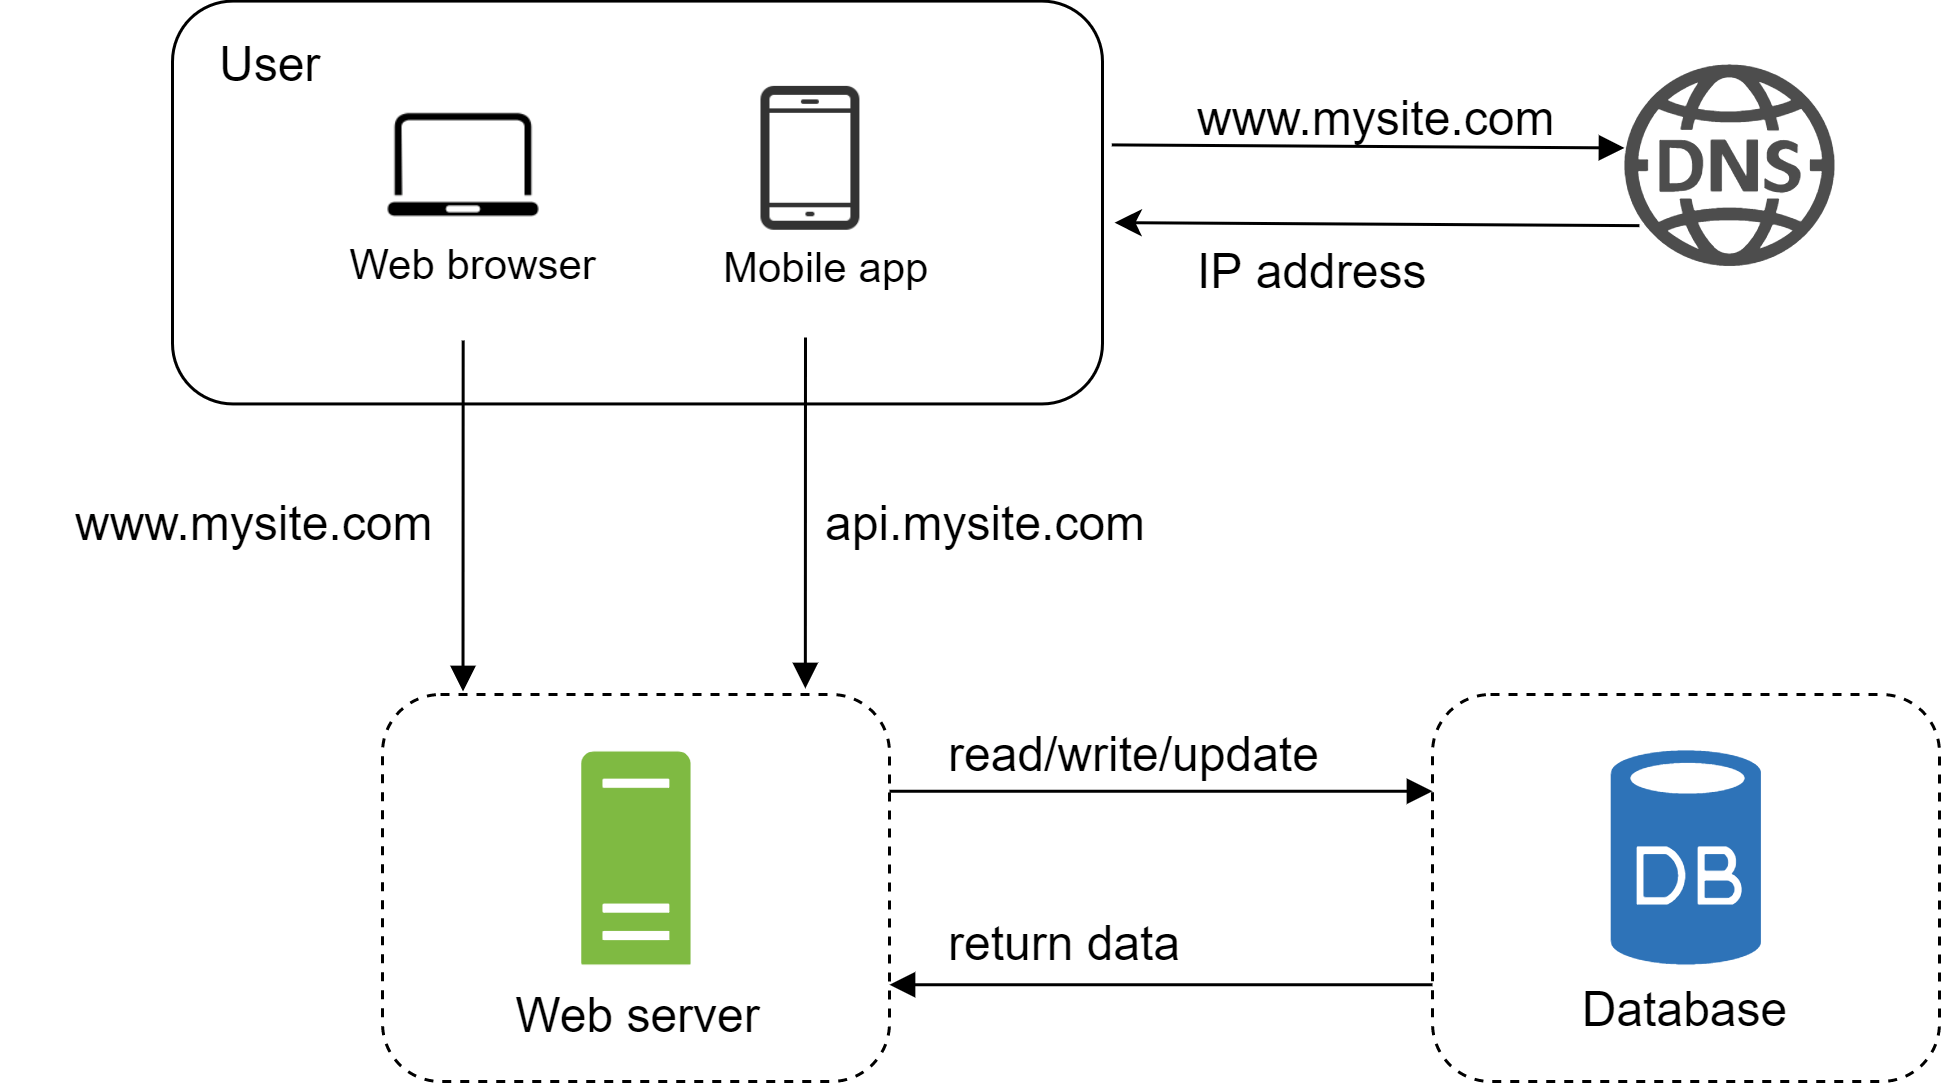
Рисунок 3
Какую базу данных выбрать?
Вы можете выбирать между традиционной реляционной базой данных и нереляционной базой данных. Давайте рассмотрим их различия.
Реляционные базы данных также называют системами управления реляционными базами данных (RDBMS)
или SQL-базами. Наиболее популярные из них: MySQL, Oracle Database, PostgreSQL и т. д.
Реляционные базы данных представляют и хранят данные в таблицах и строках. С помощью SQL можно
выполнять операции join между разными таблицами базы данных.
Нереляционные базы данных также называют NoSQL-базами. Популярные представители: CouchDB, Neo4j,
Cassandra, HBase, Amazon DynamoDB и т. д. [2]. Эти базы данных делятся на четыре категории:
хранилища типа «ключ-значение», графовые хранилища, колоночные хранилища и документные хранилища.
Операции join в
нереляционных базах обычно не поддерживаются.
Для большинства разработчиков реляционные базы данных являются лучшим вариантом, потому что они существуют уже более 40 лет и исторически хорошо себя показали. Однако если реляционные базы не подходят для ваших конкретных сценариев, критически важно рассматривать и альтернативы. NoSQL база данных может быть правильным выбором, если:
-
вашему приложению требуется сверхнизкая задержка;
-
ваши данные неструктурированы или у вас нет реляционных данных;
-
вам нужно только сериализовать и десериализовать данные (JSON, XML, YAML и т. д.);
-
вам нужно хранить огромный объем данных.
Вертикальное и горизонтальное масштабирование
Вертикальное масштабирование, также называемое scale up, означает процесс добавления серверу
мощности (CPU, RAM и т. д.). Горизонтальное масштабирование, также называемое scale out,
позволяет масштабировать систему за счет добавления серверов в пул ресурсов.
Когда трафик низкий, вертикальное масштабирование является отличным вариантом, и его главное преимущество заключается в простоте. К сожалению, у него есть серьезные ограничения.
-
У вертикального масштабирования есть жесткий предел. Невозможно бесконечно добавлять CPU и память одному серверу.
-
Вертикальное масштабирование не обеспечивает автоматическое переключение при отказе и избыточность. Если один сервер падает, вместе с ним полностью становится недоступным и сайт/приложение.
Из-за ограничений вертикального масштабирования для крупных приложений более предпочтительно горизонтальное масштабирование.
В предыдущем дизайне пользователи подключались к веб-серверу напрямую. Если веб-сервер недоступен, пользователи не смогут зайти на сайт. В другом сценарии, если много пользователей одновременно обращаются к веб-серверу и он достигает своего лимита нагрузки, пользователи обычно сталкиваются с медленными ответами или не могут подключиться к серверу. Лучший способ решить эти проблемы — использовать балансировщик нагрузки.
Балансировщик нагрузки
Балансировщик нагрузки равномерно распределяет входящий трафик между веб-серверами, входящими в сбалансированный пул. На рисунке 4 показано, как работает балансировщик нагрузки.
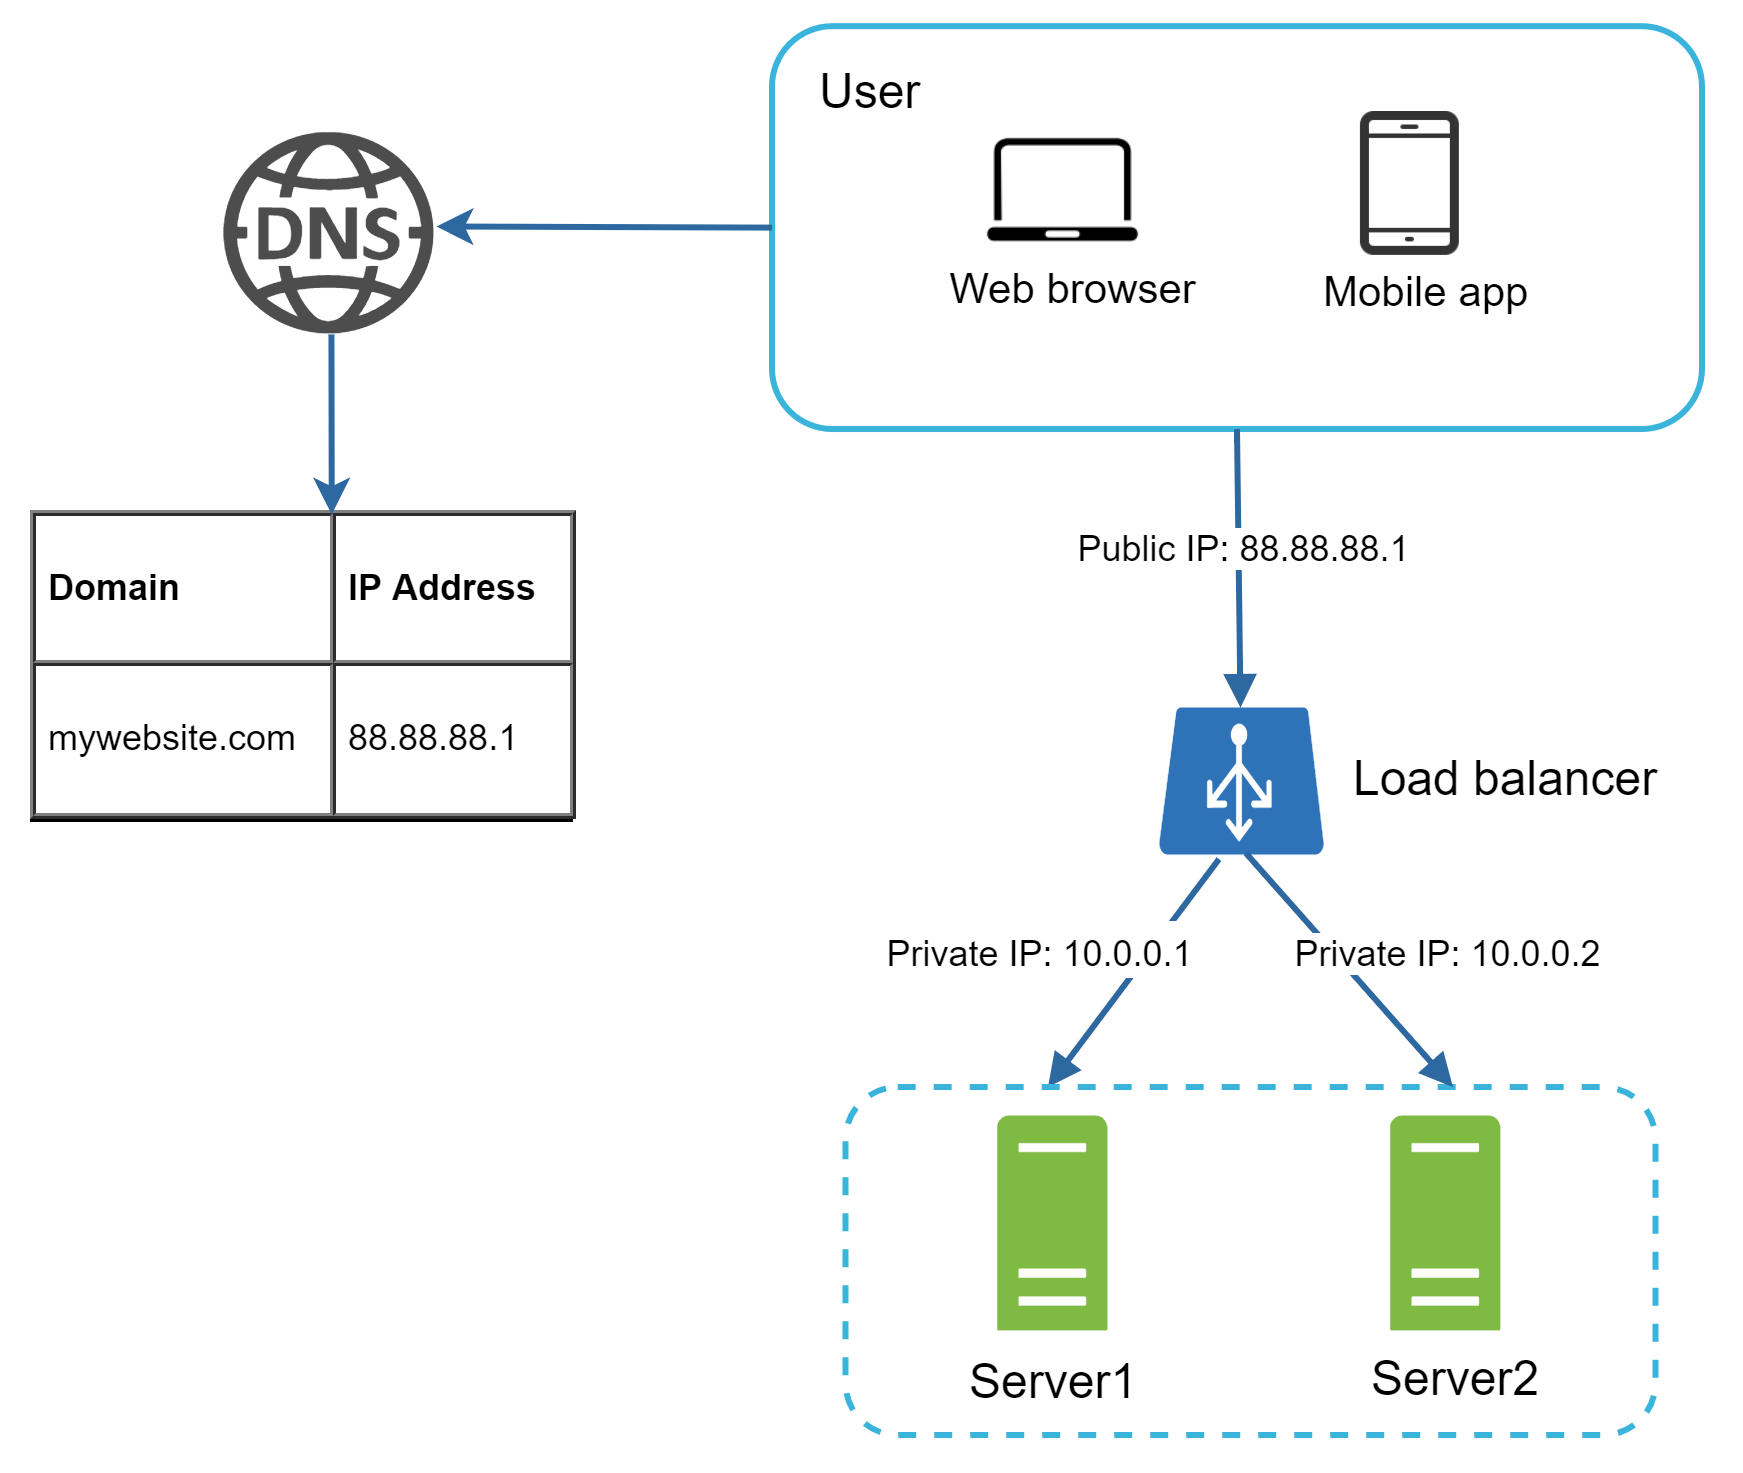
Рисунок 4
Как показано на рисунке 4, пользователи подключаются напрямую к публичному IP балансировщика нагрузки. При такой конфигурации веб-серверы больше недоступны клиентам напрямую. Для повышения безопасности для связи между серверами используются приватные IP-адреса. Приватный IP-адрес — это IP-адрес, доступный только между серверами внутри одной сети; из интернета он недостижим. Балансировщик нагрузки взаимодействует с веб-серверами через приватные IP-адреса.
На рисунке 4, после добавления балансировщика нагрузки и второго веб-сервера, мы успешно решили проблему отсутствия отказоустойчивого переключения и повысили доступность веб-уровня. Подробности приведены ниже:
-
Если сервер 1 выходит из строя, весь трафик будет перенаправлен на сервер 2. Это не даст сайту уйти в офлайн. Мы также добавим в пул новый исправный веб-сервер, чтобы сбалансировать нагрузку.
-
Если трафик сайта быстро растет и двух серверов уже недостаточно для его обработки, балансировщик нагрузки позволит изящно решить проблему. Нужно лишь добавить больше серверов в пул веб-серверов, и балансировщик автоматически начнет отправлять запросы на них.
Теперь с веб-уровнем все выглядит хорошо, но что насчет уровня данных? В текущем дизайне только одна база данных, поэтому автоматическое переключение при отказе и избыточность не поддерживаются. Для решения этих проблем часто используют репликацию базы данных. Давайте посмотрим.
Репликация базы данных
Цитата из Wikipedia: “Database replication can be used in many database management systems, usually with a master/slave relationship between the original (master) and the copies (slaves)” [3].
Master-база данных обычно поддерживает только операции записи. Slave-база данных получает копии
данных от master-базы и поддерживает только операции чтения. Все команды, изменяющие данные,
такие как insert, delete или update, должны отправляться в master-базу. Большинству
приложений требуется гораздо больше операций чтения, чем записи, поэтому количество slave-баз в
системе обычно больше количества master-баз. На рисунке 5 показана master-база данных с
несколькими slave-базами.

Рисунок 5
Преимущества репликации базы данных:
-
Лучшая производительность: в модели master-slave все записи и обновления происходят в master-узлах, тогда как операции чтения распределяются по slave-узлам. Эта модель повышает производительность, потому что позволяет обрабатывать больше запросов параллельно.
-
Надежность: если один из серверов базы данных будет уничтожен в результате природной катастрофы, например тайфуна или землетрясения, данные все равно сохранятся. Вам не нужно беспокоиться о потере данных, потому что они реплицируются в нескольких локациях.
-
Высокая доступность: при репликации данных в разных локациях ваш сайт продолжит работать, даже если одна база данных станет недоступной, так как вы сможете получить данные с другого сервера базы данных.
В предыдущем разделе мы обсуждали, как балансировщик нагрузки помог повысить доступность системы. Здесь зададим тот же вопрос: что будет, если одна из баз данных выйдет из строя? Архитектурный дизайн, показанный на рисунке 5, умеет справляться с этим случаем:
-
Если доступна только одна slave-база и она выходит из строя, операции чтения временно будут направляться в master-базу. Как только проблема будет обнаружена, старая slave-база будет заменена новой. Если доступно несколько slave-баз, запросы на чтение будут перенаправлены на другие исправные slave-базы. Старый сервер базы данных будет заменен новым.
-
Если master-база выходит из строя, одна из slave-баз будет повышена до новой master. Все операции с базой данных временно будут выполняться на новой master-базе. Для репликации данных старая slave-база будет немедленно заменена новой. В production-системах перевод slave в роль новой master сложнее, так как данные на slave-базе могут быть не полностью актуальными. Недостающие данные необходимо восстановить с помощью скриптов восстановления данных. Хотя другие методы репликации, например multi-master и circular replication, тоже могут помочь, такие конфигурации сложнее, и их обсуждение выходит за рамки этого курса. Заинтересованным читателям стоит обратиться к указанным материалам [4] [5].
На рисунке 6 показан дизайн системы после добавления балансировщика нагрузки и репликации базы данных.
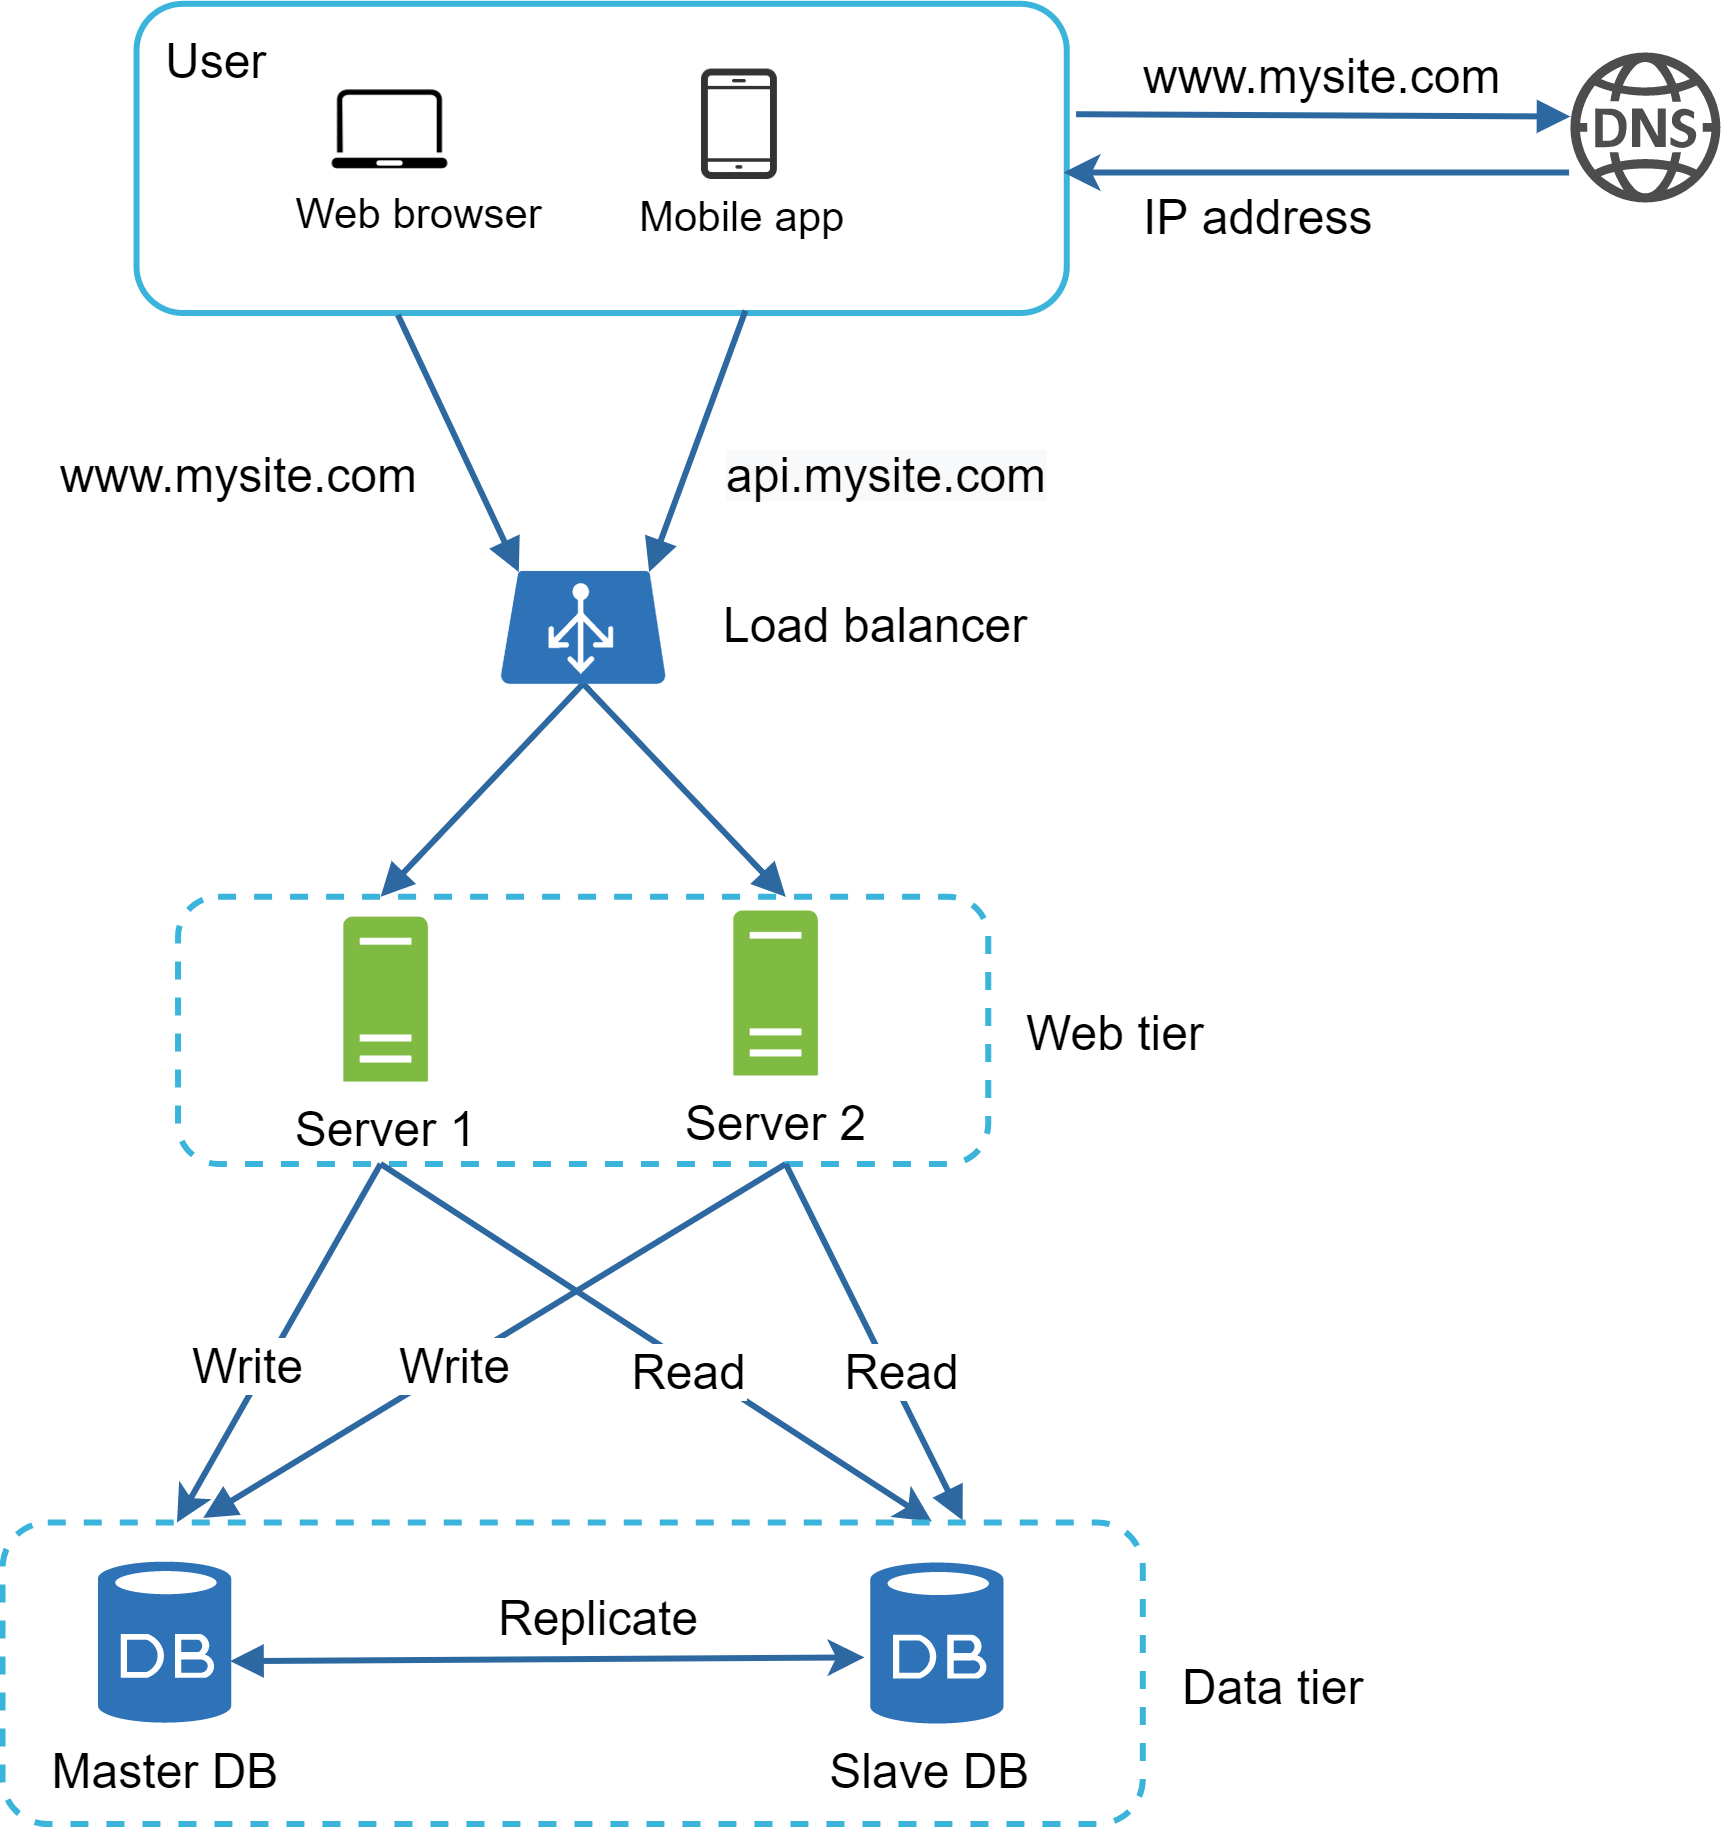
Рисунок 6
Давайте посмотрим на этот дизайн:
-
Пользователь получает IP-адрес балансировщика нагрузки из DNS.
-
Пользователь подключается к балансировщику нагрузки по этому IP-адресу.
-
HTTP-запрос маршрутизируется либо на Server 1, либо на Server 2.
-
Веб-сервер читает данные пользователя из slave-базы данных.
-
Веб-сервер отправляет любые операции, изменяющие данные, в master-базу данных. Это включает операции
write,updateиdelete.
Теперь, когда у вас есть хорошее понимание веб-уровня и уровня данных, пришло время улучшить время загрузки и отклика. Это можно сделать, добавив слой кэширования и вынеся статический контент (файлы JavaScript/CSS/изображения/видео) в сеть доставки контента (CDN).
Кэш
Кэш — это временное хранилище, которое сохраняет в памяти результаты дорогостоящих ответов или часто запрашиваемые данные, чтобы последующие запросы обслуживались быстрее. Как показано на рисунке 6, при каждой загрузке новой веб-страницы выполняется один или несколько запросов к базе данных для получения данных. Производительность приложения сильно страдает от постоянных обращений к базе данных. Кэш может смягчить эту проблему.
Слой кэширования
Слой кэширования — это слой временного хранения данных, который работает намного быстрее базы данных. Преимущества выделенного слоя кэша включают более высокую производительность системы, возможность снизить нагрузку на базу данных и возможность независимо масштабировать слой кэша. На рисунке 7 показана возможная конфигурация кэш-сервера:

Рисунок 7
После получения запроса веб-сервер сначала проверяет, есть ли нужный ответ в кэше. Если есть, он
возвращает данные клиенту. Если нет, он запрашивает данные из базы, сохраняет ответ в кэше и
отправляет его клиенту. Такая стратегия кэширования называется read-through cache. В
зависимости от типа данных, их размера и шаблонов доступа доступны и другие стратегии
кэширования. В одном из предыдущих исследований объясняется, как работают разные стратегии
кэширования [6].
Взаимодействовать с кэш-серверами просто, потому что большинство из них предоставляют API для распространенных языков программирования. Следующий фрагмент кода показывает типичный API Memcached:
SECONDS = 1
cache.set('myKey, 'hi there', 3600 * SECONDS)
cache.get('myKey')
Что учитывать при использовании кэша
Вот несколько моментов, которые стоит учитывать при использовании кэша:
-
Решите, когда использовать кэш. Рассматривайте кэш, если данные часто читаются, но редко изменяются. Поскольку кэшированные данные хранятся в энергозависимой памяти, кэш-сервер не подходит для постоянного хранения данных. Например, если кэш-сервер перезапустится, все данные в памяти будут потеряны. Поэтому важные данные должны сохраняться в постоянных хранилищах данных.
-
Политика истечения срока действия. Хорошей практикой является реализация политики истечения срока действия. Когда срок действия кэшированных данных истекает, они удаляются из кэша. Если такой политики нет, данные будут храниться в памяти постоянно. Не стоит делать срок действия слишком коротким, иначе системе придется слишком часто заново загружать данные из базы. В то же время не стоит делать его слишком длинным, иначе данные могут устареть.
-
Согласованность: речь идет о поддержании синхронизации между хранилищем данных и кэшем. Несогласованность может возникнуть, потому что операции изменения данных в хранилище и кэше не находятся в одной транзакции. При масштабировании на несколько регионов поддерживать согласованность между хранилищем и кэшем особенно сложно. Подробнее см. статью “Scaling Memcache at Facebook”, опубликованную Facebook [7].
-
Смягчение сбоев: один кэш-сервер представляет собой потенциальную единую точку отказа (SPOF), которую Wikipedia определяет так: “A single point of failure (SPOF) is a part of a system that, if it fails, will stop the entire system from working” [8]. Поэтому для предотвращения SPOF рекомендуется использовать несколько кэш-серверов в разных дата-центрах. Еще один рекомендуемый подход — закладывать запас по памяти сверх расчетной потребности на определенный процент. Это создает буфер по мере роста потребления памяти.
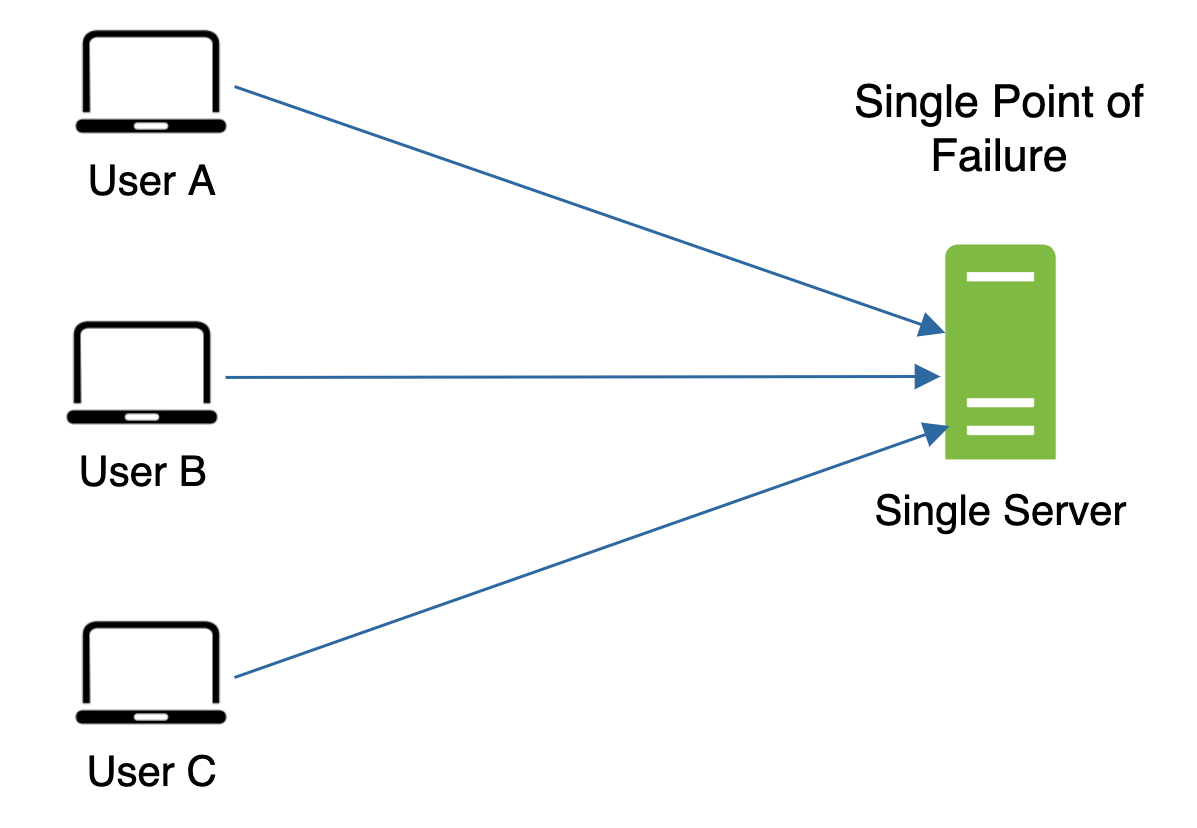
Рисунок 8
- Политика вытеснения: когда кэш заполняется, любые запросы на добавление новых элементов могут
приводить к удалению уже существующих. Это называется вытеснением из кэша (
cache eviction). Least-recently-used (LRU) — самая популярная политика вытеснения. Для разных случаев применения можно использовать и другие политики, например Least Frequently Used (LFU) или First In First Out (FIFO).
Сеть доставки контента (CDN)
CDN — это сеть географически распределенных серверов, используемая для доставки статического контента. CDN-серверы кэшируют статический контент, такой как изображения, видео, CSS, файлы JavaScript и т. д.
Кэширование динамического контента — относительно новая концепция и выходит за рамки этого курса. Оно позволяет кэшировать HTML-страницы на основе пути запроса, строки запроса, cookies и заголовков запроса. Подробнее об этом см. статью из списка литературы [9]. В этом курсе мы сосредоточимся на использовании CDN для кэширования статического контента.
На высоком уровне CDN работает так: когда пользователь заходит на сайт, статический контент ему отдает CDN-сервер, расположенный ближе всего к нему. Интуитивно понятно, что чем дальше пользователь находится от CDN-серверов, тем медленнее загружается сайт. Например, если CDN-серверы находятся в Сан-Франциско, пользователи в Лос-Анджелесе получат контент быстрее, чем пользователи в Европе. На рисунке 9 хорошо показано, как CDN улучшает время загрузки.

Рисунок 9
На рисунке 10 показан рабочий процесс CDN.
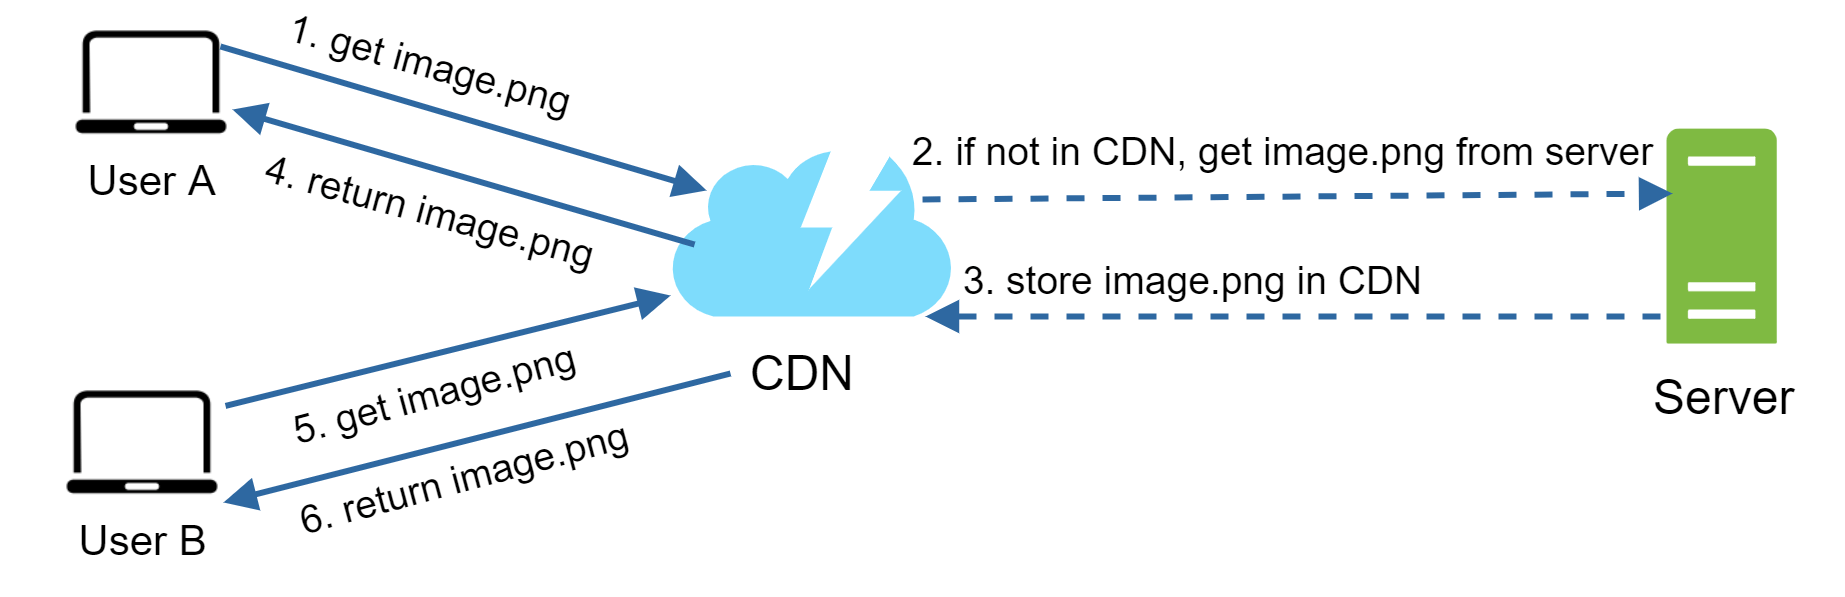
Рисунок 10
1. Пользователь A пытается получить image.png, используя URL изображения. Домен в URL
предоставляется CDN-провайдером. Следующие два URL используются как примеры того, как могут
выглядеть URL изображений в Amazon и Akamai CDN:
-
https://mysite.cloudfront.net/logo.jpg -
https://mysite.akamai.com/image-manager/img/logo.jpg
2. Если на CDN-сервере нет image.png в кэше, CDN-сервер запрашивает файл у origin, которым
может быть веб-сервер или онлайн-хранилище вроде Amazon S3.
3. Origin возвращает image.png на CDN-сервер, включая необязательный HTTP-заголовок
Time-to-Live (TTL), который описывает, как долго изображение должно кэшироваться.
4. CDN кэширует изображение и возвращает его пользователю A. Изображение остается в кэше CDN, пока не истечет TTL.
5. Пользователь B отправляет запрос на получение того же изображения.
6. Изображение возвращается из кэша до тех пор, пока TTL не истек.
Что учитывать при использовании CDN
-
Стоимость: CDN управляются сторонними провайдерами, и вы платите за передачу данных в CDN и из CDN. Кэширование редко используемых ресурсов не дает заметной пользы, поэтому стоит подумать о том, чтобы убрать их из CDN.
-
Настройка подходящего срока действия кэша: для чувствительного ко времени контента важно правильно задавать время жизни кэша. Оно не должно быть ни слишком длинным, ни слишком коротким. Если оно слишком длинное, контент может устареть. Если слишком короткое, это будет вызывать повторную загрузку контента с origin-серверов в CDN.
-
Резервный сценарий при сбое CDN: следует продумать, как ваш сайт или приложение будет справляться с отказом CDN. Если CDN временно недоступен, клиенты должны уметь обнаружить проблему и запрашивать ресурсы у origin.
-
Инвалидация файлов: вы можете удалить файл из CDN до истечения срока его жизни, выполнив одну из следующих операций:
-
Инвалидировать объект CDN с помощью API, предоставляемых CDN-вендором.
-
Использовать версионирование объектов, чтобы отдавать другую версию объекта. Чтобы версионировать объект, можно добавить параметр в URL, например номер версии. Например, номер версии 2 добавляется в строку запроса:
image.png?v=2.
На рисунке 11 показан дизайн после добавления CDN и кэша.
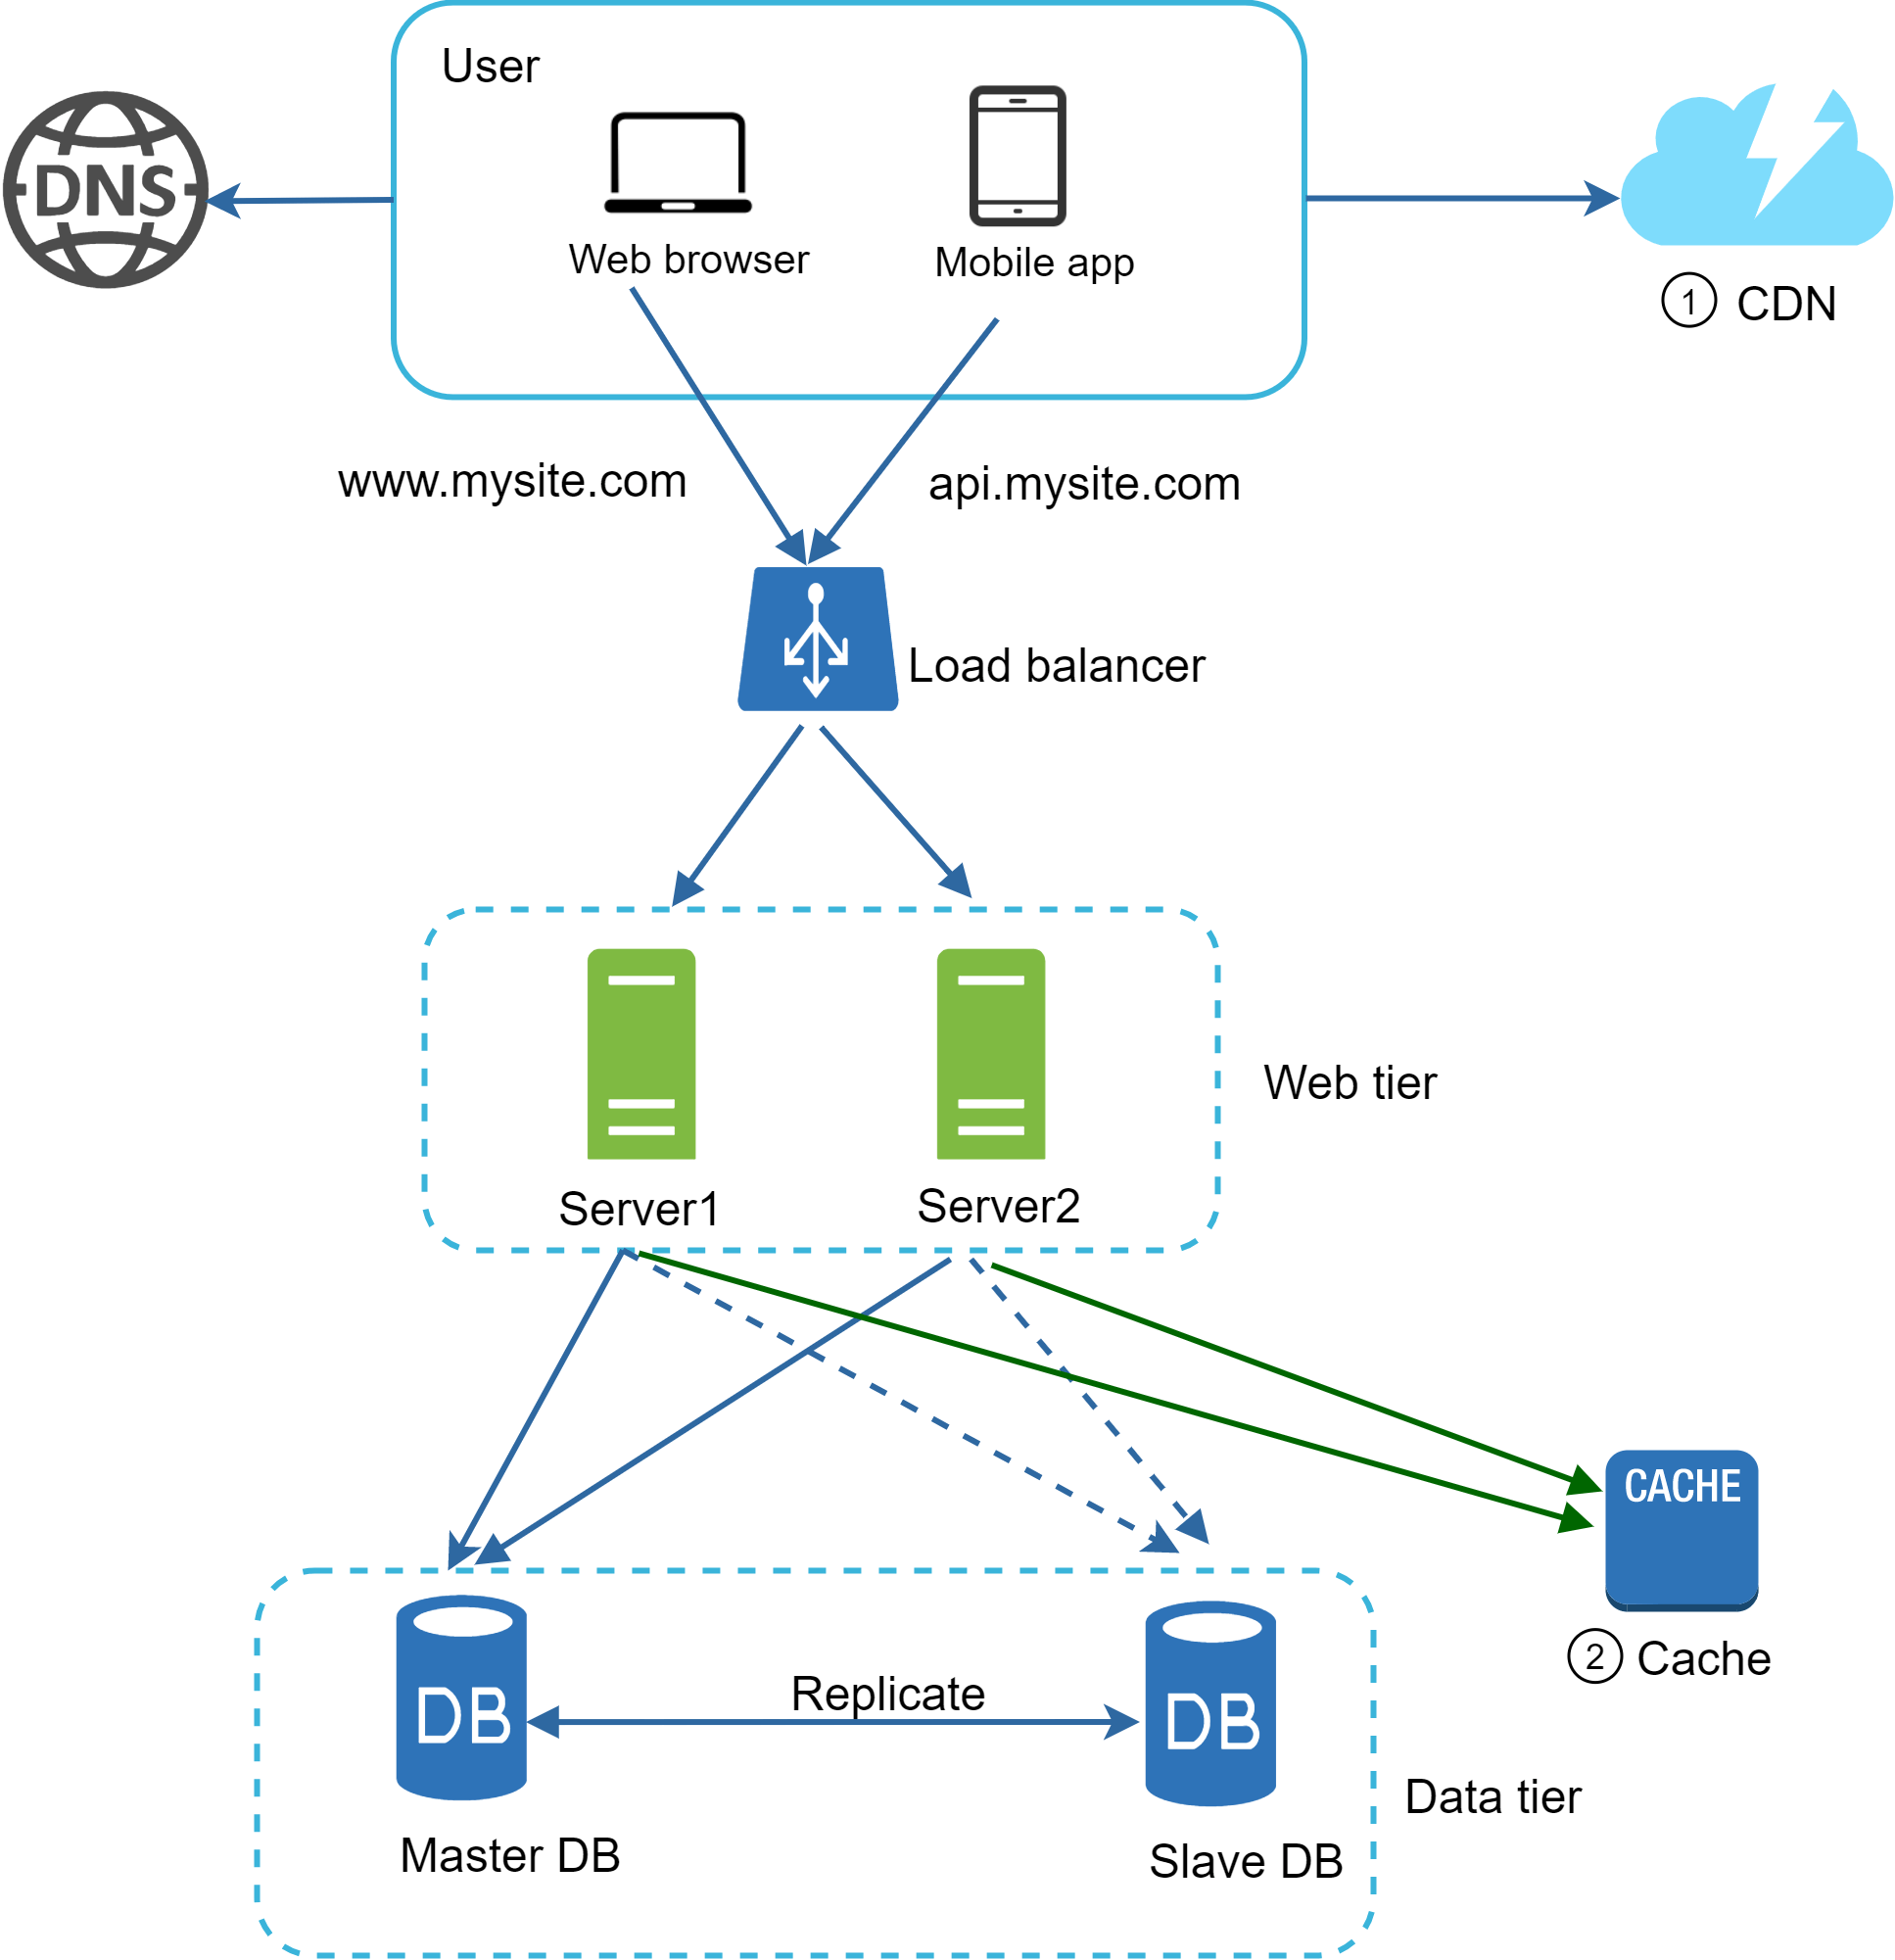
Рисунок 11
1. Статические ресурсы (JS, CSS, изображения и т. д.) больше не отдаются веб-серверами. Для лучшей производительности они загружаются из CDN.
2. Нагрузка на базу данных уменьшается за счет кэширования данных.
Веб-уровень без состояния
Теперь пришло время подумать о горизонтальном масштабировании веб-уровня. Для этого нам нужно вынести состояние (например, данные пользовательской сессии) из веб-уровня. Хорошая практика — хранить данные сессии в постоянном хранилище, например в реляционной или NoSQL-базе данных. Каждый веб-сервер в кластере может получать данные состояния из баз данных. Это и называется веб-уровнем без состояния.
Архитектура с состоянием
Сервер с состоянием и сервер без состояния имеют несколько ключевых отличий. Сервер с состоянием помнит клиентские данные (состояние) от одного запроса к следующему. Сервер без состояния не хранит никакой информации о состоянии.
На рисунке 12 показан пример архитектуры с состоянием.
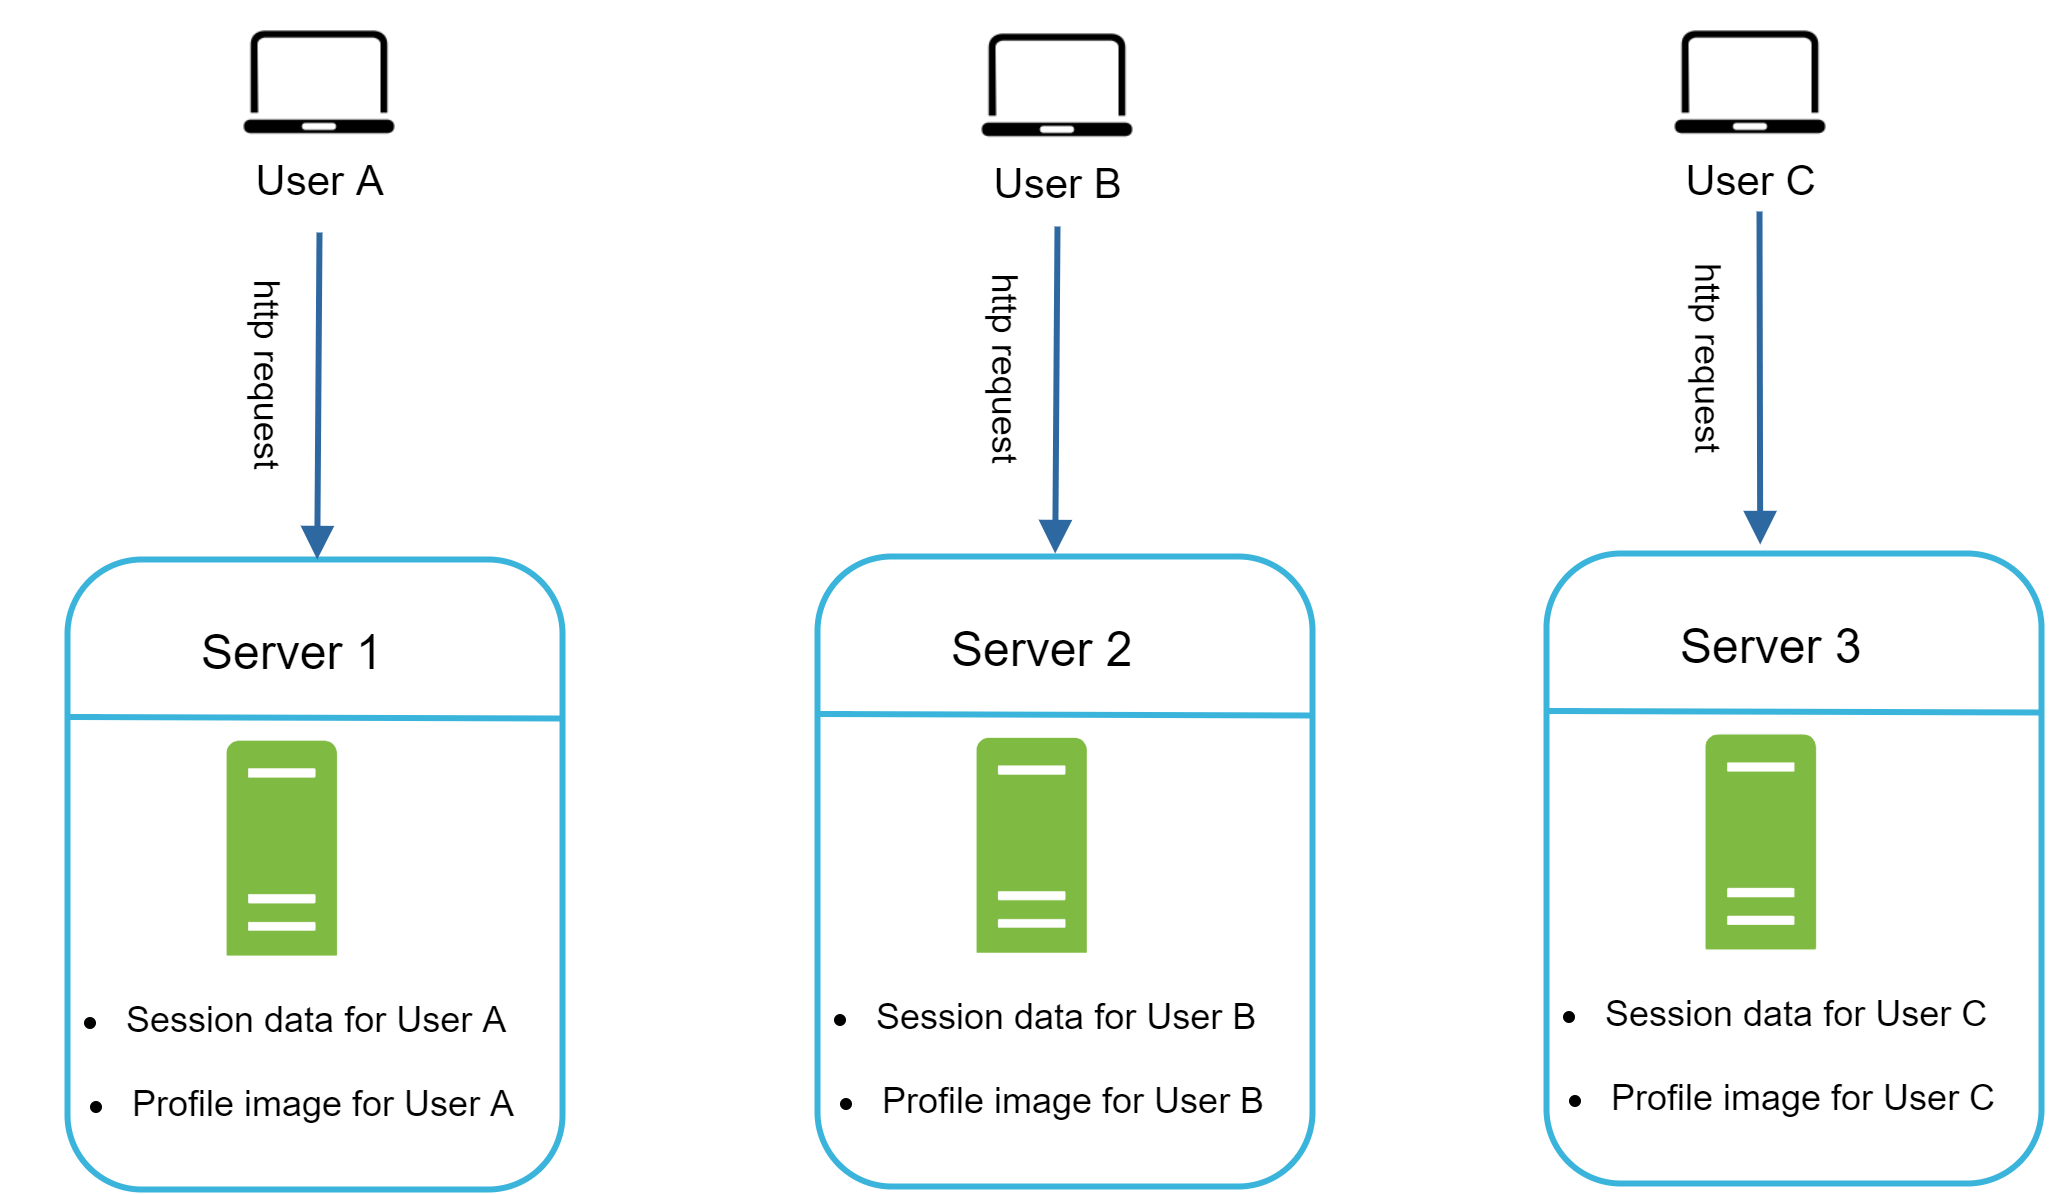
Рисунок 12
На рисунке 12 данные сессии пользователя A и его изображение профиля хранятся на Server 1. Чтобы аутентифицировать пользователя A, HTTP-запросы должны маршрутизироваться на Server 1. Если запрос будет отправлен на другой сервер, например Server 2, аутентификация завершится неудачей, потому что на Server 2 нет данных сессии пользователя A. Аналогично все HTTP-запросы от пользователя B должны направляться на Server 2, а все запросы от пользователя C — на Server 3.
Проблема в том, что каждый запрос от одного и того же клиента должен быть направлен на один и тот же сервер. На большинстве балансировщиков нагрузки это можно реализовать с помощью sticky sessions [10], но это создает дополнительные накладные расходы. При таком подходе также намного сложнее добавлять или удалять серверы. Кроме того, трудно обрабатывать отказы серверов.
Архитектура без состояния
На рисунке 13 показана архитектура без состояния.
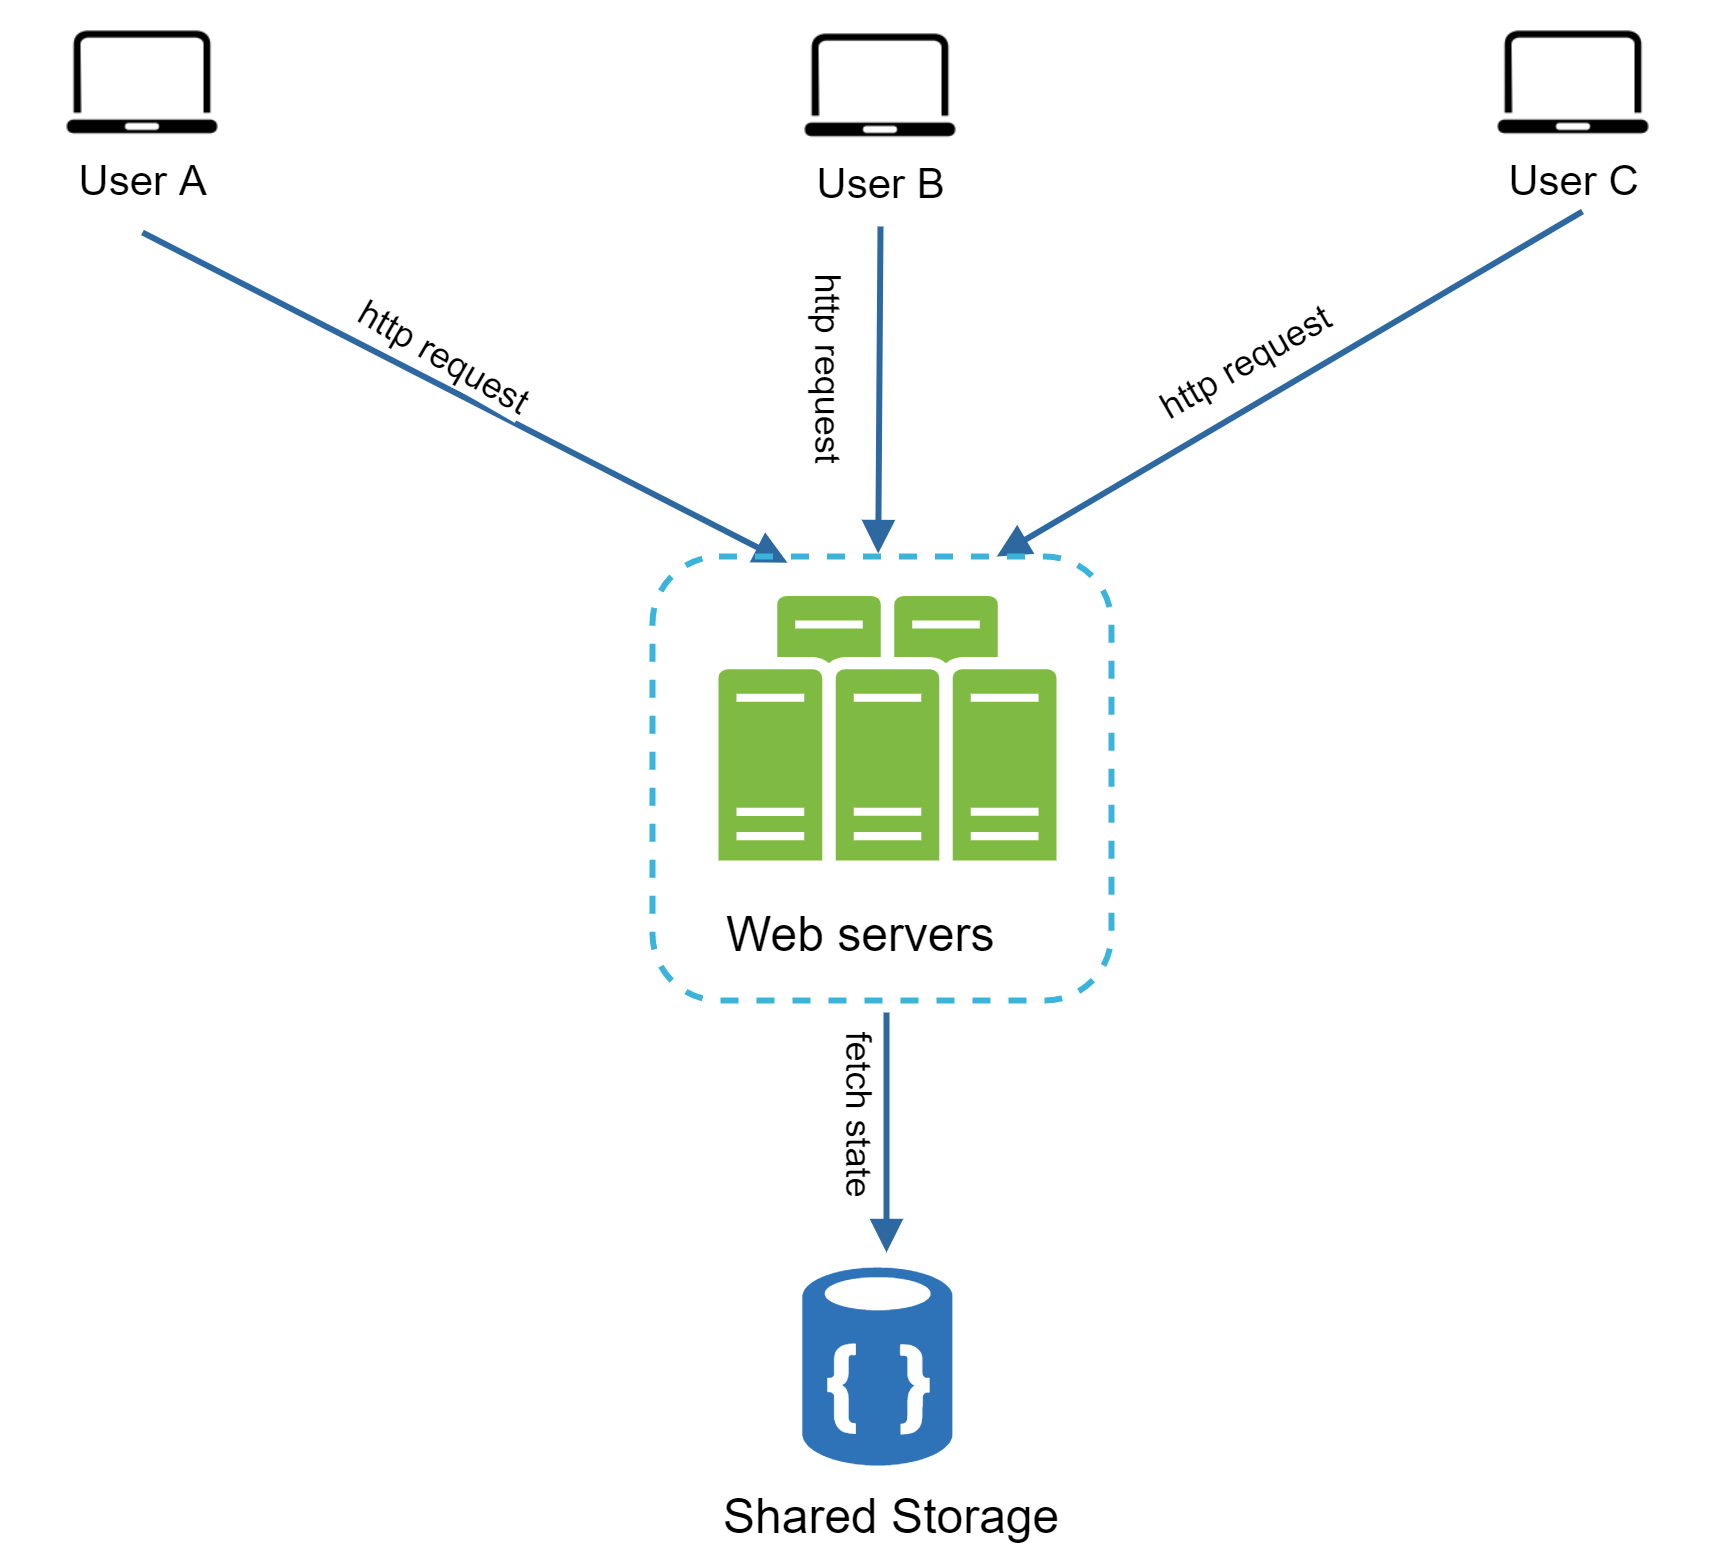
Рисунок 13
В этой архитектуре без состояния HTTP-запросы от пользователей могут отправляться на любые веб-серверы, которые затем получают данные состояния из общего хранилища данных. Данные состояния хранятся в общем хранилище и вынесены за пределы веб-серверов. Система без состояния проще, надежнее и лучше масштабируется.
На рисунке 14 показан обновленный дизайн с веб-уровнем без состояния.
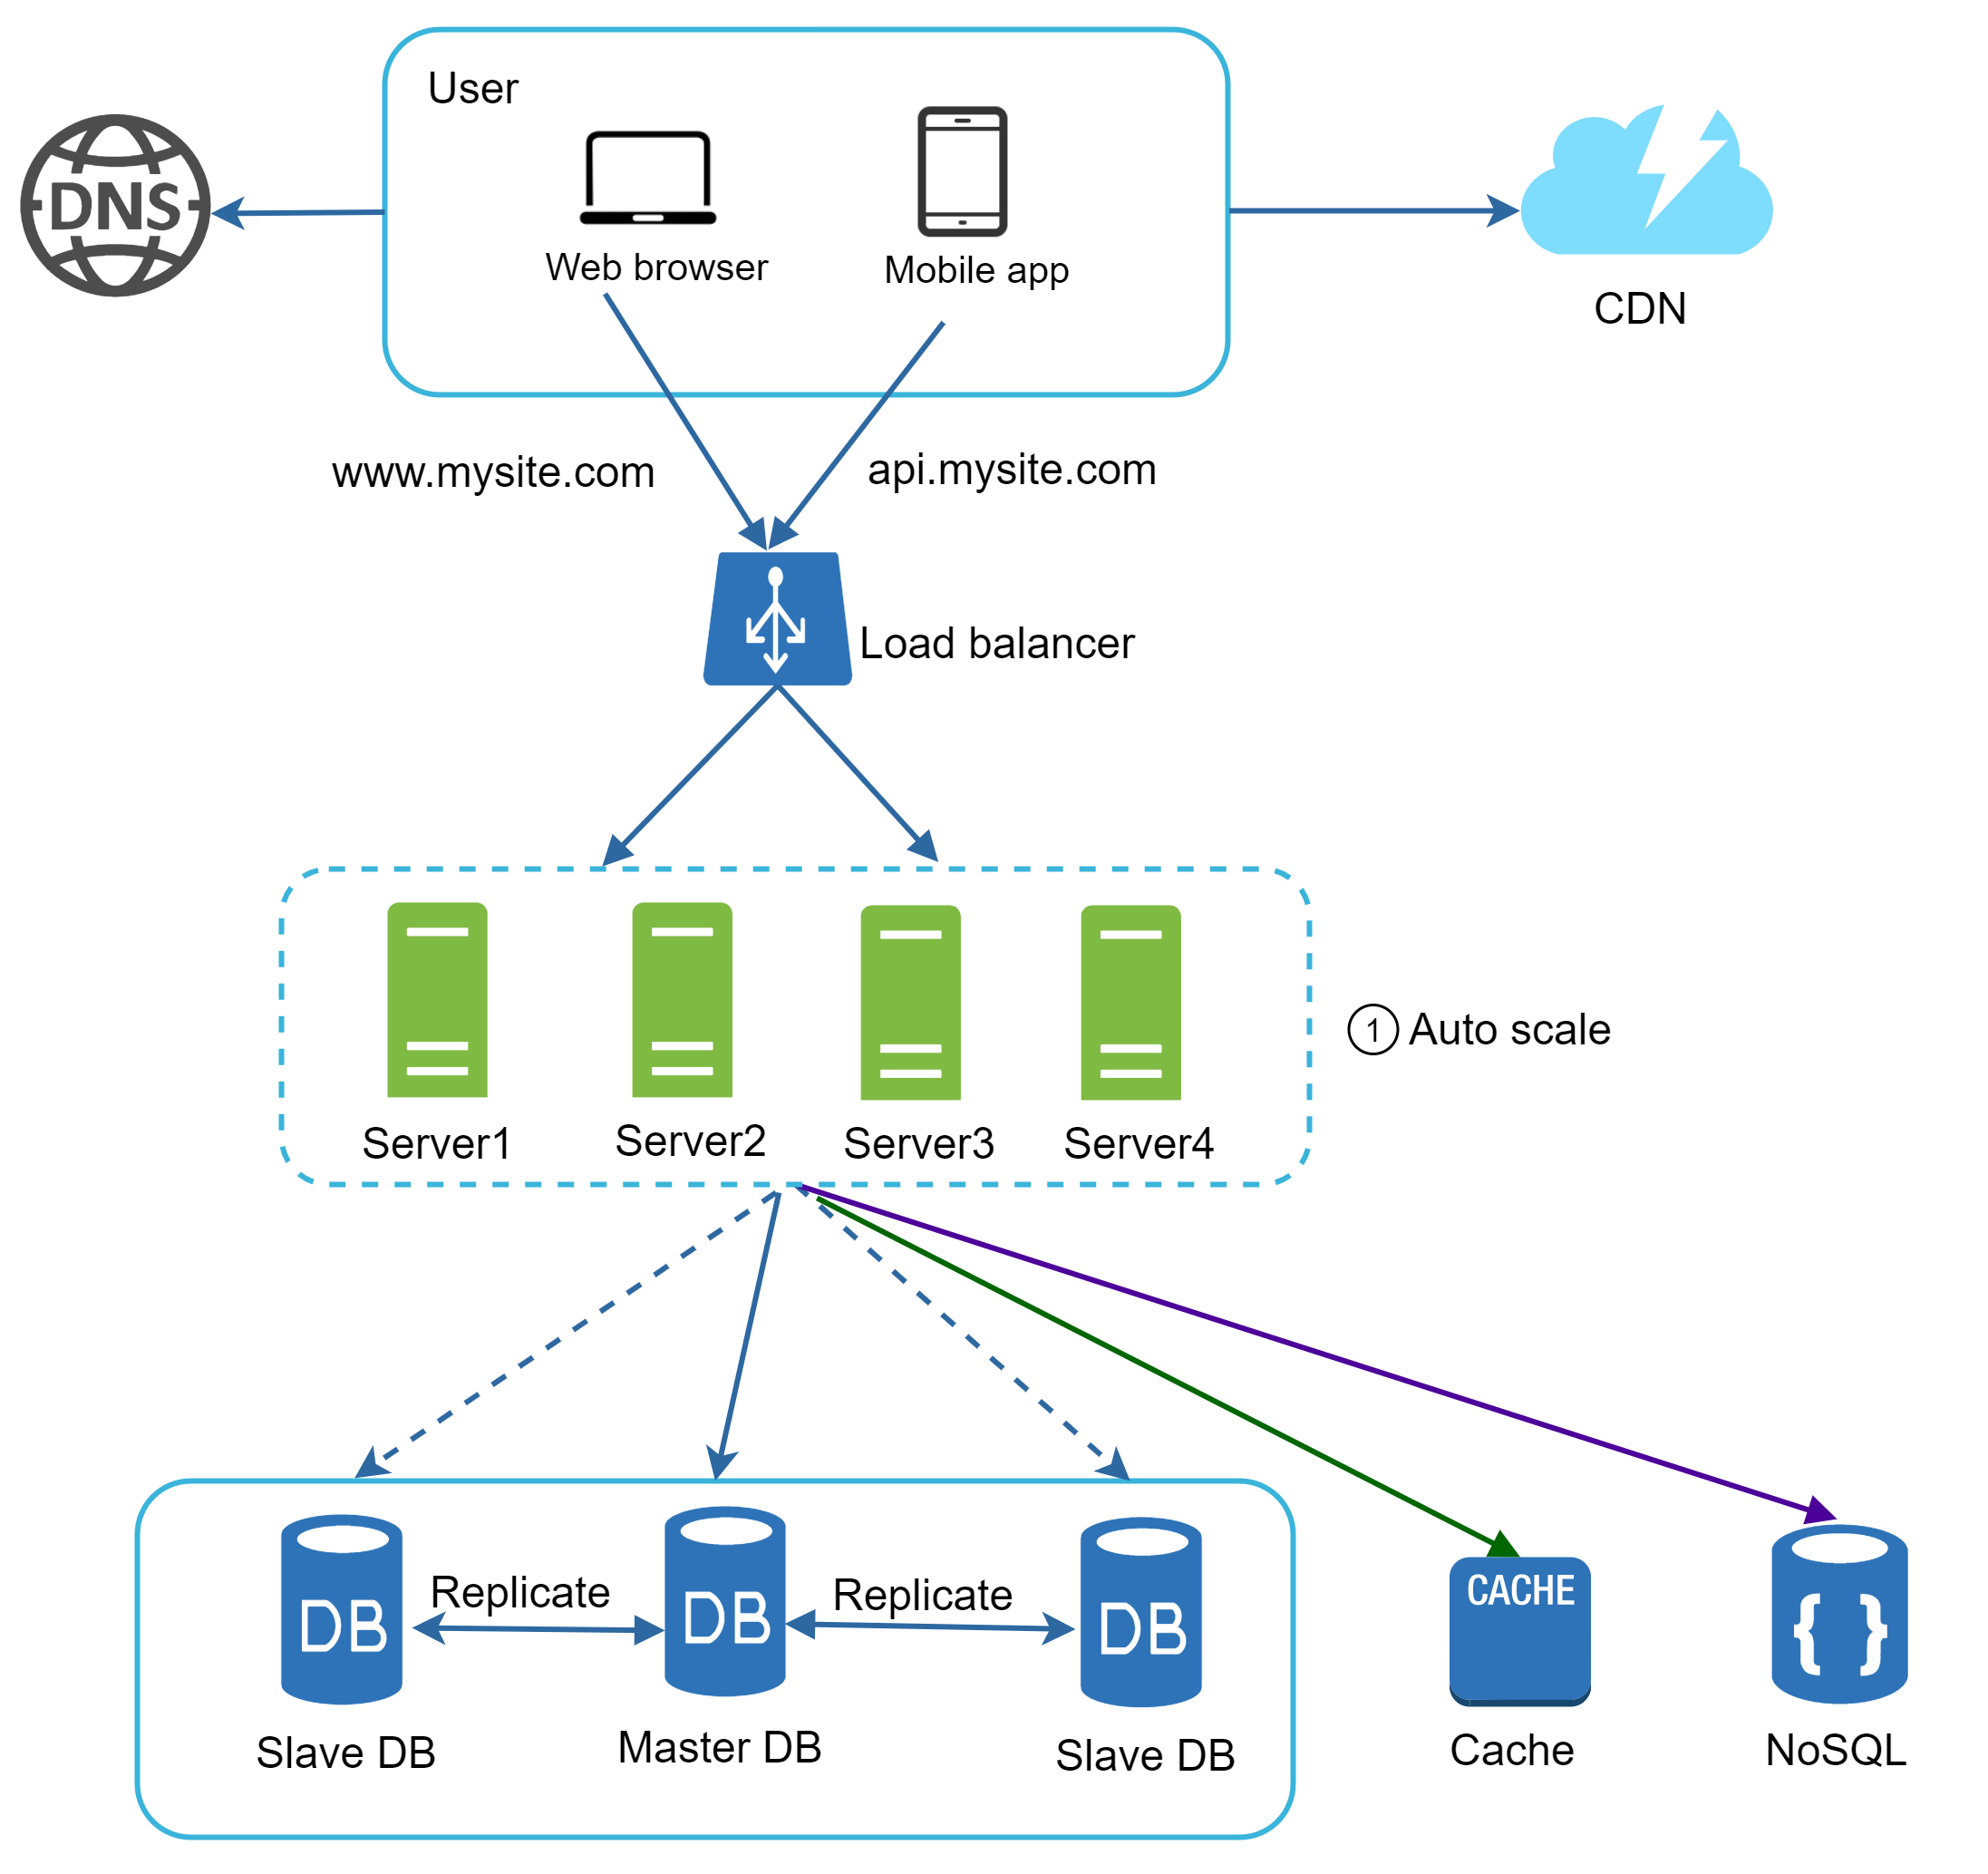
Рисунок 14
На рисунке 14 мы выносим данные сессии из веб-уровня и храним их в постоянном хранилище данных. Общим хранилищем данных может быть реляционная база данных, Memcached/Redis, NoSQL и т. д. В качестве общего хранилища выбрана NoSQL-база, поскольку ее легко масштабировать. Автомасштабирование означает автоматическое добавление или удаление веб-серверов в зависимости от нагрузки по трафику. После того как данные состояния вынесены за пределы веб-серверов, автомасштабирование веб-уровня легко достигается путем добавления или удаления серверов в зависимости от нагрузки.
Ваш сайт быстро растет и привлекает большое количество пользователей по всему миру. Чтобы повысить доступность и обеспечить лучший пользовательский опыт на более широкой географии, необходимо поддерживать несколько дата-центров.
Дата-центры
На рисунке 15 показан пример конфигурации с двумя дата-центрами. В обычном режиме пользователи маршрутизируются с помощью geoDNS, также называемого geo-routing, в ближайший дата-центр, при этом трафик делится как x% в US-East и (100 – x)% в US-West. geoDNS — это DNS-сервис, который позволяет разрешать доменные имена в IP-адреса с учетом местоположения пользователя.
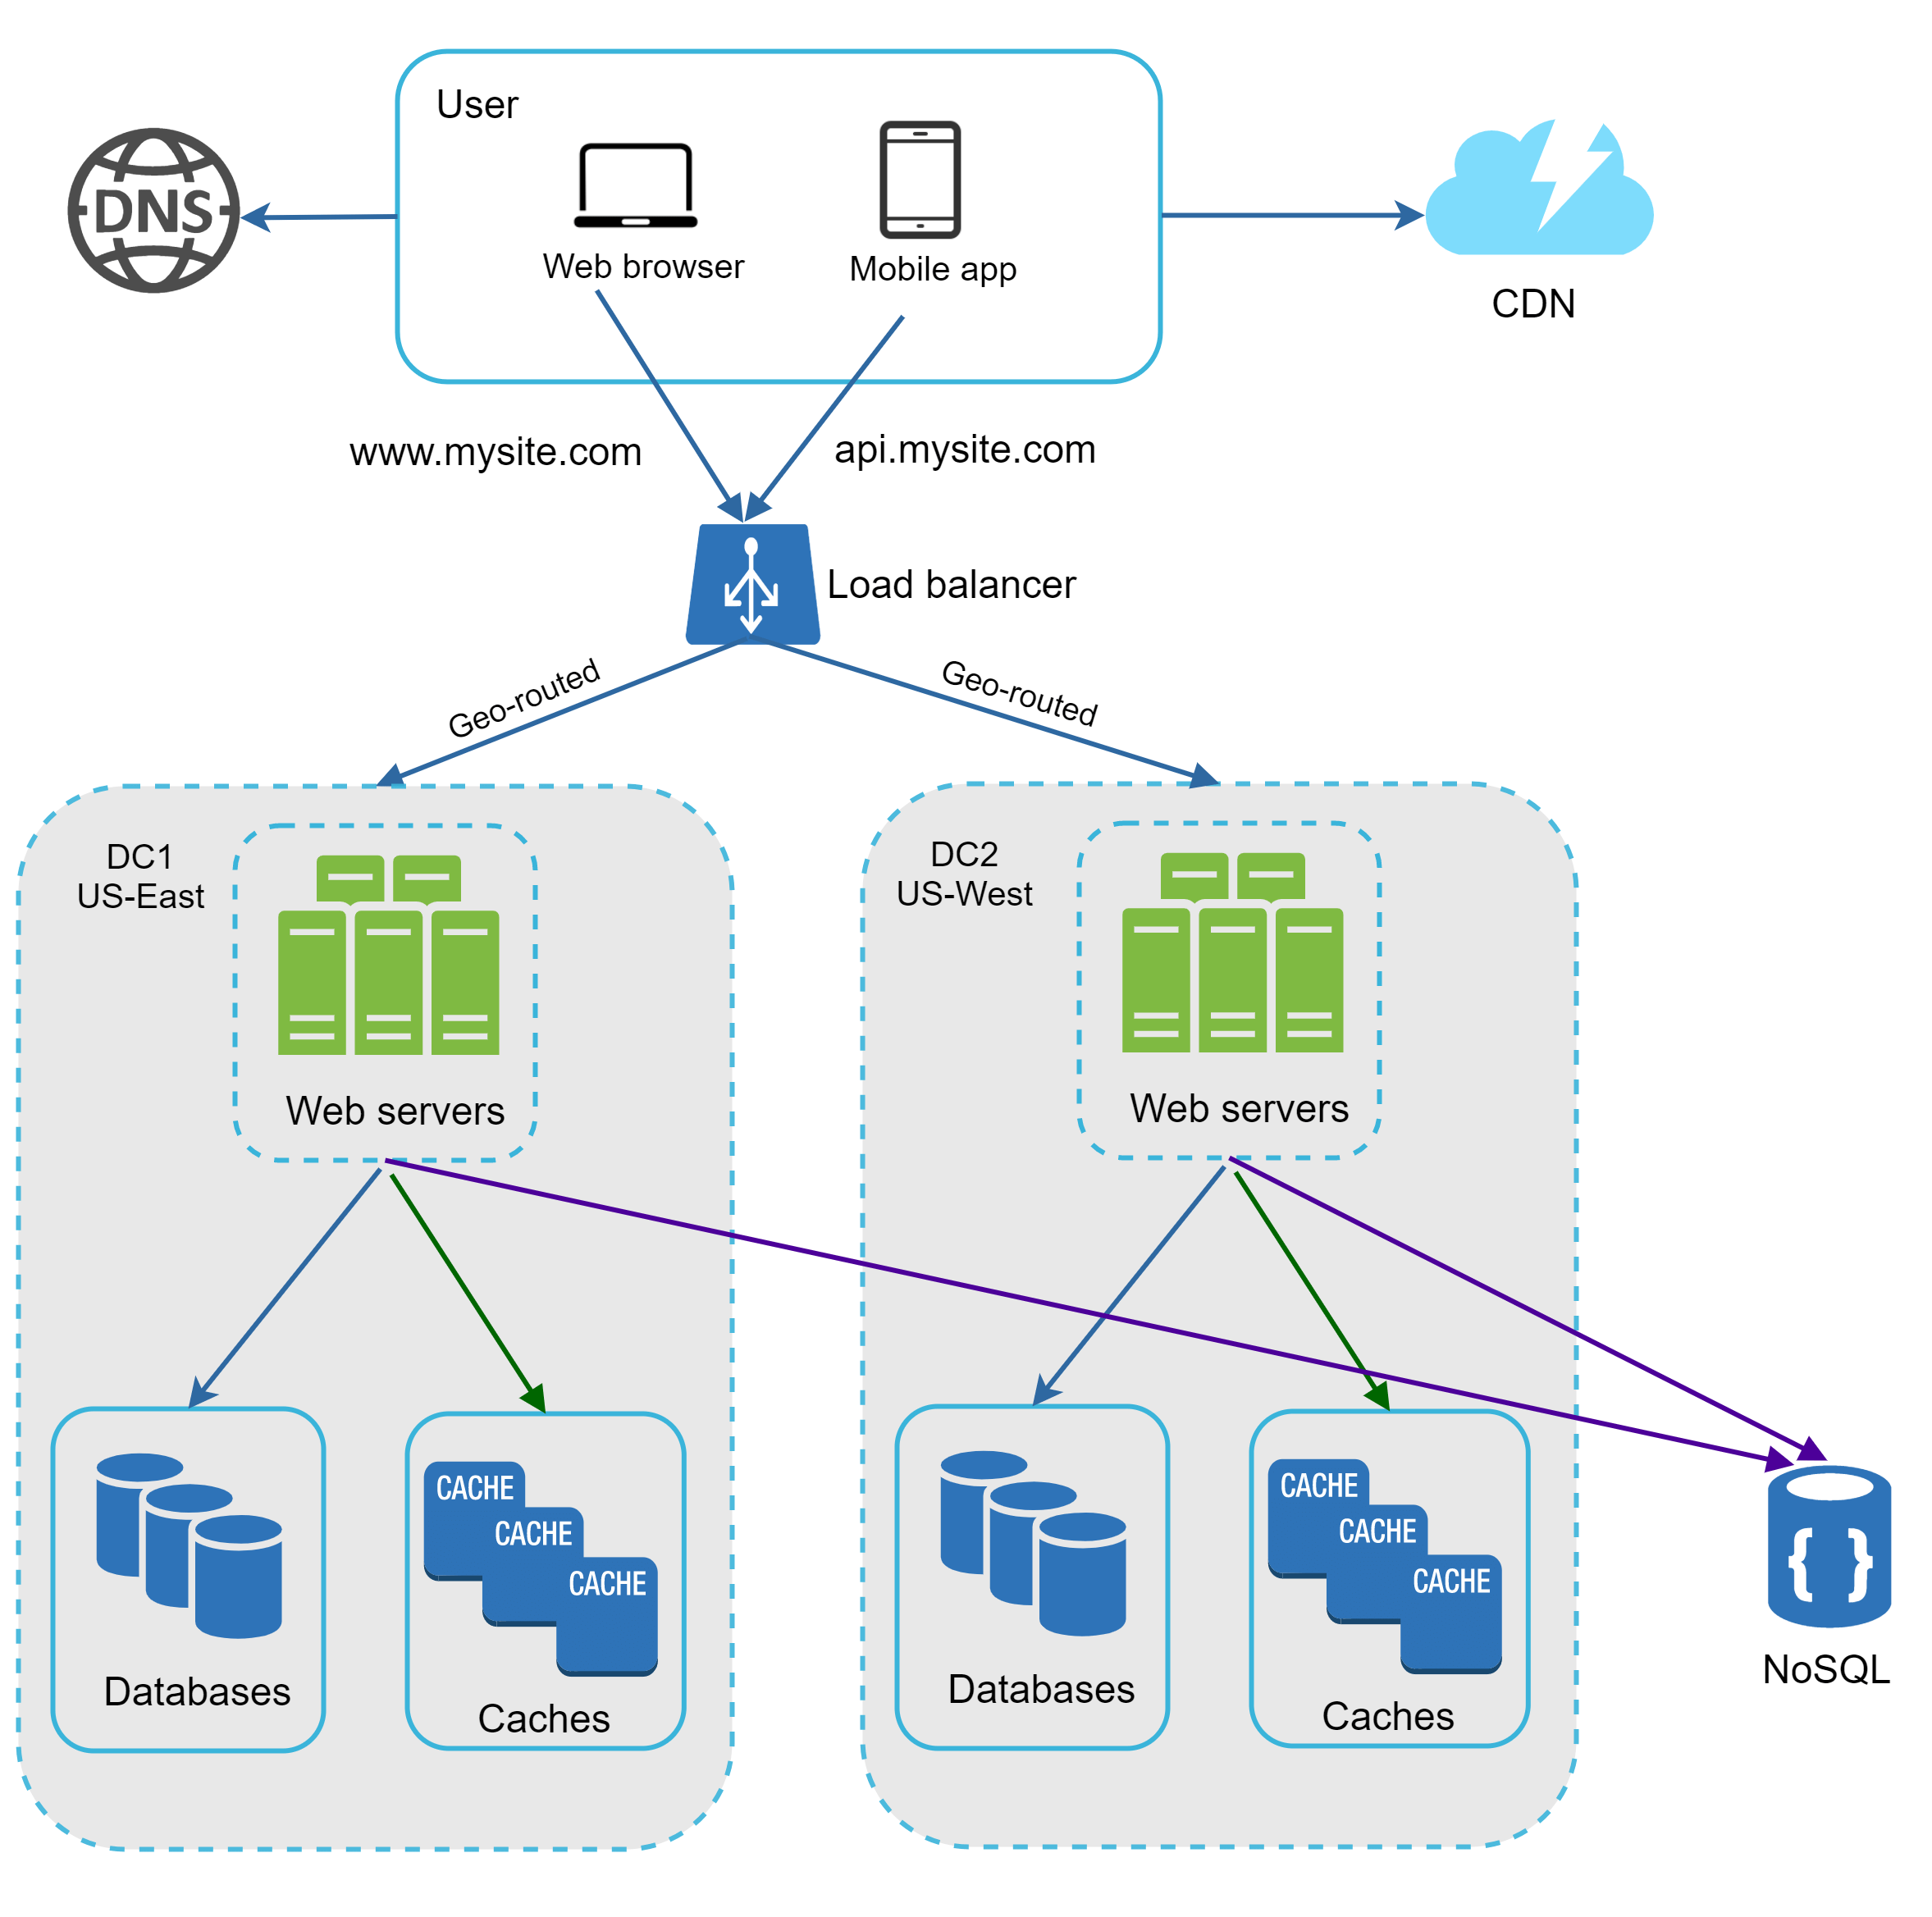
Рисунок 15
В случае серьезного сбоя в одном из дата-центров мы направляем весь трафик в исправный дата-центр. На рисунке 16 дата-центр 2 (US-West) недоступен, и 100% трафика направляется в дата-центр 1 (US-East).
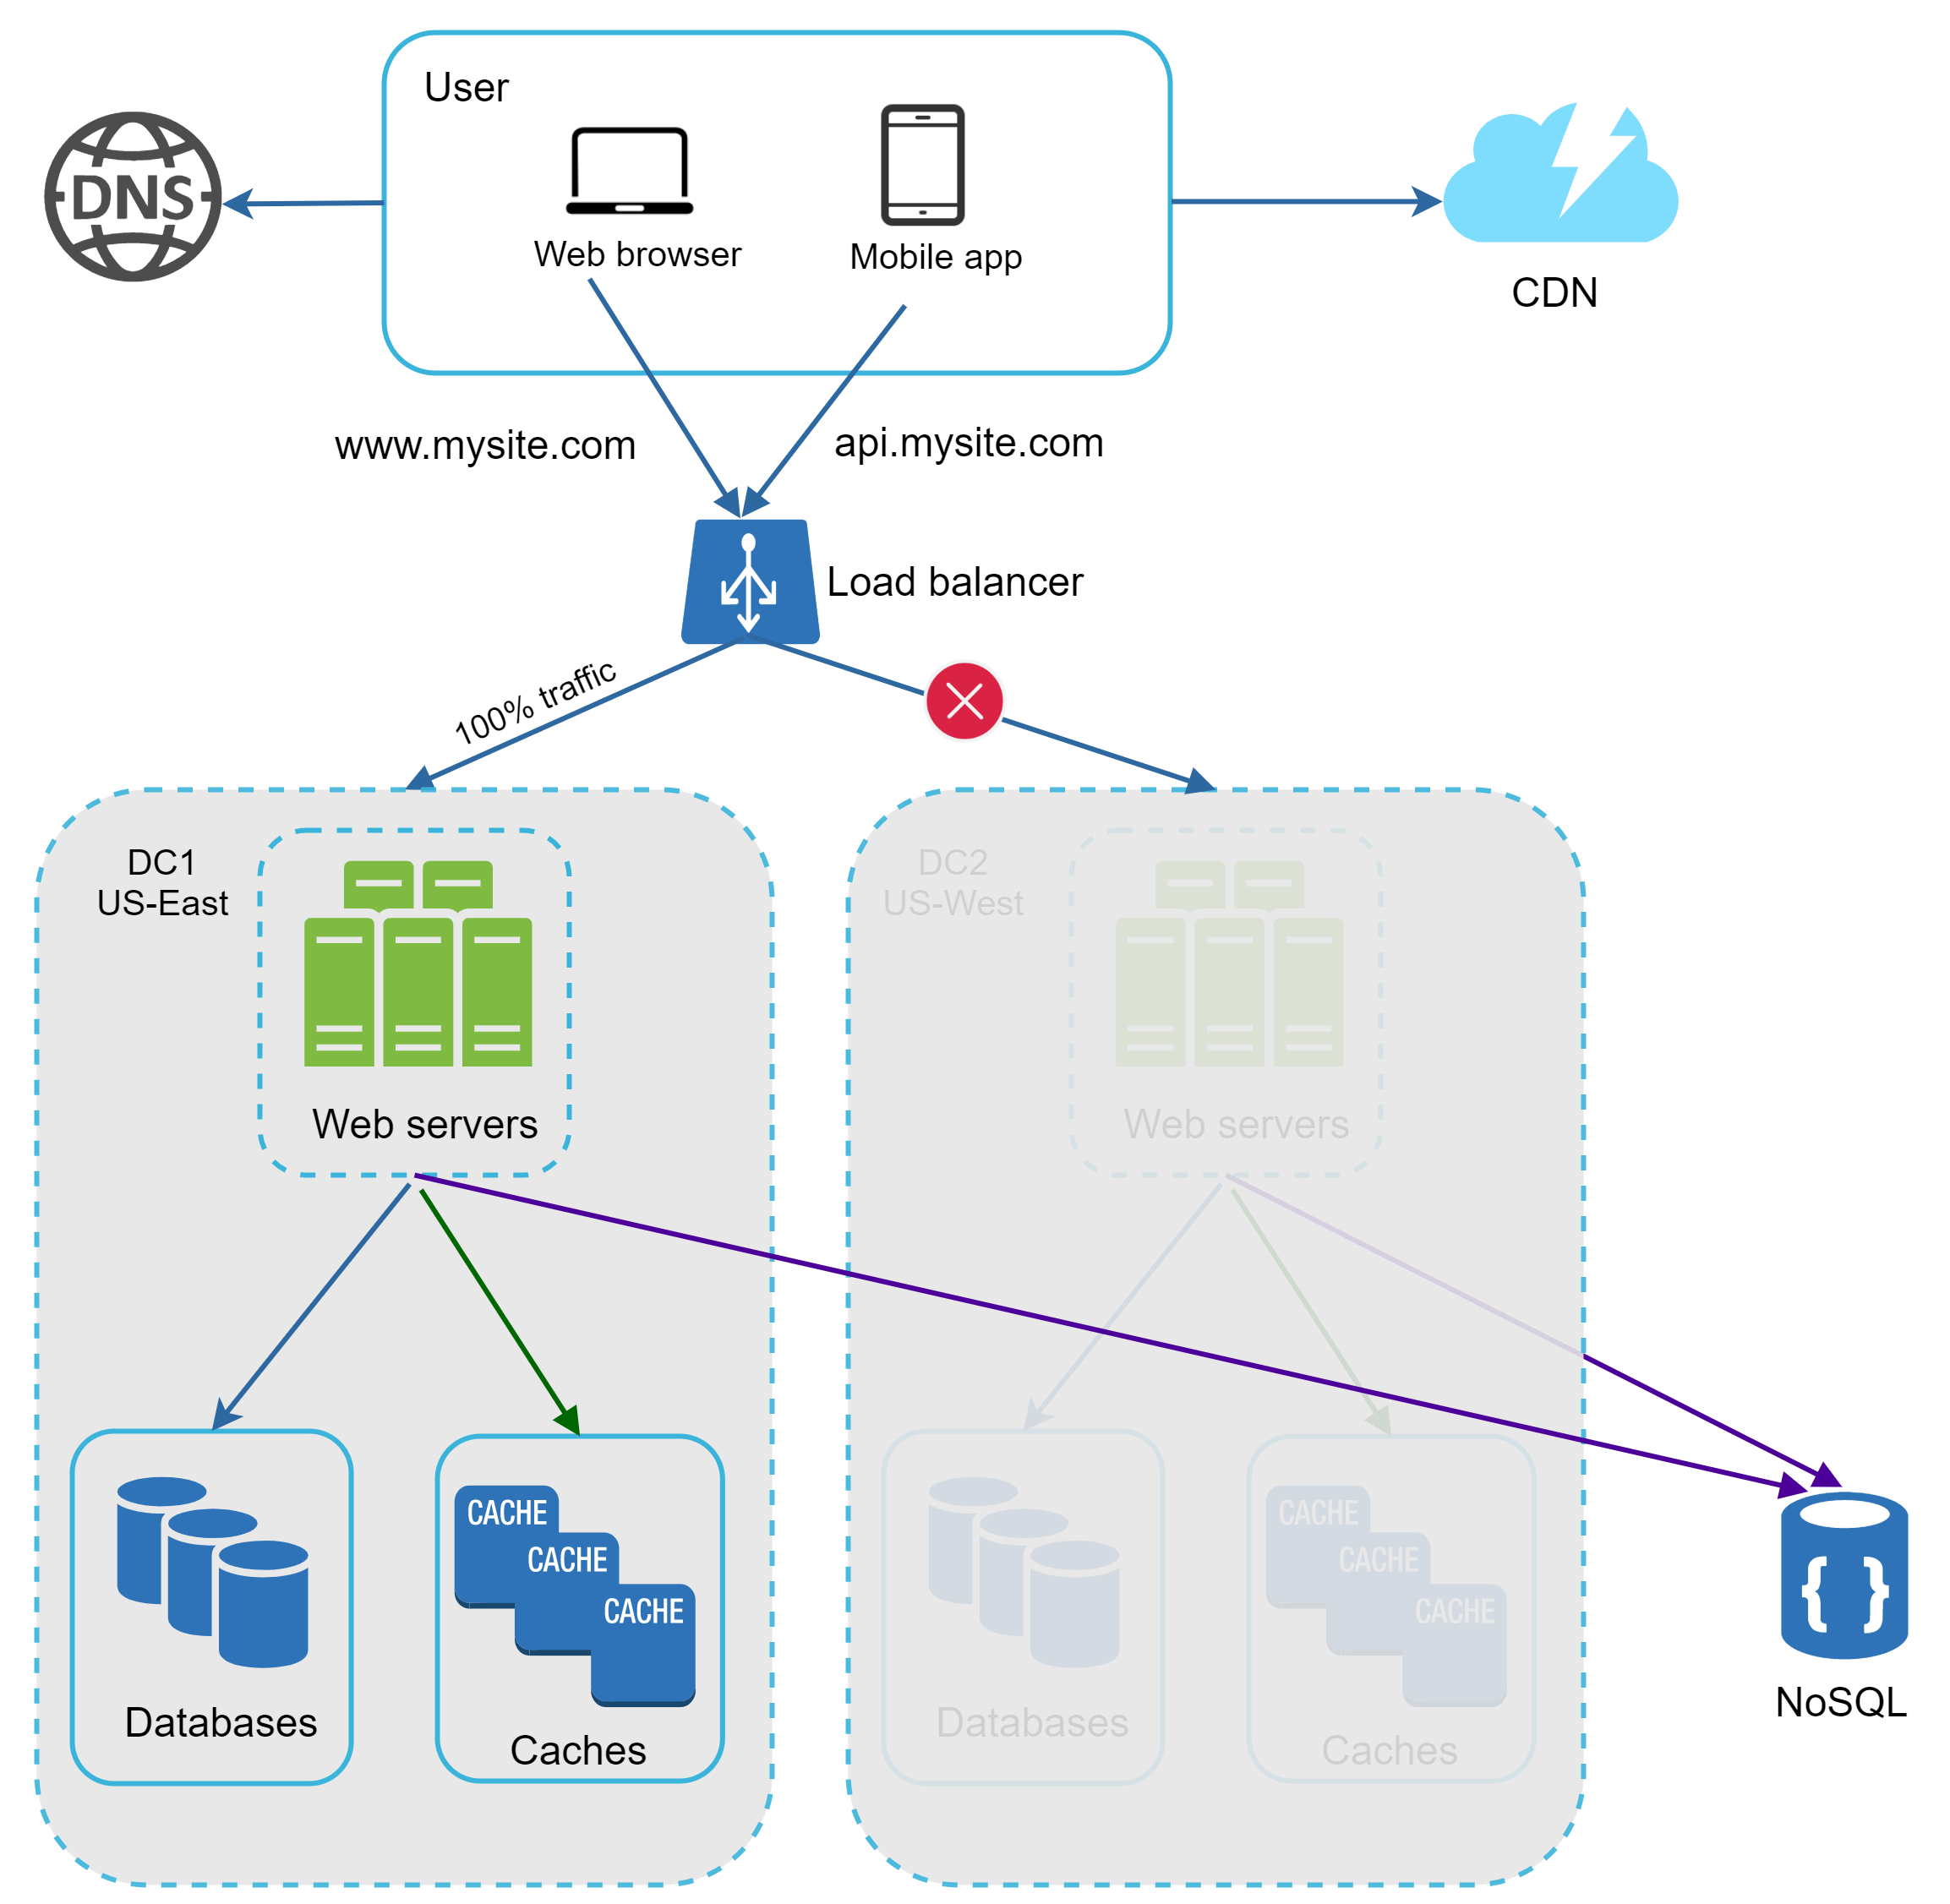
Рисунок 16
Чтобы добиться конфигурации с несколькими дата-центрами, нужно решить несколько технических задач:
-
Перенаправление трафика: нужны эффективные инструменты, позволяющие направлять трафик в правильный дата-центр. Для этого можно использовать GeoDNS, который будет отправлять трафик в ближайший дата-центр в зависимости от местоположения пользователя.
-
Синхронизация данных: пользователи из разных регионов могут использовать разные локальные базы данных или кэши. В случае переключения при отказе трафик может быть направлен в дата-центр, где нужные данные недоступны. Распространенная стратегия — реплицировать данные между несколькими дата-центрами. В одном из предыдущих исследований показано, как Netflix реализует асинхронную репликацию между несколькими дата-центрами [11].
-
Тестирование и развертывание: при конфигурации с несколькими дата-центрами важно тестировать сайт/приложение в разных локациях. Автоматизированные инструменты развертывания крайне важны, чтобы поддерживать согласованность сервисов во всех дата-центрах [11].
Чтобы масштабировать систему дальше, нам нужно развязать разные компоненты системы, чтобы их можно было масштабировать независимо. Очередь сообщений — одна из ключевых стратегий, которую многие реальные распределенные системы используют для решения этой задачи.
Очередь сообщений
Очередь сообщений — это долговечный компонент, хранящийся в памяти и поддерживающий асинхронное взаимодействие. Она служит буфером и распределяет асинхронные запросы. Базовая архитектура очереди сообщений проста. Входные сервисы, называемые producers/publishers (производителями / издателями), создают сообщения и публикуют их в очередь сообщений. Другие сервисы или серверы, называемые consumers/subscribers (потребителями / подписчиками), подключаются к очереди и выполняют действия, определенные сообщениями. Эта модель показана на рисунке 17.

Рисунок 17
Именно благодаря развязке компонентов очередь сообщений является предпочтительной архитектурой для построения масштабируемого и надежного приложения. С очередью сообщений производитель может отправить сообщение в очередь, даже если потребитель в этот момент недоступен для его обработки. Потребитель может читать сообщения из очереди, даже когда производитель недоступен.
Рассмотрим следующий сценарий: ваше приложение поддерживает обработку фотографий, включая кадрирование, повышение резкости, размытие и т. д. Такие задачи требуют времени. На рисунке 18 веб-серверы публикуют задачи по обработке фотографий в очередь сообщений. Воркеры по обработке фотографий забирают задачи из очереди сообщений и асинхронно выполняют обработку изображений. Производителя и потребителя можно масштабировать независимо. Когда размер очереди становится большим, для сокращения времени обработки добавляется больше воркеров. Если же очередь большую часть времени пуста, количество воркеров можно уменьшить.

Рисунок 18
Логирование, метрики, автоматизация
Когда вы работаете с небольшим сайтом, который работает на нескольких серверах, поддержка логирования, метрик и автоматизации — это хорошие практики, но еще не необходимость. Однако теперь, когда ваш сайт вырос и обслуживает крупный бизнес, инвестиции в такие инструменты становятся обязательными.
Логирование: мониторинг логов ошибок важен, потому что он помогает выявлять ошибки и проблемы в системе. Можно отслеживать логи ошибок на уровне каждого сервера или использовать инструменты для их агрегации в централизованный сервис, где их удобно искать и просматривать.
Метрики: сбор различных типов метрик помогает получать бизнес-инсайты и понимать состояние системы. Полезны, например, следующие метрики:
-
Метрики уровня хоста: CPU, память, дисковый ввод-вывод и т. д.
-
Агрегированные метрики: например, производительность всего уровня баз данных, уровня кэша и т. д.
-
Ключевые бизнес-метрики: ежедневная активная аудитория, удержание, выручка и т. д.
Автоматизация: когда система становится большой и сложной, нам нужно создавать или использовать инструменты автоматизации, чтобы повышать продуктивность. Continuous integration — хорошая практика, при которой каждый коммит проверяется автоматически, что позволяет командам рано обнаруживать проблемы. Кроме того, автоматизация процессов сборки, тестирования, развертывания и т. д. может значительно повысить продуктивность разработчиков.
Добавление очередей сообщений и различных инструментов
На рисунке 19 показан обновленный дизайн. Из-за ограничений по месту на рисунке показан только один дата-центр.
1. Дизайн включает очередь сообщений, которая помогает сделать систему более слабо связанной и устойчивой к сбоям.
2. Включены инструменты логирования, мониторинга, метрик и автоматизации.
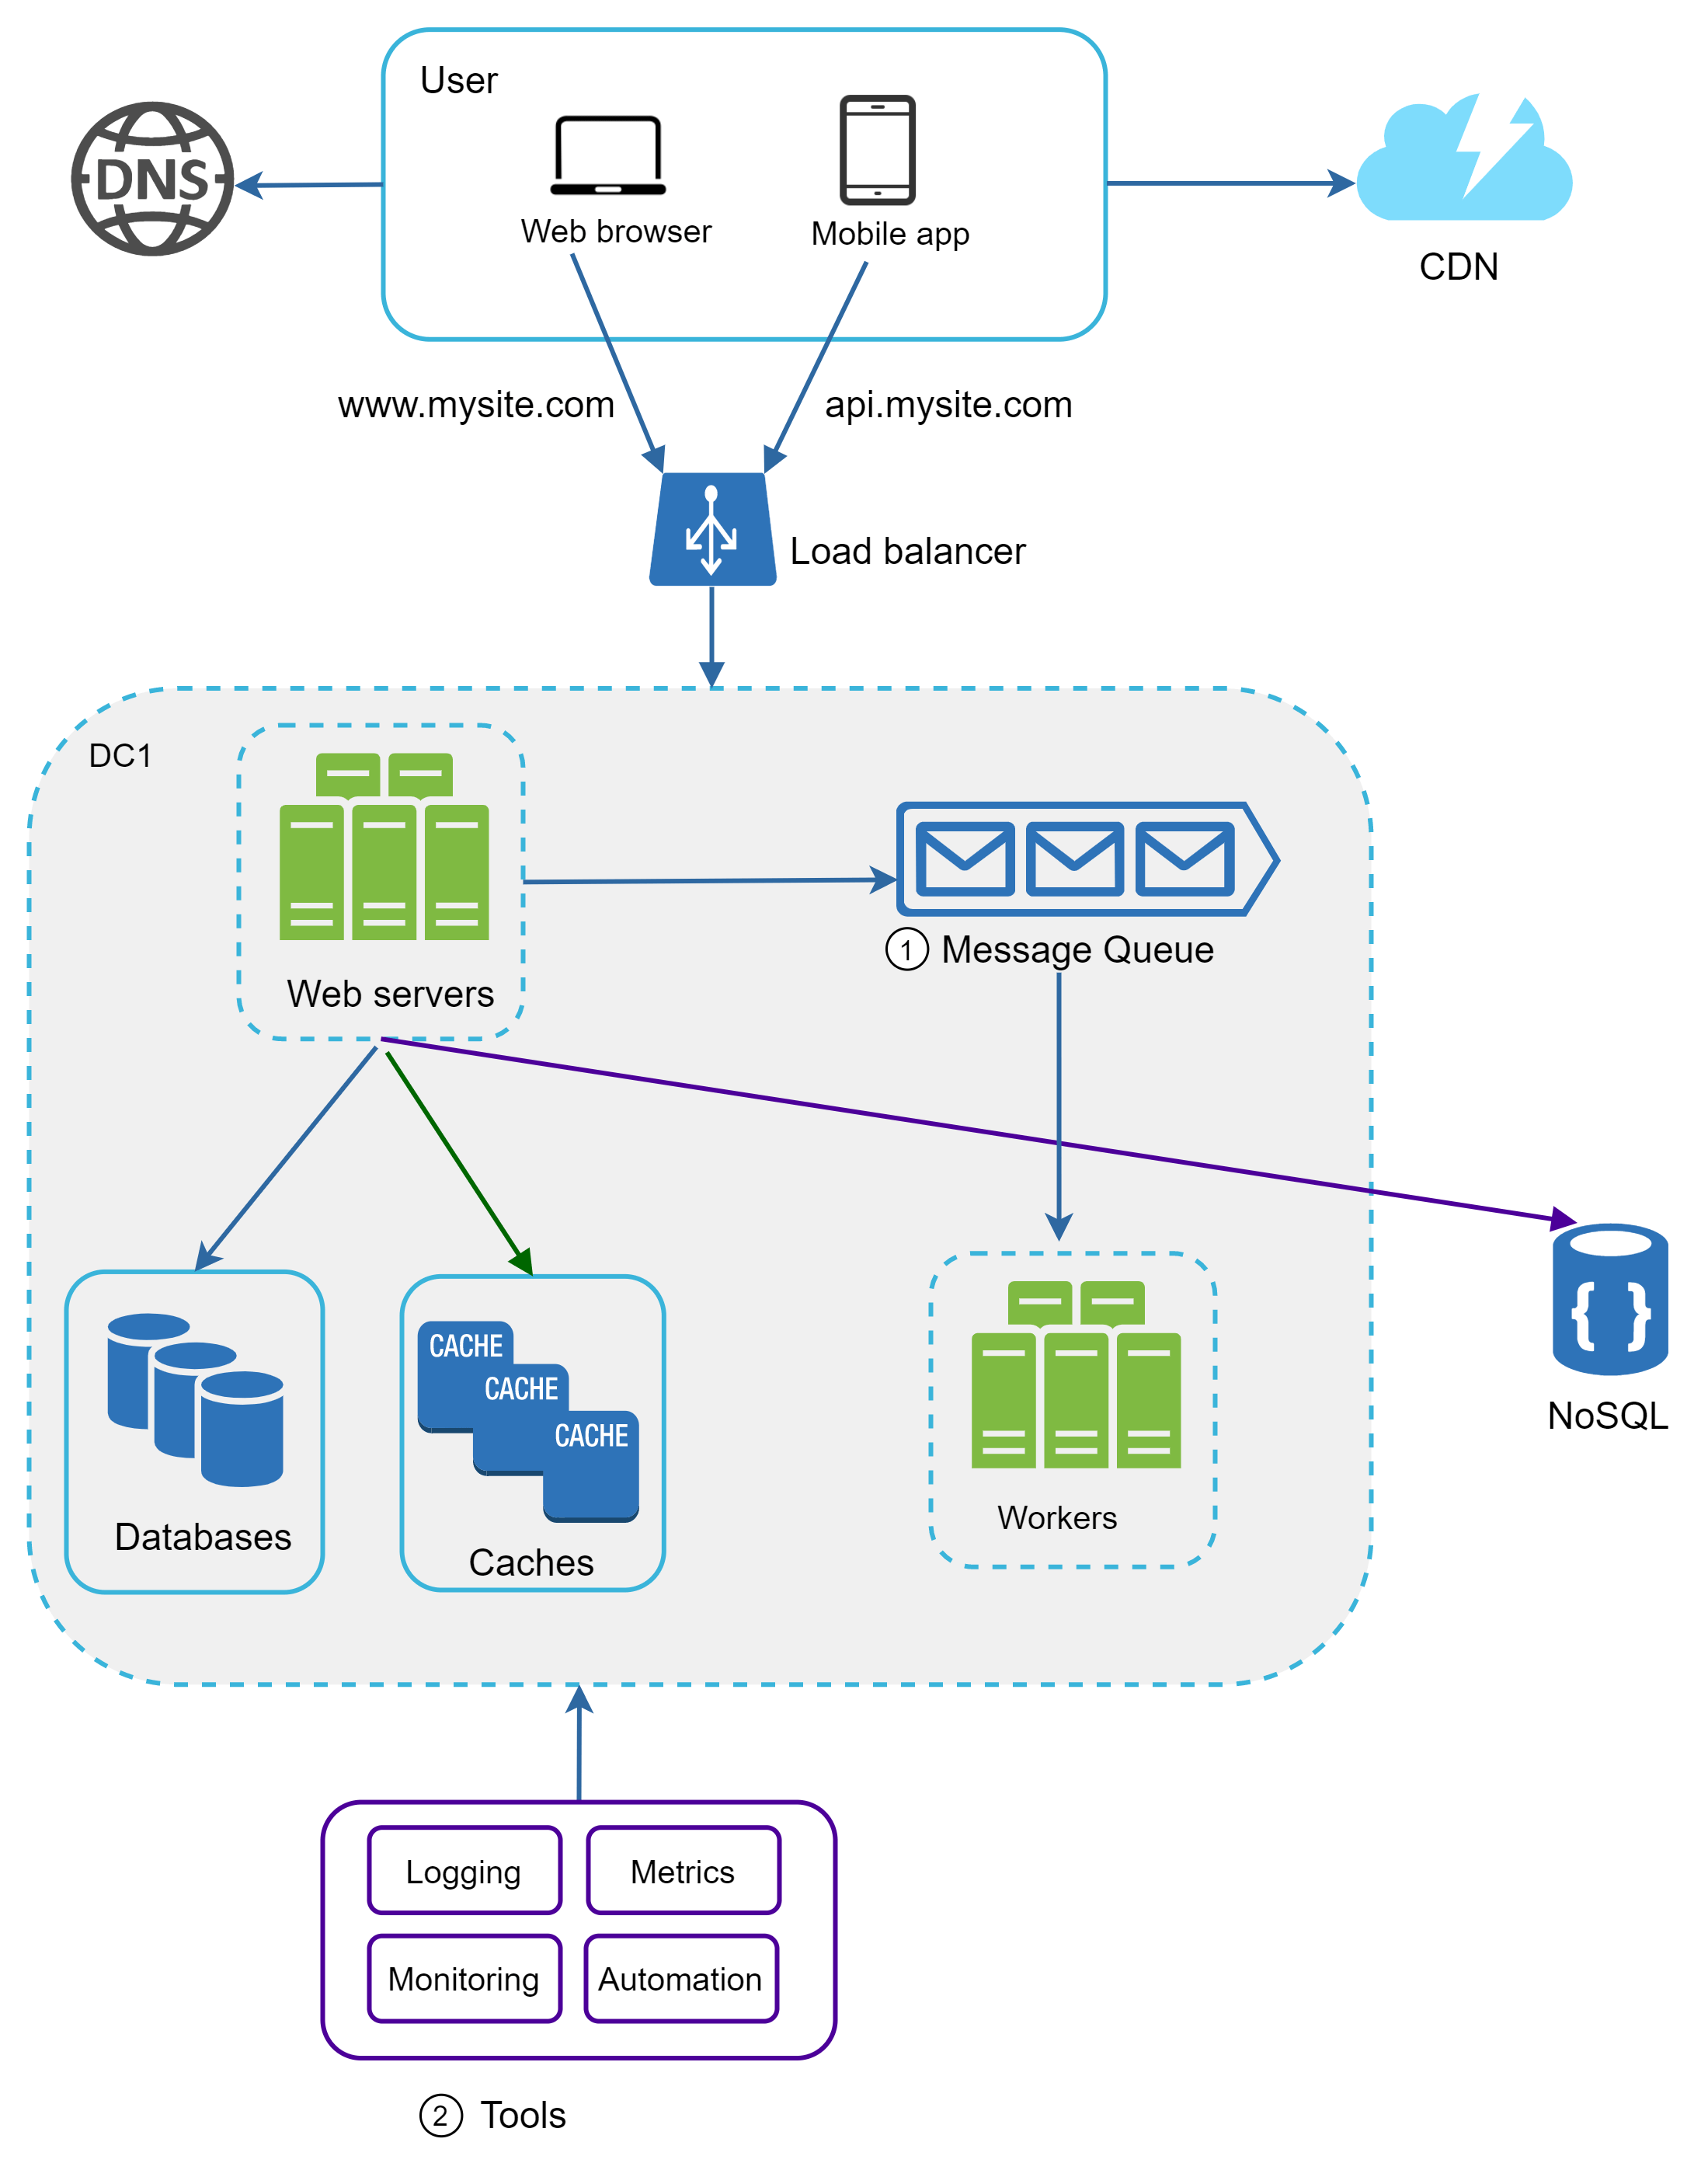
Рисунок 19
По мере ежедневного роста данных ваша база данных становится все более перегруженной. Пришло время масштабировать уровень данных.
Масштабирование базы данных
Есть два широких подхода к масштабированию базы данных: вертикальное масштабирование и горизонтальное масштабирование.
Вертикальное масштабирование
Вертикальное масштабирование, также известное как scaling up, — это увеличение мощности
существующей машины за счет добавления CPU, RAM, DISK и т. д. Существуют очень мощные серверы баз
данных. Согласно Amazon Relational Database Service (RDS) [12], можно получить сервер базы
данных с 24 ТБ RAM. Такой мощный сервер способен хранить и обрабатывать огромные объемы данных.
Например, у stackoverflow.com в 2013 году было более 10 миллионов уникальных посетителей в
месяц, но при этом только 1 master-база данных [13]. Однако у вертикального масштабирования есть
серьезные недостатки:
-
Вы можете добавлять своему серверу базы данных больше CPU, RAM и т. д., но есть аппаратные пределы. Если у вас большая база пользователей, одного сервера недостаточно.
-
Более высокий риск единой точки отказа.
-
Общая стоимость вертикального масштабирования высока. Мощные серверы стоят значительно дороже.
Горизонтальное масштабирование
Горизонтальное масштабирование, также известное как шардирование (sharding), — это практика
добавления новых серверов. На рисунке 20 сравниваются вертикальное и горизонтальное
масштабирование.

Рисунок 20
Шардирование разделяет большие базы данных на более мелкие и проще управляемые части, называемые шардами. У каждого шарда одна и та же схема, хотя фактические данные на каждом шарде уникальны для него.
На рисунке 21 показан пример шардированных баз данных. Пользовательские данные распределяются по серверам баз данных на основе идентификаторов пользователей. Каждый раз, когда вы обращаетесь к данным, используется хэш-функция для поиска соответствующего шарда. В нашем примере в качестве хэш-функции используется user_id % 4. Если результат равен 0, данные сохраняются и читаются из шарда 0. Если результат равен 1, используется шард 1. Та же логика применяется и к другим шардам.

Рисунок 21
На рисунке 22 показана таблица пользователей в шардированных базах данных.

Рисунок 22
Самый важный фактор при реализации стратегии шардирования — это выбор sharding key. Ключ шардирования (также называемый partition key) состоит из одного или нескольких столбцов, которые определяют, как распределяются данные. Как показано на рисунке 22, “user_id” является ключом шардирования. Ключ шардирования позволяет эффективно извлекать и изменять данные, направляя запросы к базе данных в правильную базу. При выборе ключа шардирования одним из самых важных критериев является выбор ключа, который сможет равномерно распределять данные.
Шардирование — отличная техника для масштабирования базы данных, но это далеко не идеальное решение. Оно добавляет системе сложности и новые вызовы:
Решардирование данных: решардирование необходимо, когда 1) один шард больше не способен вмещать данные из-за быстрого роста; 2) некоторые шарды исчерпывают свою емкость быстрее других из-за неравномерного распределения данных. Когда происходит исчерпание шарда, требуется обновить функцию шардирования и переместить данные. Согласованное хеширование (consistent hashing) — часто используемая техника для решения этой проблемы.
Проблема знаменитостей: ее также называют проблемой hotspot key. Слишком частые обращения к конкретному шарду могут перегрузить сервер. Представьте, что данные Katy Perry, Justin Bieber и Lady Gaga оказались в одном и том же шарде. Для социальных приложений такой шард будет перегружен операциями чтения. Чтобы решить эту проблему, нам может потребоваться выделить отдельный шард для каждой знаменитости. Более того, каждый такой шард может нуждаться в дополнительном партиционировании.
Join и денормализация: после шардирования базы данных на несколько серверов становится трудно
выполнять операции join между шардами. Распространенный обходной путь — денормализовать базу
данных так, чтобы запросы можно было выполнять по одной таблице.
На рисунке 23 мы шардируем базы данных, чтобы поддержать быстро растущий трафик данных. Одновременно часть нереляционной функциональности переносится в NoSQL-хранилище, чтобы снизить нагрузку на базу данных. Ниже приведена статья, которая рассматривает множество сценариев использования NoSQL [14].
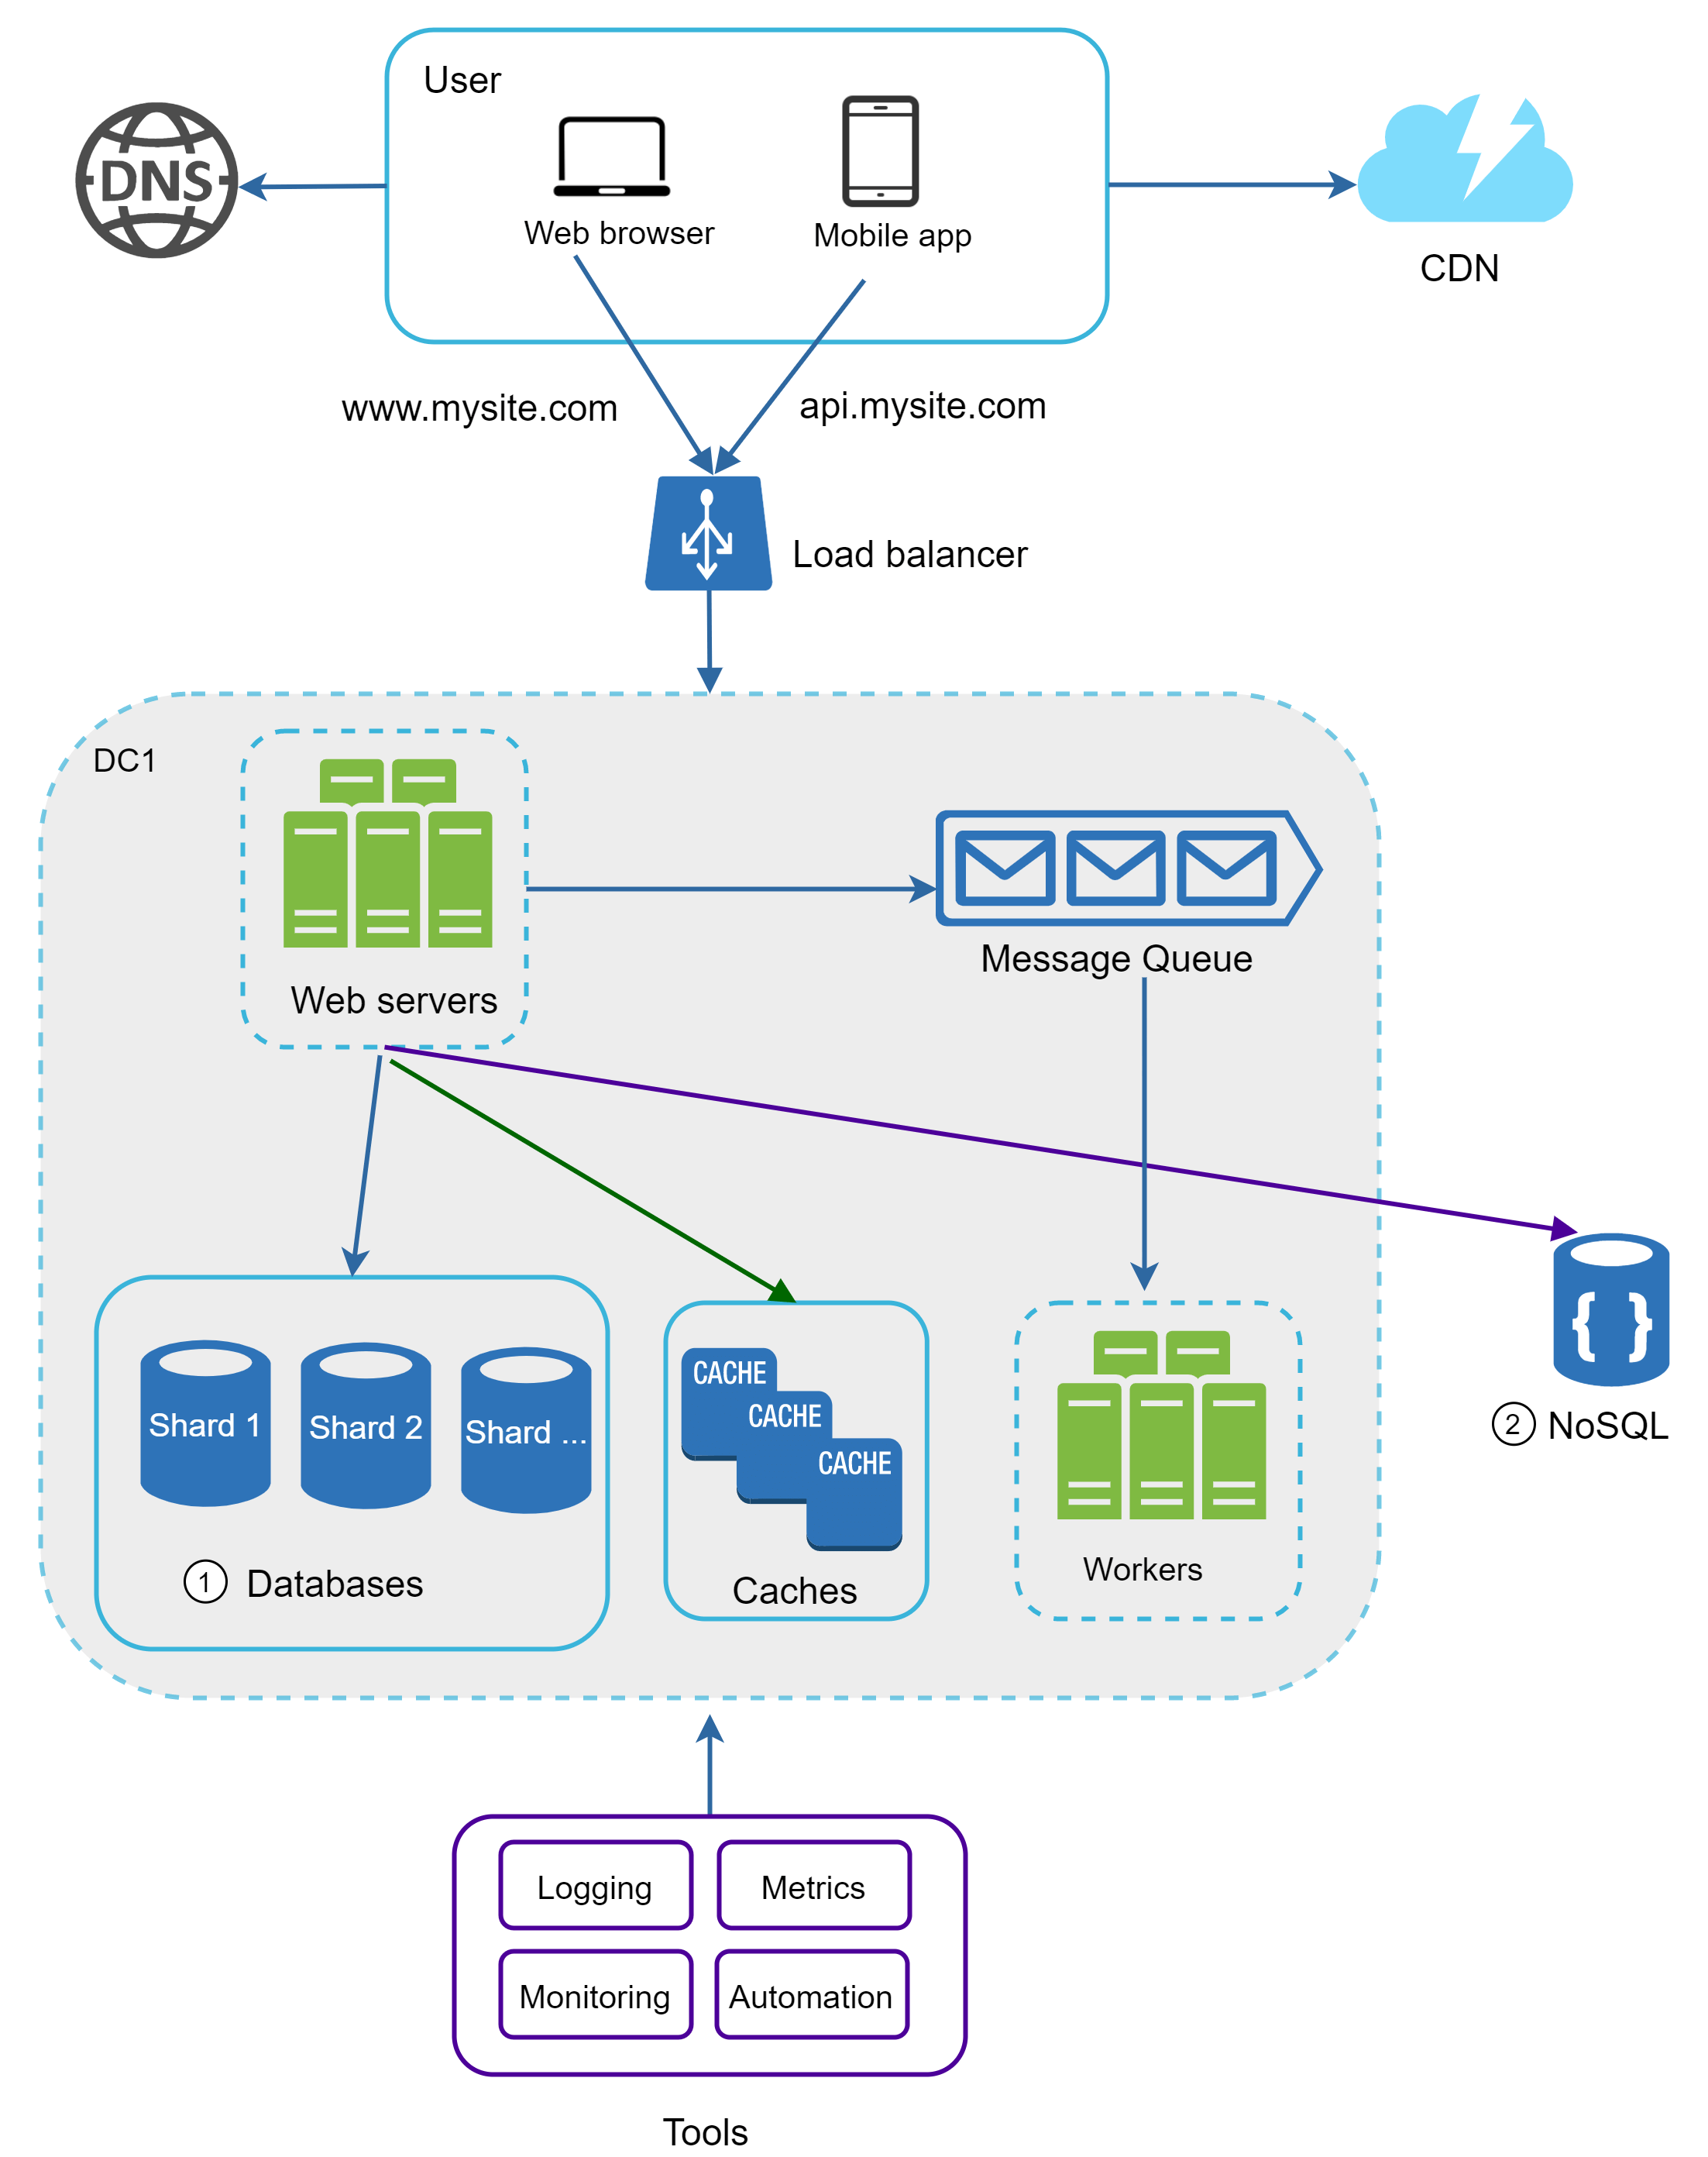
Рисунок 23
Миллионы пользователей и дальше
Масштабирование системы — это итеративный процесс. Если продолжать развивать идеи, изученные в этой главе, можно зайти очень далеко. Для масштабирования за пределы миллионов пользователей понадобятся дополнительные улучшения и новые стратегии. Например, вам может понадобиться оптимизировать систему и разделить ее на еще более мелкие сервисы. Все техники, изученные в этой главе, создают хорошую основу для решения новых задач. В завершение главы приведем краткое резюме того, как мы масштабируем систему, чтобы она поддерживала миллионы пользователей:
-
Делайте веб-уровень без состояния
-
Стройте избыточность на каждом уровне
-
Кэшируйте данные настолько активно, насколько это возможно
-
Поддерживайте несколько дата-центров
-
Размещайте статические ресурсы в CDN
-
Масштабируйте уровень данных с помощью шардирования
-
Разделяйте уровни на отдельные сервисы
-
Мониторьте систему и используйте инструменты автоматизации
Поздравляем, вы добрались до этого места! Теперь можете похлопать себя по плечу. Отличная работа!
Список литературы
[1] Hypertext Transfer Protocol: https://en.wikipedia.org/wiki/Hypertext_Transfer_Protocol
[2] Should you go Beyond Relational Databases?:
https://blog.teamtreehouse.com/should-you-go-beyond-relational-databases
[3] Replication: https://en.wikipedia.org/wiki/Replication_(computing)
[4] Multi-master replication:
https://en.wikipedia.org/wiki/Multi-master_replication
[5] NDB Cluster Replication: Bidirectional and Circular Replication:
https://dev.mysql.com/doc/refman/8.4/en/mysql-cluster-replication-multi-source.html
[6] Caching Strategies and How to Choose the Right One:
https://codeahoy.com/2017/08/11/caching-strategies-and-how-to-choose-the-right-one/
[7] R. Nishtala etc. al., "Scaling Memcache at Facebook," 10th USENIX Symposium on Networked Systems Design and Implementation (NSDI ’13): https://www.usenix.org/system/files/conference/nsdi13/nsdi13-final170_update.pdf
[8] Single point of failure: https://en.wikipedia.org/wiki/Single_point_of_failure
[9] Amazon CloudFront Dynamic Content Delivery:
https://aws.amazon.com/cloudfront/dynamic-content/
[10] Configure Sticky Sessions for Your Classic Load Balancer:
https://docs.aws.amazon.com/elasticloadbalancing/latest/classic/elb-sticky-sessions.html
[11] Active-Active for Multi-Regional Resiliency:
https://netflixtechblog.com/active-active-for-multi-regional-resiliency-c47719f6685b
[12] Amazon EC2 High Memory Instances:
https://aws.amazon.com/ec2/instance-types/high-memory/
[13] What it takes to run Stack Overflow:
http://nickcraver.com/blog/2013/11/22/what-it-takes-to-run-stack-overflow
[14] What The Heck Are You Actually Using NoSQL For:
http://highscalability.com/blog/2010/12/6/what-the-heck-are-you-actually-using-nosql-for.html