Веб-Краулер (граббер)
В этой главе мы сосредоточимся на проектировании web crawler — интересном и классическом вопросе по системному дизайну.
Web crawler также называют robot или spider. Он широко используется поисковыми системами для обнаружения нового или обновленного контента в интернете. Контентом может быть web page, изображение, видео, PDF-файл и т. д. Web crawler начинает с набора начальных страниц, а затем переходит по найденным на них ссылкам и собирает новый контент. На рисунке 1 показан визуальный пример процесса обхода.
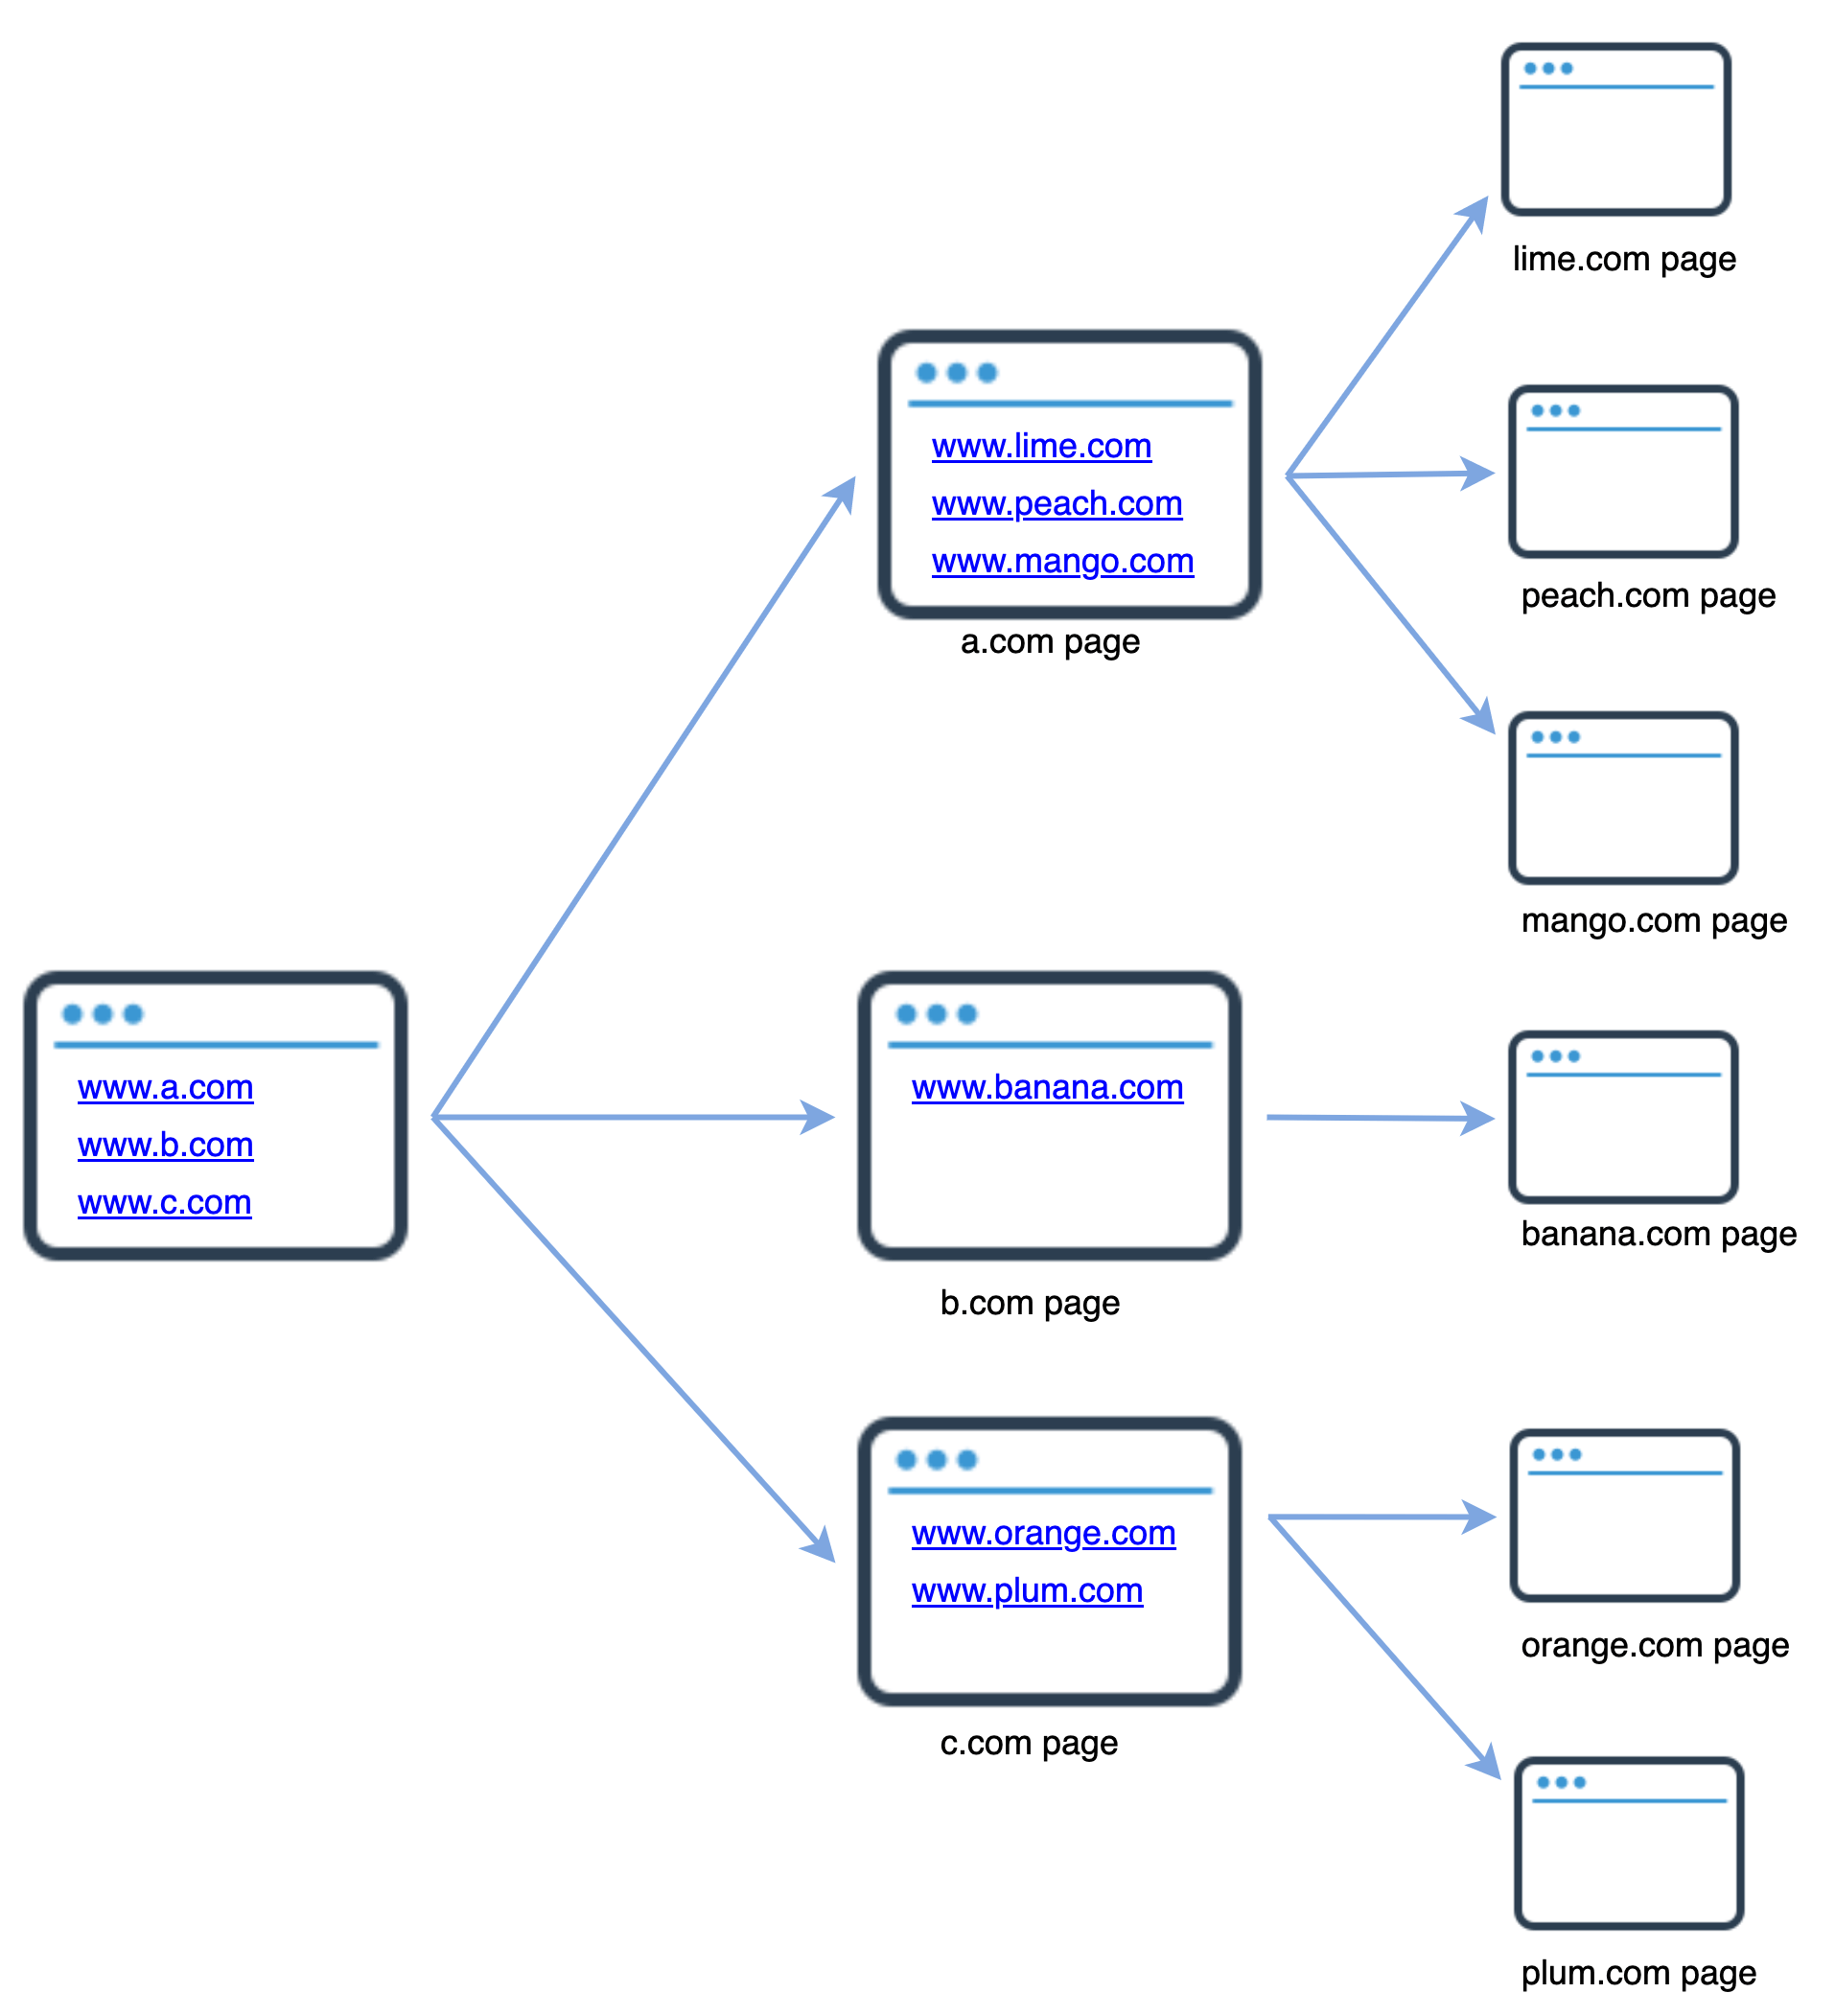
Рисунок 1
Crawler используется для многих задач:
-
Индексация поисковой системы: это самый распространенный сценарий. Crawler собирает web pages, чтобы построить локальный индекс для поисковой системы. Например, Googlebot — это web crawler, лежащий в основе поисковика Google.
-
Веб-архивирование: это процесс сбора информации из интернета для сохранения данных на будущее. Например, многие национальные библиотеки запускают crawler, чтобы архивировать сайты. Известные примеры — US Library of Congress [1] и EU web archive [2].
-
Web mining: взрывной рост интернета дает беспрецедентные возможности для анализа данных. Web mining помогает извлекать полезные знания из интернета. Например, крупные финансовые компании используют crawler, чтобы скачивать отчеты для акционеров и годовые отчеты и понимать ключевые инициативы компаний.
-
Web monitoring: crawler помогает отслеживать нарушения авторских прав и товарных знаков в интернете. Например, Digimarc [3] использует crawler для обнаружения пиратского контента.
Сложность разработки web crawler зависит от масштаба, который мы хотим поддержать. Это может быть либо небольшой учебный проект на несколько часов, либо гигантская система, требующая постоянного развития со стороны выделенной инженерной команды. Поэтому ниже мы разберем, какой масштаб и какие функции стоит поддерживать.
Шаг 1 — Понять задачу и определить рамки дизайна
Базовый алгоритм web crawler очень прост:
-
Имея набор URL, скачать все web pages по этим URL.
-
Извлечь URL из этих web pages.
-
Добавить новые URL в список адресов для скачивания. Повторять эти три шага.
Работает ли web crawler в реальности так же просто? Не совсем. Проектирование действительно масштабируемого web crawler — чрезвычайно сложная задача. Маловероятно, что кто-то сможет за время интервью спроектировать по-настоящему огромный crawler. Поэтому перед тем как переходить к дизайну, нужно задать вопросы, чтобы понять требования и зафиксировать scope:
Кандидат: Какова основная цель crawler? Индексация поисковой системы, data mining или что-то
еще?
Интервьюер: Индексация поисковой системы.
Кандидат: Сколько web pages crawler должен собирать в месяц?
Интервьюер: 1 миллиард страниц.
Кандидат: Какие типы контента включены? Только HTML или также PDF, изображения и т. д.?
Интервьюер: Только HTML.
Кандидат: Нужно ли учитывать новые или измененные страницы?
Интервьюер: Да, новые и измененные страницы нужно учитывать.
Кандидат: Нужно ли хранить HTML-страницы, скачанные из интернета?
Интервьюер: Да, до 5 лет.
Кандидат: Как мы обрабатываем страницы с дублирующимся содержимым?
Интервьюер: Страницы с дублирующимся содержимым нужно игнорировать.
Это лишь часть возможных уточняющих вопросов. Очень важно понять требования и убрать неопределенности. Даже если задача кажется простой, ваши исходные предположения с интервьюером могут отличаться.
Кроме функциональности, полезно сразу зафиксировать характеристики хорошего web crawler:
-
Scalability: интернет огромен, в нем миллиарды страниц. Web crawling должно быть максимально эффективным и использовать parallelization.
-
Robustness: интернет полон ловушек. Плохой HTML, неотвечающие серверы, падения, вредоносные ссылки — все это обычное дело. Crawler должен уметь обрабатывать такие edge cases.
-
Politeness: crawler не должен отправлять слишком много запросов к одному сайту за короткий промежуток времени.
-
Extensibility: система должна быть достаточно гибкой, чтобы поддерживать новые типы контента с минимальными изменениями. Например, если позже мы захотим скачивать изображения, нам не должно понадобиться перепроектировать всю систему.
Оценка на салфетке
Следующие оценки основаны на множестве допущений, поэтому важно проговорить их с интервьюером:
-
Предположим, что в месяц скачивается 1 миллиард web pages.
-
QPS = 1,000,000,000 / 30 days / 24 hours / 3600 seconds ≈ 400 pages per second -
Пиковый
QPS = 2 * QPS = 800 -
Предположим, что средний размер web page — 500 КБ.
-
1 billion pages * 500 KB = 500 TBхранения в месяц. -
Если хранить данные 5 лет, получаем
500 TB * 12 months * 5 years = 30 PB.
Для хранения пятилетнего архива нужен объем порядка 30 PB.
Шаг 2 — Предложить высокоуровневый дизайн и согласовать его
Когда требования понятны, можно переходить к high-level design. Опираясь на предыдущие исследования по web crawling [4] [5], предложим дизайн, показанный на рисунке 2.

Рисунок 2
Сначала разберем каждый компонент системы и его функцию. Затем пройдемся по workflow шаг за шагом.
Seed URLs
Web crawler использует seed URLs как стартовые точки обхода. Например, если нужно скачать все страницы сайта университета, естественным выбором будет использовать доменное имя университета в качестве seed URL.
Чтобы обходить весь интернет, нужно подходить к выбору seed URLs креативно. Хороший seed URL — это хорошая стартовая точка, позволяющая crawler пройти по максимально возможному числу ссылок. Общая стратегия — разбить все пространство URL на более мелкие части. Один подход основан на локальности, потому что в разных странах популярны разные сайты. Другой — выбирать seed URLs по тематикам: shopping, sports, healthcare и т. д. Выбор seed URL — открытый вопрос, тут не нужно искать идеальный ответ, достаточно рассуждать вслух.
URL Frontier
Большинство современных crawler делят состояние обхода на две части: «нужно скачать» и «уже скачано». Компонент, который хранит URL для будущего скачивания, называется URL Frontier. Можно считать его очередью First-In-First-Out (FIFO). Подробнее о URL Frontier поговорим в deep dive.
HTML Downloader
HTML downloader скачивает web pages из интернета. URL для скачивания он получает от URL Frontier.
DNS Resolver
Чтобы скачать web page, URL нужно преобразовать в IP-адрес. HTML Downloader обращается к DNS
Resolver и получает соответствующий IP. Например, URL www.wikipedia.org может быть преобразован в
IP 198.35.26.96.
Content Parser
После скачивания страницу нужно распарсить и провалидировать, потому что malformed web pages могут вызвать проблемы и только зря занимать место в хранилище. Если парсер встроить прямо в crawl server, это замедлит crawling, поэтому content parser выделяется в отдельный компонент.
Content Seen?
Исследования показывают [6], что около 29% web pages содержат дублирующийся контент, из-за чего
одни и те же данные могут храниться многократно. Чтобы убрать избыточность и сократить время
обработки, мы вводим структуру Content Seen?. Она помогает определить, встречалось ли такое
содержимое раньше. Сравнивать HTML-документы можно посимвольно, но это слишком медленно, особенно
когда речь идет о миллиардах страниц. Более эффективный способ — сравнивать hash values двух web
pages [7].
Content Storage
Это система хранения HTML-контента. Выбор конкретного хранилища зависит от типа данных, объема, частоты доступа, времени жизни и т. д. Используются и диск, и память.
-
Основная часть контента хранится на диске, потому что данных слишком много, чтобы уместить их в памяти.
-
Популярный контент хранится в памяти, чтобы уменьшить latency.
URL Extractor
URL Extractor парсит HTML-страницы и извлекает из них ссылки. На рисунке 3 показан пример процесса
извлечения ссылок. Относительные пути преобразуются в абсолютные URL путем добавления префикса
https://en.wikipedia.org.

Рисунок 3
URL Filter
URL filter исключает определенные типы контента, расширения файлов, битые ссылки и URL с сайтов, внесенных в blacklist.
URL Seen?
URL Seen? — это структура данных, которая отслеживает URL, уже посещенные ранее или уже
находящиеся во Frontier. Она помогает избежать многократного добавления одного и того же URL,
что увеличивало бы нагрузку на серверы и могло бы приводить к бесконечным циклам.
Bloom filter и hash table — типичные способы реализации URL Seen?. Подробную реализацию мы здесь
не рассматриваем; подробнее см. [4] [8].
URL Storage
URL Storage хранит уже посещенные URL.
Теперь, когда все компоненты разобраны, соберем их вместе и посмотрим на workflow.
Workflow web crawler
Чтобы удобнее объяснить workflow пошагово, на схему добавлены номера этапов, как показано на рисунке 4.

Рисунок 4
Шаг 1: добавить seed URLs в URL Frontier.
Шаг 2: HTML Downloader получает список URL из URL Frontier.
Шаг 3: HTML Downloader получает IP-адреса URL через DNS Resolver и начинает скачивание.
Шаг 4: Content Parser разбирает HTML pages и проверяет, не являются ли они malformed.
Шаг 5: после парсинга и валидации контент передается в компонент Content Seen?.
Шаг 6: Content Seen? проверяет, есть ли такая HTML-page в storage.
-
Если она уже есть в storage, значит, то же содержимое по другому URL уже было обработано. В этом случае HTML-страница отбрасывается.
-
Если ее нет в storage, система еще не обрабатывала этот контент. Тогда он передается в Link Extractor.
Шаг 7: Link Extractor извлекает ссылки из HTML pages.
Шаг 8: извлеченные ссылки передаются в URL Filter.
Шаг 9: после фильтрации ссылки поступают в URL Seen?.
Шаг 10: URL Seen? проверяет, есть ли URL в storage. Если да, значит, он уже был обработан, и
ничего делать не нужно.
Шаг 11: если URL еще не обрабатывался, он добавляется в URL Frontier.
Шаг 3 — Детальный разбор дизайна
До этого мы обсуждали high-level design. Теперь разберем подробнее наиболее важные строительные блоки и техники:
-
Depth-first search (DFS) против breadth-first search (BFS)
-
URL frontier
-
HTML Downloader
-
Robustness
-
Extensibility
-
Обнаружение и предотвращение проблемного контента
DFS против BFS
Интернет можно представить как directed graph, где web pages — это nodes, а hyperlinks (URL) — edges. Процесс обхода — это traversal такого directed graph. Два классических алгоритма обхода — DFS и BFS. Однако DFS обычно не подходит, потому что глубина обхода может быть слишком большой.
BFS широко используется в web crawler и обычно реализуется через FIFO queue. В FIFO queue URL извлекаются в том же порядке, в котором были добавлены. Но у такого подхода есть две проблемы:
- Большинство ссылок на одной web page ведут обратно на тот же хост. На рисунке 5 все ссылки на
wikipedia.comвнутренние, поэтому crawler будет занят URL с одного и того же хоста (wikipedia.com). Если crawler скачивает страницы параллельно, серверы Wikipedia окажутся завалены запросами. Это считается “impolite”.

Рисунок 5
- Обычный BFS не учитывает приоритет URL. Интернет огромен, и не все страницы одинаково полезны и важны. Поэтому может понадобиться приоритизировать URL по page rank, трафику, частоте обновления и т. д.
URL frontier
URL frontier помогает решить эти проблемы. Это структура данных, которая хранит URL, ожидающие скачивания. URL frontier — важный компонент, потому что он обеспечивает politeness, URL prioritization и freshness. Важные статьи по URL frontier указаны в [5] [9]. Их основные выводы таковы.
Politeness
Обычно web crawler не должен отправлять слишком много запросов на один и тот же host за короткий период. Иначе это считается “impolite” и даже может трактоваться как DoS-атака. Например, без ограничений crawler может посылать тысячи запросов в секунду к одному сайту и перегружать его.
Общая идея соблюдения politeness — скачивать не больше одной страницы за раз с одного host. Между двумя загрузками можно добавить задержку. Ограничение реализуется через mapping от hostname сайта к download worker thread. У каждого downloader thread есть собственная FIFO queue, и он скачивает только URL из нее. На рисунке 6 показан дизайн, обеспечивающий politeness.

Рисунок 6
-
Queue router: гарантирует, что каждая очередь (
b1, b2, …, bn) содержит URL только с одного host. -
Mapping table: сопоставляет каждому host одну очередь.
| Host | Queue |
|---|---|
| wikipedia.com | b1 |
| apple.com | b2 |
| ... | ... |
| nike.com | bn |
Таблица 1
-
FIFO queues
b1...bn: каждая очередь содержит URL одного и того же host. -
Queue selector: каждый worker thread сопоставлен с одной FIFO queue и скачивает URL только из нее. Логикой выбора очереди занимается Queue selector.
-
Worker threads 1..N: worker thread скачивает web pages по одной с одного и того же host. Между двумя загрузками можно добавить delay.
Priority
Случайный пост на форуме про продукты Apple имеет совсем другой вес, чем страницы на главной
странице Apple. Хотя в обоих случаях встречается слово Apple, логично, чтобы crawler сначала
обошел официальный сайт Apple.
Мы приоритизируем URL по их полезности, которую можно измерять через PageRank [10], трафик сайта,
частоту обновления и т. д. Компонент Prioritizer отвечает именно за это. Более подробную
информацию см. в [5] [10].
На рисунке 7 показан дизайн, управляющий приоритетами URL.

Рисунок 7
-
Prioritizer: принимает URL на вход и вычисляет их приоритет.
-
Queues
f1...fn: каждой очереди назначается свой приоритет. Очереди с более высоким приоритетом выбираются чаще. -
Queue selector: случайным образом выбирает очередь, но с bias в пользу более приоритетных очередей.
На рисунке 8 представлен дизайн URL frontier, который состоит из двух модулей:
-
Front queues: управляют prioritization
-
Back queues: управляют politeness

Рисунок 8
Freshness
Web pages постоянно добавляются, удаляются и редактируются. Web crawler должен периодически повторно обходить уже скачанные страницы, чтобы поддерживать наш data set свежим. Пересканировать все URL слишком дорого по времени и ресурсам, поэтому freshness обычно оптимизируют так:
-
Повторно обходить страницы на основе их истории обновлений.
-
Приоритизировать URL и чаще пересканировать важные страницы.
Хранение URL Frontier
В реальных search-engine crawler число URL во frontier может достигать сотен миллионов [4]. Хранить все в памяти неудобно: это и недолговечно, и плохо масштабируется. Хранить все на диске тоже плохо, потому что диск медленный и легко становится bottleneck.
Поэтому используется hybrid approach. Большая часть URL хранится на диске, так что с объемом хранилища проблем нет. Чтобы сократить стоимость чтений и записей на диск, enqueue/dequeue операции сначала буферизуются в памяти. Данные из буферов периодически сбрасываются на диск.
HTML Downloader
HTML Downloader скачивает web pages из интернета по HTTP. Но перед тем как обсуждать сам HTML Downloader, сначала стоит посмотреть на Robots Exclusion Protocol.
Robots.txt
robots.txt, или Robots Exclusion Protocol, — это стандарт, через который сайты сообщают crawler,
какие страницы им можно скачивать. Перед тем как начинать обход сайта, crawler должен сначала
скачать соответствующий robots.txt и следовать его правилам.
Чтобы не скачивать robots.txt повторно, результаты кэшируются. Файл периодически заново
скачивается и обновляется в кэше. Ниже приведен фрагмент robots.txt с
https://www.amazon.com/robots.txt. Некоторые директории, например creatorhub, запрещены для
Googlebot.
User-agent: Googlebot
Disallow: /creatorhub/*
Disallow: /rss/people/*/reviews
Disallow: /gp/pdp/rss/*/reviews
Disallow: /gp/cdp/member-reviews/
Disallow: /gp/aw/cr/
Кроме robots.txt, важнейшая тема для HTML Downloader — это performance optimization.
Оптимизация производительности
Ниже приведены несколько способов оптимизировать HTML Downloader.
- Distributed crawl
Чтобы добиться высокой производительности, crawl jobs распределяются по нескольким серверам, и каждый сервер запускает несколько threads. Пространство URL делится на меньшие куски, поэтому каждый downloader отвечает только за часть URL. На рисунке 9 показан пример distributed crawl.

Рисунок 9
- Кэширование DNS Resolver
DNS Resolver — это узкое место, потому что DNS-запросы занимают время из-за синхронной природы многих DNS-интерфейсов. Время ответа DNS обычно лежит в диапазоне от 10 до 200 мс. Пока crawler thread выполняет DNS-запрос, другие потоки блокируются до завершения этой операции. Поэтому собственный DNS cache — важная техника ускорения. Такой кэш хранит mapping от domain name к IP address и периодически обновляется cron jobs.
- Locality
Распределяйте crawl servers географически. Когда crawl servers находятся ближе к host-узлам сайтов, скорость скачивания выше. Идея locality применима не только к crawl servers, но и к cache, queue, storage и другим компонентам.
- Короткий timeout
Некоторые web servers отвечают очень медленно или не отвечают вовсе. Чтобы не зависать слишком долго, задается максимальное время ожидания. Если host не отвечает в пределах заданного timeout, crawler прерывает эту задачу и переключается на другие страницы.
Robustness
Помимо производительности, важна и robustness. Вот несколько приемов для повышения устойчивости системы:
-
Consistent hashing: помогает распределять нагрузку между downloaders. Новый downloader server можно добавить или удалить с помощью consistent hashing.
-
Сохранение crawl states и data: чтобы защититься от сбоев, crawl state и данные записываются в storage system. Прерванный crawl можно легко перезапустить, загрузив сохраненное состояние.
-
Exception handling: ошибки неизбежны и обычны в крупной системе. Crawler должен обрабатывать исключения аккуратно и не рушить всю систему.
-
Data validation: важная мера для предотвращения системных ошибок.
Extensibility
Как и любая развивающаяся система, crawler должен быть достаточно гибким, чтобы поддерживать новые типы контента. Его можно расширять, подключая новые модули. На рисунке 10 показано, как это делается.

Рисунок 10
-
Модуль
PNG Downloaderподключается для скачивания PNG-файлов. -
Модуль
Web Monitorдобавляется для мониторинга web-сайтов и отслеживания нарушений авторских прав и товарных знаков.
Обнаружение и предотвращение проблемного контента
В этом разделе обсудим, как обнаруживать и избегать избыточного, бессмысленного или вредного контента.
- Избыточный контент
Как уже обсуждалось, почти 30% web pages — это дубликаты. Для их обнаружения помогают hashes и checksums [11].
- Spider traps
Spider trap — это web page, которая загоняет crawler в бесконечный цикл. Например, бесконечно глубокая структура директорий может выглядеть так:
http://www.spidertrapexample.com/foo/bar/foo/bar/foo/bar/...
Такие ловушки можно частично избегать, если ограничить максимальную длину URL. Но универсального способа обнаружения spider traps не существует. Сайты с такими ловушками обычно легко заметить по аномально большому числу найденных страниц. Построить автоматический алгоритм их обнаружения сложно, поэтому на практике пользователь может вручную проверить сайт, определить, что это spider trap, и либо исключить такой сайт из crawler, либо применить к нему специальные URL filters.
- Data noise
Часть контента несет мало или вовсе не несет ценности: реклама, куски кода, spam URLs и т. д. Такой контент не полезен crawler и должен по возможности исключаться.
Шаг 4 — Подведем итоги
В этой главе мы сначала обсудили свойства хорошего crawler: scalability, politeness, extensibility и robustness. Затем предложили дизайн и разобрали его ключевые компоненты. Построение масштабируемого web crawler — нетривиальная задача, потому что интернет огромен и полон ловушек. Даже после такого разбора остается еще много важных тем:
-
Server-side rendering: многие сайты используют JavaScript, AJAX и подобные технологии для динамической генерации ссылок. Если просто скачивать и парсить HTML, мы не увидим эти ссылки. Чтобы решить проблему, можно сначала выполнить server-side rendering (или dynamic rendering), а потом парсить страницу [12].
-
Фильтрация нежелательных страниц: при ограниченных ресурсах хранения и crawling полезно иметь anti-spam component, который отсекает низкокачественные и spam pages [13] [14].
-
Репликация и шардинг БД: техники вроде replication и sharding используются для повышения availability, scalability и reliability на data layer.
-
Horizontal scaling: для масштабного crawling могут понадобиться сотни или даже тысячи серверов. Ключевой принцип — держать серверы stateless.
-
Availability, consistency и reliability: эти концепции лежат в основе успеха любой крупной системы.
-
Analytics: сбор и анализ данных важны для любой системы, потому что именно данные позволяют тонко ее настраивать.
Поздравляем, вы дошли до этого места! Можно похлопать себя по плечу. Отличная работа!
Справочные материалы
[1] US Library of Congress: https://www.loc.gov/websites/
[2] EU Web Archive: http://data.europa.eu/webarchive
[3] Digimarc:
https://www.digimarc.com/products/digimarc-services/piracy-intelligence
[4] Heydon A., Najork M. Mercator: A scalable, extensible web crawler World Wide Web, 2 (4) (1999), pp. 219-229
[5] By Christopher Olston, Marc Najork: Web Crawling.
http://infolab.stanford.edu/~olston/publications/crawling_survey.pdf
[6] 29% Of Sites Face Duplicate Content Issues:
https://tinyurl.com/y6tmh55y
[7] Rabin M.O., et al. Fingerprinting by random polynomials Center for Research in Computing Techn., Aiken Computation Laboratory, Univ. (1981)
[8] B. H. Bloom, “Space/time trade-offs in hash coding with allowable errors,” Communications of the ACM, vol. 13, no. 7, pp. 422–426, 1970.
[9] Donald J. Patterson, Web Crawling:
https://www.ics.uci.edu/~lopes/teaching/cs221W12/slides/Lecture05.pdf
[10] L. Page, S. Brin, R. Motwani, and T. Winograd, “The PageRank citation ranking: Bringing order to the web,” Technical Report, Stanford University, 1998.
[11] Burton Bloom. Space/time trade-offs in hash coding with allowable errors. Communications of the ACM, 13(7), pages 422--426, July 1970.
[12] Google Dynamic Rendering:
https://developers.google.com/search/docs/guides/dynamic-rendering
[13] T. Urvoy, T. Lavergne, and P. Filoche, “Tracking web spam with hidden style similarity,” in Proceedings of the 2nd International Workshop on Adversarial Information Retrieval on the Web, 2006.
[14] H.-T. Lee, D. Leonard, X. Wang, and D. Loguinov, “IRLbot: Scaling to 6 billion pages and beyond,” in Proceedings of the 17th International World Wide Web Conference, 2008.