Как применять предварительные расчеты
На собеседовании по проектированию систем вас иногда просят оценить емкость системы или требования к производительности с помощью быстрой приблизительной оценки. По словам Джеффа Дина, старшего научного сотрудника Google, “back-of-the-envelope calculations are estimates you create using a combination of thought experiments and common performance numbers to get a good feel for which designs will meet your requirements” [1].
Чтобы эффективно выполнять такие оценки, нужно хорошо понимать основы масштабируемости. Следующие понятия должны быть хорошо вам знакомы: степени двойки [2], числа задержек, которые должен знать каждый программист, и показатели доступности.
Степени двойки
Хотя объем данных в распределенных системах может быть огромным, все вычисления в итоге сводятся к базовым принципам. Чтобы правильно считать, критически важно знать единицы объема данных, основанные на степенях двойки. Байт — это последовательность из 8 бит. Один ASCII-символ занимает один байт памяти (8 бит). Ниже приведена таблица, объясняющая единицы объема данных (таблица 1).
| Степень | Примерное значение | Полное название | Краткое название |
|---|---|---|---|
| 10 | 1 тысяча | 1 килобайт | 1 KB |
| 20 | 1 миллион | 1 мегабайт | 1 MB |
| 30 | 1 миллиард | 1 гигабайт | 1 GB |
| 40 | 1 триллион | 1 терабайт | 1 TB |
| 50 | 1 квадриллион | 1 петабайт | 1 PB |
Таблица 1
Числа задержек, которые должен знать каждый программист
Доктор Дин из Google приводит длительности типичных компьютерных операций по состоянию на 2010 год [1]. Некоторые значения уже устарели, так как компьютеры стали быстрее и мощнее. Тем не менее эти числа по-прежнему помогают почувствовать, какие компьютерные операции являются быстрыми, а какие медленными.
| Название операции | Время |
|---|---|
| Обращение к L1-кэшу | 0.5 нс |
| Неверное предсказание ветвления | 5 нс |
| Обращение к L2-кэшу | 7 нс |
| Блокировка/разблокировка мьютекса | 100 нс |
| Обращение к основной памяти | 100 нс |
| Сжать 1K байт с помощью Zippy | 10,000 нс = 10 мкс |
| Отправить 2K байт по сети 1 Gbps | 20,000 нс = 20 мкс |
| Последовательно прочитать 1 MB из памяти | 250,000 нс = 250 мкс |
| Сетевой проход туда-обратно внутри дата-центра | 500,000 нс = 500 мкс |
| Поиск на диске | 10,000,000 нс = 10 мс |
| Последовательно прочитать 1 MB из сети | 10,000,000 нс = 10 мс |
| Последовательно прочитать 1 MB с диска | 30,000,000 нс = 30 мс |
| Отправить пакет Калифорния -> Нидерланды -> Калифорния | 150,000,000 нс = 150 мс |
Таблица 2
Примечания
нс = наносекунда, мкс = микросекунда, мс = миллисекунда
1 нс = 10^-9 секунды
1 мкс = 10^-6 секунды = 1,000 нс
1 мс = 10^-3 секунды = 1,000 мкс = 1,000,000 нс
Один инженер-программист Google создал инструмент для визуализации чисел доктора Дина. Инструмент также учитывает временной масштаб. На рисунке 1 показана визуализация значений задержек по состоянию на 2020 год (источник иллюстраций: материалы из списка литературы [3]).
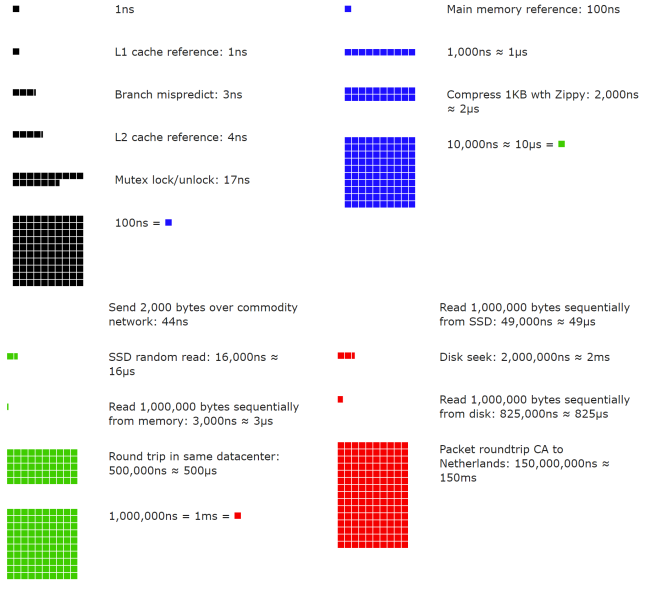
Рисунок 1
Анализируя числа на рисунке 1, можно сделать следующие выводы:
-
Память быстрая, а диск медленный.
-
По возможности избегайте операций позиционирования на диске.
-
Простые алгоритмы сжатия работают быстро.
-
Если возможно, сжимайте данные перед отправкой через интернет.
-
Дата-центры обычно находятся в разных регионах, и передача данных между ними занимает время.
Показатели доступности
Высокая доступность — это способность системы непрерывно работать в течение достаточно длительного периода времени. Высокая доступность измеряется в процентах, где 100% означает сервис с нулевым временем простоя. Большинство сервисов находятся в диапазоне между 99% и 100%.
Соглашение об уровне сервиса (SLA) — часто используемый термин среди провайдеров услуг. Это соглашение между вами (поставщиком услуги) и клиентом, которое формально определяет уровень доступности, который будет обеспечивать ваш сервис. Облачные провайдеры Amazon [4], Google [5] и Microsoft [6] устанавливают свои SLA на уровне 99.9% и выше. Доступность традиционно измеряется количеством девяток. Чем больше девяток, тем лучше. Как показано в таблице 3, количество девяток напрямую связано с ожидаемым временем простоя системы.
| Доступность % | Простой в день | Простой в неделю | Простой в месяц | Простой в год |
|---|---|---|---|---|
| 99% | 14.40 минут | 1.68 часа | 7.31 часа | 3.65 дня |
| 99.99% | 8.64 секунды | 1.01 минуты | 4.38 минуты | 52.60 минуты |
| 99.999% | 864.00 миллисекунды | 6.05 секунды | 26.30 секунды | 5.26 минуты |
| 99.9999% | 86.40 миллисекунды | 604.80 миллисекунды | 2.63 секунды | 31.56 секунды |
Таблица 3
Пример: оценка QPS и требований к хранилищу для Twitter
Обратите внимание: следующие числа используются только для этого упражнения и не являются реальными числами Twitter.
Предположения:
-
300 миллионов активных пользователей в месяц.
-
50% пользователей пользуются Twitter ежедневно.
-
В среднем пользователь публикует 2 твита в день.
-
10% твитов содержат медиа.
-
Данные хранятся 5 лет.
Оценки:
Оценка запросов в секунду (QPS):
-
Ежедневная активная аудитория (DAU) = 300 миллионов * 50% = 150 миллионов
-
QPS по твитам = 150 миллионов * 2 твита / 24 часа / 3600 секунд = ~3500
-
Пиковый QPS = 2 * QPS = ~7000
Здесь мы будем оценивать только хранилище для медиа.
-
Средний размер твита:
-
tweet_id64 байта -
текст 140 байт
-
медиа 1 MB
-
Хранилище для медиа: 150 миллионов * 2 * 10% * 1 MB = 30 TB в день
-
Хранилище для медиа за 5 лет: 30 TB * 365 * 5 = ~55 PB
Советы
Оценка на салфетке — это прежде всего про ход рассуждений. Процесс решения задачи важнее, чем точный результат. Интервьюеры могут проверять ваши навыки решения задач. Вот несколько советов, которых стоит придерживаться:
-
Округление и приближение. Во время собеседования сложно выполнять сложные математические операции. Например, чему равно “99987 / 9.1”? Нет необходимости тратить драгоценное время на сложные вычисления. От вас не ждут высокой точности. Используйте круглые числа и приближения в свою пользу. Этот пример деления можно упростить до: “100,000 / 10”.
-
Записывайте свои предположения. Полезно фиксировать предположения, чтобы позже к ним можно было вернуться.
-
Подписывайте единицы измерения. Когда вы записываете “5”, что это означает: 5 KB или 5 MB? Можно легко запутаться. Записывайте единицы измерения, потому что “5 MB” убирает неоднозначность.
-
Часто встречающиеся оценки на салфетке: QPS, пиковый QPS, объем хранилища, кэш, количество серверов и т. д. Вы можете тренировать такие вычисления при подготовке к собеседованию. Практика ведет к совершенству.
Поздравляем, вы добрались до этого места! Теперь можете похлопать себя по плечу. Отличная работа!
Список литературы
[1] J. Dean.Google Pro Tip: Use Back-Of-The-Envelope-Calculations To Choose The Best Design:
http://highscalability.com/blog/2011/1/26/google-pro-tip-use-back-of-the-envelope-calculations-to-choo.html
[2] System design primer:
https://github.com/donnemartin/system-design-primer
[3] Latency Numbers Every Programmer Should Know:
https://colin-scott.github.io/personal_website/research/interactive_latency.html
[4] Amazon Compute Service Level Agreement:
https://aws.amazon.com/compute/sla/
[5] Compute Engine Service Level Agreement (SLA):
https://cloud.google.com/compute/sla
[6] SLA summary for Azure services:
https://azure.microsoft.com/en-us/support/legal/sla/summary/